论文技术报告:AMB3R-SLAM:基于分层后端的千米级 SLAM
arXiv ID: 2609.19518 原文标题: AMB3R-SLAM: Kilometer-scale SLAM with Hierarchical Backend 翻译日期: 2026-10-28
📋 论文概览
基本信息
- 作者: Hengyi Wang, Lourdes Agapito
- 机构: 伦敦大学学院(UCL)计算机科学系
- 发表时间: 2026 年 9 月(arXiv;3DV 2027 投稿模板)
- 领域: 计算机视觉 / 视觉 SLAM / 三维几何基础模型 / 大规模三维重建
核心贡献
- 提出 AMB3R-SLAM:一个实时单目 SLAM 系统,能在单块消费级 GPU(RTX 4090)上跟踪超过 1 万帧、长达数千米的轨迹,峰值显存 10–14 GB,且不随序列长度增长。
- 设计分层后端,分三级逐步施加一致性:
- 局部:带 Span-2 边的稠密重叠子图;
- 中层:稀疏长上下文建图(SLCM),产生跨子图的长跨度边;
- 全局:DBoW2 检索加基础模型几何验证的回环。
- 坚持"相信前馈预测、不做依赖对应关系的优化"的设计原则:只在 \(\mathrm{Sim}(3)\) 位姿图上优化相对位姿,不做光束法平差(BA)。因此动态场景无需任何改动即可处理。
- 给出向双目 / RGB-D(逐子图度量尺度校准,\(\mathrm{Sim}(3)\to\mathrm{SE}(3)\))和 LiDAR(ICP 相对位姿,加上基础模型初始化的回环配准和 RMSE 加权)的扩展。
- 在 9 个数据集上验证:在 VBR、Oxford Spires 上把此前 SOTA 的 ATE 降低 70% 以上;加入 LiDAR 后,KITTI 和 VBR 的误差达到亚米级。
🎯 研究背景与动机
问题定义
视觉 SLAM 需要从视频流中在线估计相机位姿并稠密重建。约束有三条:低延迟、有界内存、长时程全局一致。目标是把 DUSt3R / VGGT / DepthAnything 3 这类三维几何基础模型的强先验,用到千米级、上万帧的真实场景中,而且不依赖相机标定。
现有方法的局限性
- 全局式基础模型(VGGT、DA3 等):对所有视图做双向注意力,复杂度是二次的,只能离线处理几十张图。
- 流式/因果模型(Spann3R、CUT3R、LoGeR、LingBot-Map):用因果注意力或记忆压缩,换来恒定开销,但局部精度下降,顺序链条会累积漂移。
- AMB3R-VO:在活动关键帧内保留双向注意力,局部精度高。但它只是 VO,没有全局优化,长轨迹上仍会漂移。
- 基于分块的离线方法(VGGT-Long、π3-Long、DA3-Long):本质上是离线的。
- 基于优化的 SLAM(MASt3R-SLAM、VGGT-SLAM、DROID-SLAM):依赖对应关系或 BA。在大尺度场景中显存溢出或超时,在动态场景中静态假设失效。
本文的创新点
- 用多级图边代替 BA。Span-2 边、长上下文边、回环边分别管住短、中、长三个尺度的漂移。
- 白化矩阵按边的基线长度归一化平移残差,让长边和短边在优化中权重均衡。
- 同一流程零改动地覆盖静态/动态场景,以及单目/双目/RGB-D/LiDAR 输入。
- 系统与骨干模型无关:后端可以换成 DA3-Giant 或 VGGT-Ω。
🔬 方法论
整体架构
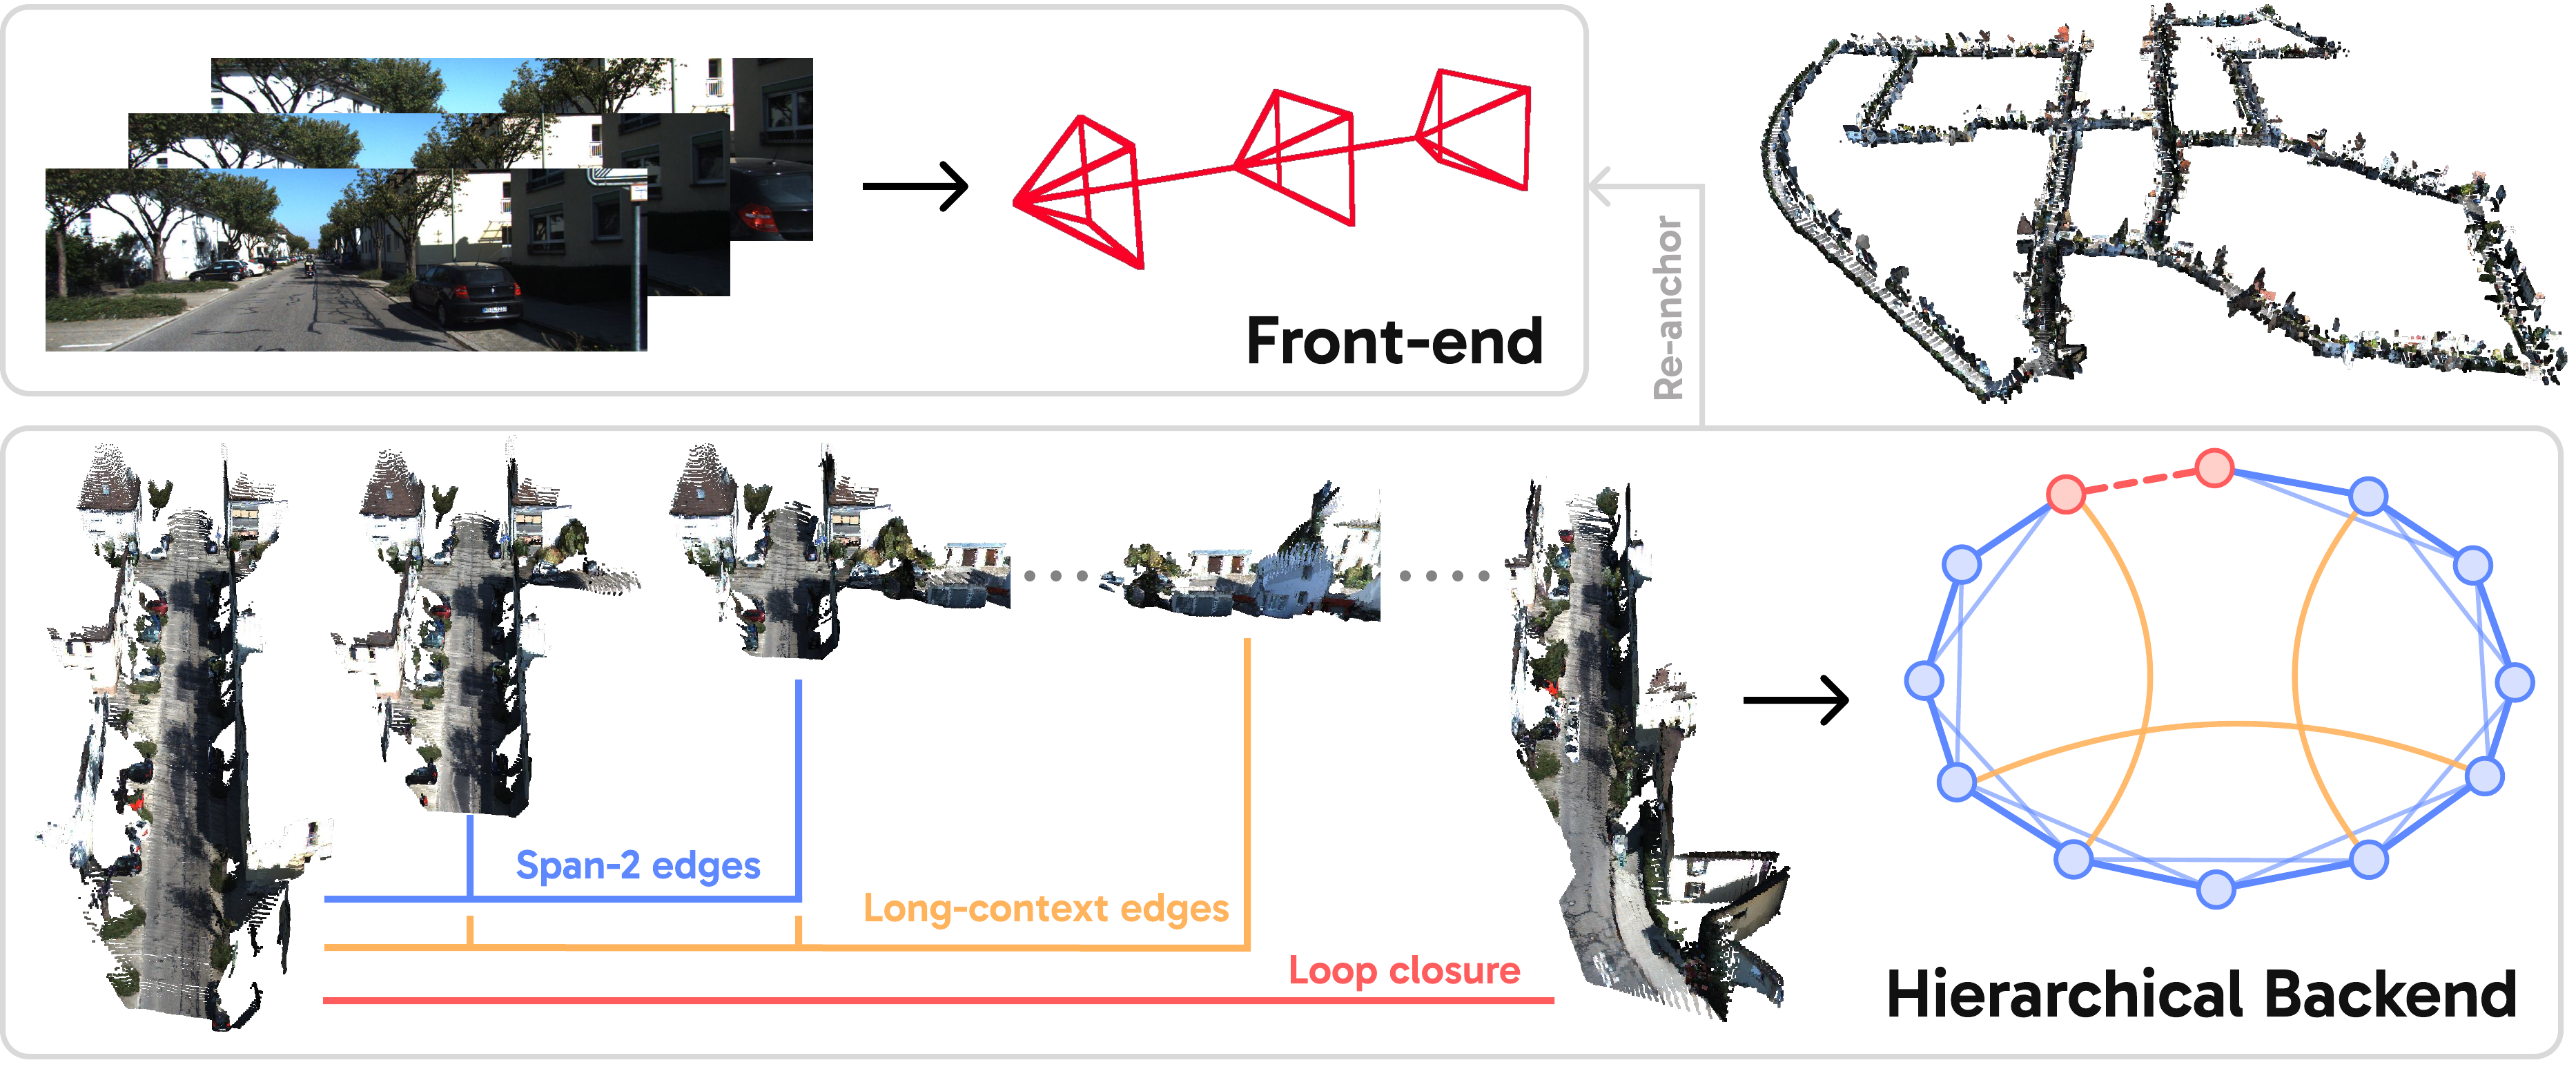
图:AMB3R-SLAM 概览。前端负责低延迟位姿跟踪;分层后端通过 Span-2 边、长上下文边和回环边构建位姿图,逐步保证局部、中层和全局一致性。
系统由两部分组成: - 前端:轻量级 DA3-Small(80M 参数)。用"锚定关键帧 + 最近两帧"做逐帧跟踪,用鲁棒尺度求解器对齐尺度。 - 分层后端:用 DA3-Giant 或 VGGT-Ω 构建稠密子图,执行稀疏长上下文建图和回环验证,最后做 \(\mathrm{Sim}(3)\) 位姿图优化,并把校正量传播回所有帧。
关键技术
1. 稠密局部建图(Span-2 边) - 每隔 \(\Delta\) 帧,在长度为 \(n\) 的滑动窗口上构建一个子图 \(\mathcal{M}_k\),取 \(\Delta=n/3\)。这样每个子图既和 \(\mathcal{M}_{k+1}\) 重叠,也和 \(\mathcal{M}_{k+2}\) 重叠,天然形成 Span-2 边。相比只连相邻子图,多了一层冗余约束。 - 子图内按步长 \(d_{\text{stride}}\) 分组,每组只重建前端置信度最高的一帧,其余帧的位姿用插值得到。这样少量上下文帧就能覆盖宽基线。 - 以子图的中间帧作为参考视图,减少子图边界处的漂移。
2. 稀疏长上下文建图(SLCM) - 每隔 \(M\) 个子图,从连续 \(K\) 个子图中稀疏采样关键帧,联合重建得到 \(\mathcal{C}\)。从 \(\mathcal{C}\) 中提取 \(|i-j|\ge 3\) 的子图对之间的 \(G_{ij}\in\mathrm{Sim}(3)\),作为长跨度边。 - 设置两道质量闸门,防止稀疏输入下基础模型退化:\(\mathcal{C}\) 的置信度不能明显低于局部子图;两个子图之间的共视要足够。 - 作用:在回环出现之前就提供中程约束,限制漂移。
3. 回环检测 - 用 DBoW2 检索候选回环。对每个候选,从两个子图中采样视图,用基础模型联合重建,再用三维体素占据重叠度做几何验证。 - 旋转或平移校正量不合理的回环会被剔除,以防重复纹理环境中的感知混淆。
4. 白化的 Sim(3) 位姿图优化 - 残差取 \(\log_{\mathrm{Sim}(3)}(G_{ij}^{-1}S_i^{-1}S_j)\),共 7 维(平移 3 维、旋转 3 维、对数尺度 1 维)。 - 平移部分除以 \(d_{ij}=\max(\|\mathbf{t}_{ij}\|, d_{\min})\),衡量的是相对漂移。 - 外点用 Huber 损失抑制。
5. 多模态扩展 - 双目 / RGB-D:用 SGM 或深度传感器得到度量深度,取逐像素比值的中位数作为子图尺度 \(\hat s_k\)。尺度校准后固定 \(s_{ij}=1\),优化退化为 \(\mathrm{SE}(3)\)。 - LiDAR:相对位姿改用 KISS-ICP。回环先用基础模型给初值,再用 ICP 精化。回环边按 \((\bar\varepsilon/\varepsilon_{ij})^2\) 加权,也就是按 RMSE 的逆方差加权。
算法流程
- 新帧到达后,前端在当前子图内估计位姿(低延迟输出)。
- 每累计 \(\Delta\) 帧,后端用大模型构建新的稠密子图,与前两个子图对齐,加入 Span-2 边,并用后端结果重新锚定前端。
- 每累计 \(M\) 个子图,执行一次稀疏长上下文建图,通过闸门的长跨度边加入位姿图。
- DBoW2 持续检索回环;候选经过基础模型重建和体素重叠验证后,作为回环边加入位姿图。
- 执行白化加 Huber 的 \(\mathrm{Sim}(3)\)(或 \(\mathrm{SE}(3)\))位姿图优化。在重叠窗口上用加权位姿平均,把校正量传播到所有帧。
📊 实验与结果
实验设置
- 数据集:共 9 个。
- 千米级室外:KITTI、VBR、Oxford Spires;
- 建筑级室内外:LaMAR、CroCoDL;
- 房间级:TUM RGB-D、ETH3D-SLAM、EuRoC;
- 动态场景:Bonn。
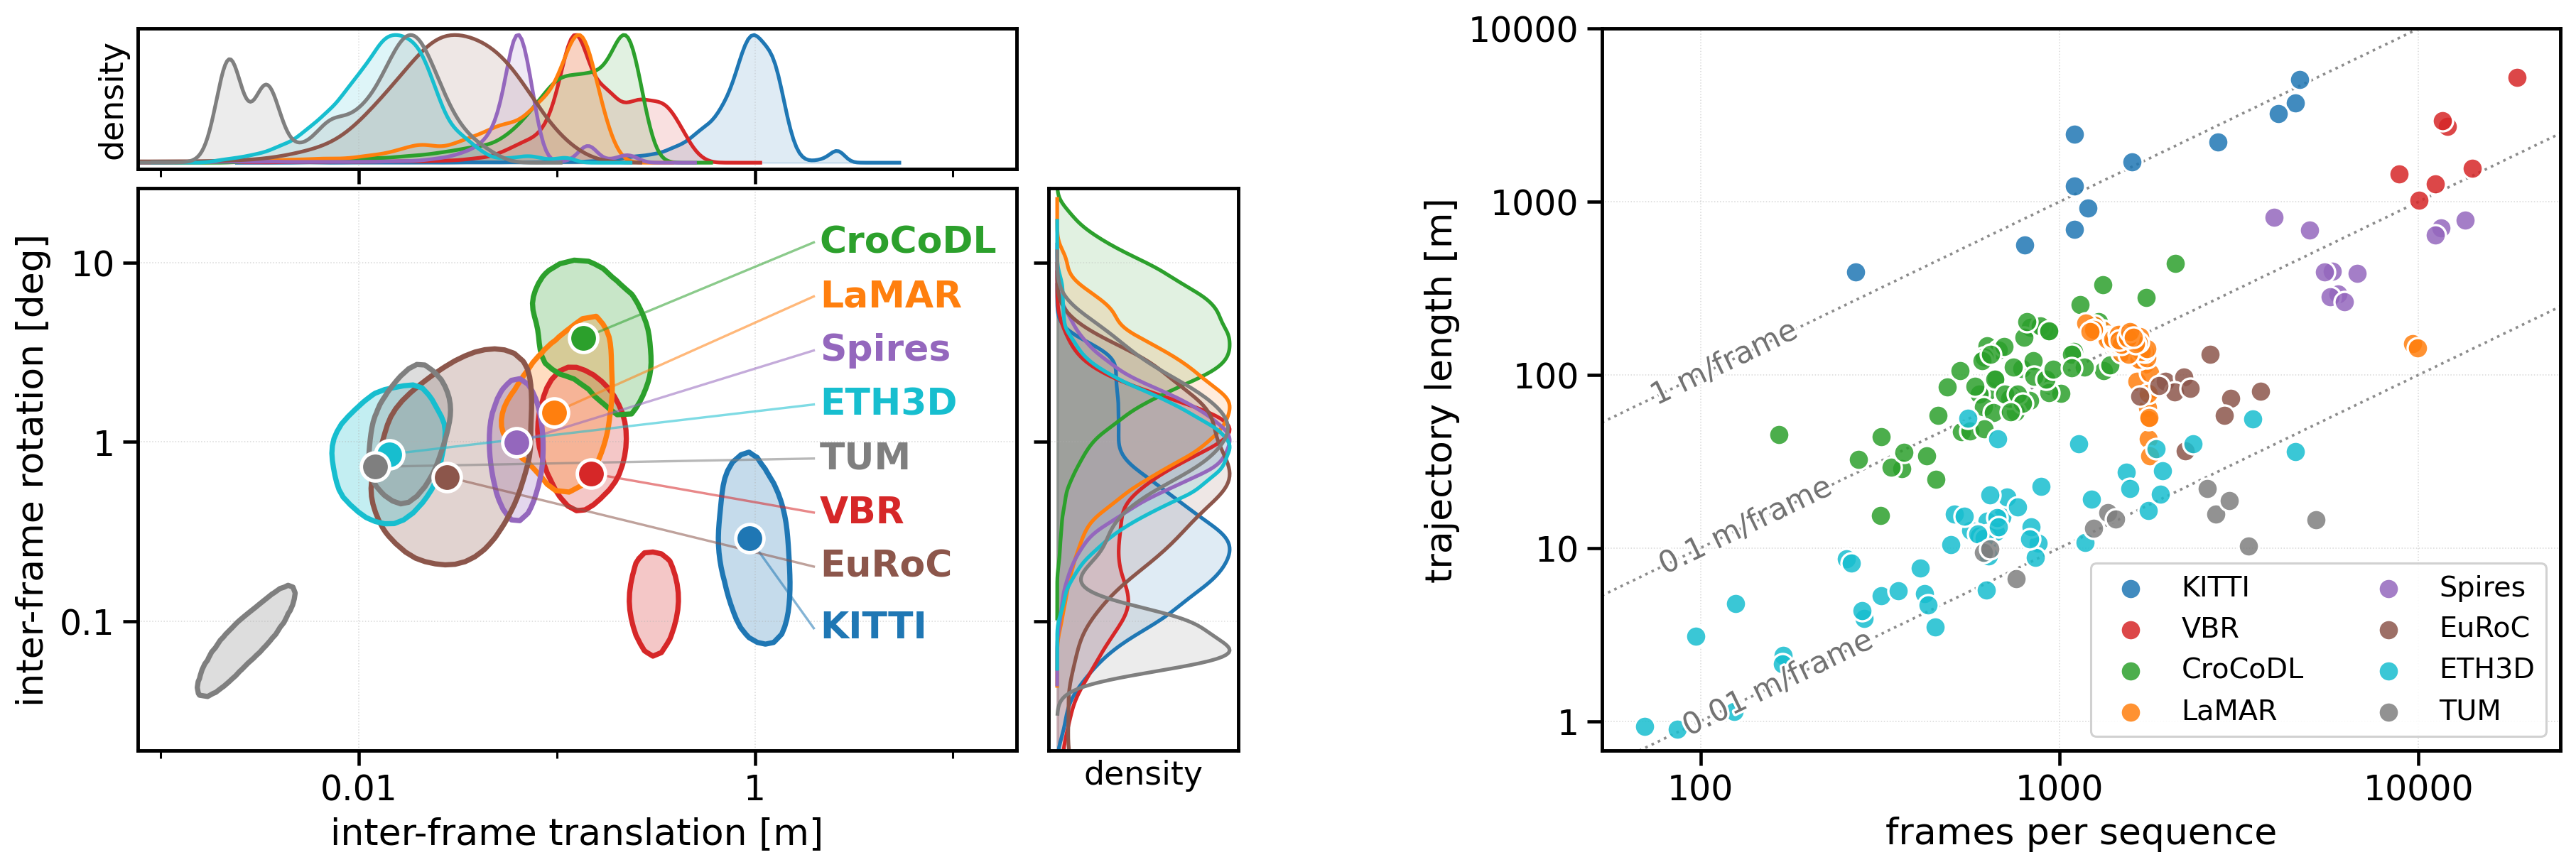
图:评测数据集统计,包括相邻帧间的旋转/平移、序列帧数和轨迹长度。
- 评估指标:
- KITTI、VBR、Oxford、TUM、Bonn:ATE RMSE;
- ETH3D、EuRoC:平移误差 AUC(阈值 5 cm 到 10 m);
- LaMAR、CroCoDL 及 VBR 消融:窗口化 AUC(W-AUC),阈值为窗口长度的 5%。
- 对比方法:
- 在线:LoGeR、LingBot-Map、MASt3R-SLAM、VGGT-SLAM2、AMB3R-VO、DROID-SLAM、ViPE、MegaSaM,以及受控基线 DA3-SLAM(把 DA3 接入 VGGT-SLAM 流程);
- 离线/分块:GLOMAP、Scal3R、Glob3R、SAILRecon、VidMap、VGGT-Long、π3-Long、DA3-Long;
- 动态场景:WildGS-SLAM;LiDAR:PIN-SLAM。
主要结果
千米级室外(平均 ATE,单位 m)
| 数据集 | 最佳在线基线 | 最佳分块/离线 | AMB3R-SLAM | AMB3R-SLAM (Ω) | +LiDAR |
|---|---|---|---|---|---|
| KITTI | LoGeR 18.65 | Glob3R 13.21 / DA3-Long 16.83 | 13.11(双目 12.15) | – | 0.95(PIN-SLAM 1.22) |
| VBR | LingBot-Map 26.65 | DA3-Long 52.65 | 7.42 | 7.15 | 0.36(PIN-SLAM 0.81) |
| Oxford Spires | LoGeR 8.59 | – | 2.32 | 2.08 | – |
- 在 KITTI 上,单目版本比 LoGeR 低 30%,比 DA3-Long 低 22%,略优于离线 SfM 方法 Glob3R。
- 在 VBR 上,误差比在线基线降低 72%;在 Oxford Spires 上降低 73%。在包含"室内—室外—室内"过渡的 chr_05 序列上,优势尤其明显(2.09 m,LoGeR 为 21.79 m)。
- 在 KITTI-01(2.5 km 高速路段,视觉特征少)上,单目漂移到 55.91 m;加入 LiDAR 后降到 2.95 m。
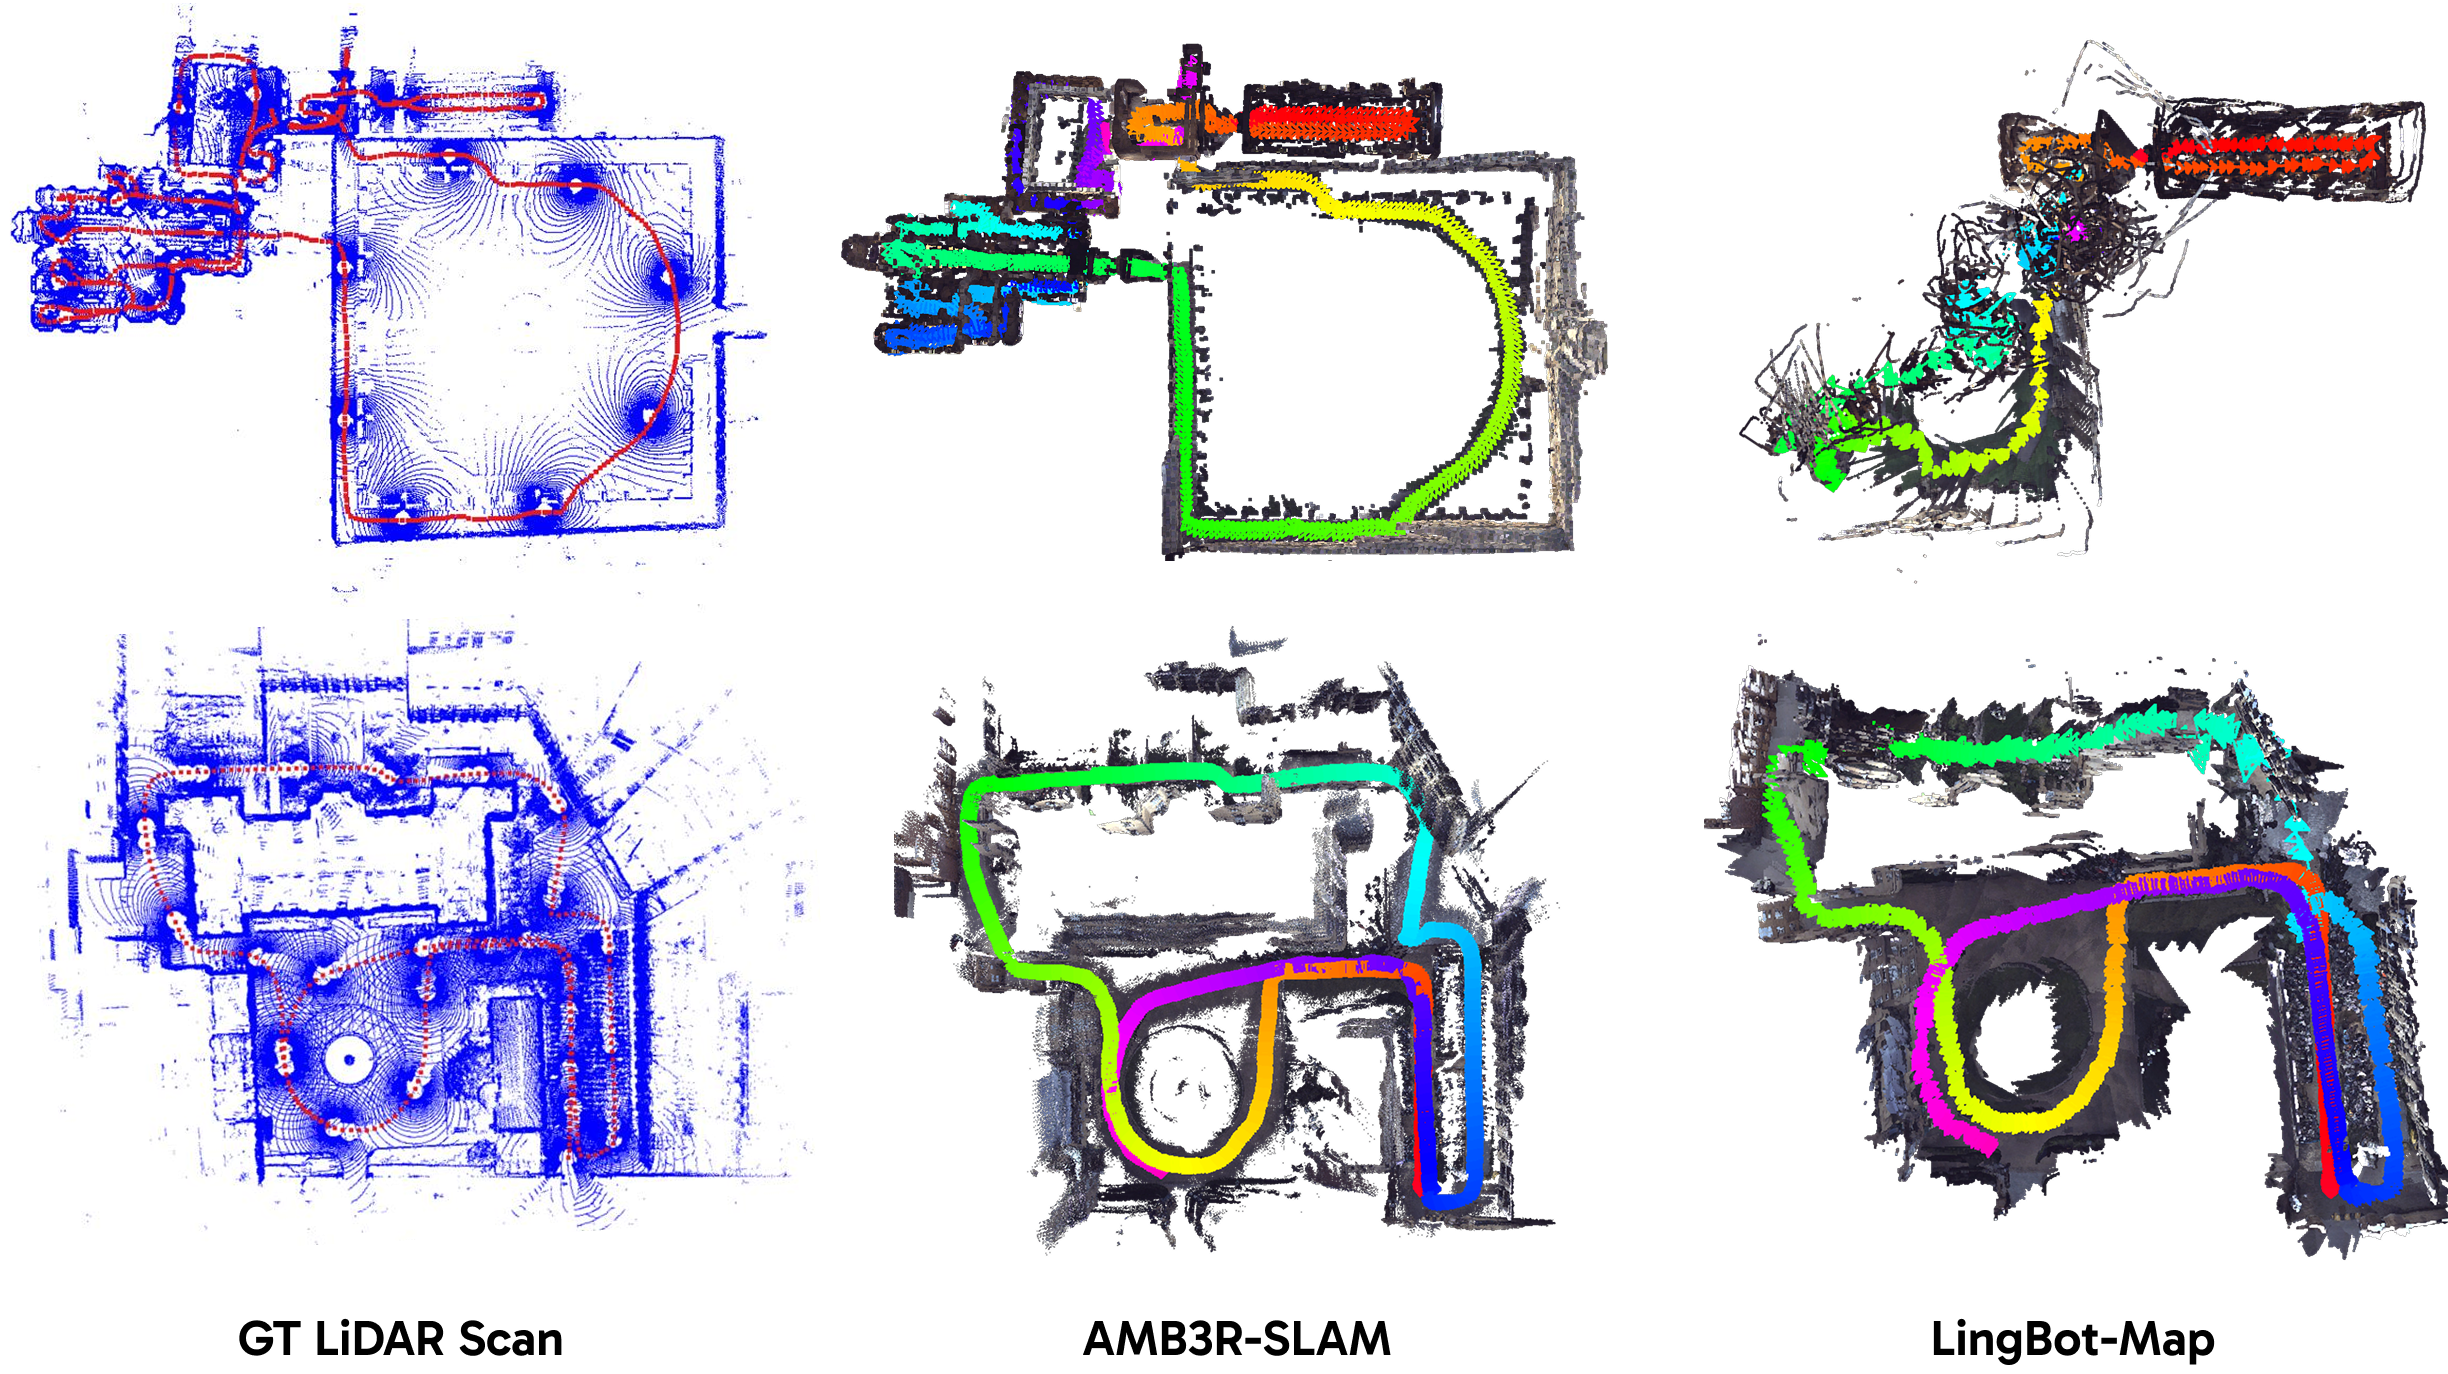
图:Oxford Spires 数据集上的定性重建结果。
建筑级(W-AUC,Full 窗口)
- LaMAR:本文(Ω)为 84.7,领先所有在线方法(ViPE 76.6),但低于离线的 VidMap(88.5)。
- CroCoDL(域外的灾害现场建筑):本文为 91.2–91.7,超过 GLOMAP 和 DA3-Long(88.9),但低于 VidMap(95.5)。
- 窗口越长,相对 DA3-SLAM 的优势越大。
房间级
- TUM RGB-D:平均 ATE 2.3 cm(AMB3R-VO 为 3.2 cm),优于所有离线和分块方法;加入 RGB-D 后为 2.2 cm。
- ETH3D-SLAM:AUC@5cm 为 44.0%(ViPE 为 38.7%);加入 RGB-D 后为 44.8%。
- EuRoC:无人机快速运动下,其他在线方法在严格阈值下全部崩溃,本文仍然鲁棒,甚至超过离线的 VidMap。
动态场景(Bonn)
- 平均 ATE 1.3 cm,在全部 8 个序列上最优,比 WildGS-SLAM(2.3 cm)低 43%,比 MegaSaM(3.5 cm)低 63%。
- 所用流程与静态场景完全相同。
效率(RTX 4090)
| 模式 | 数据集 | FPS | 显存 (GB) | 建图 (ms/帧) | 检索 | PGO |
|---|---|---|---|---|---|---|
| 单目 | KITTI | 17.6 | 10.3 | 56.5 | 0.7 | 0.17 |
| 单目 | VBR | 10.2 | 14.0 | 97.5 | 1.0 | 0.12 |
| LiDAR | KITTI | 47.8 | 10.5 | 20.8 | 0.7 | 0.05 |
| LiDAR | VBR | 31.3 | 14.1 | 44.0 | 1.0 | 0.04 |
几乎所有开销都花在基础模型推理上,位姿图优化的开销可以忽略。
前端:DA3-Small 前端以 78 FPS 运行,KITTI 窗口内的漂移(ATE%)为 4.43,远低于双视图基线的 12.09。
消融实验
VBR,W-AUC %
| 变体 | 10 m | 100 m | 500 m | 1000 m | 全程 |
|---|---|---|---|---|---|
| w/o 回环 | 89.38 | 80.94 | 55.39 | 47.82 | 42.02 |
| w/o 白化 | 88.11 | 80.92 | 77.47 | 82.79 | 86.97 |
| w/o SLCM | 89.15 | 84.28 | 84.36 | 88.35 | 90.46 |
| 完整 | 89.14 | 85.57 | 86.00 | 90.17 | 90.39 |
- 回环是全局一致性的关键。没有回环时,500 m 以上的指标断崖式下降。
- 白化影响所有窗口。不做归一化时,长基线边的平移残差会主导优化。
- SLCM 主要提升 50–1000 m 的中程指标(这段距离内回环稀疏或缺失);全程指标与无 SLCM 版本基本持平,说明它的作用是"在回环之前限制漂移"。
- LiDAR 回环初始化:去掉基础模型初值后,ATE 从 1.17 m 升到 1.39 m(SE(3) 下从 1.23 m 升到 1.45 m)。原因是视角变化较大时,ICP 容易陷入局部极小。
💡 关键见解
理论分析
- 为什么不做 BA:BA 最小化的是跨像素的重投影误差,隐含了静态世界假设,规模也随点数增长(数百万点)。本文只优化子图之间的相对 \(\mathrm{Sim}(3)\)。变量数等于子图节点数,因此开销极小(PGO 小于 0.2 ms/帧);而且动态物体只影响基础模型内部的推理,不进入优化目标。
- 多尺度约束覆盖漂移谱:漂移是在不同时间尺度上累积的。Span-2 边管短程,SLCM 管中程(回环出现之前),回环管全局。三者互补,在消融的不同窗口长度上体现得很清楚。
- 白化等价于相对误差度量:平移残差除以基线长度后,各条边上的漂移以比例计量。这与 W-AUC 按"窗口长度的 5%"设阈值的思路一致。
- 单目尺度漂移:在 \(\mathrm{Sim}(3)\) 图中,尺度是自由度,只能靠回环修正。引入度量深度、把优化降为 \(\mathrm{SE}(3)\),相当于在每个节点上锚定了尺度。
实践启示
- 前端用小模型、后端用大模型的异步分工,是把大型基础模型做成实时系统的有效办法。延迟由小模型决定,精度由大模型决定。
- 与骨干模型无关的设计,让系统可以随基础模型的进步直接升级(例如从 DA3 换成 VGGT-Ω,VBR 从 7.42 m 降到 7.15 m)。
- 在有 LiDAR 的场景中,视觉基础模型最有价值的角色是为回环提供鲁棒的初值,而不是替代 ICP。
- 对机器人和自动驾驶来说,同一套系统能覆盖单目、双目、RGB-D、LiDAR 以及动态场景,部署成本更低。
🔍 局限性与未来工作
当前局限
- 地图用点云表示,没有统一、紧凑的表面表示。在感知歧义区域可能出现重复表面或重影。
- 双目、RGB-D、LiDAR 只在系统层面(位姿图)融合,底层基础模型只看 RGB,没有以深度或点云为条件输入。
- 纯单目在弱纹理、高速场景(如 KITTI-01)上仍然漂移严重。
- 在 LaMAR、CroCoDL 等建筑级数据上仍落后于离线方法 VidMap。长上下文边和回环闸门涉及多个阈值(置信度比例、共视度、校正量上限等),论文没有给出系统的敏感性分析。
未来方向
- 引入神经隐式场或高斯溅射等紧凑表示,维护全局一致的地图。
- 开发原生支持多模态条件输入(深度、LiDAR)的几何基础模型。
- 研究可学习的回环验证或边置信度估计,减少手工阈值。
- 扩展到多会话、多机器人的地图合并,以及更长(城市级)的序列。
📚 相关工作对比
| 方法 | 核心思想 | 优势 | 劣势 |
|---|---|---|---|
| MASt3R-SLAM / VGGT-SLAM | 基础模型先验加对应关系/BA 式优化 | 无需标定,局部精度好 | 大场景下显存溢出或超时,依赖静态假设 |
| LoGeR / LingBot-Map | 因果注意力或记忆压缩的流式基础模型 | 恒定开销,可流式处理 | 局部精度下降,长轨迹漂移(VBR 上 26–32 m) |
| AMB3R-VO | 活动关键帧内双向注意力的 VO | 局部精度高、实时 | 无全局优化,长程漂移 |
| VGGT-Long / DA3-Long | 重叠分块加全局对齐 | 精度尚可 | 离线 |
| PIN-SLAM | 神经隐式 LiDAR SLAM | 度量精度高 | 需要 LiDAR,视角变化大时回环易失败 |
| 本文方法 | 小模型前端,大模型分层后端,三级图边,白化 Sim(3) PGO | 千米级实时、动态鲁棒、支持多模态、与骨干模型无关 | 点云地图有重影;多模态未进入模型;超参与闸门较多 |
🎓 个人评价
优点
- 问题定位清楚:把"基础模型精度高但无法扩展"和"SLAM 需要全局一致"这两件事用分层图优化连接起来,工程上简洁有效。
- 评测非常充分:9 个数据集,覆盖桌面到 5 km 尺度、静态到动态、多种传感器,并设置了 DA3-SLAM 受控基线,把系统设计的贡献和骨干模型的贡献分开。
- 结果提升幅度大(VBR 和 Oxford 上降低 70% 以上),并给出了运行时间和显存分解,说服力强。
- 动态场景的鲁棒性来自"不做 BA"这一设计,而不是额外模块,论证自然。
可改进之处
- 方法部分对 \(n\)、\(\Delta\)、\(M\)、\(K\)、\(d_{\text{stride}}\)、闸门阈值等超参数的取值和敏感性交代不足。
- 没有对重建质量(几何精度、点云完整性)做定量评估,主要只评测了轨迹。
- 前端和后端的异步调度、延迟分布(例如回环优化时的尖峰)可以描述得更详细。
- 与经典 ORB-SLAM3 等传统系统在 KITTI 上的比较缺失(只有 DROID-SLAM)。
推荐阅读对象
- 研究视觉/多模态 SLAM、大规模三维重建的研究者;
- 关注三维几何基础模型(DUSt3R/VGGT/DA3 系列)落地应用的工程师;
- 自动驾驶和移动机器人定位建图方向的从业者。
📎 附录
重要公式
Sim(3) 位姿图优化目标:
白化矩阵(按基线长度归一化平移误差):
度量尺度校准(双目 / RGB-D):
LiDAR 回环边加权:
术语表
| 英文 | 中文 | 说明 |
|---|---|---|
| Geometric Foundation Model (GFM) | 几何基础模型 | 前馈回归深度和位姿的大模型,如 DUSt3R、VGGT、DA3 |
| Front-end / Backend | 前端 / 后端 | 低延迟逐帧跟踪 / 建图与全局优化 |
| Submap | 子图 | 滑动窗口内稠密重建的局部地图 |
| Span-2 edge | 跨度为 2 的边 | 连接 \(\mathcal{M}_k\) 与 \(\mathcal{M}_{k+2}\) 的约束 |
| Sparse Long-Context Mapping (SLCM) | 稀疏长上下文建图 | 跨多个子图稀疏采样联合重建,产生长跨度边 |
| Loop Closure (LC) | 回环检测/闭环 | 识别重访位置,施加全局约束 |
| Pose Graph Optimization (PGO) | 位姿图优化 | 以相对位姿为约束优化节点位姿 |
| Bundle Adjustment (BA) | 光束法平差 | 联合优化位姿与三维点的重投影误差 |
| Whitening matrix | 白化矩阵 | 归一化各残差分量的权重矩阵 |
| ATE | 绝对轨迹误差 | 对齐后轨迹位置误差的 RMSE |
| W-AUC | 窗口化 AUC | 以轨迹片段为单位、阈值为片段长度 5% 的 AUC |
| Perceptual aliasing | 感知混淆 | 不同地点外观相似导致的错误回环 |
参考资源
- 论文原文: arXiv:2609.19518
- 中文翻译 PDF: paper_cn.pdf
- 中文 Markdown 译文: paper_cn.md
- 代码实现: 论文未给出代码链接(可关注项目主页)
- 项目主页: https://hengyiwang.github.io/projects/amber-slam