MagicPoint
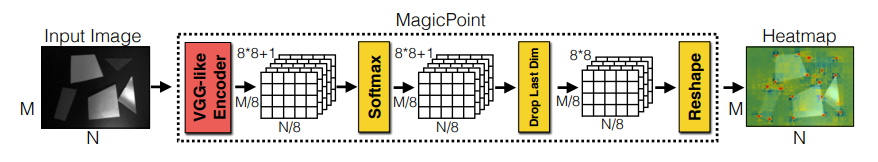
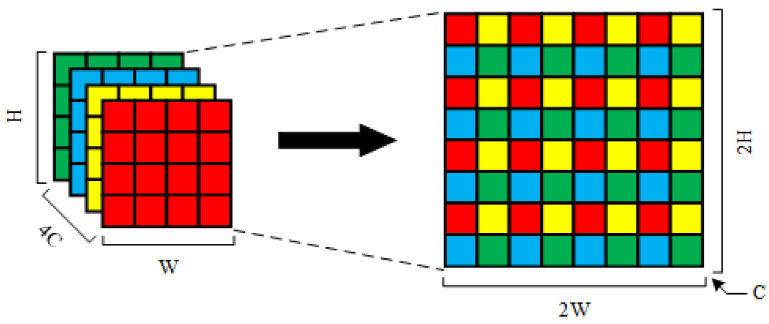
输入为灰度图(\(1\times N \times M\)),通过VGG-like的encoder得到特征图(\(128 \times N/8 \times M/8\)),decoder经过一次卷积得到特征图(\(65 \times N/8 \times M/8\)),通过softmax转换为概率, 代表着输入图中局部\(8\times 8\)像素区域每个像素为角点的概率, 通道数为\(8\times 8 + 1\),\(+1\)代表垃圾通道,表示在该区域没有检测到角点, 如果只有64层,那么经过softmax之后,所有的得分之和就会等于1,这意味着这个小区域即使是完全空白也将获得平均得分1/64因此65行存在的意义在于当这个小区域没有特征时,这一行数据非常大,使得整体经过softmax之后前64行的得分很小,从而使得该区域被标记为没有特征点的区域。。将概率图(\(65 \times N/8 \times M/8\))去掉第65层,并通过 pixel shuffle得到原图大小的heatmap。即可通过概率筛选特征点。
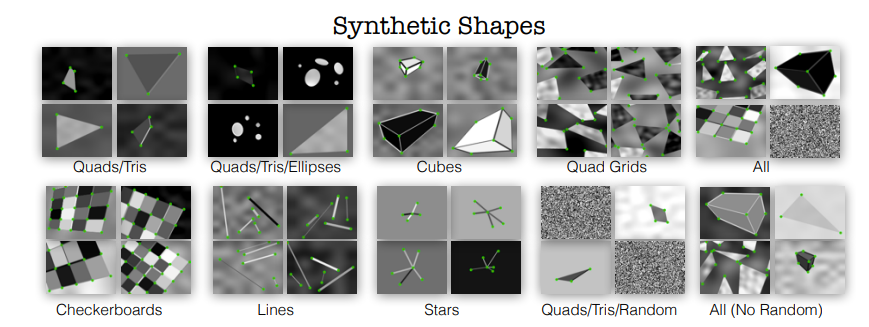
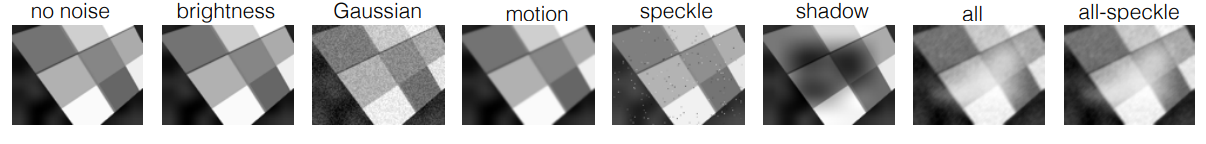
MagicPoint的训练数据集是通过虚拟出一些三维物体,然后再对这些物体进行一个视角的图片截取获得的,所有特征点的真值是已知的,有了明确的特征点位置,便可以进行网络训练。为了增强其泛化能力,在图片中人为添加了一些噪声和不具有特征点的形状,比如椭圆等。
损失函数采用交叉熵损失函数(cross entropy loss)
Homographic Adaptation机制
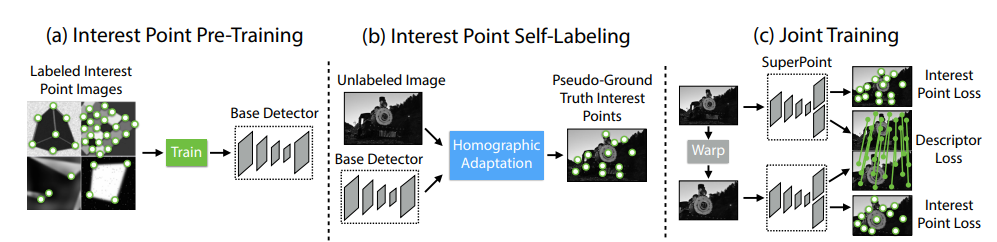
MagicPoint是用带兴趣点label的模拟数据集训练的,它在类似的模拟数据集上的测试效果较好。然而只用模拟数据训练出的MagicPoint在真实影像上提取兴趣点的效果并不一定好,真实影像本身没有兴趣点label,提出一个叫Homographic Adapatation的机制为真实影像生成兴趣点label,然后对MagicPoint进行迁移学习。
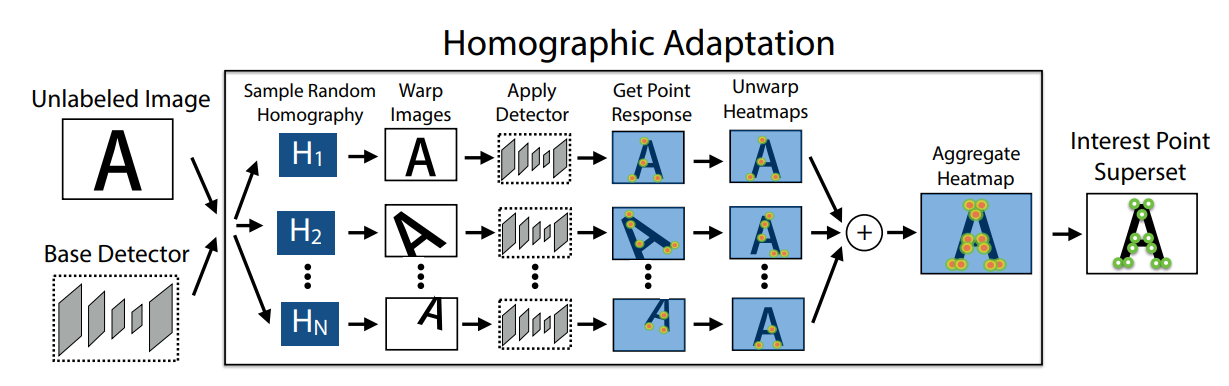
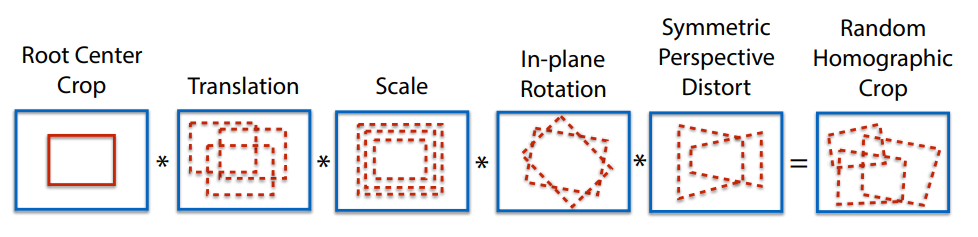
左边Unlabeled Image即COCO数据集中不带兴趣点label的影像,Base Detector为上一步使用模拟数据预训练好的兴趣点检测器MagicPoint。对Unlabeled Image执行N次随机不同的透视变换(Homography),得到N张Warp Images。将N张Warp Images分别输入到Base Detector中,得到N张兴趣点的概率/得分图,再对这些兴趣点概率/得分图执行刚才透视变换矩阵的逆变换。
原图经不同透视变换后的兴趣点得分,再逆变换回原始的得分图,在理论上,同一位置像素的得分应该是一致的。然而实际上是不一致的,这是因为Base Detector对于真实影像的兴趣点检测效果有限。某个点可能在透视变换1的得分图上得分较高,而在透视变换2的得分图上得分较低。
对经逆变换的所有兴趣点得分图进行整合,得到一张整合后的得分图,作为Unlabel Image的兴趣点label。
SuperPoint
Reference
[0] Deep Image Homography Estimation
[1] Toward Geometric Deep SLAM
[2] SuperPoint: Self-Supervised Interest Point Detection and Description
[4] https://github.com/magicleap/SuperPointPretrainedNetwork.git