论文技术报告:NavRL:在动态环境中学习安全飞行
arXiv ID: 2409.15634 原文标题: NavRL: Learning Safe Flight in Dynamic Environments 翻译日期: 2026-10-19
📋 论文概览
基本信息
- 作者: Zhefan Xu, Xinming Han, Haoyu Shen, Hanyu Jin, Kenji Shimada
- 机构: 卡内基梅隆大学(CMU)机械工程系
- 发表时间: arXiv 2024 年 9 月;IEEE Robotics and Automation Letters(RA-L)2025 年 2 月录用
- 领域: 无人机自主导航、深度强化学习、动态避障、Sim-to-Real
核心贡献
- NavRL 导航框架:基于 PPO 的端到端(感知表示 → 速度指令)四旋翼导航策略,同时处理静态与动态障碍物,零样本迁移到真实飞行,代码开源(https://github.com/Zhefan-Xu/NavRL)。
- 策略动作安全护盾:在部署阶段用速度障碍(VO)+ ORCA 式半平面约束,把网络输出的速度投影到安全区域,弥补神经网络黑盒带来的偶发失效。
- 大规模并行训练 + 课程学习:在 NVIDIA Isaac Sim 中用 1024 架四旋翼并行采样,单卡 RTX 4090 约 10 小时完成训练。
- 实物验证:在 Jetson Orin NX 机载计算机上,感知 + 策略 + 护盾全链路实时运行。
🎯 研究背景与动机
问题定义
四旋翼需要在含有任意形状静态障碍物和移动障碍物(如行人)的环境中,从起点安全飞到目标点。输入为机载 RGB-D 相机与 LIO 位姿,输出为每个时间步的三维速度指令。
现有方法的局限性
- 传统规则/优化方法(EGO-Planner、ViGO 等):预测 + 规划层级模块,参数多、换场景需重调;模型简化导致解次优,对近距离突发障碍反应不够快。
- 基于图像的 RL:仿真图像与真实图像差异大,需要额外的域适配或真实数据训练,数据效率低。
- 安全性:RL 策略是黑盒,缺乏廉价的在线安全保障;已有的可达性分析方案需要预计算可达集,代价随动作维数指数增长。
- 训练效率:单机器人采样收敛慢、数据多样性不足。
- 动态障碍物:多数 RL 方法只考虑静态场景,或把动态障碍当静态处理。
本文的创新点
- 用几何化的中间表示(光线投射距离矩阵 + 动态障碍物状态矩阵)替代原始图像作为策略输入,从源头缩小 Sim-to-Real 差距。
- 目标坐标系下表达所有状态与动作,消除对全局坐标的依赖,加速收敛。
- Beta 分布策略 + 归一化速度,动作范围部署时可调。
- VO 安全护盾作为轻量后处理层,与策略训练解耦。
🔬 方法论
整体架构
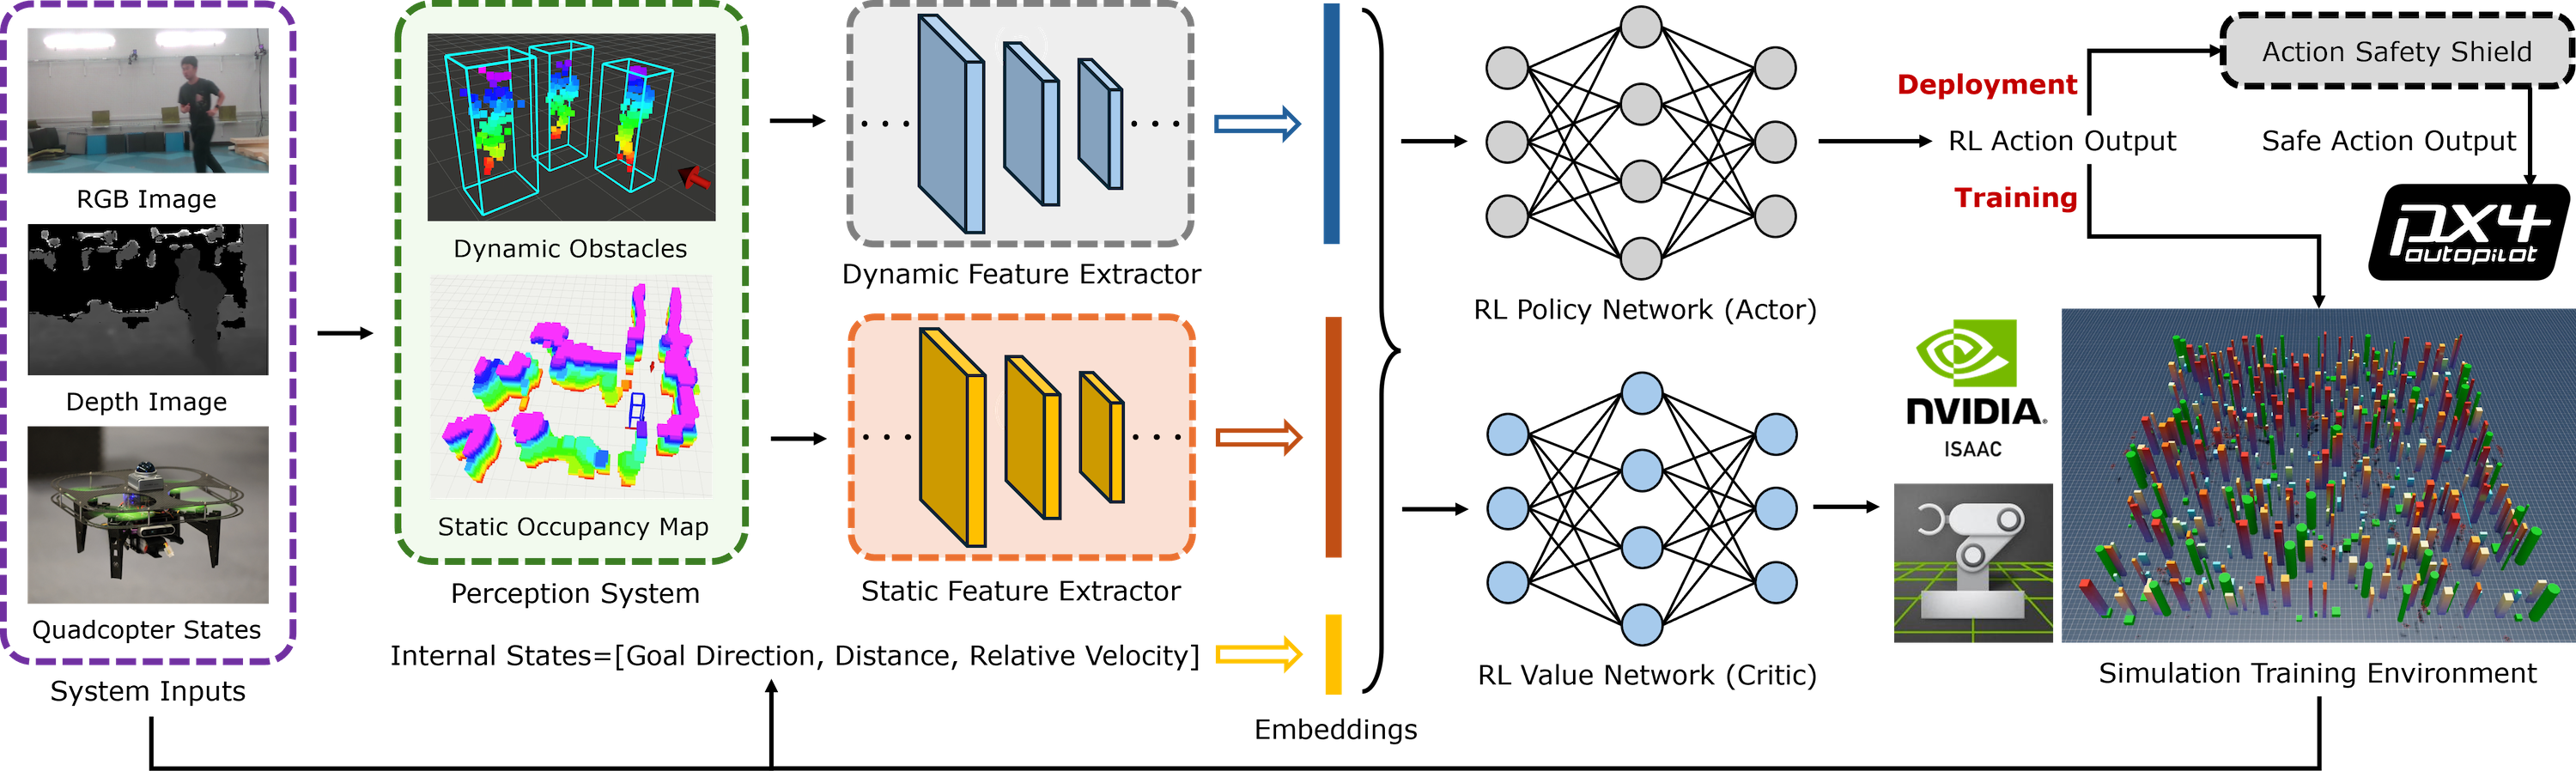
图:NavRL 框架。感知系统生成静态/动态障碍物表示,经两个 CNN 特征提取器编码后与机器人内部状态拼接,送入 Actor-Critic 网络;部署时策略输出再经安全护盾修正。
整个系统分为四块: 1. 障碍物感知系统:静态障碍 → 占据体素地图;动态障碍 → 带速度的 3D 包围盒。 2. RL 建模:状态(内部状态 + 动态 + 静态)、动作(归一化速度)、奖励(5 项加权)。 3. 网络与训练:两个 CNN 编码器 + MLP Actor/Critic,PPO,Isaac Sim 并行 + 课程学习。 4. 安全护盾:VO + 线性约束投影。
关键技术
1)静态/动态分离的感知 - 静态:固定内存的预分配体素数组,\(\mathcal{O}(1)\) 访问;每帧基于深度图递归更新占据对数概率,并用动态障碍物包围盒清除其残影。 - 动态:U-depth 检测器 + DBSCAN 检测器取相互一致结果抑制误检;3D 框重投影到图像,用轻量 YOLO 判断是否为动态物体;跟踪阶段用位置/尺寸/点云数量/点云标准差构造特征做数据关联,卡尔曼滤波(恒加速度模型)估计速度。
2)状态表示(全部在目标坐标系 \(G\) 下) - 内部状态:\(S_{int} = [\text{单位方向}, \text{到目标距离}, V_r^G]\),即 7 维。 - 动态障碍:取最近的 \(N_d\) 个,\(\mathcal{D}_i = [\text{单位方向}, \text{距离}, V^G_{o_i}, \text{dim}(o_i)]\),不足补零,组成 \(N_d \times M\) 矩阵。 - 静态障碍:从机器人位置做水平 360° × 竖直多角度的光线投射,得到 \(N_h \times N_v\) 距离矩阵;超出最大量程的射线赋值"最大量程 + 小偏移",用于区分"无障碍"。
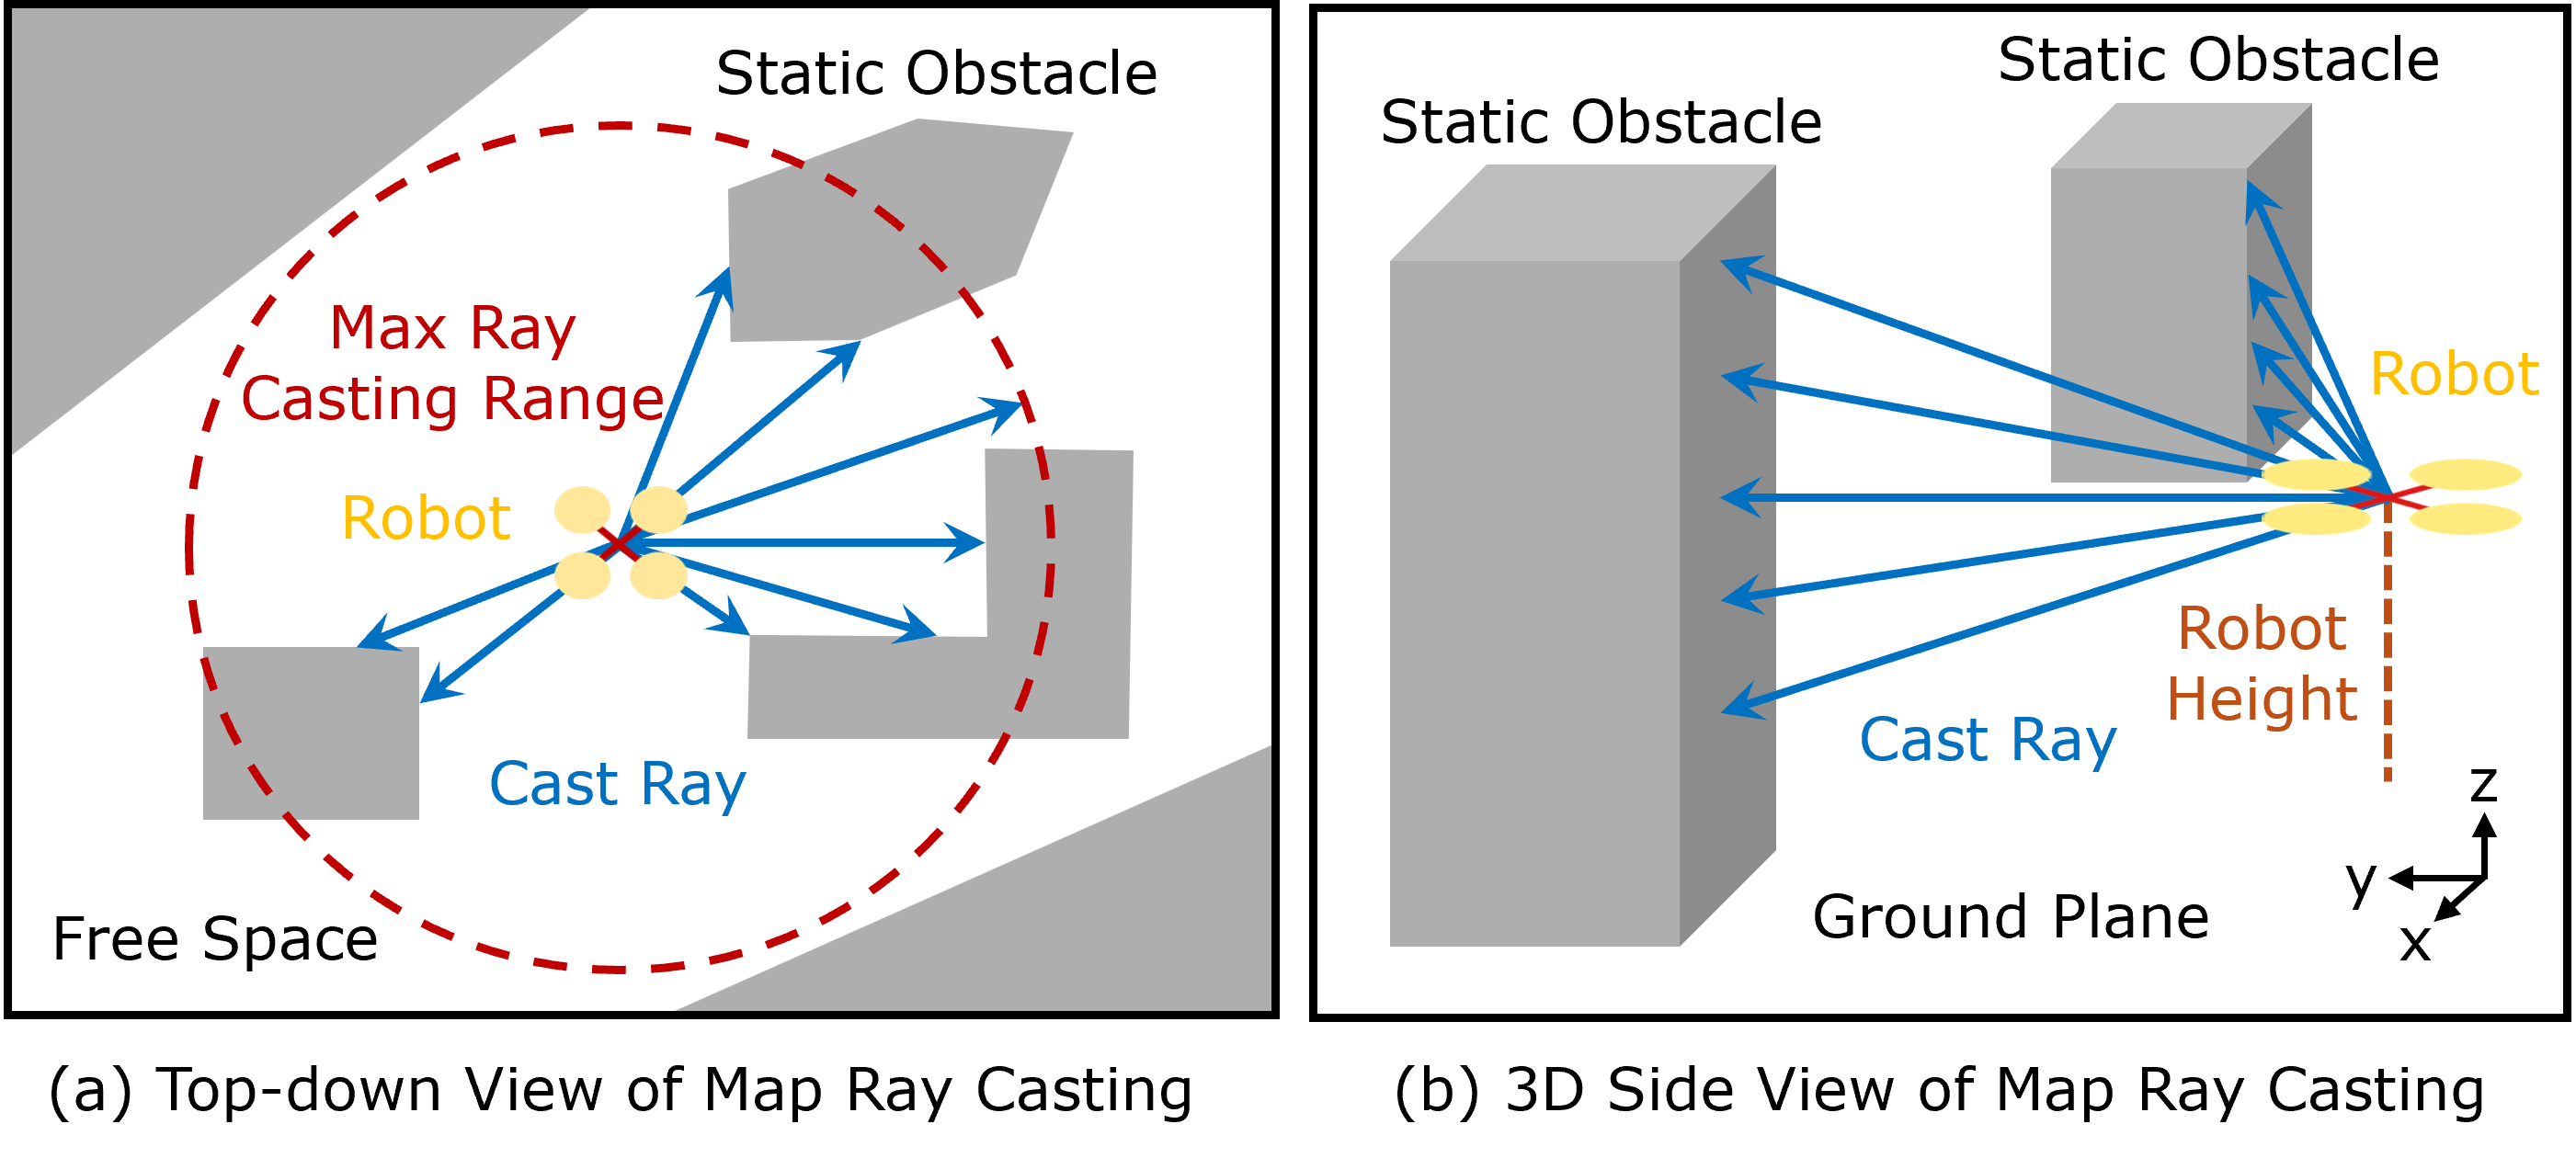
图:地图光线投射示意。(a) 水平 360° 投射的俯视图;(b) 竖直平面内光线的侧视图。
关键设计:相对位置向量拆成"单位向量 + 模长",作者报告收敛略快。光线距离矩阵在仿真与真实中都由占据地图算出,几乎没有外观域差。
3)动作:Beta 分布 + 归一化速度
网络输出每个维度 Beta 分布的 \((\alpha, \beta)\);训练时采样探索,部署时取均值 \(\alpha/(\alpha+\beta)\)。好处:有界动作空间下无截断偏差(相较高斯策略),且 \(v_{lim}\) 在部署时可直接改而无需重训。
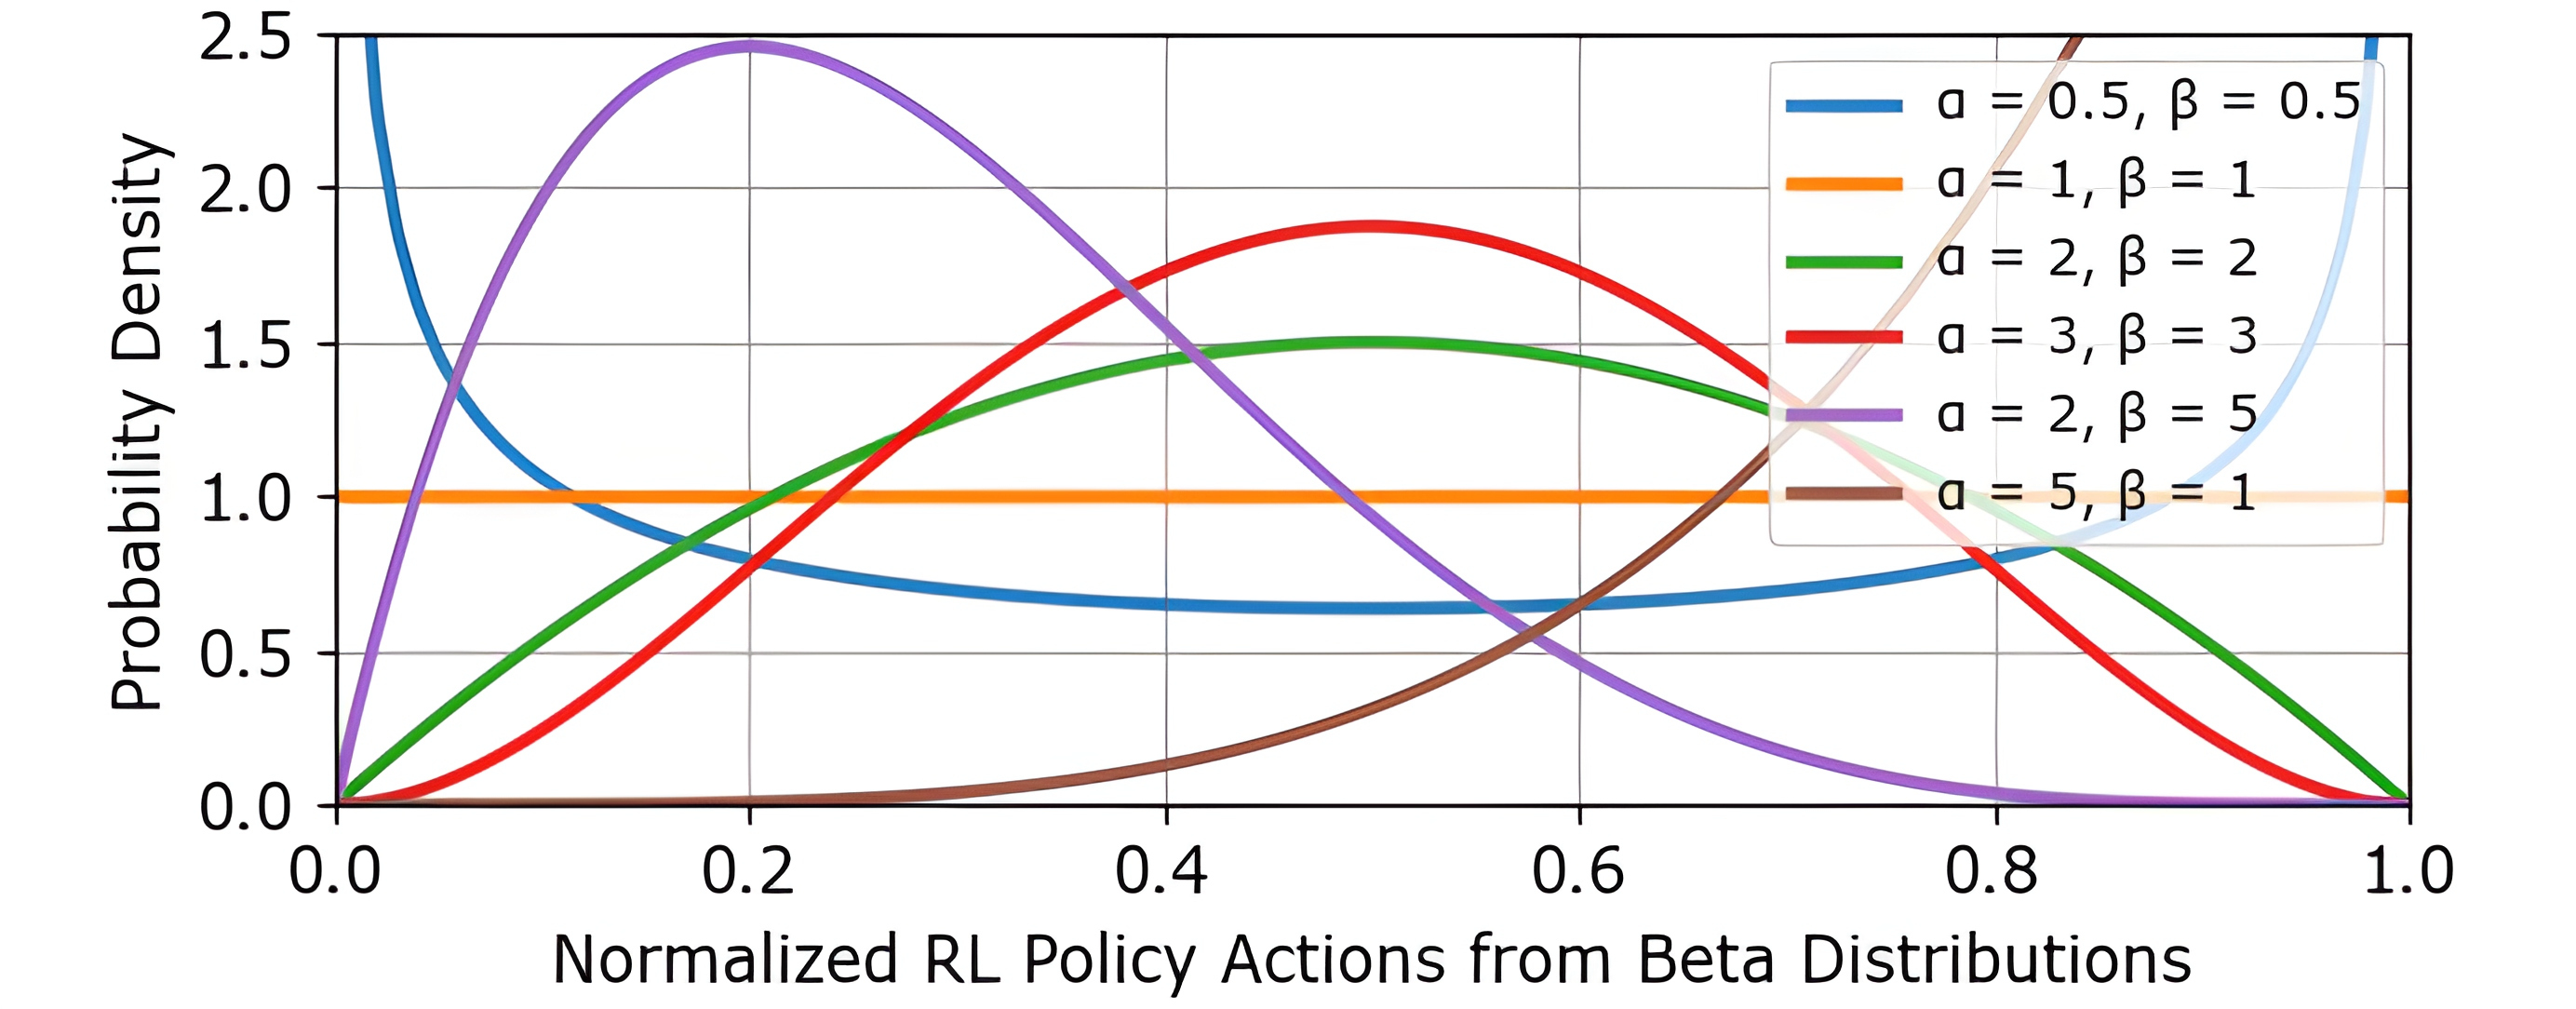
图:基于 Beta 分布的策略动作示例。
4)奖励函数
| 项 | 形式 | 作用 |
|---|---|---|
| \(r_{vel}\) | 目标方向单位向量 · 当前速度 | 鼓励朝目标快速飞行 |
| \(r_{ss}\) | 所有光线距离的平均 \(\log\) | 远离静态障碍 |
| \(r_{ds}\) | 到各动态障碍距离的平均 \(\log\) | 远离动态障碍 |
| \(r_{smooth}\) | \(-\lVert V_r(t_i)-V_r(t_{i-1})\rVert\) | 抑制速度突变 |
| \(r_{height}\) | 超出起止高度区间时的负平方偏差 | 防止靠"飞高"绕过障碍 |
\(\log\) 距离的设计使得距离越近惩罚增长越快,而远处的边际收益递减,是一种平滑的势场式安全项。
5)安全护盾(VO 投影)
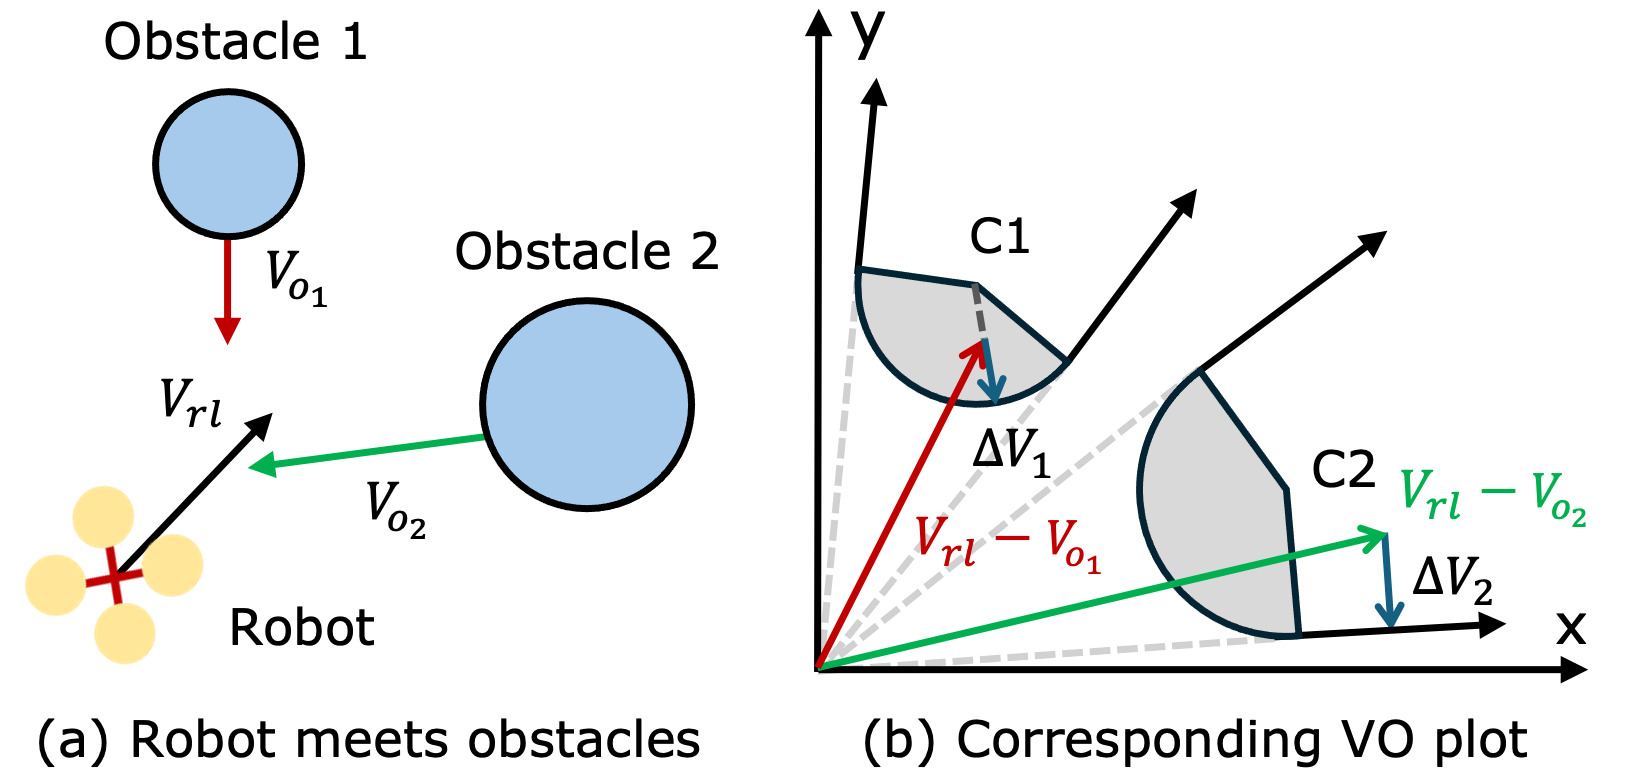
图:基于速度障碍确定安全速度区域。(a) 机器人遭遇两个障碍物;(b) 对应 VO 区域,蓝色箭头为离开 VO 所需的最小速度变化。
若策略速度 \(V_{rl}\) 落在某个 VO 内,参照 ORCA 计算离开该 VO 的最小速度变化 \(\Delta V_i\),构造半平面约束并求解:
静态障碍物用每条射线命中点构造零速度的圆球,动态障碍用一个或多个球包络。半平面近似在障碍物多时偏保守,但只在策略偶发失效时触发,对整体性能影响小。
算法流程
训练(Isaac Sim,1024 架并行):
  初始化:350 静态障碍 + 60 动态障碍的 50m×50m 类森林环境
  循环:
    每架机器人随机起点/目标 → 光线投射 + 动态障碍状态 → 策略采样 Beta 动作
    执行速度指令,计算 5 项奖励;碰撞或回合结束则重置
    PPO 更新(clip=0.1, Adam lr=5e-4, γ=0.99)
    若成功率 > 80%:动态障碍数 += 20(直到 120)

部署(Jetson Orin NX):
  深度图 → 占据地图更新(15 ms)、动态检测跟踪(27 ms)
  → 构造状态 → 策略取 Beta 均值(7 ms)
  → 若落在 VO 内则求解投影(16 ms)→ 坐标变换后下发速度
📊 实验与结果
实验设置
- 训练环境: Isaac Sim,50m×50m,350 静态 + 60→120 动态障碍;RTX 4090 训练约 10 h;最大速度 2.0 m/s。
- 网络: 静态/动态特征提取器为 3 层 CNN(嵌入维度 128 / 64),策略为两层 MLP。
- 仿真测试: Gazebo(验证 Sim-to-Sim),20m×40m 地图,静态/纯动态/混合三类环境,每种 20 次。
- 评估指标: 训练最高成功率、平均碰撞次数、各模块运行时间。
- 对比方法: EGO-Planner(基于优化的静态规划器)、ViGO(面向动态环境的视觉辅助规划器,作者团队前作)、NavRL 去掉安全护盾。
- 硬件: Intel RealSense D435i + LIO 状态估计 + Jetson Orin NX。
主要结果
课程学习效果(表 I)
| 障碍物数量 | 无课程学习 | 课程学习 |
|---|---|---|
| static=350, dynamic=60 | 94.33% | 94.33% |
| static=350, dynamic=80 | 74.51% | 82.71% |
| static=350, dynamic=100 | 62.30% | 80.96% |
| static=350, dynamic=120 | 54.98% | 68.65% |
动态障碍越多,课程学习的优势越大(100 个动态障碍时 +18.7 个百分点)。最终部署模型取自 100 动态障碍阶段的最佳权重(80.96%)。
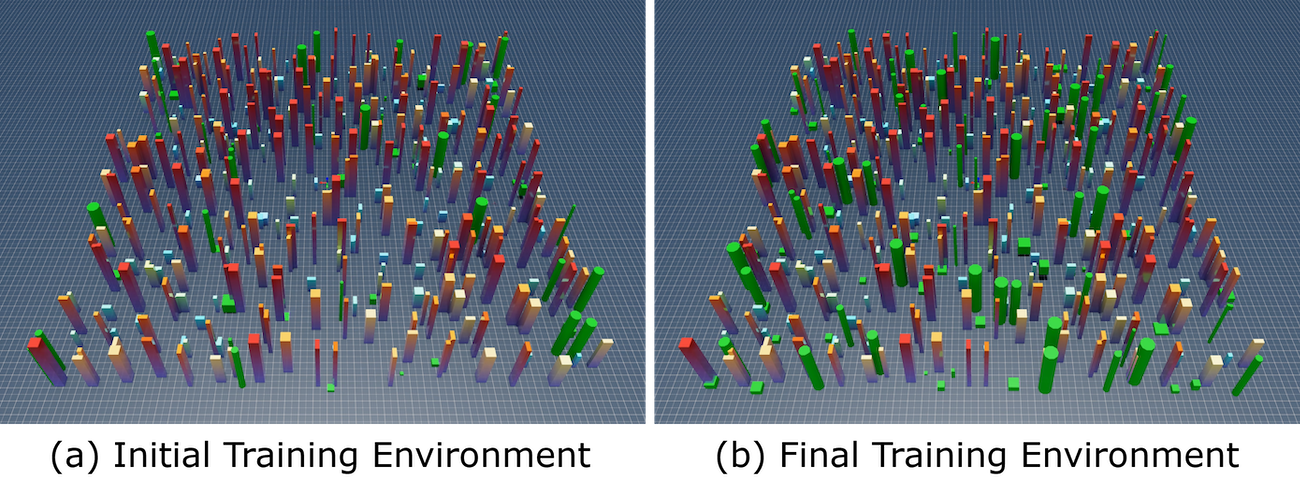
图:课程学习的初始环境(60 个动态障碍)与最终环境(120 个动态障碍)。
碰撞对比(表 II,20 次平均碰撞次数,括号为相对 ViGO)
| 方法 | 静态环境 | 动态环境 | 混合环境 |
|---|---|---|---|
| EGO | 0.45 (56.3%) | N/A | N/A |
| ViGO | 0.80 (100%) | 3.15 (100%) | 4.40 (100%) |
| 本文(无安全护盾) | 0.95 (118.8%) | 2.70 (85.7%) | 4.60 (104.5%) |
| 本文(NavRL) | 0.65 (81.3%) | 0.85 (27.0%) | 2.10 (47.8%) |
- 动态/混合环境下 NavRL 碰撞最少,动态环境碰撞仅为 ViGO 的 27%。
- 静态环境下 EGO 最好(0.45),NavRL 次之(0.65)。EGO 在动态环境中因地图更新被动态噪声污染而卡死(N/A)。
- 纯策略(无护盾)与 ViGO 大致同级,大部分收益来自安全护盾:动态环境 2.70 → 0.85,混合环境 4.60 → 2.10。
运行时间(表 III)
| 系统模块 | GeForce RTX 4090 | Jetson Orin NX |
|---|---|---|
| 静态感知 | 8 ms | 15 ms |
| 动态感知 | 11 ms | 27 ms |
| RL 策略网络 | 1 ms | 7 ms |
| 安全护盾 | 2 ms | 16 ms |
机载端各模块都在 30 ms 以内,满足实时需求。
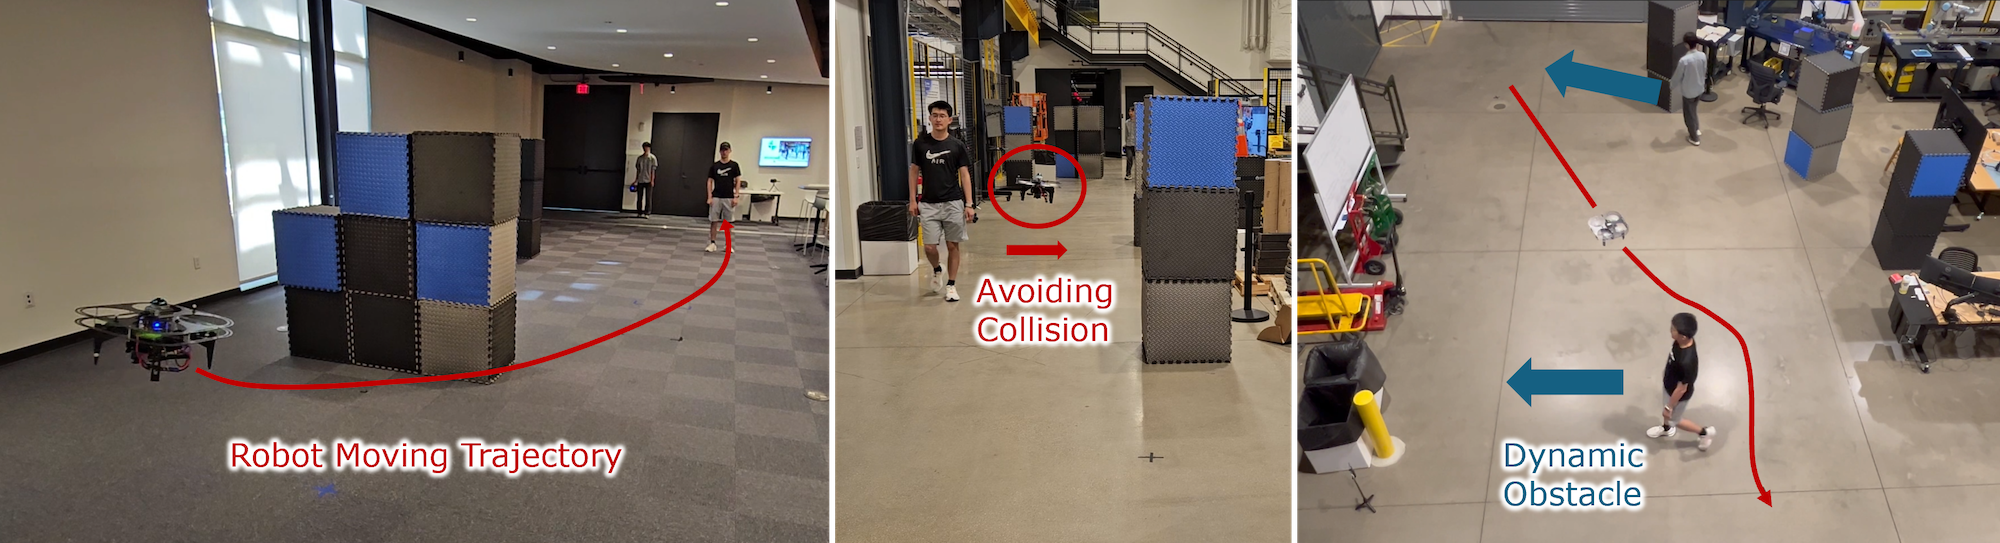
图:实物飞行测试示例,机器人在静态障碍与迎面行人之间安全穿行。
消融实验
- 课程学习:见表 I,有效提升高密度动态环境下的成功率。
- 并行机器人数量:训练曲线显示机器人越多收敛越快、最终回报越高;1024 架为 4090 显存上限。
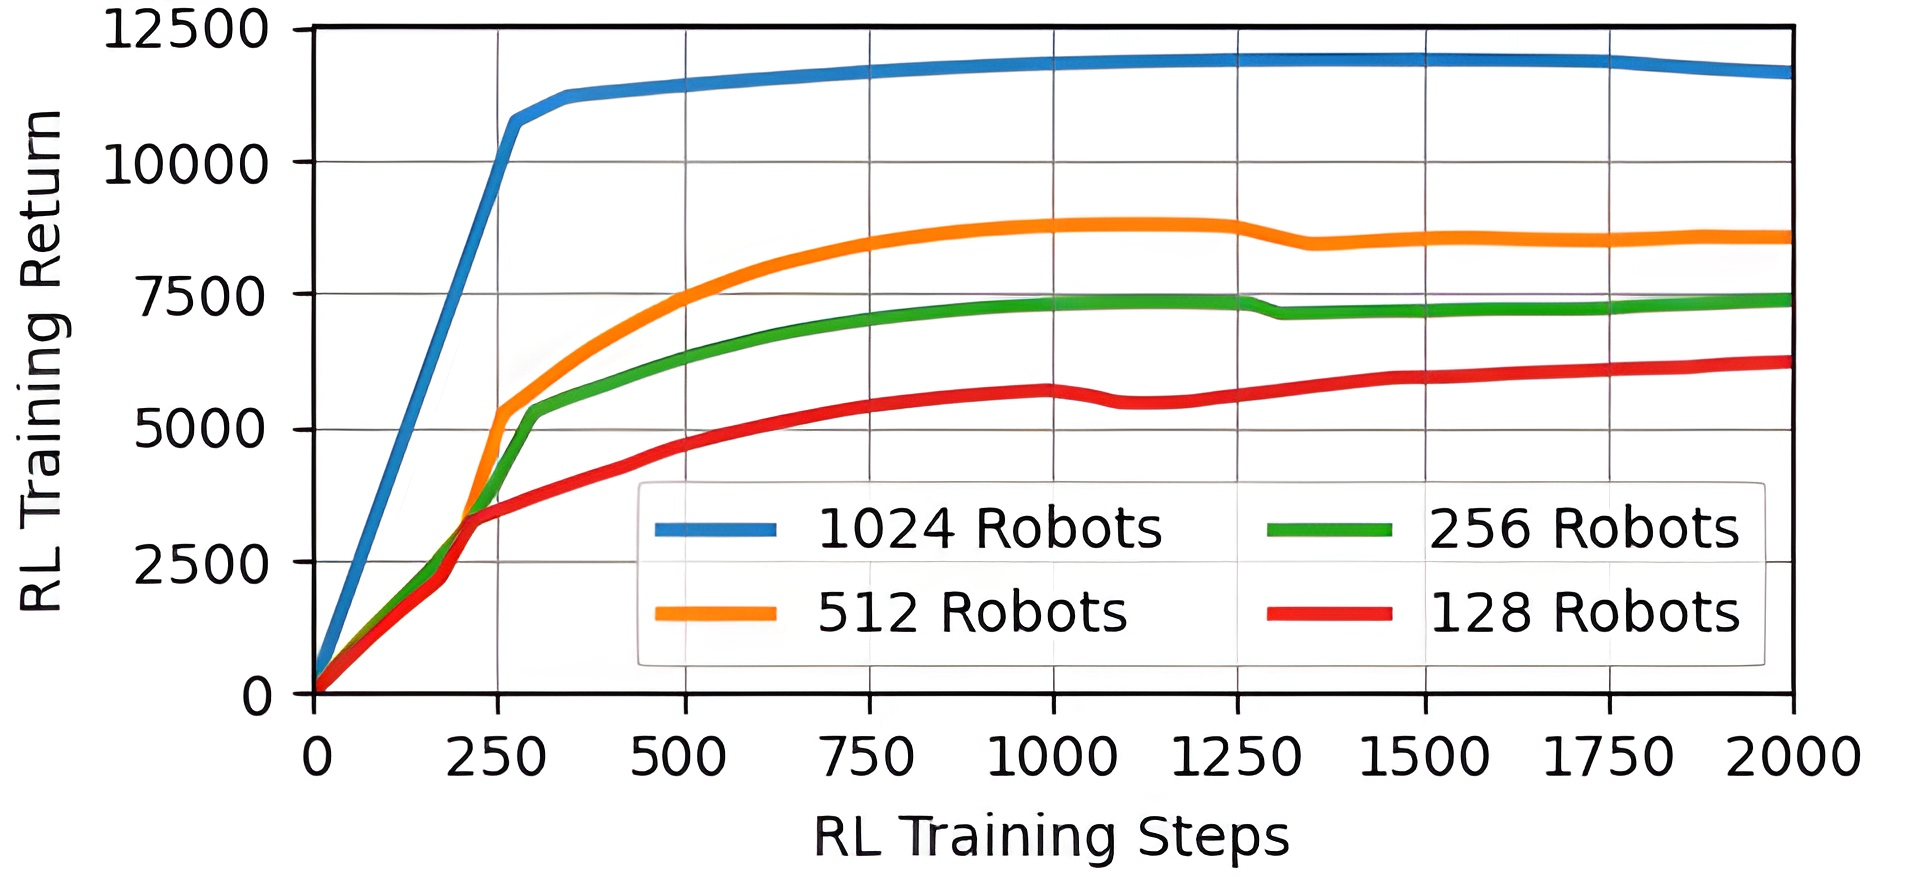
图:不同并行机器人数量下的平滑平均训练回报曲线。
- 安全护盾:见表 II 的"无安全护盾"行,在三类环境中都减少碰撞。
- 论文未对状态表示中的"单位向量 + 模长拆分"、目标坐标系、Beta vs 高斯等设计给出定量消融,仅有定性陈述。
💡 关键见解
理论分析
- 表示即迁移:Sim-to-Real 差距主要来自传感外观。把策略输入换成由占据地图派生的几何量(射线距离、障碍物相对状态),差距就被推给了感知模块,而感知模块是经典、可单独调试的。这本质上是"模块化感知 + 学习化决策"的折中路线。
- 目标坐标系相当于做了一次旋转/平移不变性归一化,把"朝目标飞"简化为"朝 +x 方向飞",减少策略需要学习的对称性。
- 安全护盾与策略解耦:护盾只在 VO 冲突时介入、求最小修改量,类似于安全滤波器(Safety Filter)思路;它不改变训练,因此不会影响策略的探索行为,但也意味着策略本身并不"知道"护盾存在。
实践启示
- 对机载算力有限的无人机,"轻量感知 + 小 MLP 策略 + 解析安全层"可在 Orin NX 上跑满实时,是可落地的工程范式。
- 有界动作用 Beta 分布、速度上限做后缩放,部署时可以直接调速度上限而不重训,对工程调参友好。
- 在 Isaac Sim 中大规模并行 + 简单课程(按成功率阈值加障碍)就能显著提升高难度场景表现,成本低、易复现。
🔍 局限性与未来工作
当前局限
- 评测规模小:每种环境仅 20 次,没有报告方差/置信区间;对比基线只有两个规则方法,缺少其他 RL 导航方法(如 Agile But Safe、OmniDrones 上的策略)的对比。
- 纯策略不占优:无护盾的 NavRL 在静态与混合环境中甚至不如 ViGO,说明安全性能很大程度依赖手工设计的 VO 护盾,"学习"部分的贡献需要更细的拆解。
- 依赖感知质量:动态障碍检测跟踪误差(误检、漏检、速度估计偏差)直接进入状态与护盾;论文未分析感知噪声对策略的影响,也未在训练中注入感知噪声的说明。
- 固定 \(N_d\) 与球形近似:最近 \(N_d\) 个动态障碍的截断和球体包络在密集人群或细长障碍下可能失真;半平面约束在多障碍时偏保守,可能导致无可行解或冻结行为,论文未讨论不可行情况的处理。
- 奖励权重 \(\lambda_i\)、射线分辨率、\(N_d\) 等关键超参数未给出,复现需参考开源代码。
- 速度级控制:忽略了四旋翼动力学约束(加速度/姿态),在高速或激进机动时可能不足。
- 公式中有小笔误(如 \(r_{vel}\) 式中 "where \(P_g, P_s, V_r\)" 应为 \(P_r\)),不影响理解。
未来方向
- 作者提出:改进框架并适配更多机器人平台(如地面机器人、腿式机器人)。
- 可延伸方向:
- 将安全护盾纳入训练(Shielded RL / 可微安全层),让策略学会规避触发护盾。
- 引入障碍物轨迹预测(而非仅当前速度)以提升对行人意图的反应。
- 在训练中模拟感知噪声和延迟,提升真实场景鲁棒性。
- 从速度控制推进到加速度/姿态/推力控制,追求更敏捷的飞行。
- 结合多机协同(ORCA 式互惠避碰)扩展到多无人机场景。
📚 相关工作对比
| 方法 | 核心思想 | 优势 | 劣势 |
|---|---|---|---|
| EGO-Planner [48] | 无 ESDF 的梯度优化局部规划 | 静态环境碰撞最少、成熟稳定 | 不处理动态障碍,动态噪声下地图更新卡死 |
| ViGO [20] | 视觉辅助动态障碍检测 + B 样条轨迹优化 | 显式考虑动态障碍 | 近距离障碍反应不够快,参数多 |
| Agile But Safe [42] | RL 策略 + 可达-规避恢复策略 | 高速且有安全保障 | 把动态障碍当静态,面向腿式机器人 |
| 可达性动作投影 [13] | 基于可达集将不安全动作投影 | 可证明安全 | 需预计算可达集,维度灾难 |
| 本文方法(NavRL) | 几何状态表示 + Beta PPO + VO 安全护盾 | 零样本 Sim-to-Real、动态环境碰撞最少、机载实时 | 依赖感知模块与手工护盾,评测规模有限 |
🎓 个人评价
优点
- 系统完整:从感知、策略到安全层和实机部署全链路打通,并开源,工程价值高。
- 设计务实:状态表示、目标坐标系、Beta 动作、课程学习都是简单但有效的工程选择,迁移性好。
- 安全护盾计算轻量(机载 16 ms),对动态环境碰撞下降明显(2.70 → 0.85)。
可改进之处
- 定量实验偏少,缺少更多 RL 基线、统计显著性、成功率/路径长度/飞行时间等多维指标。
- 对"策略 vs 护盾"各自贡献的分析不足;无护盾策略的表现并不突出。
- 关键超参数(奖励权重、射线配置)未在正文披露。
推荐阅读对象
- 做无人机/移动机器人 RL 导航、关注 Sim-to-Real 的研究者与工程师。
- 想了解如何把经典方法(VO/ORCA)作为 RL 安全层的读者。
- 使用 Isaac Sim/Isaac Lab 做大规模并行机器人训练的开发者。
📎 附录
重要公式
MDP 目标:
静态障碍表示:
静态安全奖励:
高度奖励:
术语表
| 英文 | 中文 |
|---|---|
| Unmanned Aerial Vehicle (UAV) | 无人机 |
| Proximal Policy Optimization (PPO) | 近端策略优化 |
| Velocity Obstacle (VO) | 速度障碍 |
| Optimal Reciprocal Collision Avoidance (ORCA) | 最优互惠避碰 |
| Safety Shield | 安全护盾 |
| Sim-to-Real Transfer | 仿真到现实迁移 |
| Zero-shot Transfer | 零样本迁移 |
| Ray Casting | 光线投射 |
| Occupancy Voxel Map | 占据体素地图 |
| Curriculum Learning | 课程学习 |
| Actor-Critic | 演员-评论家 |
| Goal Coordinate Frame | 目标坐标系 |
| LiDAR Inertial Odometry (LIO) | 激光雷达惯性里程计 |
参考资源
- 论文原文: arXiv链接
- 中文翻译 PDF: paper_cn.pdf
- 中文 Markdown 译文: paper_cn.md
- 代码实现: https://github.com/Zhefan-Xu/NavRL
- 实验视频: https://youtu.be/EbeJW8-YlvI