论文技术报告:SimpleVLN:迈向简洁而前沿的视觉-语言导航
arXiv ID: 2610.23203 原文标题: SimpleVLN: Towards Simple and Frontier Vision-Language Navigation 翻译日期: 2026-10-21
📋 论文概览
基本信息
- 作者: Lingyi Hong*†、Weiren Cai*、Jiayu Chen*、Xinyu Zhou†‡、Bailin He、Yunfei Guo、Qiao Sun、Boyu Ma、Jianfei Yang、Wenqiang Zhang(*同等贡献,†共同项目负责人,‡通讯作者)
- 机构: 复旦大学、南洋理工大学、联想研究院
- 发表时间: 2026 年 10 月(arXiv 预印本,NeurIPS 2026 模板)
- 领域: 具身智能 / 视觉-语言导航(VLN-CE)/ 多模态大模型后训练
核心贡献
- 不改架构:直接用现成 MLLM(Qwen2.5-VL / Qwen3-VL / Qwen3.5)做连续环境 VLN,不加 3D 编码器、拓扑图、双系统等任务专用模块,可以直接复用现有的 MLLM 推理框架。
- 决策级形式化:单轮决策输入 + 固定预算的全局--局部视觉记忆(\(M=8\) 帧全局、\(N=1\) 帧局部、1 帧当前)+ 动作块输出。
- 数据与训练流程:R2R + RxR + ScaleVLN 专家示范 → 基于偏离度的 DAgger → 在训练场景中重新合成 RL 任务,配合渐进式 IL→DAgger→RL 优化,奖励为二值成功奖励。
- SOTA 结果:Qwen3.5-9B 版本在 R2R-CE val-unseen 达到 76.7 SR,在 RxR-CE 达到 80.1 SR,仅使用单目 RGB;4B 模型每次决策延迟 293 ms。
🎯 研究背景与动机
问题定义
在连续环境(Habitat + Matterport3D)中,智能体每步获得一张以自我为中心的 RGB 图像,从动作空间 \(\{\text{Forward}(0.25\text{m}), \text{TurnLeft}(15^\circ), \text{TurnRight}(15^\circ), \text{Stop}\}\) 中选择动作,执行 Stop 时若距目标 3 m 以内即判为成功。
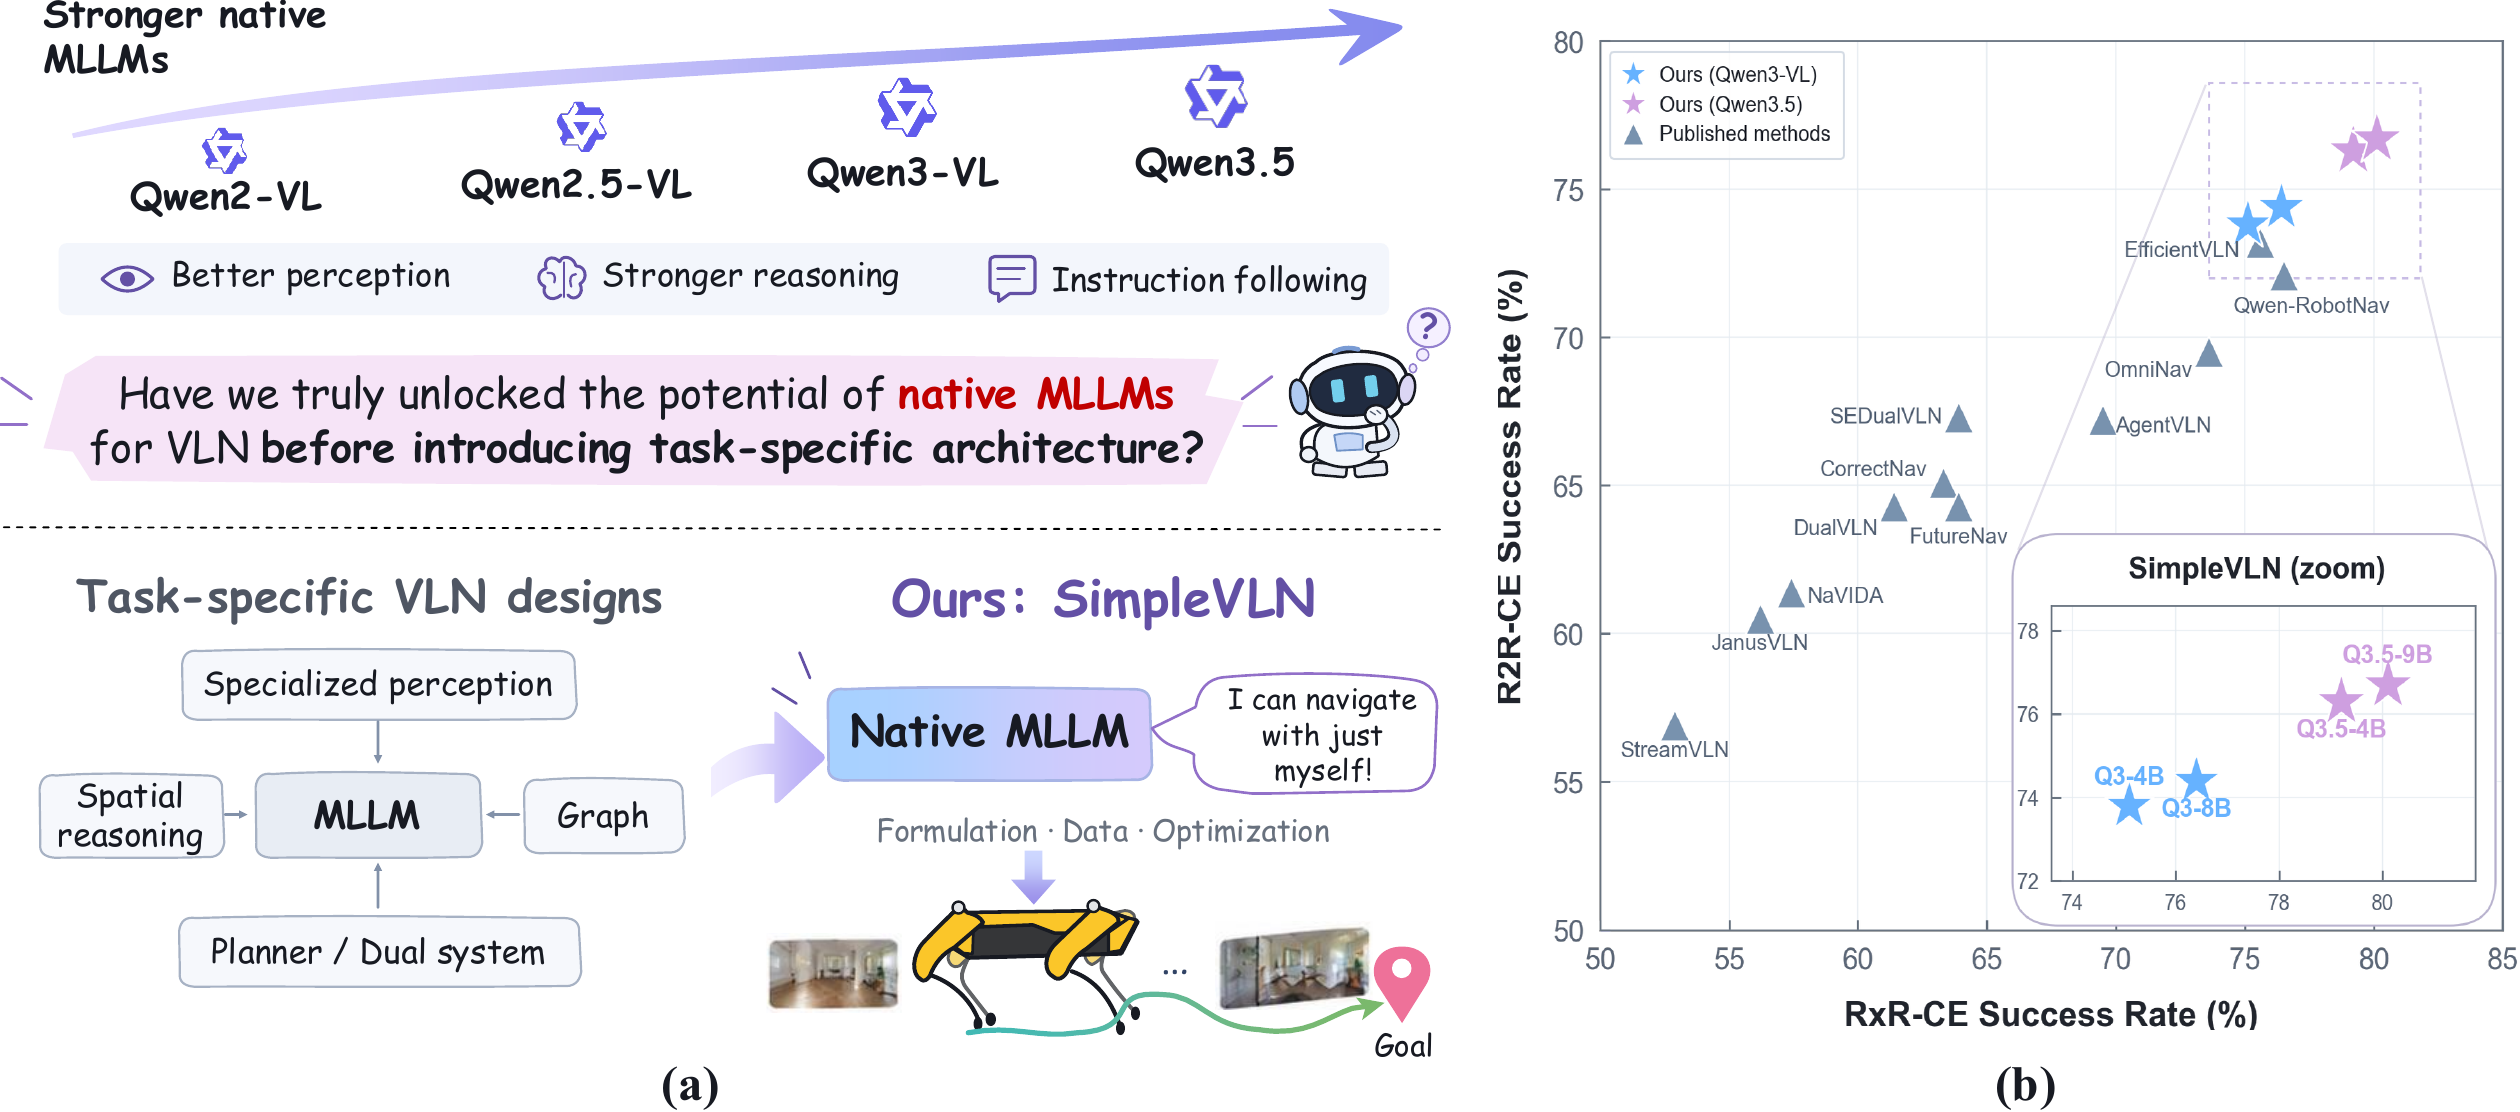
图 1:SimpleVLN 的动机(a)以及与现有方法在 R2R-CE / RxR-CE 上的对比(b)。
现有方法的局限性
- 近期基于 MLLM 的 VLN 方法(StreamVLN、JanusVLN、DualVLN、AgentVLN、OmniNav 等)普遍叠加流式 KV 缓存、3D 几何编码器、双系统规划器或显式 CoT 等任务专用组件。系统性能是“骨干 + 附加模块”的混合结果,原生 MLLM 本身能做到多好并不清楚。
- 附加模块带来额外延迟(JanusVLN 906 ms、FutureNav 1141 ms),也破坏了与 vLLM 等标准推理框架的兼容性。
- 多轮对话式输入让上下文随回合无界增长,模型难以有效利用(多轮仅 35.7 SR)。
本文的创新点
本文的新意不在于提出新模块,而在于说明:只要把形式化、数据、优化三件事做对,原生 MLLM 就能超过带专用架构的方法。这是一篇“做减法”的系统性经验研究。
🔬 方法论
整体架构
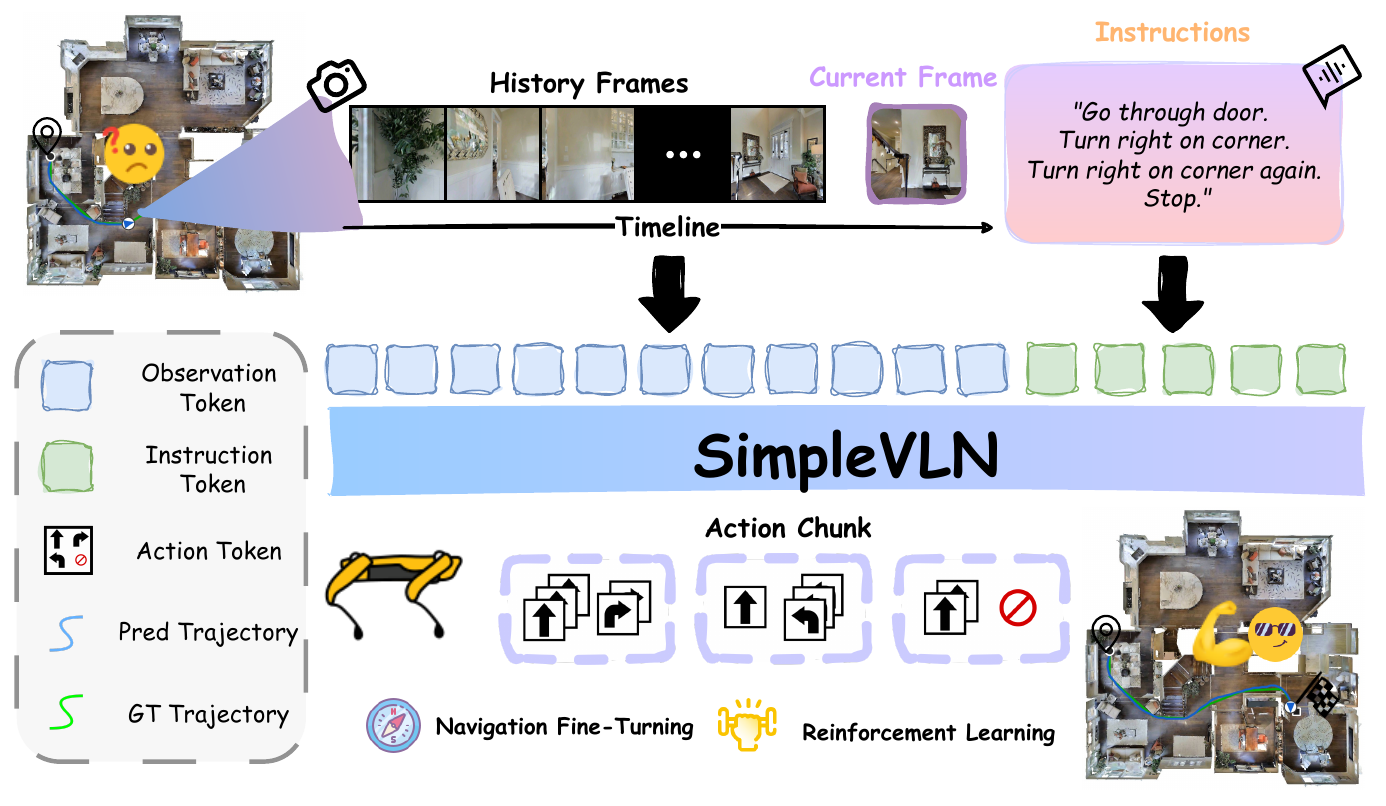
图 2:SimpleVLN 概览。历史帧、当前帧与指令一起作为单轮输入送入 MLLM,模型直接输出动作块。
模型就是一个标准 MLLM:输入 = 指令 \(\mathcal{I}\) + 当前观测 \(o_t\) + 采样历史 \(H_t\),输出 = 以文本 token 表示的动作块 \(a_t\)。没有任何额外网络结构。
关键技术
1. 单轮决策输入。 每次决策都重新构造一个独立的 prompt,不保留以往的对话轮次和动作文本。上下文大小因此与回合长度无关。
2. 全局--局部历史选择。 设决策 \(t\) 前已执行 \(n_t\) 个原子动作: - 局部历史 \(L_t\):紧邻当前帧之前的 \(N\) 帧; - 全局历史 \(G_t\):从更早的帧中均匀采样至多 \(M\) 帧,并保持时间顺序; - \(H_t = G_t \Vert L_t\),单次决策至多使用 \(N+M+1\) 张图。
默认 \(M=8, N=1\),即每次决策最多 10 张图。一个关键细节是,历史按原子步采样,而不是按动作块边界采样(Primitive(8) 53.6 vs Chunk 46.3)。
3. 动作分块。 沿用 NaVIDA,模型一次输出一个有序原子动作序列 \(a_t=(u_{n_t},\dots,u_{n_t+K_t-1})\),环境执行完整个块后再重新查询模型。这一改动带来 +8.0 SR,同时减少了模型调用次数。
4. 数据构建。
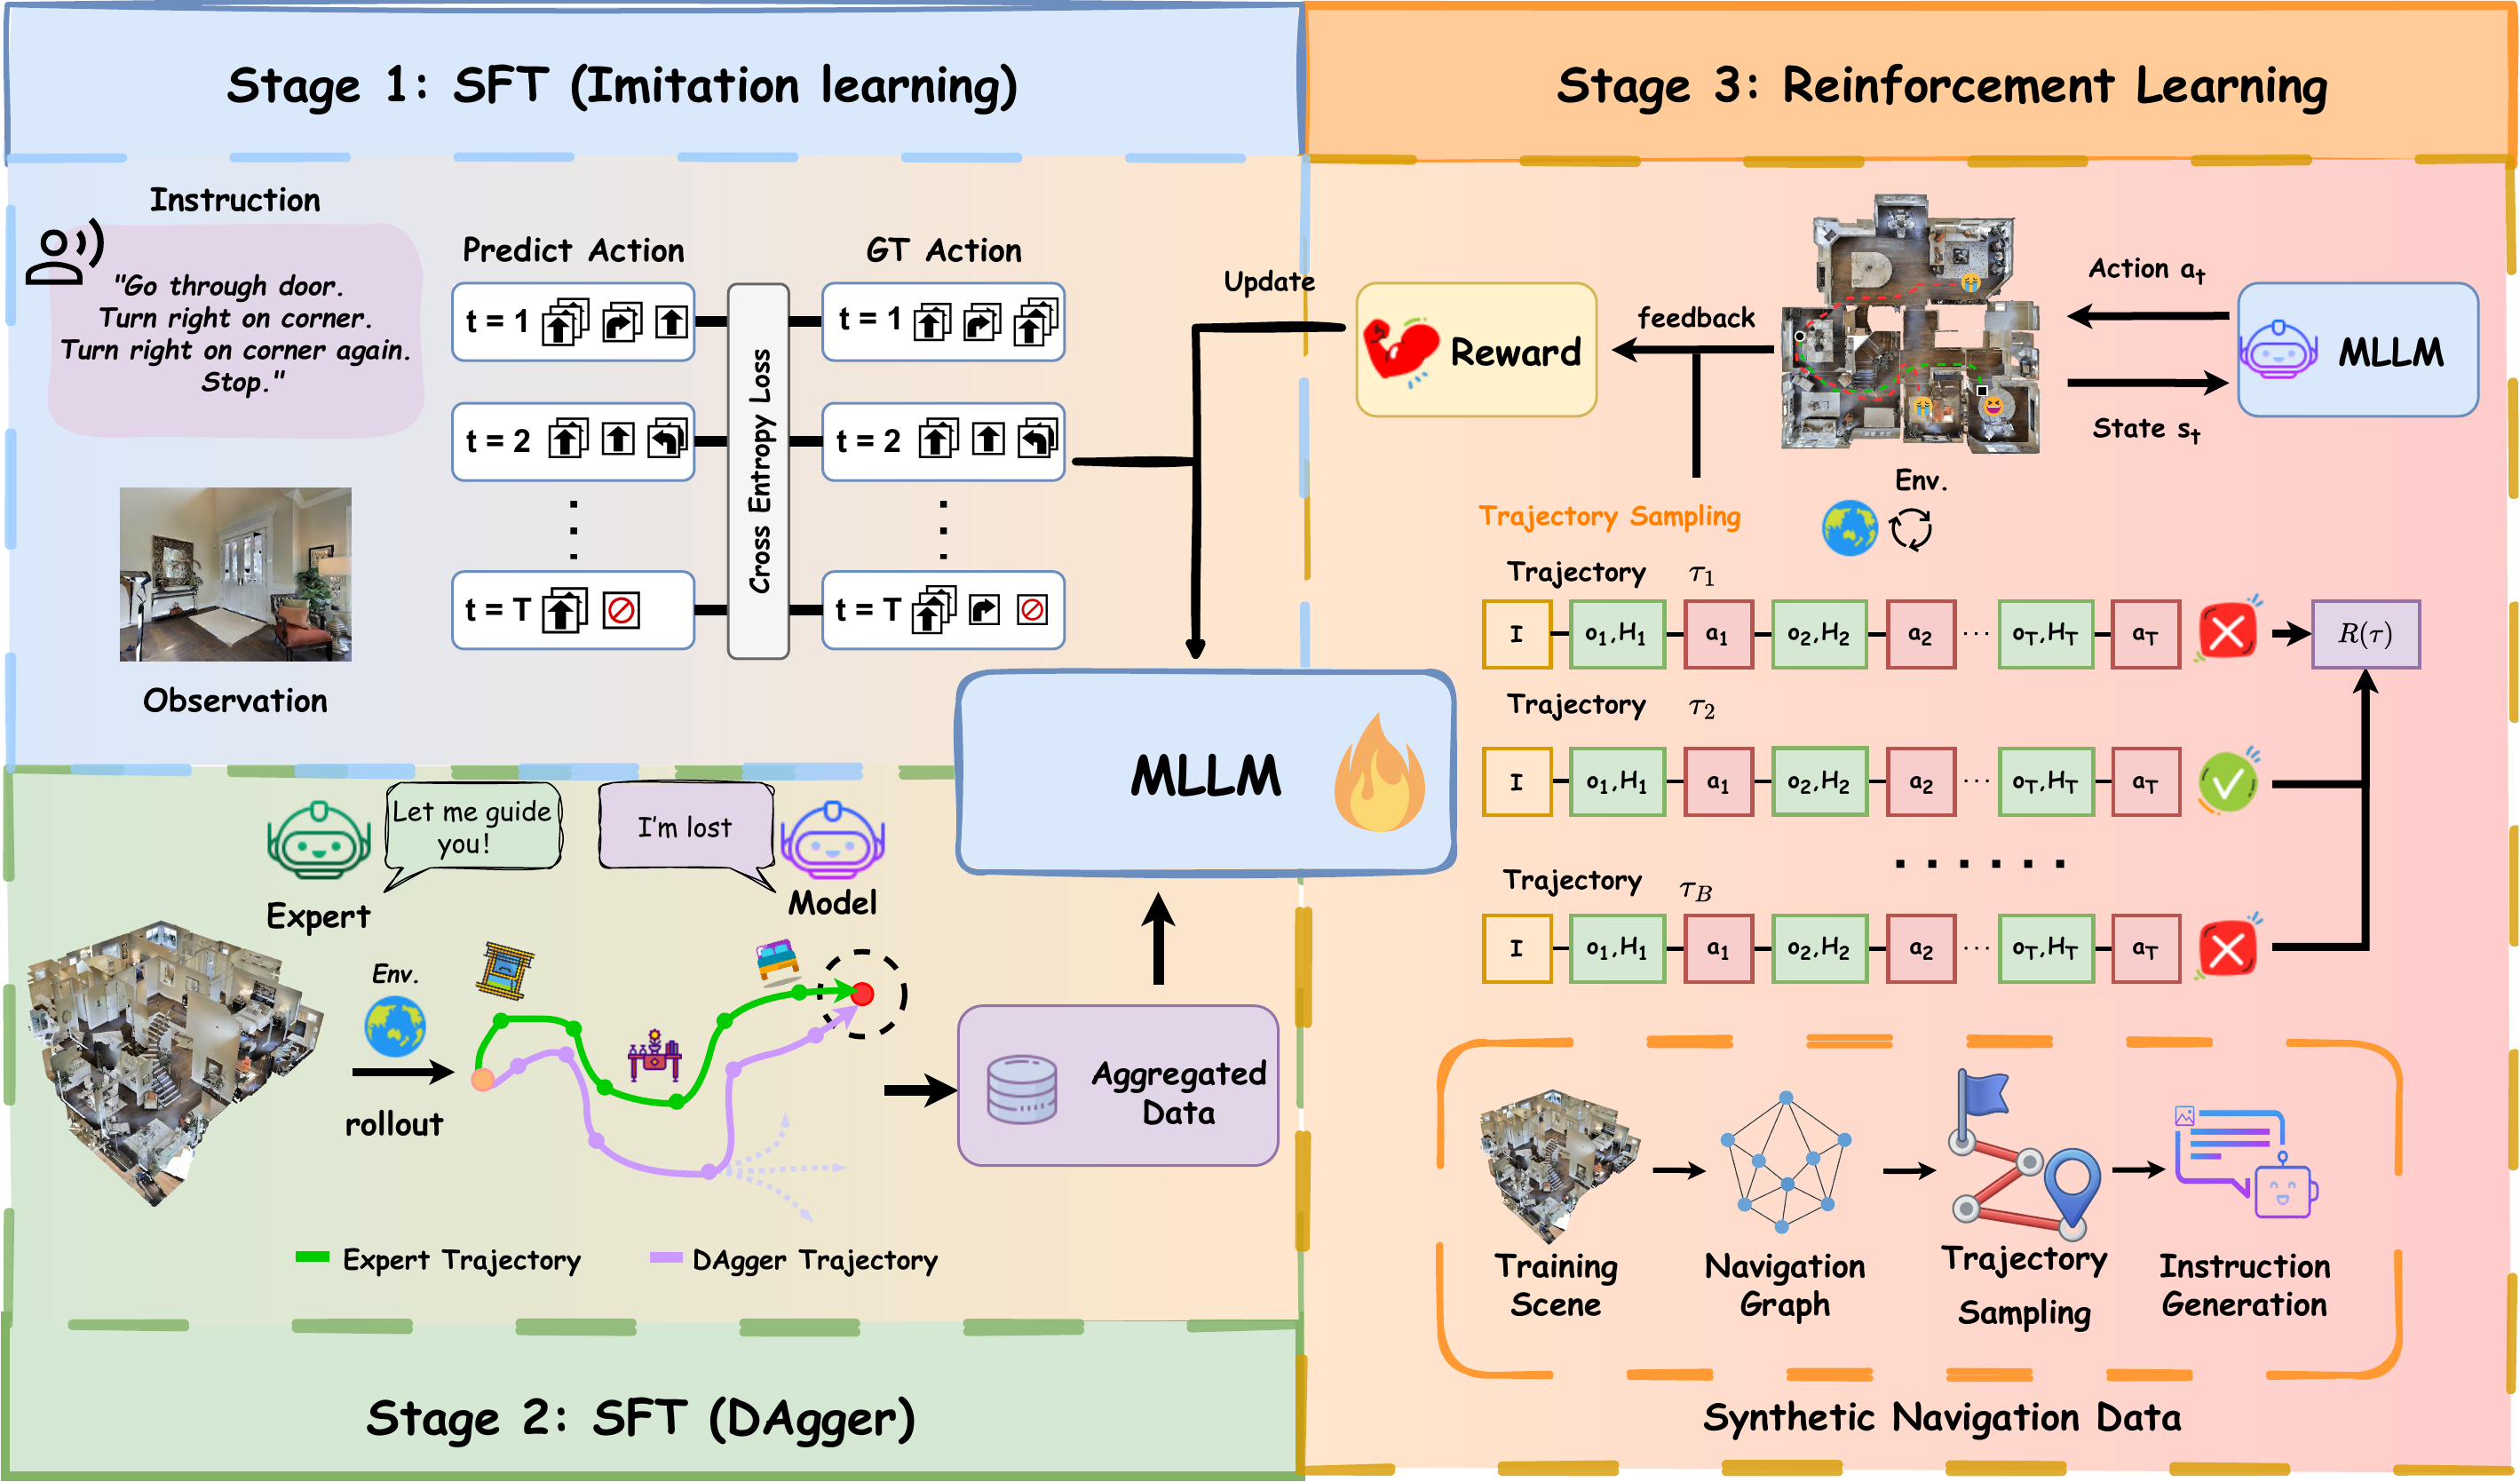
图 3:训练数据流程:专家示范 → DAgger 纠正轨迹聚合 → 合成 RL 回合 + 环境交互。
- 专家示范:R2R(141k)、RxR(411k)、ScaleVLN(1,699k)样本(数据规模见源码注释);
- DAgger:比较策略轨迹与 GT 轨迹,偏离大时用专家轨迹,否则保留策略轨迹;共收集 R2R DAgger 930k、RxR DAgger 361k 样本;
- RL 任务合成:在三个数据集的训练场景(排除 val-unseen 场景)中,从导航图采样跨房间的起点--终点对,终点关联语义物体,再由 MLLM 根据路点描述生成指令。参考路径只用来构造任务,不作为动作监督。
算法流程
- IL(SFT):在 R2R+RxR 上训练 3 个 epoch,冻结视觉编码器,峰值学习率 2e-5,损失为动作块的负对数似然 \(\mathcal{L}_{\mathrm{SFT}}\);
- DAgger:在 DAgger 数据 + R2R/RxR 上训练 1 个 epoch,再加入 ScaleVLN 训练 2 个 epoch;
- RL:DAPO,40 步,batch 256,每个 prompt 16 次 rollout,学习率 1e-6,KL=0,clip 0.30/0.20;奖励 \(R(\tau)=\mathbb{I}(\text{success})\)。
📊 实验与结果
实验设置
- 数据集: R2R-CE、RxR-CE(val-unseen),Habitat + Matterport3D
- 评估指标: NE、OS、SR(主指标)、SPL、nDTW
- 对比方法: NaVid、Uni-NaVid、NaVILA、ActiveVLN、StreamVLN、NavFoM、JanusVLN、NaVIDA、CorrectNav、DualVLN、FutureNav、AgentVLN、OmniNav、SEDualVLN、Qwen-RobotNav、Efficient-VLN
主要结果
| 方法 | 规模 | 观测 | R2R SR | R2R SPL | RxR SR | RxR nDTW |
|---|---|---|---|---|---|---|
| StreamVLN | 7B | S.RGB | 56.9 | 51.9 | 52.9 | 61.9 |
| DualVLN | 7B | S.RGB | 64.3 | 58.5 | 61.4 | 70.0 |
| CorrectNav | 7B | S.RGB | 65.1 | 62.3 | 69.3 | 75.2 |
| Qwen-RobotNav | 8B | 全景 | 72.1 | 66.6 | 76.5 | 72.5 |
| Efficient-VLN | 8B | S.RGB | 73.2 | 65.0 | 75.6 | - |
| SimpleVLN* (Qwen3-VL) | 4B | S.RGB | 73.8 | 66.7 | 75.1 | 71.5 |
| SimpleVLN* (Qwen3.5) | 4B | S.RGB | 76.3 | 72.3 | 79.2 | 80.3 |
| SimpleVLN (Qwen3.5)* | 9B | S.RGB | 76.7 | 72.6 | 80.1 | 79.8 |
- RL 的增益在所有骨干上都很大:Qwen3-VL 4B 在 R2R 上 65.4→73.8(+8.4),在 RxR 上 63.4→75.1(+11.7);Qwen3.5 9B 在 R2R 上 69.2→76.7,在 RxR 上 64.0→80.1(+16.1)。
- 仅用单目 RGB 的 SimpleVLN 超过了使用全景观测的 Qwen-RobotNav 和 OmniNav。
- 效率:4B 模型单次动作块决策 293 ms(A100),与 StreamVLN(300 ms)相当,明显快于 DualVLN(683 ms)、JanusVLN(906 ms)和 FutureNav(1141 ms)。
消融实验
形式化(Qwen3-VL 4B,仅 R2R 微调)
| 消融项 | 对照 | 默认 | SR 变化 |
|---|---|---|---|
| 输出格式 | 原子动作 45.6 | 动作块 53.6 | +8.0 |
| 对话格式 | 多轮 35.7 | 单轮 53.6 | +17.9 |
| 观测采样 | Chunk 边界 46.3 / 全部原子帧 51.9 | 均匀 8 帧 53.6 | +1.7~7.3 |
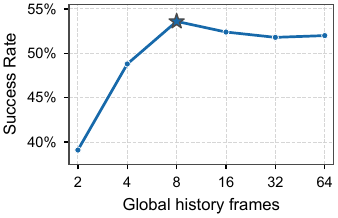
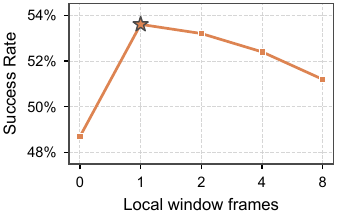
图 4:记忆预算。\(N=1\) 时 SR 在 \(M=8\) 处达到峰值;\(M=8\) 时 \(N=1\) 最优,局部帧越多反而越差。
数据构建(Qwen3-VL 4B)
| 训练数据 | R2R SR | RxR SR |
|---|---|---|
| R2R | 53.6 | 50.3 |
| + RxR | 56.7 | 54.5 |
| + ScaleVLN | 57.9 | 55.3 |
| + DAgger | 65.4(+7.5) | 63.4(+8.1) |
DAgger 是监督阶段收益最大的一步;ScaleVLN 的大规模数据只带来约 1 个点的提升。
RL 任务来源(GRPO,batch 32):只用单一场景池合成任务时 SR 为 66.6~68.5(R2R),三池混合为 70.1 / 71.0,说明任务多样性有帮助。
奖励与算法
| 配置 | R2R SR | RxR SR |
|---|---|---|
| RL 前 | 65.4 | 63.4 |
| GRPO + SPL 奖励 | 68.9 | 67.7 |
| GRPO + 二值成功奖励 | 70.1 | 71.0 |
| DAPO + 二值成功奖励 | 71.5 | 73.7 |
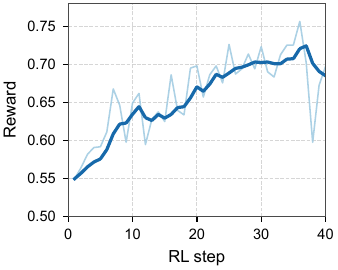
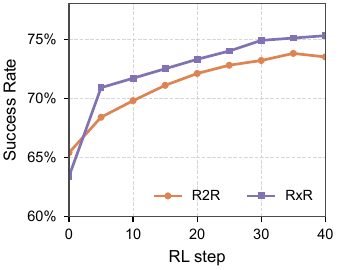
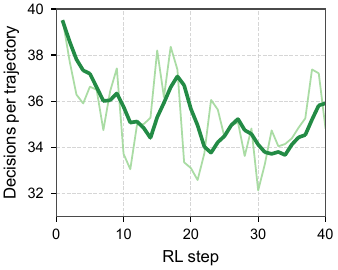
图 5:RL 训练动态:rollout 奖励与评估 SR 上升,每条轨迹的动作块决策次数下降。
真实机器人:Daystar 四足机器人 + Jetson Thor 机载推理 + RealSense D450(仅用 RGB),能完成多步指令导航(定性展示)。
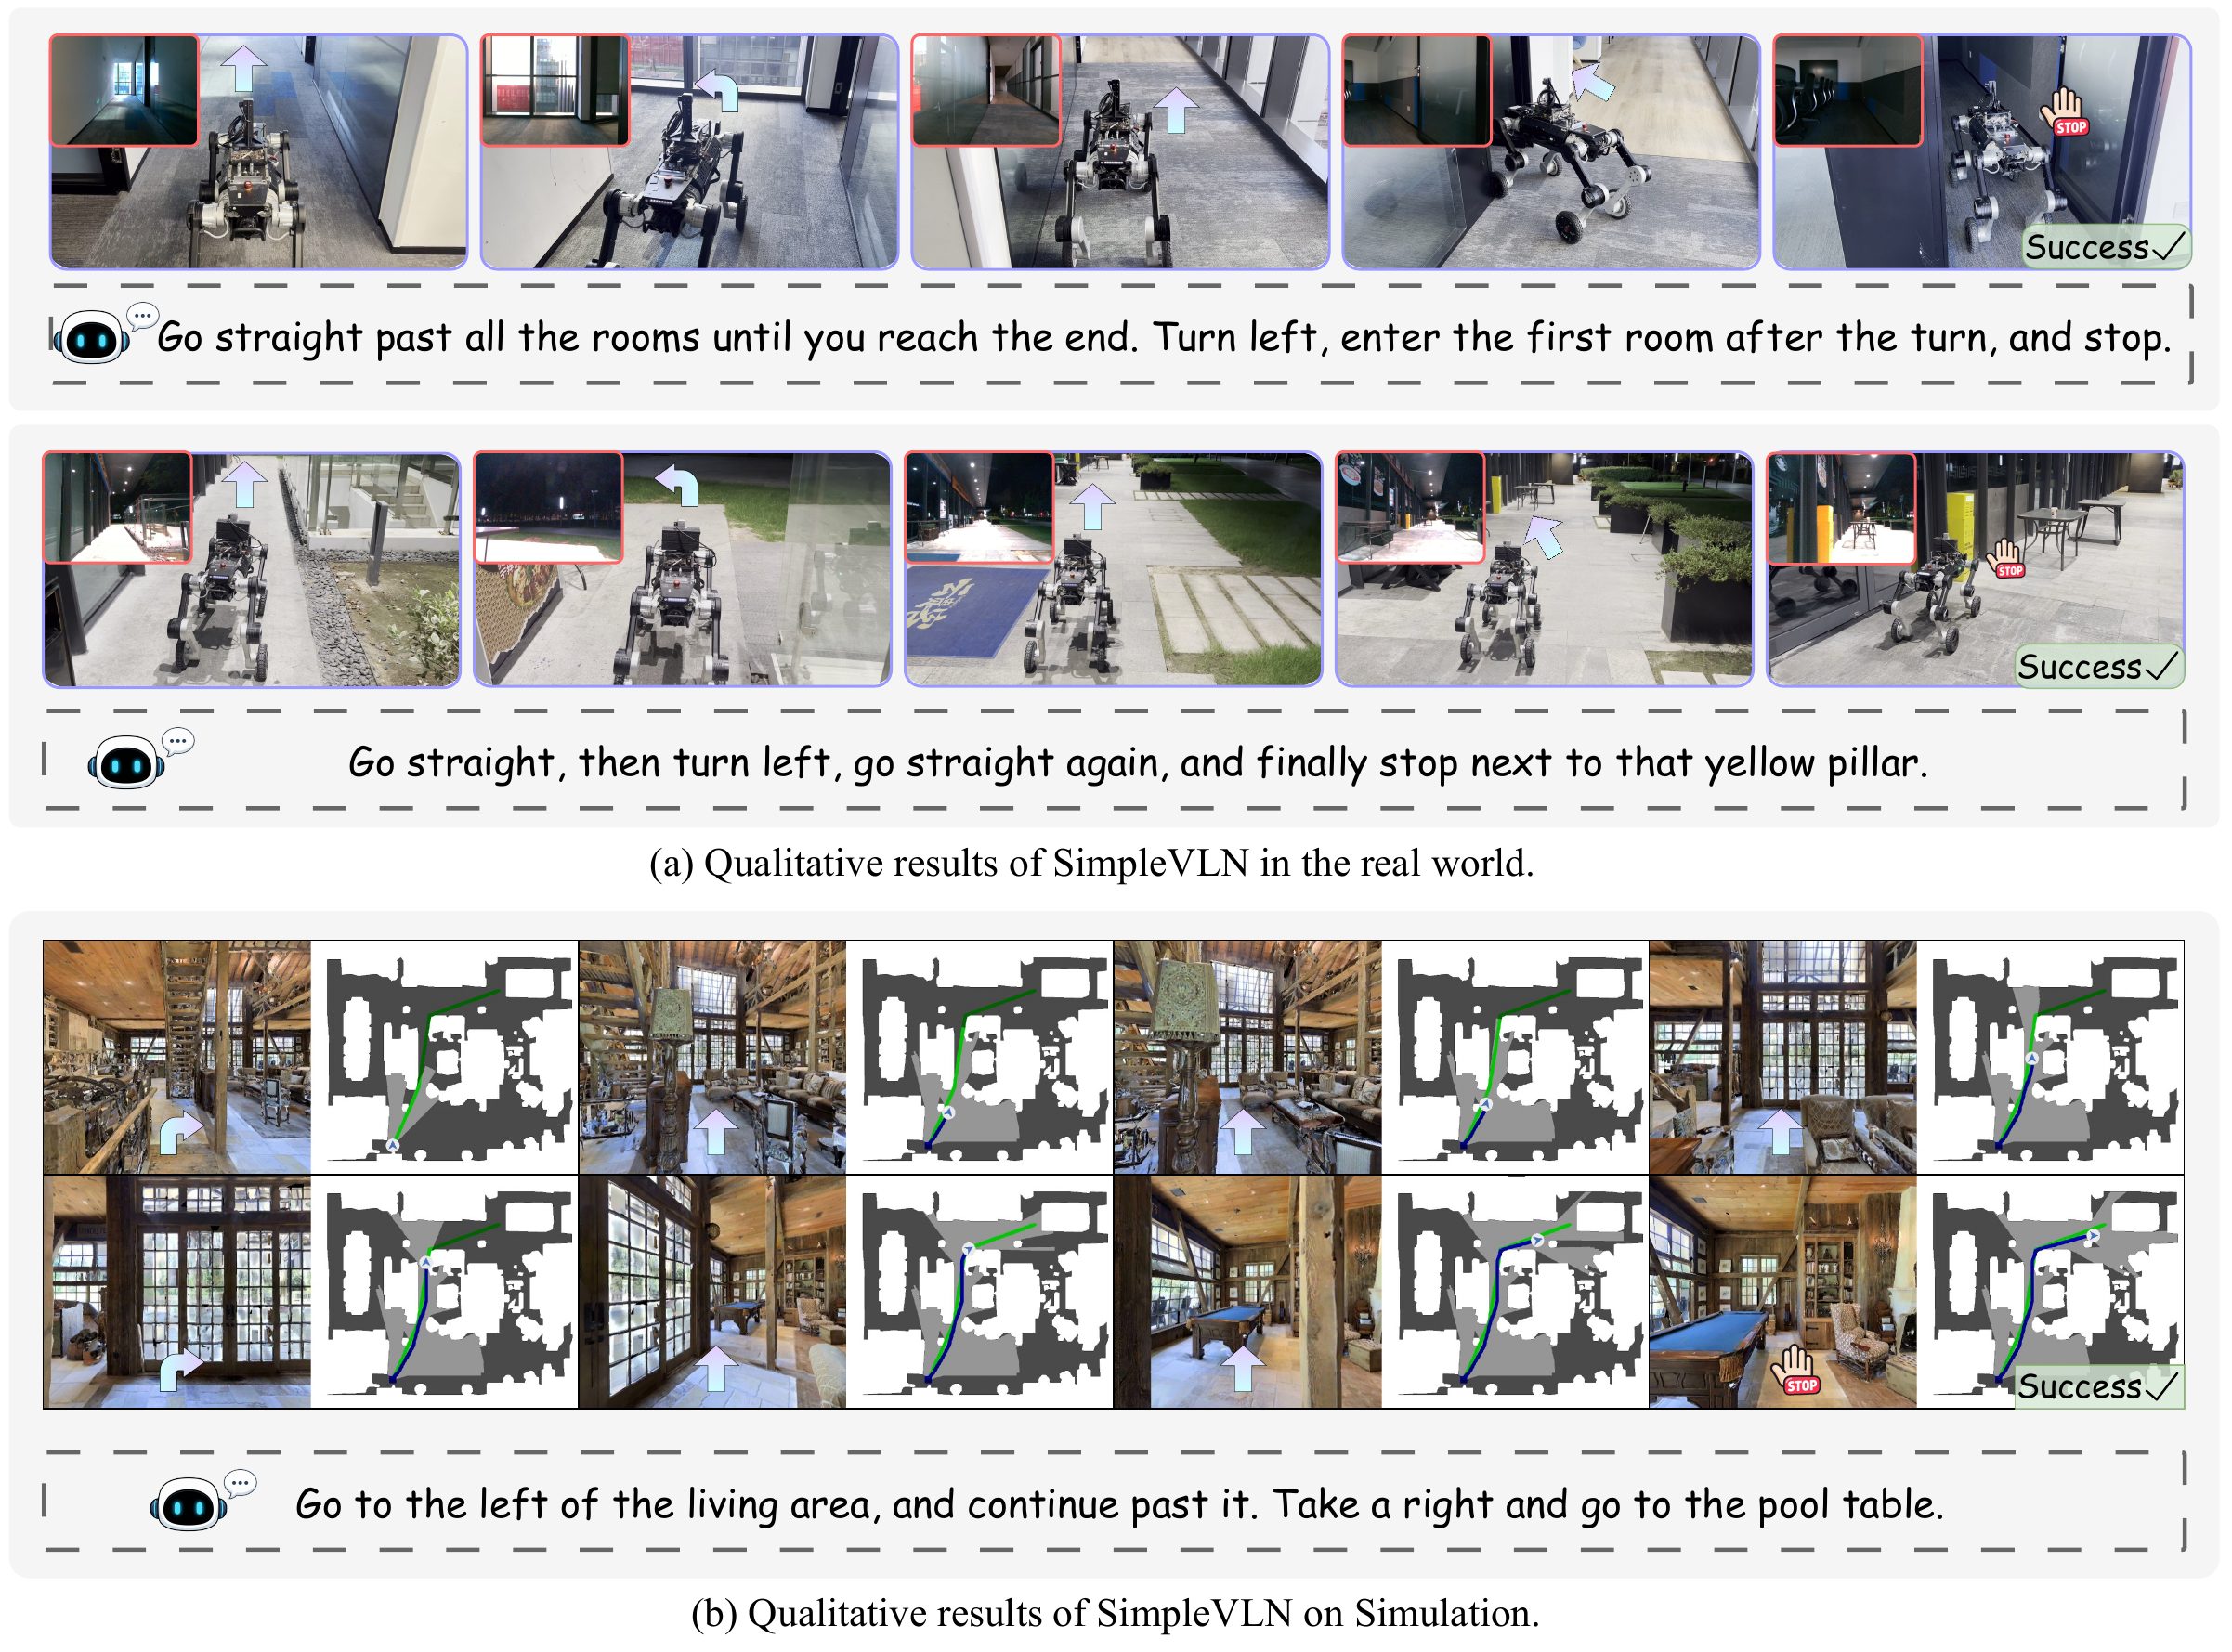
图 6:SimpleVLN 在真实与仿真环境中的导航示例。
💡 关键见解
理论分析
- 上下文长度并非越长越好。 多轮对话保留了最完整的历史,SR 却最低(35.7);全局帧超过 8 帧后 SR 也开始下降。当前 MLLM 对长视觉序列的利用效率有限,冗余帧会稀释有效信息。紧凑、均匀覆盖的历史起到了类似“信息瓶颈”的作用。
- 动作块不只是加速手段。 动作块减少了决策次数,相当于缩短了有效决策时程,降低了误差累积;一次预测多个动作也迫使模型做出更长程的规划。
- 分布偏移是 SFT 的主要瓶颈。 DAgger 的增益(+7.5/+8.1)远大于扩充专家数据(+1.2/+0.8),说明问题在于状态分布不匹配,而不是示范数量不足。
- 稀疏二值奖励优于稠密塑形奖励。 SPL 奖励会惩罚“绕路但成功”的轨迹,抑制探索;二值奖励只关心是否成功,与评估指标对齐,同时给了策略更大的自由度。RL 后决策次数下降,说明效率是在优化过程中自发出现的。
实践启示
- 做具身任务时,可以先把原生 MLLM 的输入形式化、数据和后训练流程调到最优,再考虑加模块;这条强基线往往被低估。
- 保持原生架构意味着可以直接使用 vLLM/SGLang 等推理框架以及 verl 等 RL 框架,也便于部署到 Jetson Thor 等边缘设备。
- “重新合成 RL 任务而不复用 SFT 回合”这一做法可以推广到其他具身 RL 场景,避免 RL 只是在已记住的任务上做强化。
🔍 局限性与未来工作
当前局限
- 主结果与消融配置不一致:消融使用 GRPO、batch 32;主结果使用 DAPO、batch 256。作者也承认 DAPO 的优势不能完全归因于算法本身。
- 缺乏统计显著性:所有结果均为单次运行,没有方差或多种子统计;部分消融的差距只有 1~2 个点(如 Primitive(all) vs Primitive(8))。
- DAgger 细节不足:“偏离较大”的阈值、DAgger 迭代轮数和收集成本都没有给出。
- RL 任务合成的质量未评估:MLLM 生成指令的准确性、与人工指令的分布差异都没有分析,也没有说明使用的是哪个 MLLM。
- 真实世界实验只有定性展示,没有成功率等量化统计。
- 骨干覆盖有限:只实验了 Qwen 系列,“适用于原生 MLLM”这一结论的通用性仍需在 InternVL、LLaVA 等其他系列上验证。
- 正文中没有讨论失败案例,也没有单独的局限性章节。
未来方向
- 用可学习或自适应的关键帧选择替代均匀采样,或让模型自行决定动作块长度;
- 将 RL 扩展到更多场景(如 HM3D 生成场景)和更大规模的合成任务,研究 RL 的扩展规律;
- 在真实机器人上做系统性的量化评估,并考虑 sim-to-real 的 RL 微调;
- 验证同一套方法是否适用于 ObjectNav、EQA 等其他具身任务。
📚 相关工作对比
| 方法 | 核心思想 | 优势 | 劣势 |
|---|---|---|---|
| StreamVLN | 流式多轮上下文 + KV 缓存,SlowFast 记忆 | 延迟低(300 ms) | SR 较低(56.9) |
| JanusVLN | 引入 3D 几何编码器的双重隐式记忆 | 空间理解更强 | 延迟高(906 ms),需改架构 |
| DualVLN | 慢系统规划 + 快系统执行的双系统架构 | 长时程规划 | 结构复杂,683 ms |
| Qwen-RobotNav | 大规模导航数据训练的 Qwen 导航模型 | 全景版本 RxR 表现强 | 最佳结果依赖全景观测 |
| NaVIDA | 动作块 + 逆动力学增强 | 动作块的来源 | SR 61.4 |
| 本文方法 | 原生 MLLM + 单轮全局局部记忆 + 动作块 + IL→DAgger→RL | 不改架构、SOTA、293 ms | 依赖大量 DAgger/RL 交互,消融配置与主结果不统一 |
🎓 个人评价
优点
- 问题提得清楚:在加模块之前,先榨干原生 MLLM 的能力。这为 VLN 社区提供了一条难以忽视的强基线。
- 消融覆盖了形式化、数据、优化三个维度,每个设计选择都有对应的实验支持。
- 方法简单、易于复现和部署,在效率和精度上都取得了领先。
可改进之处
- 论文篇幅较短,DAgger、任务合成和 prompt 格式等实现细节不足,附录为空;
- 缺少多随机种子统计和失败案例分析;
- “原生 MLLM 足够”这一结论是在大量 DAgger 与 RL 交互数据的前提下得出的,模型容量和数据或计算量的贡献没有被拆开。
推荐阅读对象
VLN / 具身导航研究者、将 MLLM 用于机器人决策的工程师,以及关注具身任务 RL 后训练(GRPO/DAPO)实践的读者。
📎 附录
重要公式
全局--局部记忆:
动作块策略:
SFT 目标:
RL 目标:
术语表
| 英文 | 中文 | 说明 |
|---|---|---|
| VLN-CE | 连续环境视觉-语言导航 | 在 Habitat 连续空间中执行低层动作 |
| Primitive Action | 原子动作 | 前进 0.25 m / 左转 15° / 右转 15° / 停止 |
| Action Chunk | 动作块 | 一次决策输出的有序原子动作序列 |
| Single-turn Decision Input | 单轮决策输入 | 每次决策重建独立 prompt |
| Global--Local Memory | 全局--局部记忆 | 均匀采样的全局帧 + 紧邻的局部帧 |
| DAgger | 数据集聚合 | 在策略诱导的状态上收集监督数据 |
| SR / SPL / NE / OS / nDTW | 成功率 / 路径长度加权成功率 / 导航误差 / Oracle 成功率 / 归一化动态时间规整 | 标准 VLN 指标 |
| GRPO / DAPO | 组相对策略优化 / 解耦裁剪与动态采样策略优化 | 无价值网络的 RL 算法 |
参考资源
- 论文原文: arXiv:2610.23203
- 中文翻译 PDF: paper_cn.pdf
- 中文 Markdown 译文: paper_cn.md
- 代码实现: 论文未给出代码链接
- 项目主页: https://simplevln.github.io/