VLAD
VLAD(Vector of Local Aggregated Descriptors),是一种图像特征提取方法。思路如下:
- 存在一个图像库\(I\),对每张图片\(I_i\)通过特征函数提取特征\(f(I_i)\)
- 提供一张query图片\(q\),通过特征函数提取特征\(f(q)\)
- 将query特征\(f(q)\)与图库特征\(f(I)\)做相似度计算,一般为欧式距离:\(d(q,I) = || f(q) - f(I) ||\),距离越小,越相似.
这里提到的VLAD算是特征提取函数\(f\)的一种,可简称为\(f_{vlad}\)。但VLAD方法如其描述——局部聚类向量,将局部特征聚类得到一个向量。所以VLAD应用的前提是要先获得图像的局部特征。图像局部特征可以用SIFT,SURF,ORB等一般方法,也可以通过当前流行的CNN方法提取。
假设一张图像,提取了N个D维特征(通常N可能比较大,不同图片,其特征数N也可能不同),Vlad计算流程如下:
-
对全部的N*D特征图进行K-means聚类,获得K个聚类中心,记为\(C_k\)
-
通过以下公式,将\(N*D\)的局部特征图转为一个全局特征图V,全局特征图shape为K*D。公式如下:
\[ V(j, k) = \sum_{i = 1}^{N} a_k(x_i)(x_i(j) - c_k(j)), k \in K,j\in D \]
其中\(x_i\)表示第i个局部特征,\(c_k\)表示第k个聚类中心,\(x_i\)和\(c_k\)都是D维向量。\(a_k(x_i)\)是一个符号函数,如果\(x_i\)不属于聚类中心\(c_k\),\(a_k(x_i) = 0\), 反之,\(a_k(x_i) = 1\)
分析公式,可以看出该式累加了每个聚类的所有特征残差,最终得到了K个全局特征。我们理解这K个全局特征表达了聚类范围内局部特征的某种分布,这种分布通过\(x_i - c_k\)抹去了图像本身的特征分布差异,只保留了局部特征与聚类中心的分布差异。通过上面经典VLAD算法介绍,我们可以看出\(f_{vlad}\)是将一个若干局部特征压缩为特定大小全局特征的方法。
NetVLAD
经典的Vlad是一个不可导的函数,其主要不可导的地方在于\(a_k(x_i)\)是一个符号函数。为了让Vlad变得可导,我们需要将其变得平滑,即可微。根据\(a_k(x_i)\)特性,我们可以将其平滑为一个权重函数,即\(x_i\)与\(c_k\)越相近\(a_k(x_i)\)越接近1,反之越接近0。可设计公式:
这里\(\alpha\)是一个大于0的参数,\(\alpha \rightarrow \infty\)时,\(\overline a (x_i)\)越趋近于0和1。其中\(w_k = 2 \alpha c_k, b_k = -\alpha || c_k ||^2\),上述公式也是softmax函数。至此VLAD函数就改成:
这里\(w_k, b_k, c_k\)就是NetVLAD要学习的参数。第一项是一个soft-max函数\(\sigma_{k}(z)=\exp \left(z_{k}\right) / \sum \exp \left(z_{k}\right)\),因此\(x_i\)到\(c_k\)的权重分配可以看做是包含两个步骤的过程:1. 经过\(w_k\)和\(b_k\)的卷积,产生输出\(s_k(x_i) - w_k^T x_i + b_k\).2.卷积的输出经过一个softmax函数用于获取最终的权重分配\(a_k(x_i)\).最终得到的向量\(V\)经过标准化处理得到一个\((K∗D)∗1\)的描述符
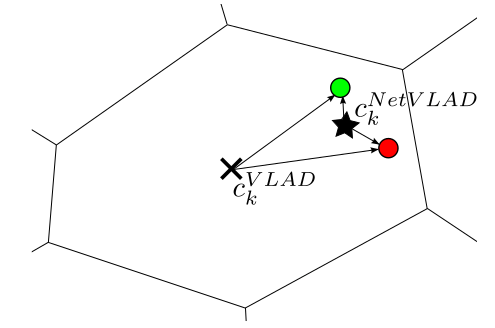
我们这样将\(c_k\)作为学习参数有什么好处呢,论文中用了一幅图进行了直观解释,传统 VLAD 的中心是聚类出来的,没有监督的标签数据,\(c_k^{VLAD}\)在聚类时我们使用了很多图像这些图像的描述符之间没有关系,那么也就很可能把本来不是一个物体的描述符聚为一类,使得我们原本期望的类内描述符都是一个物体的feature不太容易达到。而在使用监督数据进行训练时,我们可以已知图像数据属于同一物体,那么训练时就可以只把属于同一物体的特征聚在一起而把不是的划分到其他类别,这样就可能学习出一个更好的\(c_k^{NetVLAD}\)聚类中心,使得最终的特征更有区分度。
从VLAD到NetVLAD的最大变化是之前需要通过聚类获得参数\(c_k\)变成了需要通过训练得到。这样就可以把VLAD变成了一个分类问题,即设定有K个分类,计算局部特征在这K个分类的差值分布来得到全局特征V(j,k)。
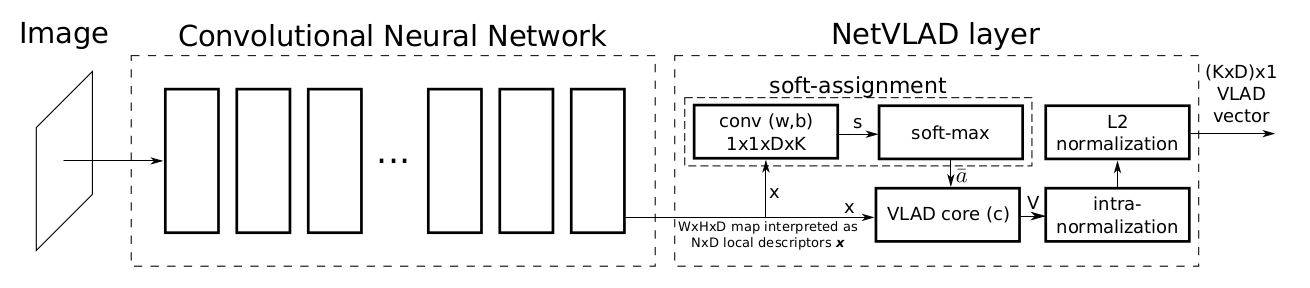
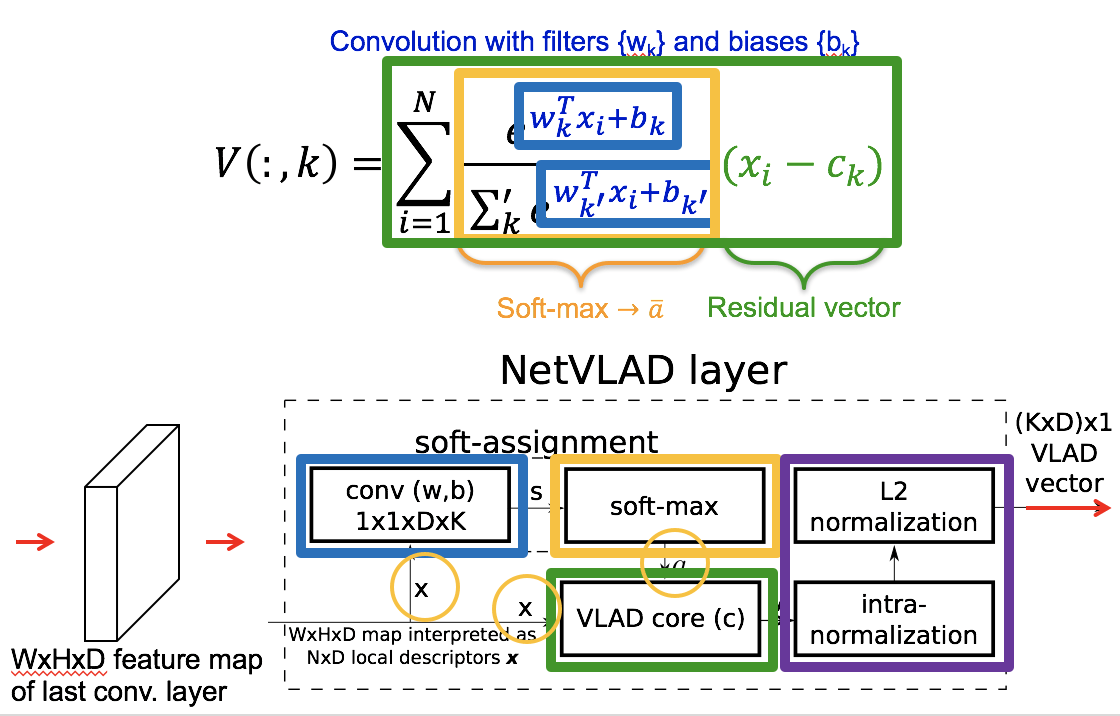
由于是 NN 的方法,这里使用 CNN Feature 代替了传统 VLAD 中的 N 个局部描述子,CNN 是一个全局的特征,它的 Feature Map 是 W*H*D 大小,那么类比于我们之前的传统方法 N*D,我们这里 NetVLAD 目标就是将 W*H*D (N=W*H)的特征转换为 K*D 的特征; 我们将整个 NetVLAD 看做一个 pooling layer,它的作用是实现降最终和 VLAD 一样获得我们想要的 K*D 维描述子。
具体细节:
- 实现\(z_k=w_k^Tx_i+b_k\),也就是公式中的蓝色部分,论文里直接通过一个1x1的卷积来做。这也是1x1卷积的一个应用;
- 实现\(\sigma_k (z)=\frac{e^{z_k}}{\sum_{k'} e^{z_{k'}} }\),也就是公式中的黄色部分,如之前所述这实际上就是一个 softmax 公式,论文里直接通过一个 softmax 来做;
- 实现\(x_i (j)- c_k(j)\),也就是公式中的绿色部分,这部分就是一个减法,直接用一个 VLAD core来做;
- 1~3已经实现了 V(j,k)的计算了,后面按照 All about VLAD 论文还要对 V(j,k)做两步简单的归一化(这篇论文证明了归一化可以提升检索性能)分别是intra-normalization和l2 normalization。
class NetVLAD(nn.Module):
    """NetVLAD layer implementation"""

    def __init__(self, num_clusters=64, dim=128,
                 normalize_input=True, vladv2=False):
        """
        Args:
            num_clusters : int
                The number of clusters
            dim : int
                Dimension of descriptors
            alpha : float
                Parameter of initialization. Larger value is harder assignment.
            normalize_input : bool
                If true, descriptor-wise L2 normalization is applied to input.
            vladv2 : bool
                If true, use vladv2 otherwise use vladv1
        """
        super(NetVLAD, self).__init__()
        self.num_clusters = num_clusters
        self.dim = dim
        self.alpha = 0
        self.vladv2 = vladv2
        self.normalize_input = normalize_input
        self.conv = nn.Conv2d(dim, num_clusters, kernel_size=(1, 1), bias=vladv2)
        self.centroids = nn.Parameter(torch.rand(num_clusters, dim))

    def init_params(self, clsts, traindescs):
        #TODO replace numpy ops with pytorch ops
        if self.vladv2 == False:
            clstsAssign = clsts / np.linalg.norm(clsts, axis=1, keepdims=True)
            dots = np.dot(clstsAssign, traindescs.T)
            dots.sort(0)
            dots = dots[::-1, :] # sort, descending

            self.alpha = (-np.log(0.01) / np.mean(dots[0,:] - dots[1,:])).item()
            self.centroids = nn.Parameter(torch.from_numpy(clsts))
            self.conv.weight = nn.Parameter(torch.from_numpy(self.alpha*clstsAssign).unsqueeze(2).unsqueeze(3))
            self.conv.bias = None
        else:
            knn = NearestNeighbors(n_jobs=-1) #TODO faiss?
            knn.fit(traindescs)
            del traindescs
            dsSq = np.square(knn.kneighbors(clsts, 2)[1])
            del knn
            self.alpha = (-np.log(0.01) / np.mean(dsSq[:,1] - dsSq[:,0])).item()
            self.centroids = nn.Parameter(torch.from_numpy(clsts))
            del clsts, dsSq

            self.conv.weight = nn.Parameter(
                (2.0 * self.alpha * self.centroids).unsqueeze(-1).unsqueeze(-1)
            )
            self.conv.bias = nn.Parameter(
                - self.alpha * self.centroids.norm(dim=1)
            )

    def forward(self, x):
        N, C = x.shape[:2]
        if self.normalize_input:
            x = F.normalize(x, p=2, dim=1)  # across descriptor dim

        # soft-assignment
        soft_assign = self.conv(x).view(N, self.num_clusters, -1)
        soft_assign = F.softmax(soft_assign, dim=1)

        x_flatten = x.view(N, C, -1)

        # calculate residuals to each clusters
        vlad = torch.zeros([N, self.num_clusters, C], dtype=x.dtype, layout=x.layout, device=x.device)
        for C in range(self.num_clusters): # slower than non-looped, but lower memory usage
            residual = x_flatten.unsqueeze(0).permute(1, 0, 2, 3) - \
                    self.centroids[C:C+1, :].expand(x_flatten.size(-1), -1, -1).permute(1, 2, 0).unsqueeze(0)
            residual *= soft_assign[:,C:C+1,:].unsqueeze(2)
            vlad[:,C:C+1,:] = residual.sum(dim=-1)

        vlad = F.normalize(vlad, p=2, dim=2)  # intra-normalization
        vlad = vlad.view(x.size(0), -1)  # flatten
        vlad = F.normalize(vlad, p=2, dim=1)  # L2 normalize

        return vlad
训练
对于地点识别,可以利用图片的位置信息,将同一地点、不同视角、不同时间的数据作为同一物体标签进行训练。 获取相近的图片集合,作为正样本\(p_{i*}^q\),获取绝对不可能是同一物体的负样本集合\(n_j^q\),我们需要获得这样的结果,所有正样本集合的特征距离,应该要比负样本集合的特征距离要小:
正样本中距离最近的应该就是我们想要的最近图片:
构造loos函数:
demo
使用双目数据集,右目通过NetVLAD构建全局特征,并构建最近邻查询数据结构,左目NetVLAD构建全局特征,并通过最近邻查询相似图片。
Reference
[1] NetVLAD: CNN architecture for weakly supervised place recognition, 2016.
[2] Patch-NetVLAD: Multi-Scale Fusion of Locally-Global Descriptors for Place Recognition
[3] http://file.liuxiao.org/blog/cvpr16_NetVLAD_presentation.pptx
[4] http://liuxiao.org/2019/02/%e8%ae%ba%e6%96%87%e7%ac%94%e8%ae%b0%ef%bc%9anetvlad-cnn-architecture-for-weakly-supervised-place-recognition/
[5] https://data.ciirc.cvut.cz/public/projects/2015netVLAD/
[6] https://www.kaggle.com/competitions/landmark-retrieval-2021/data
[7] https://github.com/yxgeee/OpenIBL