title: 牛顿法 高斯牛顿法 列文伯格-马夸尔特算法
date: 2018-09-15 12:46:56
comments: true
toc: true
mathjax: true
categories: "algorithm"
tags:
- algorithm
- optimization method
- least squares
Jacobian矩阵和Hessian矩阵
Jacobian
在向量分析中, 雅可比矩阵是一阶偏导数以一定方式排列成的矩阵, 其行列式称为雅可比行列式. 还有, 在代数几何中, 代数曲线的雅可比量表示雅可比簇:伴随该曲线的一个代数群, 曲线可以嵌入其中. 它们全部都以数学家卡尔·雅可比(Carl Jacob, 1804年10月4日-1851年2月18日)命名;英文雅可比量”Jacobian”可以发音为[ja ˈko bi ən]或者[ʤə ˈko bi ən].
雅可比矩阵
雅可比矩阵的重要性在于它体现了一个可微方程与给出点的最优线性逼近. 因此, 雅可比矩阵类似于多元函数的导数.
假设F:\({R_n} \to {R_m}\)是一个从欧式n维空间转换到欧式m维空间的函数. 这个函数由m个实函数组成: y1(x1,…,xn), …, ym(x1,…,xn). 这些函数的偏导数(如果存在)可以组成一个m行n列的矩阵, 这就是所谓的雅可比矩阵:
此矩阵表示为:\(J_F(x_1, \cdots , x_n)\), 或者\(\frac{\partial (y_1, \cdots ,y_m)} {\partial (x_1, \cdots ,x_n)}\).
这个矩阵的第i行是由梯度函数的转置yi(i=1,…,m)表示的.
如果\(p\)是\(R_n\)中的一点,\(F\)在\(p\)点可微分, 那么在这一点的导数由\(J_F(p)\)给出(这是求该点导数最简便的方法). 在此情况下, 由\(F(p)\)描述的线性算子即接近点\(p\)的\(F\)的最优线性逼近,\(x\)逼近于\(p\):
雅可比行列式
如果m = n, 那么\(F\)是从n维空间到n维空间的函数, 且它的雅可比矩阵是一个方块矩阵. 于是我们可以取它的行列式, 称为雅可比行列式.
在某个给定点的雅可比行列式提供了 在接近该点时的表现的重要信息. 例如, 如果连续可微函数\(F\)在\(p\)点的雅可比行列式不是零, 那么它在该点附近具有反函数. 这称为反函数定理. 更进一步, 如果\(p\)点的雅可比行列式是正数, 则\(F\)在\(p\)点的取向不变;如果是负数, 则\(F\)的取向相反. 而从雅可比行列式的绝对值, 就可以知道函数\(F\)在\(p\)点的缩放因子;这就是为什么它出现在换元积分法中.
对于取向问题可以这么理解, 例如一个物体在平面上匀速运动, 如果施加一个正方向的力\(F\)即取向相同, 则加速运动, 类比于速度的导数加速度为正;如果施加一个反方向的力\(F\), 即取向相反, 则减速运动, 类比于速度的导数加速度为负.
海森Hessian矩阵
在数学中, 海森矩阵(Hessian matrix或Hessian)是一个自变量为向量的实值函数的二阶偏导数组成的方块矩阵, 此函数如下:
如果\(f\)的所有二阶导数都存在, 那么\(f\)的海森矩阵即:
其中\(x = (x_1, x_2, \cdots , x_n)\), 即\(H(f)\)为:
(也有人把海森定义为以上矩阵的行列式)海森矩阵被应用于牛顿法解决的大规模优化问题.
牛顿法(Newton`s Method)
求解方程
牛顿法是一种在实数域和复数域上近似求解方程的方法。方法使用函数f (x)的泰勒级数的前面几项来寻找方程f (x) = 0的根。牛顿法最大的特点就在于它的收敛速度很快。
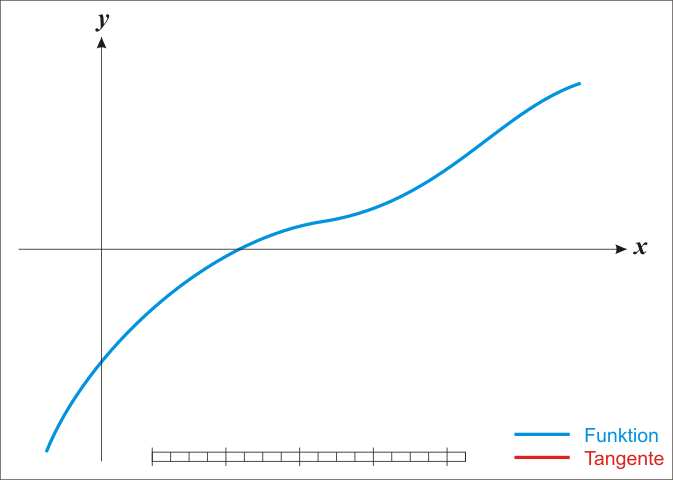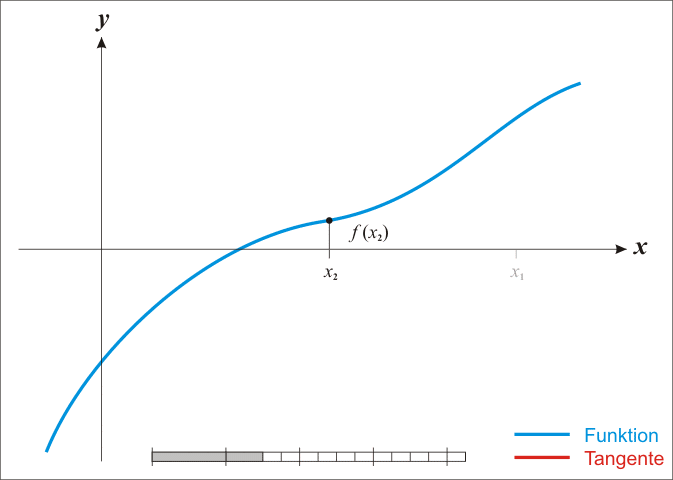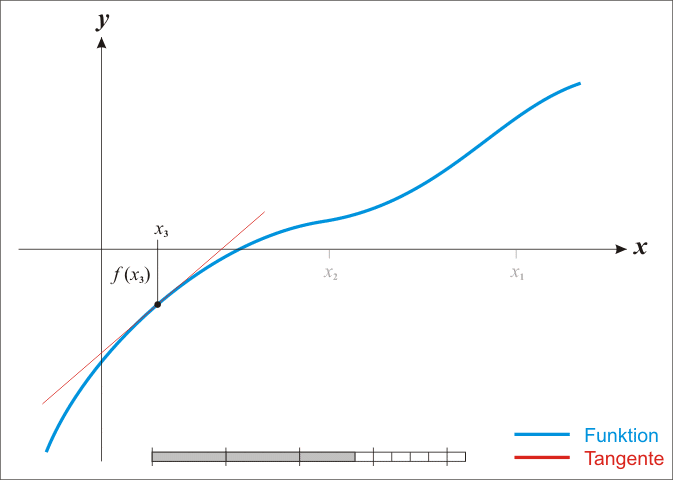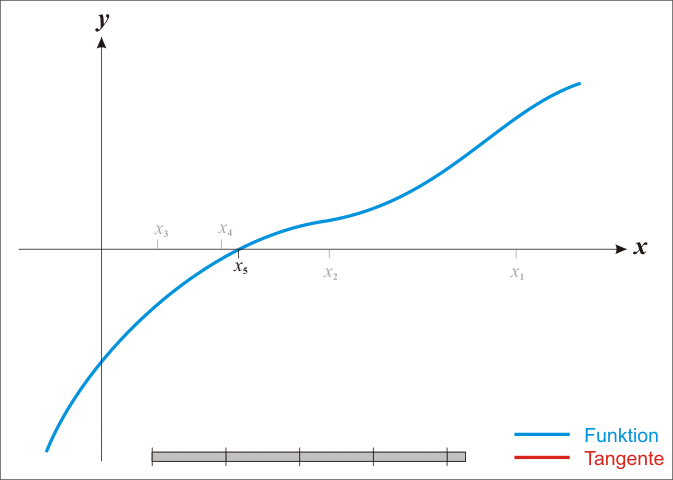
首先,选择一个接近函数 f (x)零点的 x0,计算相应的 f (x0) 和切线斜率f ' (x0)(这里f ' 表示函数 f 的导数)。然后我们计算穿过点(x0, f (x0)) 并且斜率为f '(x0)的直线和 x 轴的交点的x坐标,也就是求如下方程的解:
我们将新求得的点的 x 坐标命名为x1,通常x1会比x0更接近方程f (x) = 0的解。因此我们现在可以利用x1开始下一轮迭代。迭代公式可化简为如下所示:
已经证明,如果f ' 是连续的,并且待求的零点x是孤立的,那么在零点x周围存在一个区域,只要初始值x0位于这个邻近区域内,那么牛顿法必定收敛。 并且,如果f ' (x)不为0, 那么牛顿法将具有平方收敛的性能. 粗略的说,这意味着每迭代一次,牛顿法结果的有效数字将增加一倍。下图为一个牛顿法执行过程的例子。
从本质上去看,牛顿法是二阶收敛,梯度下降是一阶收敛,所以牛顿法就更快。如果更通俗地说的话,比如你想找一条最短的路径走到一个盆地的最底部,梯度下降法每次只从你当前所处位置选一个坡度最大的方向走一步,牛顿法在选择方向时,不仅会考虑坡度是否够大,还会考虑你走了一步之后,坡度是否会变得更大。所以,可以说牛顿法比梯度下降法看得更远一点,能更快地走到最底部。(牛顿法目光更加长远,所以少走弯路;相对而言,梯度下降法只考虑了局部的最优,没有全局思想。)
从几何上说,牛顿法就是用一个二次曲面去拟合你当前所处位置的局部曲面,而梯度下降法是用一个平面去拟合当前的局部曲面,通常情况下,二次曲面的拟合会比平面更好,所以牛顿法选择的下降路径会更符合真实的最优下降路径。
Example
下面介绍使用牛顿迭代法求方根的例子。牛顿迭代法是已知的实现求方根最快的方法之一,只需要迭代几次后就能得到相当精确的结果。
首先设x的m次方根为a。
下面程序使用牛顿法求解平方根。
const float EPS = 0.00001;
double sqrt(double x) {
    if(x == 0) return 0;
    double result = x; /*Use double to avoid possible overflow*/
    double lastValue;
    do{
        lastValue = result;
        result = result / 2.0f + x / 2.0f / result;
    }while(abs(result - lastValue) > EPS);
     return (double)result;
}
更快的方法:(reference: https://en.wikipedia.org/wiki/Fast_inverse_square_root)
double sqrt(float x) {
    if(x == 0) return 0;
    float result = x;
    float xhalf = 0.5f*result;
    int i = *(int*)&result;
    i = 0x5f375a86- (i>>1); // what the fuck?
    result = *(float*)&i;
    result = result*(1.5f-xhalf*result*result); // Newton step, repeating increases accuracy
    result = result*(1.5f-xhalf*result*result);
    return 1.0f/result;
}
用于最优化
在最优化的问题中,线性最优化至少可以使用单纯行法求解,但对于非线性优化问题,牛顿法提供了一种求解的办法。假设任务是优化一个目标函数\(f(x)\),求函数f的极大极小问题,可以转化为求解函数f的导数\(f^{\prime}(x) = 0\)的问题,这样求可以把优化问题看成方程求解问题。剩下的问题就和第一部分提到的牛顿法求解很相似了。在极小值估计值附近,把\(f(x)\)泰勒展开到2阶形式:
当且仅当\(\Delta x\)无限趋近与0,上面的公式成立, 令\(f^{\prime}(x + \Delta x) = 0\),得到:
求解:
即:
一般认为牛顿法可以利用到曲线本身的信息, 比梯度下降法更容易收敛(迭代更少次数).
在上面讨论的是2维情况,高维情况的牛顿迭代公式是:
其中H是hessian矩阵,定义如上。
Example
高斯牛顿(Gauss Newton)
高斯牛顿法是对牛顿法的一种改进,它用雅克比矩阵的乘积近似代替牛顿法中的二阶Hessian 矩阵,从而省略了求二阶Hessian 矩阵的计算。
高斯—牛顿迭代法的基本思想是使用泰勒级数展开式去近似地代替非线性回归模型,然后通过多次迭代,多次修正回归系数,使回归系数不断逼近非线性回归模型的最佳回归系数,最后使原模型的残差平方和达到最小。
对于一个非线性最小二乘问题:
高斯牛顿的思想是把\(f(x)\)利用泰勒展开,取一阶线性项近似。
带入到上式,得:
对上式求导,令导数为0:
令\(H = J^TJ \quad B = -J^Tf\)得:
求解,便可以获得调整增量\(\Delta x\)。这要求\(H\)可逆(正定),但实际情况并不一定满足这个条件,因此可能发散,另外步长\(\Delta x\)可能太大,也会导致发散。
如果已知观测z的协方差的矩阵\(\Sigma\),应该对指标函数按方差\(\Sigma\)加权,方差大的观测分量权重小,对结果的影响小.
迭代公式为:
设信息矩阵\(\Sigma^{-1}\),由Cholesky分解,\(\Sigma^{-1} = A^{T}A\), 得:
因此加权最小二乘可以转换为非加权问题。
Example
非线性方程:\(y = exp(ax^2 + bx +c)\)给定n组观测数据\((x, y)\)求解系数\(X = [a, b, c]^T\)
令\(f(X) = y - exp(ax^2 + bx + c)\)N组数据可以组成一个大的非线性方程组
可以构建一个最小二乘问题:
要求解这个问题,根据推导部分可知,需要求解雅克比。
#include <iostream>
#include <Eigen/Core>
#include <vector>
#include <opencv2/opencv.hpp>
#include <Eigen/Cholesky>
#include <Eigen/QR>
#include <Eigen/SVD>
#include <chrono>

class CostFunction{
public:
        CostFunction(double* a, double* b, double* c, int max_iter, double min_step, bool is_out):
        a_(a), b_(b), c_(c), max_iter_(max_iter), min_step_(min_step), is_out_(is_out)
        {}

        void addObservation(double x, double y)
        {
            std::vector<double> ob;
            ob.push_back(x);
            ob.push_back(y);
            obs_.push_back(ob);
        }

        void calcJ_fx()
        {
            J_ .resize(obs_.size(), 3);
            fx_.resize(obs_.size(), 1);

            for ( size_t i = 0; i < obs_.size(); i ++)
            {
                std::vector<double>& ob = obs_.at(i);
                double& x = ob.at(0);
                double& y = ob.at(1);
                double j1 = -x*x*exp(*a_ * x*x + *b_*x + *c_);
                double j2 = -x*exp(*a_ * x*x + *b_*x + *c_);
                double j3 = -exp(*a_ * x*x + *b_*x + *c_);
                J_(i, 0 ) = j1;
                J_(i, 1) = j2;
                J_(i, 2) = j3;
                fx_(i, 0) = y - exp( *a_ *x*x + *b_*x +*c_);
            }
        }

       void calcH_b()
        {
            H_ = J_.transpose() * J_;
            B_ = -J_.transpose() * fx_;
        }

        void calcDeltax()
        {
            deltax_ = H_.ldlt().solve(B_);
        }

       void updateX()
        {
            *a_ += deltax_(0);
            *b_ += deltax_(1);
            *c_ += deltax_(2);
        }

        double getCost()
        {
            Eigen::MatrixXd cost= fx_.transpose() * fx_;
            return cost(0,0);
        }

        void solveByGaussNewton()
        {
            double sumt =0;
            bool is_conv = false;
            for( size_t i = 0; i < max_iter_; i ++)
            {
                calcJ_fx();
                calcH_b();
                calcDeltax();
                double delta = deltax_.transpose() * deltax_;
                if( is_out_ )
                {
                    std::cout << "Iter: " << std::left <<std::setw(3) << i << " Result: "<< std::left <<std::setw(10)  << *a_ << " " << std::left <<std::setw(10)  << *b_ << " " << std::left <<std::setw(10) << *c_ <<
                    " step: " << std::left <<std::setw(14) << delta << " cost: "<< std::left <<std::setw(14)  << getCost() << " time: " << std::left <<std::setw(14) << t.duration()  <<
                    " total_time: "<< std::left <<std::setw(14) << (sumt += t.duration()) << std::endl;
                }
                if( delta < min_step_)
                {
                    is_conv = true;
                    break;
                }
                updateX();
            }

           if( is_conv  == true)
                std::cout << "\nConverged\n";
            else
                std::cout << "\nDiverged\n\n";
        }

        Eigen::MatrixXd fx_;
        Eigen::MatrixXd J_; //
        Eigen::Matrix3d H_; // H
        Eigen::Vector3d B_;
        Eigen::Vector3d deltax_;
        std::vector< std::vector<double>  > obs_; //
        double* a_, *b_, *c_;

        int max_iter_;
        double min_step_;
        bool is_out_;
};//class CostFunction

int main(int argc, char **argv) {
    const double aa = 0.1, bb = 0.5, cc = 2; // true value
    double a =0.0, b=0.0, c=0.0; // first value

    CostFunction cost_func(&a, &b, &c, 50, 1e-10, true);

    /* generate data */
    const size_t N = 100; // data size
    cv::RNG rng(cv::getTickCount());
    for( size_t i = 0; i < N; i ++)
    {
       double x = rng.uniform(0.0, 1.0) ;
       double y = exp(aa*x*x + bb*x + cc) + rng.gaussian(0.05);

       cost_func.addObservation(x, y);
    }
    cost_func.solveByGaussNewton();
    return 0;
}
列文伯格-马夸尔特算法
不难看出, G-N优化通过在\(X\)附近进行近似二阶泰勒展开来简化计算,这也决定了\(\Delta X\)只在\(X\)附近才有较高的置信度,我们很自然地想到应该给\(\Delta X\)添加一个信赖区域(Trust Region) ,不让\(\Delta X\)过大,于是就产生了L-M优化算法。
L-M优化通过在增量方程中增加一个动态拉格朗日乘子\(\mu\)来改善G-N方法:
L-M优化中的增量方程:
拉格朗日乘子\(\mu\)设定为正数;由于\(H\)是半正定矩阵,所以其对角阵\(I \cdot H\)是正定矩阵。这样\(\mu\)增大,\(\Delta x\)减小,成反比关系。
- 对与\(\mu > 0\),\(H + \mu I\)正定,保证了度下降的方向。
- 当\(\mu\)较大时:其实就是梯度、最速下降法,当离最终结果较远的时候,很好。
- 当\(\mu\)较小时,方法接近与高斯牛顿,当离最终结果很近时,可以获得二次收敛速度。
在一次迭代中,\(H\)和\(g\)是不变的,如果我们发觉解出的\(\Delta x\)过大,就适当调大\(\mu\),并重新计算增量方程,以获得相对小一些的\(\Delta x\);
反过来,如果发觉解出的\(\Delta x\)在合理的范围内,则适当减小\(\mu\),减小后的\(\mu\)将用于下次迭代,相当于允许下次迭代时\(\Delta x\)有更大的取值,以尽可能地加快收敛速度。
通过这样的调控,L-M算法即保证了收敛的稳定性,又加快了收敛速度。
\(\mu\)初始值: \(\mu\)的值应该和\(H\)的最大特征值在一个数量级。对于\(J^TJ\)对角线上的最大元素和最大特征值在一个数量级:
\(\mu\)更新:
实际下降比上近似下降
if\(\rho > 0\)
\(\mu = \mu * max\{ 1/3, 1-(2\rho-1)^3 \} \quad v = 2\)
else
\(\mu = \mu * v \quad v = 2 * v\)
详见:methods for non-linear least squares problems
Reference
[1] https://en.wikipedia.org/wiki/Fast_inverse_square_root
[2] https://baike.baidu.com/item/0x5f375a86/10449453
[3] https://blog.csdn.net/zdy0_2004/article/details/52477640
[4] https://en.wikipedia.org/wiki/Gauss%E2%80%93Newton_algorithm#Derivation_from_Newton.27s_method
[5] https://www8.cs.umu.se/kurser/5DA001/HT07/lectures/lsq-handouts
[6] The Levenberg-Marquardt algorithm for nonlinear least squares curve-fitting problems
[7] https://zhuanlan.zhihu.com/p/147275344
[8] https://bl.ocks.org/EmilienDupont/aaf429be5705b219aaaf8d691e27ca87
[9] https://github.com/lilipads/gradient_descent_viz
[10] https://en.wikipedia.org/wiki/Test_functions_for_optimization
[11] http://users.ics.forth.gr/~lourakis/levmar/levmar.pdf