Gradient Descent 是一个一阶最优化算法,通常也称为最速下降法。 要使用梯度下降法找到一个函数的局部极小值,必须向函数上当前点对应梯度(或者是近似梯度)的反方向的规定步长距离点进行迭代搜索。如果相反地向梯度正方向迭代进行搜索,则会接近函数的局部极大值点;这个过程则被称为梯度上升法。
梯度
在微积分里面,对多元函数的参数求∂偏导数,把求得的各个参数的偏导数以向量的形式写出来,就是梯度。比如函数\(f(x,y)\), 分别对x,y求偏导数,求得的梯度向量就是\((∂f/∂x, ∂f/∂y)^T\),简称\(grad f(x,y)\)或者\(▽f(x,y)\)。对于在点\((x0,y0)\)的具体梯度向量就是\((∂f/∂x0, ∂f/∂y0)^T\).或者\(▽f(x0,y0)\),如果是3个参数的向量梯度,就是\((∂f/∂x, ∂f/∂y,∂f/∂z)^T\),以此类推。
那么这个梯度向量求出来有什么意义呢?他的意义从几何意义上讲,就是函数变化增加最快的地方。具体来说,对于函数\(f(x,y)\),在点\((x0,y0)\),沿着梯度向量的方向就是\((∂f/∂x0, ∂f/∂y0)^T\)的方向是\(f(x,y)\)增加最快的地方。或者说,沿着梯度向量的方向,更加容易找到函数的最大值。反过来说,沿着梯度向量相反的方向,也就是\(-(∂f/∂x0, ∂f/∂y0)^T\)的方向,梯度减少最快,也就是更加容易找到函数的最小值。
梯度下降与梯度上升
在机器学习算法中,在最小化损失函数时,可以通过梯度下降法来一步步的迭代求解,得到最小化的损失函数,和模型参数值。反过来,如果我们需要求解损失函数的最大值,这时就需要用梯度上升法来迭代了。
梯度下降法和梯度上升法是可以互相转化的。比如我们需要求解损失函数\(f(θ)\)的最小值,这时我们需要用梯度下降法来迭代求解。但是实际上,我们可以反过来求解损失函数\(-f(θ)\)的最大值,这时梯度上升法就派上用场了。
下面来详细总结下梯度下降法。
梯度下降法算法详解
梯度下降的直观解释
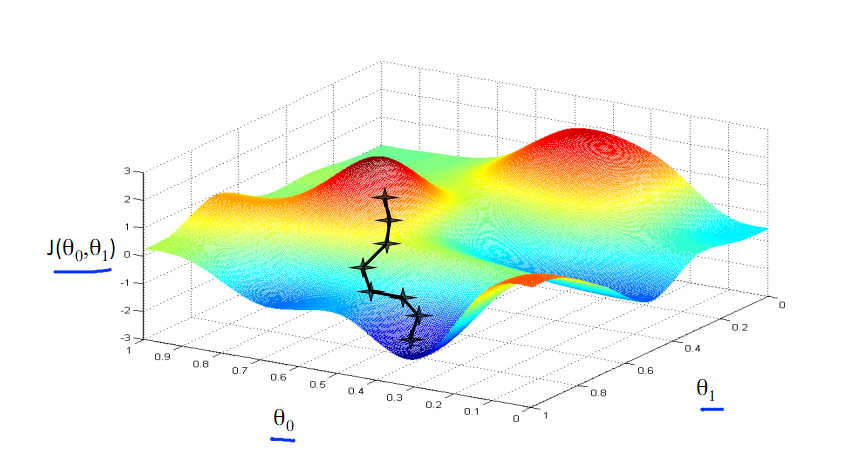
首先来看看梯度下降的一个直观的解释。比如我们在一座大山上的某处位置,由于我们不知道怎么下山,于是决定走一步算一步,也就是在每走到一个位置的时候,求解当前位置的梯度,沿着梯度的负方向,也就是当前最陡峭的位置向下走一步,然后继续求解当前位置梯度,向这一步所在位置沿着最陡峭最易下山的位置走一步。这样一步步的走下去,一直走到觉得我们已经到了山脚。当然这样走下去,有可能我们不能走到山脚,而是到了某一个局部的山峰低处。
从上面的解释可以看出,梯度下降不一定能够找到全局的最优解,有可能是一个局部最优解。当然,如果损失函数是凸函数,梯度下降法得到的解就一定是全局最优解。
梯度下降的相关概念
在详细了解梯度下降的算法之前,我们先看看相关的一些概念。
1. 步长(Learning rate):步长决定了在梯度下降迭代的过程中,每一步沿梯度负方向前进的长度。用上面下山的例子,步长就是在当前这一步所在位置沿着最陡峭最易下山的位置走的那一步的长度。
2.特征(feature):指的是样本中输入部分,比如2个单特征的样本\((x(0),y(0)),(x(1),y(1))\),则第一个样本特征为\(x(0)\),第一个样本输出为y(0)。
3. 假设函数(hypothesis function):在监督学习中,为了拟合输入样本,而使用的假设函数,记为\(hθ(x)\)。比如对于单个特征的m个样本\((x(i),y(i))(i=1,2,...m)\),可以采用拟合函数如下:\(h_θ(x)=θ0+θ1x\)。
4. 损失函数(loss function):为了评估模型拟合的好坏,通常用损失函数来度量拟合的程度。损失函数极小化,意味着拟合程度最好,对应的模型参数即为最优参数。在线性回归中,损失函数通常为样本输出和假设函数的差取平方。比如对于m个样本\((xi,yi)(i=1,2,...m)\),采用线性回归,损失函数为:
其中\(x_i\)表示第i个样本特征,\(y_i\)表示第i个样本对应的输出,\(h_\theta(x_i\))为假设函数。
梯度下降的详细算法
梯度下降法的算法可以有代数法和矩阵法(也称向量法)两种表示,如果对矩阵分析不熟悉,则代数法更加容易理解。不过矩阵法更加的简洁,且由于使用了矩阵,实现逻辑更加的一目了然。这里先介绍代数法,后介绍矩阵法。
梯度下降法的代数方式描述
- 先决条件: 确认优化模型的假设函数和损失函数。
比如对于线性回归,假设函数表示为\(hθ(x1,x2,...xn)=θ0+θ1x1+...+θnxn\), 其中\(θi (i = 0,1,2... n)\)为模型参数,\(xi (i = 0,1,2... n)\)为每个样本的n个特征值。这个表示可以简化,我们增加一个特征\(x_0=1\),这样\(hθ(x0,x1,...xn) = \sum_{i = 0}^{n}\Theta_ix_i\)。
同样是线性回归,对应于上面的假设函数,损失函数为:
- 算法相关参数初始化:主要是初始化\(θ0,θ1...,θn\),算法终止距离ε以及步长α。在没有任何先验知识的时候,我喜欢将所有的θ初始化为0, 将步长初始化为1。在调优的时候再 优化。
- 算法过程:
1)确定当前位置的损失函数的梯度,对于θi,其梯度表达式如下:
2)用步长乘以损失函数的梯度,得到当前位置下降的距离,即\(\alpha\frac {\partial}{\partial\theta_i}J(\theta_i, \theta_1, ..., \theta_n)\)对应于前面登山例子中的某一步。
3)确定是否所有的\(θi\),梯度下降的距离都小于ε,如果小于ε则算法终止,当前所有的\(θi(i=0,1,...n)\)即为最终结果。否则进入步骤4.
4)更新所有的θ,对于θi,其更新表达式如下。更新完毕后继续转入步骤1.
下面用线性回归的例子来具体描述梯度下降。假设我们的样本是\((x_{1}^{(0)}, x_{2}^{(0)}, ..., x_{n}^{(0)}, y_0), (x_{1}^{(1)}, x_{2}^{(1)}, ..., x_{n}^{(1)}, y_1), ..., (x_{1}^{(n)}, x_{2}^{(n)}, ..., x_{n}^{(n)}, y_n)\),损失函数如前面先决条件所述:
则在算法过程步骤1中对于θi 的偏导数计算如下:
由于样本中没有\(x_0\)上式中令所有的\(x_0^j\)为1.
步骤4中\(\theta_i\)的更新表达式如下:
从这个例子可以看出当前点的梯度方向是由所有的样本决定的,加1m 是为了好理解。由于步长也为常数,他们的乘机也为常数,所以这里α1m可以用一个常数表示。
在下面第4节会详细讲到的梯度下降法的变种,他们主要的区别就是对样本的采用方法不同。这里我们采用的是用所有样本。
梯度下降法的矩阵方式描述
这一部分主要讲解梯度下降法的矩阵方式表述,相对于3.3.1的代数法,要求有一定的矩阵分析的基础知识,尤其是矩阵求导的知识。
1. 先决条件: 和3.3.1类似, 需要确认优化模型的假设函数和损失函数。对于线性回归,假设函数\(h_\theta(x_0, x_1, ..., x_n) = \theta_0 + \theta_1x_1 + ... + \theta_nx_n\)的矩阵表达方式为:
其中, 假设函数\(h_\theta(x)\)为mx1的向量,θ为(n+1)x1的向量,里面有n个代数法的模型参数。X为mx(n+1)维的矩阵。m代表样本的个数,n+1代表样本的特征数。
损失函数的表达式为:\(J(\theta) = \frac{1}{2}(X\theta - Y)^T(X\theta - Y)\), 其中Y是样本的输出向量,维度为mx1.
2. 算法相关参数初始化: θ向量可以初始化为默认值,或者调优后的值。算法终止距离ε,步长α和3.3.1比没有变化。
3. 算法过程:
1)确定当前位置的损失函数的梯度,对于θ向量,其梯度表达式如下:
2)用步长乘以损失函数的梯度,得到当前位置下降的距离,即\(\alpha\frac{\partial}{\partial\theta}J(\theta)\)对应于前面登山例子中的某一步。
3)确定θ向量里面的每个值,梯度下降的距离都小于ε,如果小于ε则算法终止,当前θ向量即为最终结果。否则进入步骤4.
4)更新θ向量,其更新表达式如下。更新完毕后继续转入步骤1.
\(\theta = \theta - \alpha\frac{\partial}{\partial\theta}J(\theta)\)
还是用线性回归的例子来描述具体的算法过程。
损失函数对于θ向量的偏导数计算如下:
步骤4中θ向量的更新表达式如下:\(\theta = \theta - \alpha X^T(X\theta - Y)\)
对于3.3.1的代数法,可以看到矩阵法要简洁很多。这里面用到了矩阵求导链式法则,和两个矩阵求导的公式。
公式1:\(\frac{\partial}{\partial X} = 2X\)
公式2:\(\frac{\partial}{\partial\theta} = X^T\)
如果需要熟悉矩阵求导建议参考张贤达的《矩阵分析与应用》一书。
梯度下降的算法调优
在使用梯度下降时,需要进行调优。哪些地方需要调优呢?
1. 算法的步长选择。在前面的算法描述中,我提到取步长为1,但是实际上取值取决于数据样本,可以多取一些值,从大到小,分别运行算法,看看迭代效果,如果损失函数在变小,说明取值有效,否则要增大步长。前面说了。步长太大,会导致迭代过快,甚至有可能错过最优解。步长太小,迭代速度太慢,很长时间算法都不能结束。所以算法的步长需要多次运行后才能得到一个较为优的值。
2. 算法参数的初始值选择。 初始值不同,获得的最小值也有可能不同,因此梯度下降求得的只是局部最小值;当然如果损失函数是凸函数则一定是最优解。由于有局部最优解的风险,需要多次用不同初始值运行算法,关键损失函数的最小值,选择损失函数最小化的初值。
3.归一化。由于样本不同特征的取值范围不一样,可能导致迭代很慢,为了减少特征取值的影响,可以对特征数据归一化,也就是对于每个特征x,求出它的期望\(\overline{x}\)和标准差std(x),然后转化为:
\(\frac{x - \overline{x}}{std(x)}\)
这样特征的新期望为0,新方差为1,迭代次数可以大大加快。
梯度下降法大家族(BGD,SGD,MBGD)
批量梯度下降法(Batch Gradient Descent)
批量梯度下降法,是梯度下降法最常用的形式,具体做法也就是在更新参数时使用所有的样本来进行更新,这个方法对应于前面3.3.1的线性回归的梯度下降算法,也就是说3.3.1的梯度下降算法就是批量梯度下降法。
由于我们有m个样本,这里求梯度的时候就用了所有m个样本的梯度数据。
随机梯度下降法(Stochastic Gradient Descent)
随机梯度下降法,其实和批量梯度下降法原理类似,区别在与求梯度时没有用所有的m个样本的数据,而是仅仅选取一个样本j来求梯度。对应的更新公式是:
随机梯度下降法,和4.1的批量梯度下降法是两个极端,一个采用所有数据来梯度下降,一个用一个样本来梯度下降。自然各自的优缺点都非常突出。对于训练速度来说,随机梯度下降法由于每次仅仅采用一个样本来迭代,训练速度很快,而批量梯度下降法在样本量很大的时候,训练速度不能让人满意。对于准确度来说,随机梯度下降法用于仅仅用一个样本决定梯度方向,导致解很有可能不是最优。对于收敛速度来说,由于随机梯度下降法一次迭代一个样本,导致迭代方向变化很大,不能很快的收敛到局部最优解。
那么,有没有一个中庸的办法能够结合两种方法的优点呢?有!这就是4.3的小批量梯度下降法。
小批量梯度下降法(Mini-batch Gradient Descent)
小批量梯度下降法是批量梯度下降法和随机梯度下降法的折衷,也就是对于m个样本,我们采用x个样子来迭代,1<x<m。一般可以取x=10,当然根据样本的数据,可以调整这个x的值。对应的更新公式是:
例子
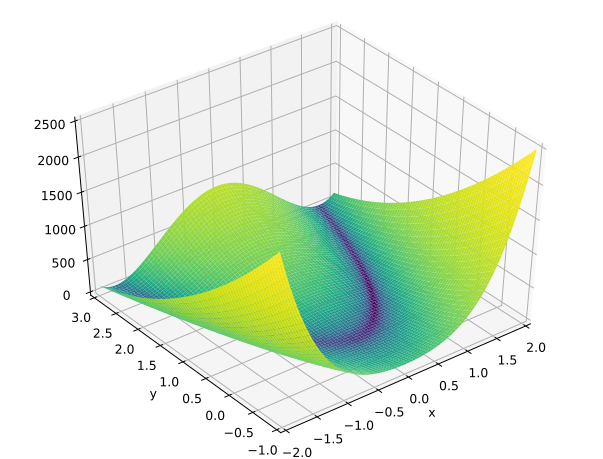
假设有函数(Rosenbrock函数:是一个用来测试最优化算法性能的非凸函数,由Howard Harry Rosenbrock在1960年提出[1]。也称为Rosenbrock山谷或Rosenbrock香蕉函数,也简称为香蕉函数)如下定义:
很明显,其最小最为\(f(1 ,1) = 0\),其三维图片如下:
 函数f 分别对 x,y 求导得到
在实现的过程中可以给出x, y初始值(例如设置为 0, 0) 然后计算函数在这个点的梯度,并按照梯度方向更新x, y的值。
这里给出通过梯度下降法计算上述函数的最小值对应的x 和 y
import numpy as np

def cal_rosenbrock(x1, x2):
    """
    计算rosenbrock函数的值
    :param x1:
    :param x2:
    :return:
    """
    return (1 - x1) ** 2 + 100 * (x2 - x1 ** 2) ** 2


def cal_rosenbrock_prax(x1, x2):
    """
    对x1求偏导
    """
    return -2 + 2 * x1 - 400 * (x2 - x1 ** 2) * x1

def cal_rosenbrock_pray(x1, x2):
    """
    对x2求偏导
    """
    return 200 * (x2 - x1 ** 2)

def for_rosenbrock_func(max_iter_count=100000, step_size=0.001):
    pre_x = np.zeros((2,), dtype=np.float32)
    loss = 10
    iter_count = 0
    while loss > 0.001 and iter_count < max_iter_count:
        error = np.zeros((2,), dtype=np.float32)
        error[0] = cal_rosenbrock_prax(pre_x[0], pre_x[1])
        error[1] = cal_rosenbrock_pray(pre_x[0], pre_x[1])

        for j in range(2):
            pre_x[j] -= step_size * error[j]

        loss = cal_rosenbrock(pre_x[0], pre_x[1])  # 最小值为0

        print("iter_count: ", iter_count, "the loss:", loss)
        iter_count += 1
    return pre_x

if __name__ == '__main__':
    w = for_rosenbrock_func()
    print(w)
单变量函数的梯度下降
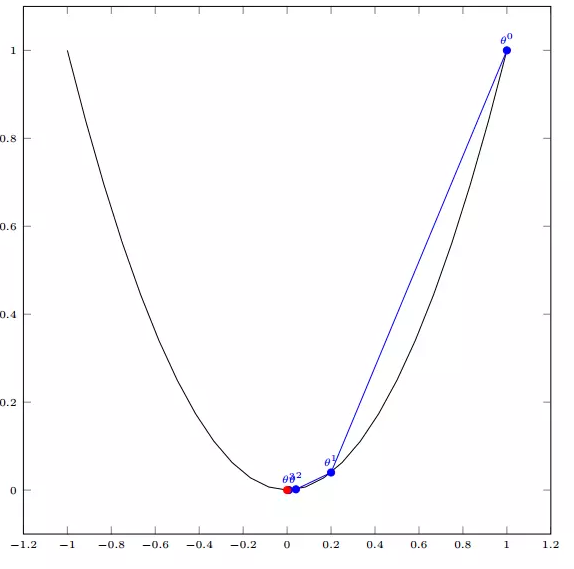
假设单变量函数:
函数的微分:
初始化,起点为:
学习率为:
根据梯度下降公式:
开始地图下降迭代算法:
如图,经过四次迭代,函数到达最低点。
多变量函数梯度下降
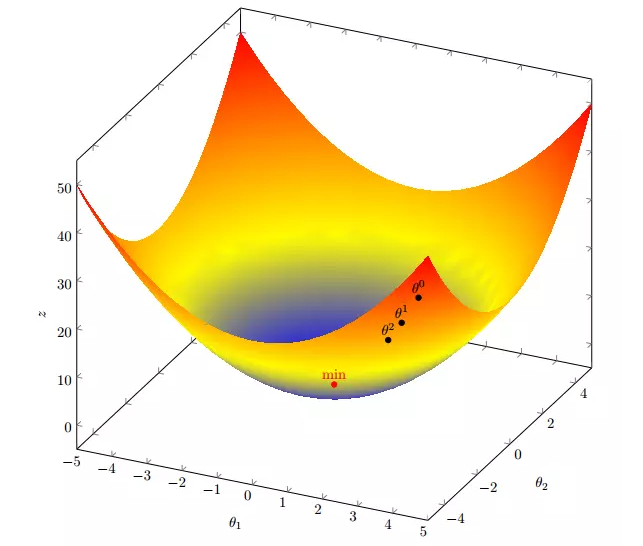
假设一个目标函数
现在要通过梯度下降法计算这个函数的最小值。我们通过观察就能发现最小值其实就是 (0,0)点。但是接下来,我们会从梯度下降算法开始一步步计算到这个最小值! 我们假设初始的起点为:
初始的学习率:
进行多次迭代:
线性回归
一般的线性回归方程如下:
转换为统一形式:
这里\(\theta_0 = 1\)转换为向量形式:
这里\(\theta\)、\(x\)均为行向量。
现在需要定义损函数,用于判断最后得到的预测参数的预测效果。常用的损失函数是均方误差:
\(i\)是维度索引,\(j\)是样本索引,对\(\theta\)求导得到:
更新公式为:
BGM--批量梯度下降法
import numpy as np

def gen_line_data(sample_num=100):
    """
    y = 3*x1 + 4*x2
    :return:
    """
    x1 = np.linspace(0, 9, sample_num)
    x2 = np.linspace(4, 13, sample_num)
    x = np.concatenate(([x1], [x2]), axis=0).T
    y = np.dot(x, np.array([3, 4]).T)  # y 列向量
    return x, y

def bgd(samples, y, step_size=0.01, max_iter_count=10000):
    sample_num, dim = samples.shape
    y = y.flatten()
    w = np.ones((dim,), dtype=np.float32)
    loss = 10
    iter_count = 0
    while loss > 0.001 and iter_count < max_iter_count:
        loss = 0
        error = np.zeros((dim,), dtype=np.float32)
        for i in range(sample_num):
            predict_y = np.dot(w.T, samples[i])
            for j in range(dim):
                error[j] += (y[i] - predict_y) * samples[i][j]

        for j in range(dim):
            w[j] += step_size * error[j] / sample_num

        for i in range(sample_num):
            predict_y = np.dot(w.T, samples[i])
            error = (1 / (sample_num * dim)) * np.power((predict_y - y[i]), 2)
            loss += error

        print("iter_count: ", iter_count, "the loss:", loss)
        iter_count += 1
    return w

if __name__ == '__main__':
    samples, y = gen_line_data()
    w = bgd(samples, y)
    print(w)
SGB--随机梯度下降法
import numpy as np

def gen_line_data(sample_num=100):
    """
    y = 3*x1 + 4*x2
    :return:
    """
    x1 = np.linspace(0, 9, sample_num)
    x2 = np.linspace(4, 13, sample_num)
    x = np.concatenate(([x1], [x2]), axis=0).T
    y = np.dot(x, np.array([3, 4]).T)  # y 列向量
    return x, y

def sgd(samples, y, step_size=0.01, max_iter_count=10000):
    """
    随机梯度下降法
    :param samples: 样本
    :param y: 结果value
    :param step_size: 每一接迭代的步长
    :param max_iter_count: 最大的迭代次数
    :param batch_size: 随机选取的相对于总样本的大小
    :return:
    """
    sample_num, dim = samples.shape
    y = y.flatten()
    w = np.ones((dim,), dtype=np.float32)
    loss = 10
    iter_count = 0
    while loss > 0.001 and iter_count < max_iter_count:
        loss = 0
        error = np.zeros((dim,), dtype=np.float32)
        for i in range(sample_num):
            predict_y = np.dot(w.T, samples[i])
            for j in range(dim):
                error[j] += (y[i] - predict_y) * samples[i][j]
                w[j] += step_size * error[j] / sample_num

        # for j in range(dim):
        #     w[j] += step_size * error[j] / sample_num

        for i in range(sample_num):
            predict_y = np.dot(w.T, samples[i])
            error = (1 / (sample_num * dim)) * np.power((predict_y - y[i]), 2)
            loss += error

        print("iter_count: ", iter_count, "the loss:", loss)
        iter_count += 1
    return w

if __name__ == '__main__':
    samples, y = gen_line_data()
    w = sgd(samples, y)
    print(w)
MBGB--小批量梯度下降法
import numpy as np
import random

def gen_line_data(sample_num=100):
    """
    y = 3*x1 + 4*x2
    :return:
    """
    x1 = np.linspace(0, 9, sample_num)
    x2 = np.linspace(4, 13, sample_num)
    x = np.concatenate(([x1], [x2]), axis=0).T
    y = np.dot(x, np.array([3, 4]).T)  # y 列向量
    return x, y

def mbgd(samples, y, step_size=0.01, max_iter_count=10000, batch_size=0.2):
    """
    MBGD(Mini-batch gradient descent)小批量梯度下降:每次迭代使用b组样本
    :param samples:
    :param y:
    :param step_size:
    :param max_iter_count:
    :param batch_size:
    :return:
    """
    sample_num, dim = samples.shape
    y = y.flatten()
    w = np.ones((dim,), dtype=np.float32)
    # batch_size = np.ceil(sample_num * batch_size)
    loss = 10
    iter_count = 0
    while loss > 0.001 and iter_count < max_iter_count:
        loss = 0
        error = np.zeros((dim,), dtype=np.float32)

        # batch_samples, batch_y = select_random_samples(samples, y,
        # batch_size)

        index = random.sample(range(sample_num),
                              int(np.ceil(sample_num * batch_size)))
        batch_samples = samples[index]
        batch_y = y[index]

        for i in range(len(batch_samples)):
            predict_y = np.dot(w.T, batch_samples[i])
            for j in range(dim):
                error[j] += (batch_y[i] - predict_y) * batch_samples[i][j]

        for j in range(dim):
            w[j] += step_size * error[j] / sample_num

        for i in range(sample_num):
            predict_y = np.dot(w.T, samples[i])
            error = (1 / (sample_num * dim)) * np.power((predict_y - y[i]), 2)
            loss += error

        print("iter_count: ", iter_count, "the loss:", loss)
        iter_count += 1
    return w

if __name__ == '__main__':
    samples, y = gen_line_data()
    w = mbgd(samples, y)
    print(w)