算法原理
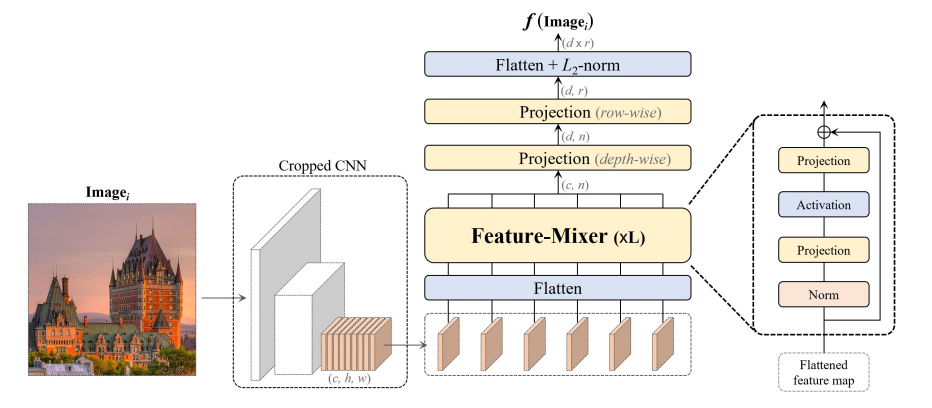
给定一个图像I,首先从CNN主干网的中间层提取其特征图\(\mathbf{F} \in R^{c \times h \times w}\).认为三维张量F是一组大小为h×w的二维特征:
将二维特征扁平化重塑为一维表示,得到扁平化特征图\(\mathbf{I} \in R^{c \times n}\),其中\(n = h \times w\)。 把它们送入特征混合器,一个结构相同的L个MLP块的级联。
对于一个给定的输入\(F\in R^{c\times n}\),特征混合器(FM)产生一个相同形状的输出\(Z\in R^{c\times n}\)(由于其各向同性的结构),将其送入第二个特征混合器块,以此类推,直到我们达到L个连续块,如下所示:
Z通常是高维的(因为它的维度与提取的特征图F相同)。为了进一步降低其维度,我们在它后面加了两个全连接层,依次降低其深度(通道)和行的维度。这可以被看作是一个加权池运算,能够控制最终全局描述符的大小。
Feature-Mixer背后的直觉是,利用全连接层的能力,以整体的方式自动聚合特征,而不是专注于局部特征,并迫使网络通过注意力机制。特征混合器取代了分层(金字塔)聚合,这要归功于它的全受体场,每个神经元都能看到整个输入图像的情况。使用一个级联的Feature-Mixer块,以便在每个单独的特征图中迭代地纳入空间特征之间的关系。
Export ONNX and NCNN
import sys
from os.path import abspath, join, dirname
sys.path.insert(0, join(abspath(dirname(__file__)), './MixVPR/'))
import os
import argparse
import numpy
import torch
from torchvision import transforms
import torchvision.models as models
from PIL import Image
import onnx
import onnxruntime
import ncnn
import pnnx
from onnxsim import simplify
import pytorch_lightning as pl
from models import helper
import utils

# https://github.com/amaralibey/MixVPR

if __name__ == "__main__":
    parser = argparse.ArgumentParser()
    parser.add_argument('--output', default = './output', type = str, help='output path.')
    parser.add_argument('--image', default = './image.jpg', type = str, help='image input.')
    options = parser.parse_args()


    # https://drive.google.com/file/d/1vuz3PvnR7vxnDDLQrdHJaOA04SQrtk5L/view?usp=share_link
    # https://drive.google.com/file/d/1khiTUNzZhfV2UUupZoIsPIbsMRBYVDqj/view?usp=share_link
    model_path = os.path.join(options.output, 'resnet50_MixVPR_512_channels(256)_rows(2).ckpt')
    vpr_model = VPRModel(backbone_arch='resnet50',
                     layers_to_crop=[4],
                     agg_arch='MixVPR',
                     agg_config={'in_channels': 1024,
                                 'in_h': 20,
                                 'in_w': 20,
                                 'out_channels': 256,
                                 'mix_depth': 4,
                                 'mlp_ratio': 1,
                                 'out_rows': 2},
                     )

    state_dict = torch.load(model_path)
    vpr_model.load_state_dict(state_dict)
    vpr_model.eval()
    vpr_model.cpu()

    class TinyModel(torch.nn.Module):
        def __init__(self, backbone, aggregator):
            super(TinyModel, self).__init__()
            self.backbone = backbone
            self.aggregator = aggregator
            #self.backbone = models.resnet50(pretrained=True)
        def forward(self, x):
            x = self.backbone(x)
            x = self.aggregator(x)
            return x

    model = TinyModel(vpr_model.backbone, vpr_model.aggregator)

    input = torch.randn(1, 3, 320, 320)
    vpr_out = vpr_model(input)
    out = model(input)
    print(f"vpr_out:\n{vpr_out}")
    print(f"out:\n{out}")

    if not os.path.exists(options.output):
        os.makedirs(options.output)

    # export onnx
    onnx_path = os.path.join(options.output, 'model.onnx')
    torch.onnx.export(model, input, onnx_path, verbose=False, opset_version=13, input_names=['img'], output_names=['des'],)

    # sim
    onnxsim_path = os.path.join(options.output, 'model.sim.onnx')
    onnx_model = onnx.load(onnx_path)
    model_sim, check = simplify(onnx_model)
    assert check, "simplified ONNX model could not be validated"
    onnx.save(model_sim, onnxsim_path)
    # onnx2ncnn ./model.sim.onnx ./model.param ./model.bin

    # pnnx
    print(f"pnnx version: {pnnx.__version__}")
    pnnx_path = os.path.join(options.output, 'model.pt')
    model_pnnx = pnnx.export(model, pnnx_path, input)

    pnnx_param_path = os.path.join(options.output, 'model.ncnn.param')
    pnnx_bin_path = os.path.join(options.output, 'model.ncnn.bin')
    pnnx_net = ncnn.Net()
    pnnx_net.opt.use_vulkan_compute = False
    pnnx_net.load_param(pnnx_param_path)
    pnnx_net.load_model(pnnx_bin_path)
    input_names = pnnx_net.input_names()
    output_names = pnnx_net.output_names()
    print(f'input_names: {input_names}')
    print(f'output_names: {output_names}')
    pnnx_ex = pnnx_net.create_extractor()
    pnnx_ex.set_num_threads(1)
    pnnx_ex.input(input_names[0], ncnn.Mat(input.squeeze(0).numpy()).clone())
    ret, output = pnnx_ex.extract(output_names[0])
    print(f"output:\n{torch.from_numpy(numpy.array(output))}")
# endof main
试验
MixVPR与NetVLAD使用NCNN部署性能对比:
测试环境CPU:Intel(R) Core(TM) i9-10940X CPU @ 3.30GHz x28,GPU:NVIDIA RTX A4000 x4.
CPU运行时启用14个核,GPU运行时启用1个GPU。NetVLAD输入为640x480,MixVPR输入为320x320.
| OpenIBL NetVLAD 耗时(s) | MixVPR ResNet50-512 耗时(s) | MixVPR ResNet18-512 耗时(s) | OpenIBL NetVLAD Recall(TOP1) | MixVPR ResNet50-512 Recall(TOP1) | MixVPR ResNet18-512 Recall(TOP1) | |
|---|---|---|---|---|---|---|
| CPU | 0.34067136 | 0.033859275 | 0.016765615 | 0.9110147 | 0.9213985 | 0.9114090 |
| GPU | 0.11593787 | 0.009852698 | 0.008098234 | 0.9048370 | 0.9217928 | 0.9119348 |
Reference
[0] https://github.com/amaralibey/MixVPR
[1] https://zhuanlan.zhihu.com/p/619906188
[2] https://github.com/amaralibey/OpenVPRLab