VGGT-Ω
作者: Jianyuan Wang、Minghao Chen、Shangzhan Zhang、Nikita Karaev、Johannes Schönberger、Patrick Labatut、Piotr Bojanowski、David Novotny、Andrea Vedaldi、Christian Rupprecht
机构: 牛津大学视觉几何组;Meta AI
arXiv: 2605.15195
摘要
VGGT 等近期前馈式重建模型(feed-forward reconstruction model)的性能已可媲美传统的基于优化的重建方法,同时还能提供适用于其他任务的几何感知特征。 本文表明,这些模型的质量随模型规模和数据规模以可预测的方式提升。 为此,我们提出 VGGT-Ω,其在静态与动态场景中均显著提升了重建精度、效率和能力。 为以前所未有的规模训练该模型,我们引入提高训练效率的架构改进、支持动态场景的高质量数据标注流程,以及自监督学习方案。 我们采用具有多任务监督的单个稠密预测头,并移除计算代价高昂的高分辨率卷积层,从而简化 VGGT 的架构。 此外,我们使用寄存器将场景信息聚合为紧凑表示,并提出寄存器注意力,将帧间信息交换限制在这些寄存器上,以部分替代全局注意力。 由此,训练期间 VGGT-Ω 仅使用其前代模型约 \(\sim\)30% 的 GPU 内存,使我们能够以比以往工作多 15\(\times\) 的监督数据训练 VGGT-Ω,并利用海量无标签视频数据。 VGGT-Ω 在多个基准的静态与动态场景重建上均取得优异结果,例如,其在 Sintel 上的相机估计精度较此前最佳结果提升 77%。 我们还表明,学习得到的寄存器能够改进视觉-语言-动作(VLA)模型并支持语言对齐,这说明重建可作为空间理解的强大且可规模化的代理任务。
项目主页:http://vggt-omega.github.io/
引言
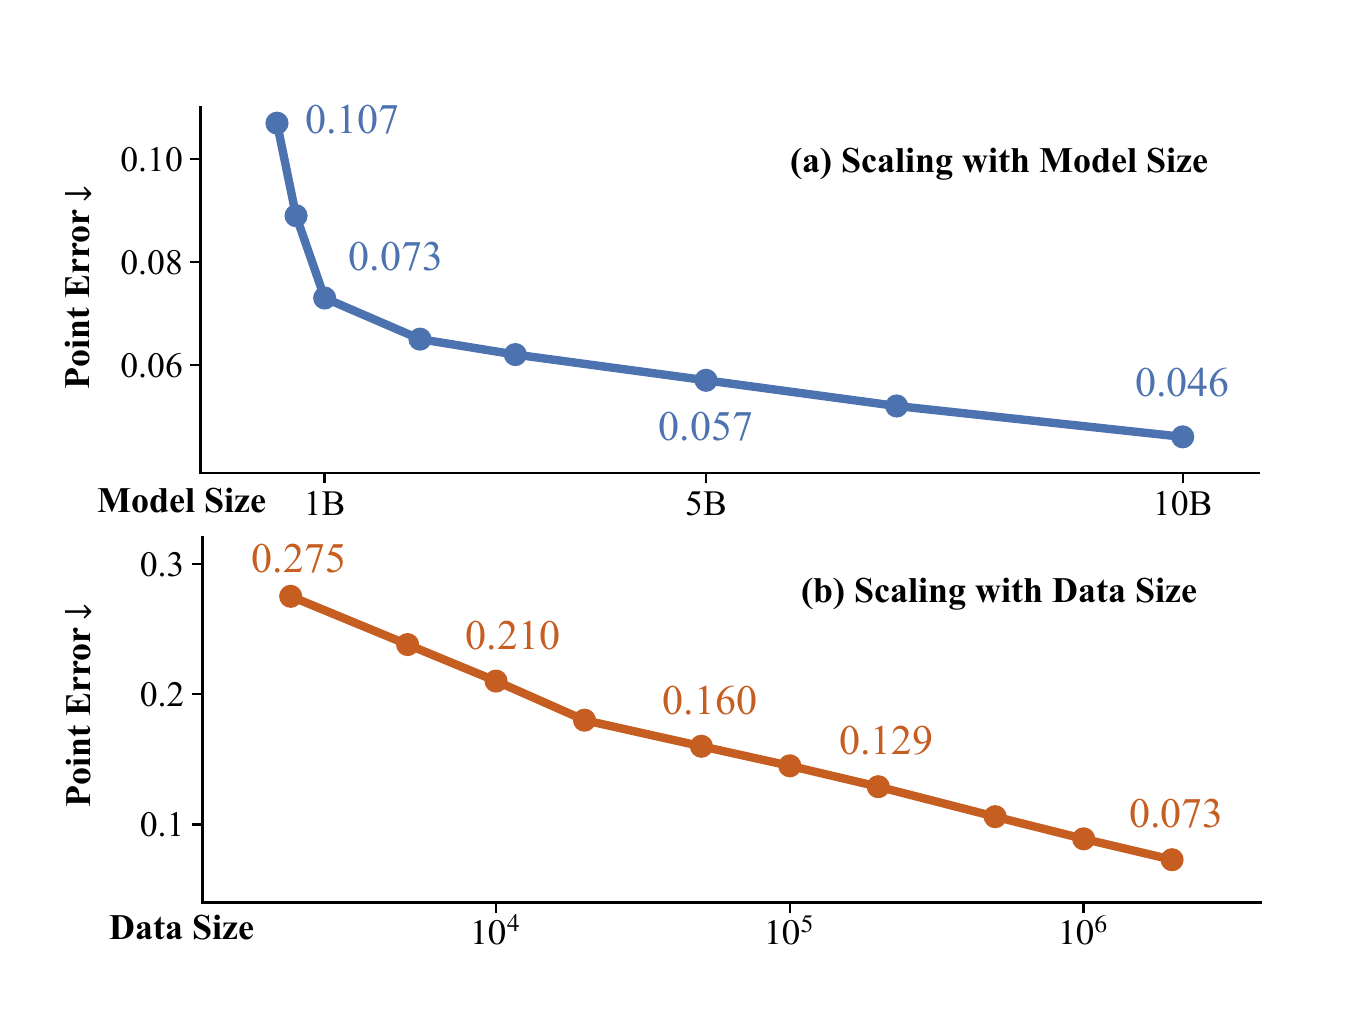
图:数据与模型参数规模扩展带来的性能增益。 随着模型规模从 0.2B 参数增至 10B 参数、数据规模从 2K 序列增至 2M 序列,以三维点误差衡量的性能持续提升(越低越好;请注意坐标轴刻度不同)。 所有模型均使用大致相同数量的词元进行训练,并取六个数据集上的平均结果进行评估;详情见 [sec:benchmarking]。
近期工作[wang24dust3r:, leroy24grounding, wang25vggt, wang25p3, lin25depth] 表明,前馈式重建模型在许多情况下能够比肩甚至超越传统的运动恢复结构(Structure-from-Motion,SfM)流程[hartley00multiple, snavely06photo, schonberger16structure-from-motion]。 此外,此类模型学习的词元已作为有效的几何感知表示用于众多其他任务[li25spatial, abouzeid25geoaware-vla:, zeng25janusvln:, qian26xembodied:, zhang26spatialstack:, zhang26make, zheng25learning, bonnen26human-level, wang26let-geometry, huang26gen3r:, jang26repurposing, yang26cambrian-s:, szymanowicz26lagernvs, cao26vggt-det:, gao26vggt-segmentor:, zhao25spacemind:, yang25dense, vuong25improving, rao26augvla-3d:, zhou26generalizing, xu26vggt-mpr:, wu26mvggt:, lee253d-aware]。 这说明重建可作为代理任务,用于学习一般空间理解所需的表示,具有基础性价值。 然而,相较于规模作用已得到充分认识的基础模型[simeoni25dinov3, kaplan20scaling, zhai22scaling],三维计算机视觉对此探索尚少。 因此,本文探究前馈式重建模型能否规模化,以及规模扩展会带来哪些收益。 为回答这一问题,我们提出 VGGT-Ω,将前馈式重建的数据规模以及可选的模型规模显著扩展至超越以往工作的水平。
与 VGGT[wang25vggt] 相比,新模型引入多项架构改进,首先是寄存器的使用方式。 近期工作[darcet24vision, jiang25vision, marouani26revisiting] 发现,视觉 Transformer(Vision Transformer,ViT)会自发利用少量图像词元承载全局信息,并引入可学习寄存器,以更直接、更高效地实现这一功能。 VGGT 已具有逐帧寄存器,而 VGGT-Ω 进一步提出寄存器注意力:在部分全局注意力层中,将帧间信息交换限制在寄存器上。 更新后的寄存器随后在帧内注意力层中与其他词元进行局部交互,从而形成聚合与再分发多帧信息的瓶颈。 这一设计促使寄存器聚合整个场景的信息,因此我们也称其为“场景”词元。
这一设计有两项优势。 首先,其他架构通常将寄存器视为辅助成分并在推理时丢弃[darcet24vision],而本文表明寄存器承载了有用的全局信息。 具体而言,尽管没有显式监督,寄存器仍可为视觉-语言-动作(Vision-Language-Action,VLA)模型和语言对齐提供有效特征。 其次,寄存器注意力还能提高效率。 全局注意力是 VGGT 的主要计算瓶颈,但其注意力图非常稀疏[shen26fastvggt:, wang25faster]。 我们发现,寄存器注意力通过聚合全局信息,也能成为完整全局注意力的高效替代方案。 具体而言,以寄存器注意力替换 25% 的全局注意力层不会造成可测量的性能下降,同时在训练期间为骨干网络节省约 23% 的 FLOPs 和 16% 的内存。以寄存器注意力替换全部全局注意力层可将 FLOPs 降至原来的 6%,但会导致明显的性能下降。
除寄存器外,我们还注意到,稠密预测头(例如,DPT)中的高分辨率卷积层虽然仅占模型参数的一小部分,却会消耗不成比例的 GPU 内存来存储前向激活。 FSDP 或梯度检查点等技术无法消除存储这些激活的开销。 因此,第二项改进是以单个 MLP 加像素重排算子,替代稠密预测器中内存开销最大的卷积层。 无论从定量还是定性结果看,这一设计都能在不降低性能的前提下大幅减少内存占用。
最后,我们已在 VGGT 中证明,直接监督深度图、点图和跟踪特征的多任务训练是有效的。 本文发现,实现这些收益并不需要额外的稠密预测头。 第三项改进是继续使用多任务损失,但仅保留一个用于深度预测的稠密预测头和一个用于相机预测的稀疏预测头。
这三项改进可在训练期间节省 70% 的 GPU 内存,并小幅提高推理速度。
除效率外,我们发现训练数据的数量、多样性和质量对规模扩展至关重要。 尤其是,处理动态内容十分关键,因为这能释放数量级更大的类互联网视频用于训练。 因此,我们开发了一套高质量数据标注流程,可大规模生成刚性视频与动态视频的标注。 该流程整合了基于视觉语言模型(VLM)的预筛选、VGGT、COLMAP、现代图像匹配模型和有监督几何后筛选。 在约 \(40\)M 个内部类互联网视频上应用后,该筛选流程保留了 \(0.8\)M 个具有准确标注的序列,其中约三分之一包含动态内容。 结合现有数据集(包括真实数据与合成数据),最终得到共 \(4\)M 个具有准确重建标注的多样化场景/序列,数量超过 VGGT 的 \(15\times\)。
为进一步提高泛化能力,我们引入受 DINO 及相关动量教师-学生方法启发的自监督学习方案[caron21emerging, oquab24dinov2:, simeoni25dinov3, tarvainen17mean, he20momentum]。 教师模型和学生模型均由有监督的 VGGT-Ω 检查点初始化。 两个模型在不同的数据增强与帧排列下处理相同的输入序列。 学生模型经过训练,在对齐帧顺序后匹配教师模型的预测和特征分布;教师模型则通过学生模型的指数移动平均进行更新。 我们使用该方案在 \(18\)M 个无标签视频上训练。
这些改进使我们得以研究前馈式重建模型的规模扩展特性。 如 [fig:scale] 所示,随着模型容量从 0.2B 参数增至 10B 参数、训练数据从数千个序列扩展至两百万个不同序列,以点误差衡量的重建精度持续呈现近似幂律的提升。
总体而言,VGGT-Ω 将前馈式重建性能提升到新的水平,在三个静态基准和三个动态基准上均以显著优势取得最先进结果。 特别是,它大幅超越 MegaSaM 等后优化方法以及 Depth Anything 3 等近期前馈式方法[lin25depth]。 在 Sintel 上,VGGT-Ω 的相机估计 AUC@\(3^\circ\) 达到 \(40.0\),对比此前的 \(22.5\) 提升 \(77\%\);AUC@\(30^\circ\) 达到 \(79.1\),对比 \(58.3\) 提升 \(35\%\)。其深度估计 \(\delta_{1.25}\) 达到 \(93.5\),对比 \(74.1\) 提升 \(26\%\),同时速度比 MegaSaM 快 \(50\times\)。 最后,我们表明学习得到的寄存器可复用于重建之外的任务,既能改进 VLA 模型,也能支持语言对齐。
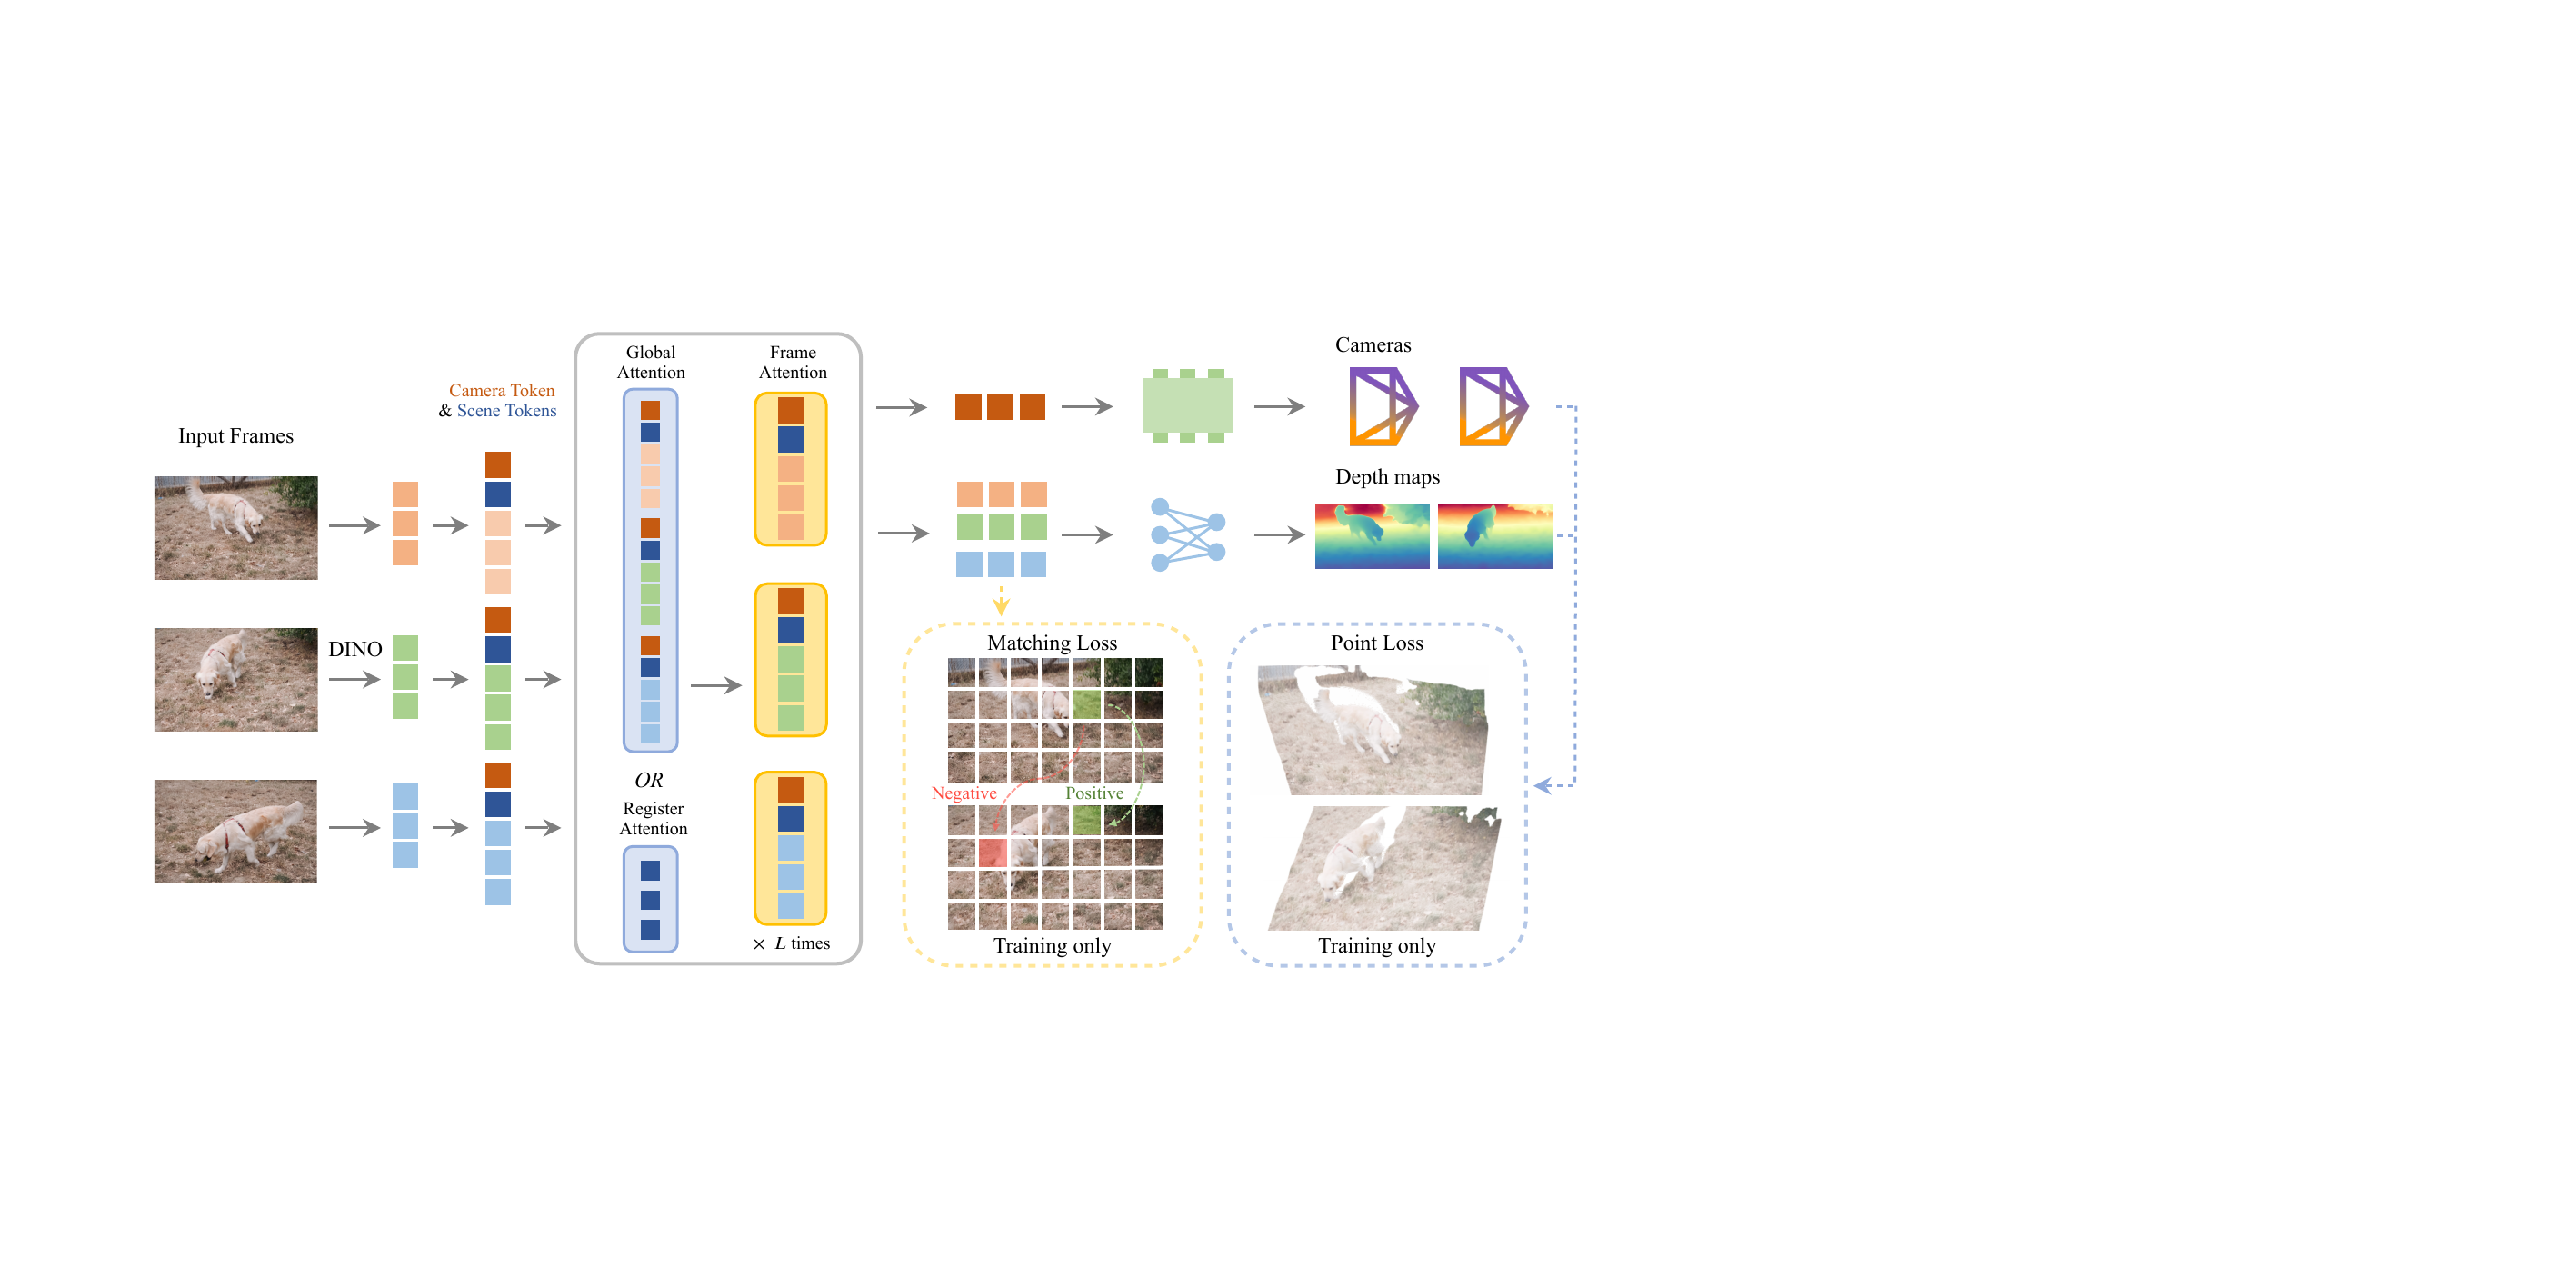
图:架构概览。VGGT-Ω 在图像词元后附加相机词元和场景词元(寄存器),随后交替通过全局注意力(或寄存器注意力)层与帧内注意力层。 我们用仅在训练时使用的损失替代 VGGT 中冗余的稠密预测头。
相关工作
三维重建。
三维重建研究历史悠久,其开端是奠定多视图几何理论的早期奠基性工作[faugeras90motion, oliensis00a-critique, hartley04multiple, ozyesil17a-survey]。 后续研究推动了重大的实践进展,包括 COLMAP 等鲁棒的 SfM 系统[schonberger16structure-from-motion] 及其他流程[snavely06photo, agarwal11building, frahm10building, liu24robust, dellaert12factor]。 本文关注前馈式重建模型,即,直接从一幅或多幅图像推断场景几何与相机位姿的神经网络。 尽管近期 SfM 流程越来越多地引入关键点检测器[yi16lift:, daniel18superpoint:, dusmanu19d2-net:, tyszkiewicz20disk:]、特征匹配器[sarlin20superglue:, chen21learning, shi22clustergnn:, lindenberger23lightglue:] 等可学习组件,但与本文最相关的是直接学习几何估计的端到端可微 SfM 框架[zhou17unsupervised, ummenhofer17demon:, tang19ba-net:, wei20deepsfm:, wang21deep, teed20deepv2d:, teed21droid-slam:, brachmann24scene, wang23posediffusion:, wang24vggsfm:]。 这些工作虽证明 SfM 可以进行端到端学习,但仍需组合经典 SfM 流程中的多个组成部分。 DUSt3R[wang24dust3r:] 及其后续工作 MASt3R[duisterhof25mast3r-sfm:] 可直接从图像估计场景几何与相机参数(外参与内参)。 然而,与立体视觉方法[niemeyer20differentiable, fu22geo-neus:, wei21nerfingmvs:, yariv20multiview, yao18mvsnet:, gu20cascade, ma22multiview, peng22rethinking, zhang23geomvsnet:] 类似,DUSt3R 和 MASt3R 中的神经网络仅处理图像对,在处理更多视图时仍需后优化。 能够联合处理多幅图像的方法带来了一项关键进展,它们不再需要跨视图优化[wang24spann3r:, wang25continuous, tang25mv-dust3r:, wu25point3r:, zhang25flare:, yang25fast3r:, elflein25light3r-sfm:]。 其中,VGGT[wang25vggt] 是代表性方法:它仅依靠前馈推理便首次超越后优化方法(例如,使用束调整的方法),并催生了大量后续工作[wang25p3, keetha26mapanything:, xiao25spatialtrackerv2:, chen25ttt3r:, deng25vggt-long:, lan26stream3r:, maggio25vggt-slam:, li25wint3r:, huang25longsplat:, szymanowicz26lagernvs, yuan25test3r:, deng26sail-recon:, jiang25anysplat:, cabon25must3r:, liu25plana3r:, li25rig3r:, zang26robust, chen26hd-vggt:, liu26streamcachevggt:, zhuo26streaming, jung26more:, mahdi25evict3r:, wang26lidar-vggt:, qi25fupad:, mazur264d-primitive-mache:]。 若干工作通过词元合并、稀疏注意力或基于描述子的聚合,提高 VGGT 类模型的计算可扩展性,使多视图前馈式重建更加高效[shen26fastvggt:, wang25faster, mahdi25evict3r:]。 另一些工作采用具有状态且容量受限的场景表示,以线性更新代价解决全局自注意力的二次复杂度问题。 例如,部分方法采用推理时训练层[chen26ttt3r:, jin26zipmap:, zhang26loger:]。 另一些方法[zhuo26streaming, lan26stream3r:, chen26geometric, taher25kv-tracker:] 以因果方式处理帧,同时通过缓存词元、键值对、局部窗口或地图来维持持久的几何状态。 还有一些工作使用 VGGT 进行局部场景重建,再通过对齐、定位或 SLAM 算法融合结果[deng25vggt-long:, maggio25vggt-slam:, deng26sail-recon:, wang25amb3r:]。
另有工作扩展 VGGT 类模型,使其能够接收额外的几何信息作为输入(例如,相机[keetha26mapanything:])、增加传感器(例如,LiDAR[wang26lidar-vggt:]),或对相机阵列进行建模[li25rig3r:]。 其他扩展工作预测法向量[fang26dens3r:],或采用混合专家设计[gao25more:, wang26moe3d:]。 PI3[wang25p3] 摆脱了对固定参考视图的依赖;Depth Anything 3(DA3)[lin25depth] 则采用原生 DINO 作为骨干网络,二者均支持动态场景。 部分研究探究了这些模型学到了什么,包括对应关系、极线结构,以及与人类三维形状感知之间的联系[bratulic25on-geometric, bonnen26human-level]。 SelfEvo[huang26self-improving] 探索了利用时空上下文不对称性的自蒸馏方案。 除重建本身外,前馈式重建模型学习的特征也被用作其他任务的几何感知表示。 相关应用包括视频生成与新视图合成[jiang25anysplat:, huang26gen3r:, jang26repurposing, liu26camgeo:, szymanowicz26lagernvs]、视觉语言模型[zeng25janusvln:, qian26xembodied:, zhang26spatialstack:, zhang26make, zheng25learning, wang26let-geometry, yang26cambrian-s:, zhao25spacemind:, wu26mvggt:, lee253d-aware]、视觉-语言-动作模型[li25spatial, abouzeid25geoaware-vla:, vuong25improving, rao26augvla-3d:],以及检测、分割、匹配、占用预测和地点识别等感知任务[cao26vggt-det:, gao26vggt-segmentor:, yang25dense, zhou26generalizing, xu26vggt-mpr:, deng25unipr-3d:]。
单目动态三维重建(即四维重建)旨在恢复随时间变化的场景几何。 这一研究方向同样历史悠久,早期代表性工作包括 Bregler 等人[bregler00recovering] 和 Torresani 等人[torresani08nonrigid] 的研究。 近期工作中,MegaSaM[li25megasam:] 尤具影响力,它将前馈式深度预测与基于优化的非刚性重建相结合。 ViPE[huang25vipe:] 在此方向上进一步推进。 若干工作探索了减少优化的前馈式四维重建。 MonST3R[zhang24monst3r:] 和 D\(^2\)USt3R[han25d2ust3r:] 扩展 DUSt3R,以处理动态三维内容。 Align3R[lu25align3r:] 基于 DUSt3R 推断相机,并沿时间维度对齐单目深度预测,但处理两个以上视图时仍依赖优化。 CUT3R[wang25continuous] 和 Point3R[wu25point3r:] 同时支持增量重建与动态场景。 Geo4D[jiang25geo4d] 通过微调视频生成器恢复四维几何。 PI3[wang25p3] 和 DA3[lin25depth] 采用 VGGT 类模型并以动态数据训练;PAGE-4D[zhou25page-4d:] 则通过分离静态区域与运动区域的模块改造 VGGT。 Human3R 专注于人-场景重建[chen25human3r:]。 SpatialTracker[xiao25spatialtrackerv2:]、St4RTrack[feng25st4rtrack:]、DPM[sucar25dynamic]、V-DPM[sucar26v-dpm]、Uni4D[yao25uni4d:]、Any4D[karhade2025any4d] 及相关方法统一了动态重建与点跟踪。 D4RT[zhang25efficiently] 提出统一的前馈式 Transformer,通过查询点级四维场景信息重建动态场景。
视觉 Transformer(ViT)中的寄存器。
近期工作[darcet24vision, marouani26revisiting] 发现,ViT 中的少量词元不仅编码局部图块信息,还编码全局信息。 这些离群词元具有较高范数,会破坏图块特征的空间连贯性。 这促使研究者使用独立于图像词元的寄存器词元,以帮助保持图块表示之间的连贯性。 后续研究进一步探究了这一现象的成因,以及寄存器词元与图像词元之间的交互[jiang25vision, shi26vision, lappe25register, marouani26revisiting]。 本文为每个输入图像帧加入寄存器词元,并使用它们跨图像聚合与交换全局信息。 由此,寄存器能够承载整个序列的信息。 不同于以往工作通常将其丢弃的做法,我们证明寄存器可用于下游应用。
方法
VGGT-Ω以原始 VGGT 为基础,并从多个方面加以改进。 首先介绍 VGGT-Ω的新架构([sec:architecture])与训练流程([sec:training-losses])。 随后介绍利用无标注数据的自监督训练方案([sec:self-supervised-training]),以及用于稳健标注数百万段视频的新数据流程([sec:data])。
新的可扩展架构
如[fig:architecture]所示,VGGT-Ω是一个前馈式 Transformer \(f\),将 \(N\) 张输入图像 $$ I_1,\dots,I_N \in \mathbb{R}^{3\times H \times W} $$ 映射为对应的相机和深度图: $$ ((\boldsymbol{g}_1, D_1),\dots,(\boldsymbol{g}_N,D_N)) = f(I_1,\dots,I_N), $$ 其中, \(D_i \in \mathbb{R}^{H \times W}\) 是图像 \(I_i\) 的深度图, \(\boldsymbol{g}_i = (\boldsymbol{q}_i, \boldsymbol{t}_i, \boldsymbol{f}_i) \in \mathbb{R}^{9}\) 由描述相应相机的 旋转四元数 \(\boldsymbol{q}_i \in \mathbb{R}^4\)、 平移向量 \(\boldsymbol{t}_i \in \mathbb{R}^3\) 和视场角 \(\boldsymbol{f}_i \in \mathbb{R}^2\) 拼接而成。 遵循常见做法[schonberger16structure-from-motion, wang24vggsfm:, wang25vggt],本文假设主点位于图像中心。 因此,该问题定义与 VGGT[wang25vggt]相似,但模型不会直接预测点图(Point Map)或跟踪特征(尽管仍会监督这些量,详见[sec:training-losses])。 网络 \(f\) 将每张图像编码为词元([sec:feature-extraction-and-tokenization]),通过交替注意力(Alternating-Attention)聚合跨视图特征([sec:global-attention]),再用轻量级预测头将词元映射为最终预测([sec:heads])。
特征提取与词元化
使用以 DINOv3 初始化的视觉 Transformer[simeoni25dinov3]对每张图像 \(I_i\) 进行词元化,得到 $$ \boldsymbol{z}_i^F = \operatorname{DINO}(I_i) \in \mathbb{R}^{H'W'\times C} $$ , 其中,块大小为 \(r\),\(H'=H/r\),\(W'=W/r\)。 对于每张图像 \(I_i\),还附加一个相机词元(Camera Token) \(\boldsymbol{z}^{\mathrm{cam}}_i\in\mathbb{R}^{1\times C}\) 和十六个寄存器(场景词元,Scene Token) \(\boldsymbol{z}^{\mathrm{scene}}_i\in\mathbb{R}^{16\times C}\)。 相机词元用于预测相机参数,寄存器则聚合场景信息。 与[wang25vggt]相同,这些词元可采用两组可学习参数之一:若图像 \(I_i\) 为参考图像则采用一组,否则采用另一组。 随后将其拼接成词元集合 $$ \boldsymbol{z} = (\boldsymbol{z}_1,\dots,\boldsymbol{z}_N) \in \mathbb{R}^{N \times (H'W'+17)\times C} $$ 其中,\(\boldsymbol{z}_i = (\boldsymbol{z}_i^F, \boldsymbol{z}^{\mathrm{cam}}_i, \boldsymbol{z}^{\mathrm{scene}}_i)\) 是图像 \(I_i\) 的词元。
寄存器注意力
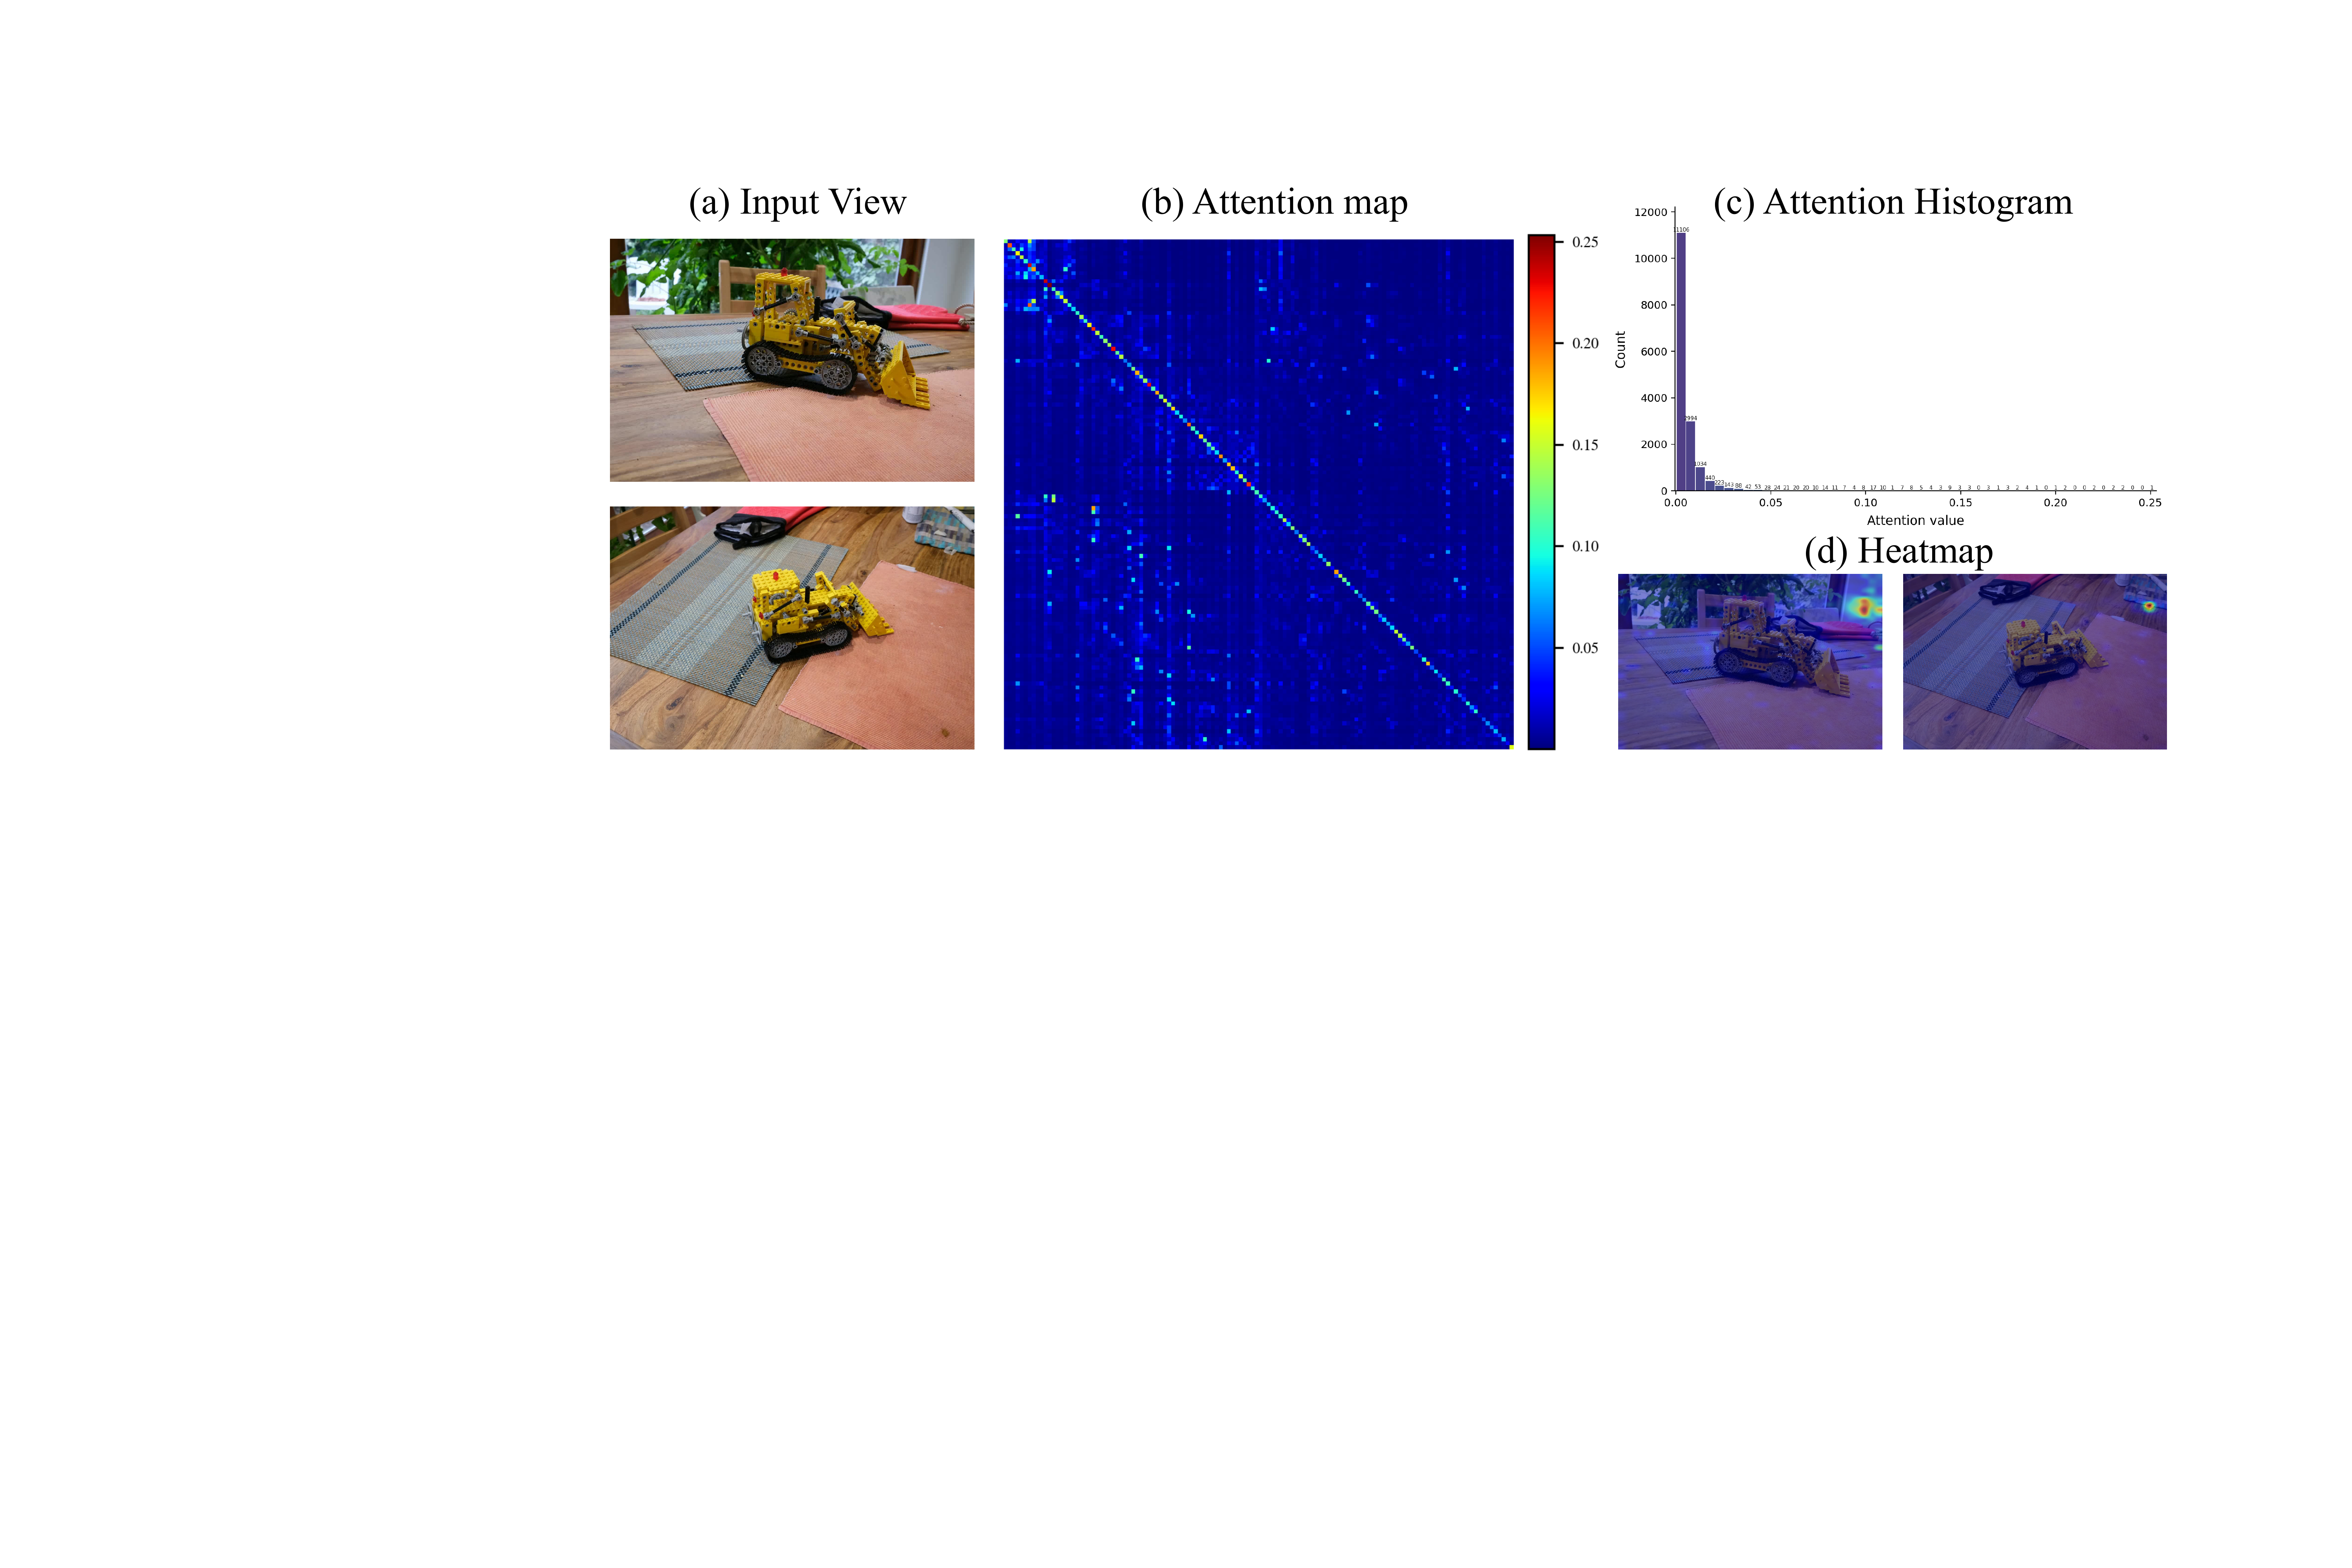
图:VGGT 全局注意力可视化。从 (b) 全局注意力矩阵、(c) 数值分布和 (d) 空间热力图可以看出,第 \(13\) 层的注意力十分稀疏。
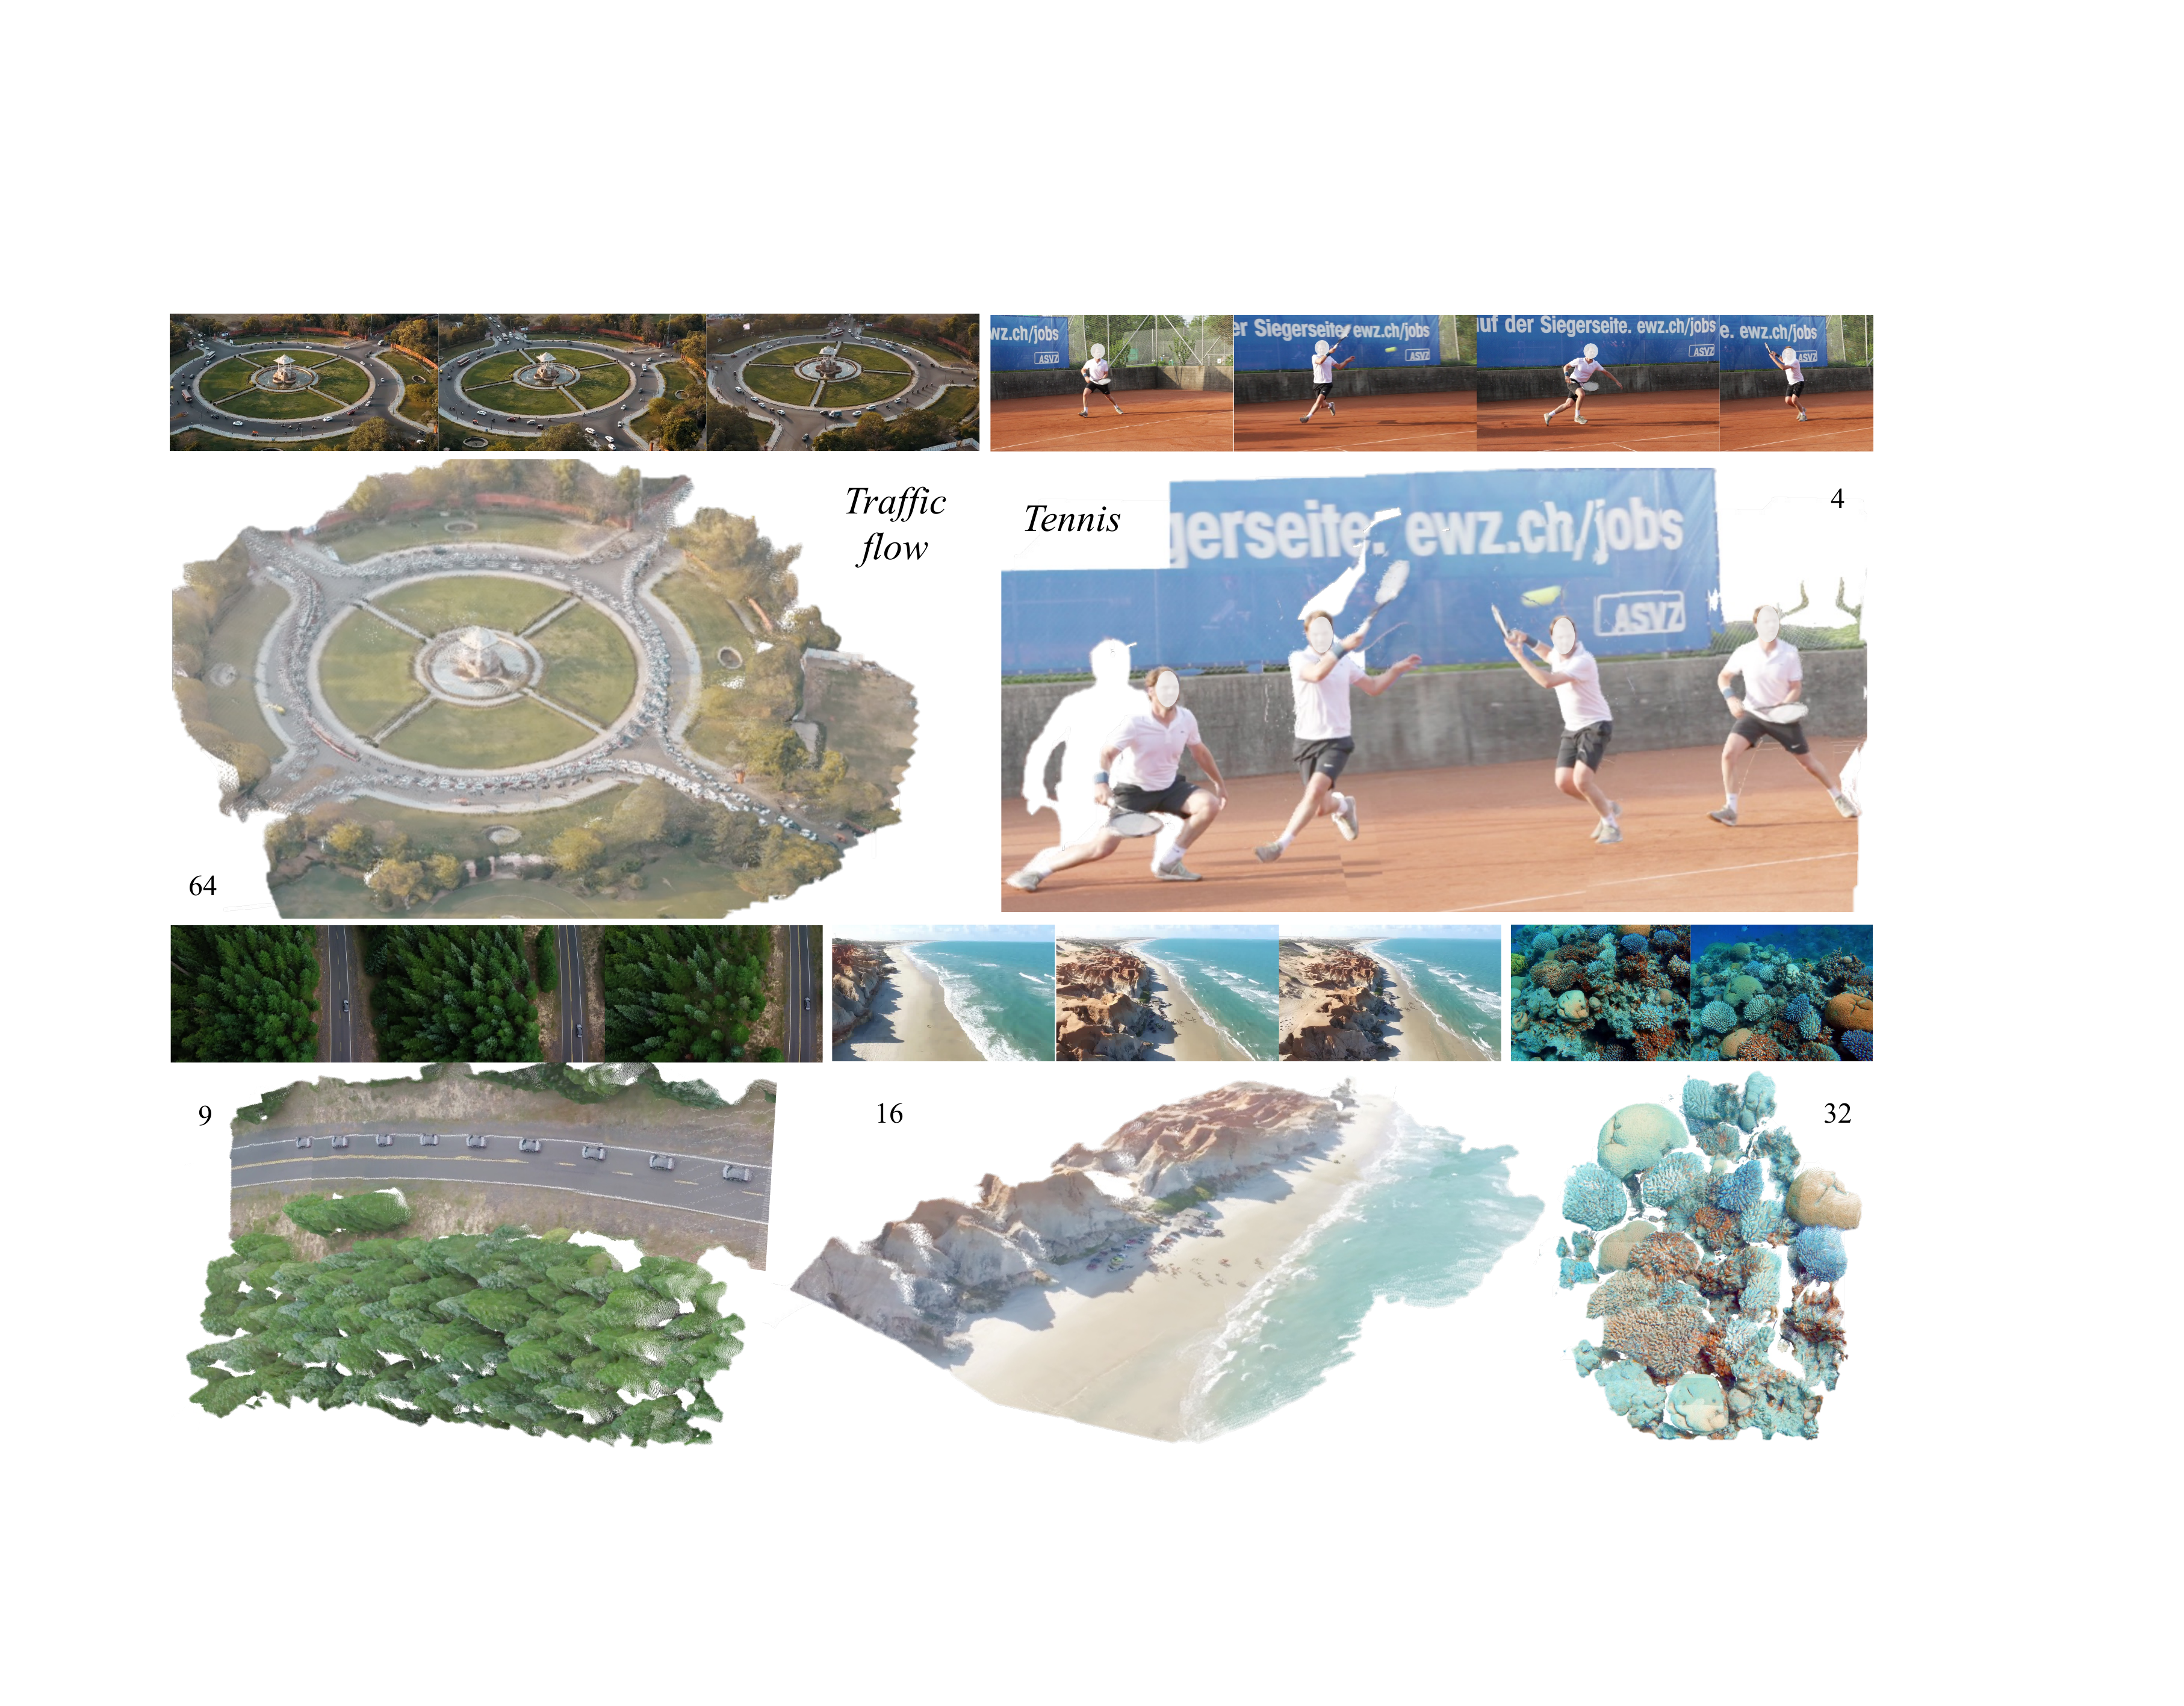
图:定性结果。 VGGT-Ω能够处理静态与动态内容,图中叠加的车流和网球运动员轨迹即为例证。 该方法还能泛化到困难场景,例如,水下珊瑚礁。 各示例分别使用 \(64\)、\(4\)、\(9\)、\(16\) 和 \(32\) 帧输入。
VGGT 采用交替注意力[wang25vggt],交替执行每张图像内部的帧内自注意力(Frame-Wise Self-Attention)与跨所有图像的全局自注意力(Global Self-Attention);两者在定义上均具有置换等变性。 帧内注意力无需帧索引嵌入,否则会限制模型泛化到不同输入帧数的能力。 因此,词元并未显式编码对应图像的身份(仅标明某帧是否为参考帧)。 全局注意力即对所有词元 \(\boldsymbol{z}\) 应用标准注意力层,记为 $$ \boldsymbol{z}' = \operatorname{attn}(\boldsymbol{z}) $$ . 帧内注意力与之类似,但会对每张图像 \(I_i\) 的 \(\boldsymbol{z}_i\) 独立应用, 记为 $$ \boldsymbol{z}' = \operatorname{attn}f(\boldsymbol{z}) = ( \operatorname{attn}(\boldsymbol{z}_1), \dots, \operatorname{attn}(\boldsymbol{z}_N) ) $$ . 不同帧通过全局注意力交互,并在此形成多帧场景信息。 但全局注意力需要关注所有帧的全部词元,计算成本随词元总数呈二次增长,因而开销很高。 如[fig:atten_visual]所示,全局注意力图通常较为稀疏,这表明少量词元或许足以交换相应信息。 这一观察与近期研究[shen26fastvggt:, wang25faster]一致。 因此,本文用寄存器注意力(Register Attention)替换 25% 的全局注意力层,并将自注意力限制在所有帧的寄存器之间。 形式上,寄存器注意力仅更新寄存器: $$ \boldsymbol{z}' = \operatorname{attn}\text{scene}(\boldsymbol{z}) $$ 其中, $$ ({\boldsymbol{z}^{\mathrm{scene}}_1}',\dots,{\boldsymbol{z}^{\mathrm{scene}}_N}') = \operatorname{attn}( \boldsymbol{z}^{\mathrm{scene}}_1,\dots,\boldsymbol{z}^{\mathrm{scene}}_N ) $$ , 即,换言之,在这些模块中,只有寄存器参与跨帧自注意力。 更新后的寄存器会在后续帧内注意力模块中与各帧的图像词元交互,将聚合的场景信息重新分配给图像词元。 这既促使最终寄存器承载全局场景信息,又降低了全局注意力的成本。
解码
注意力层输出的最终词元集合 \(\boldsymbol{z}' = (\boldsymbol{z}_1',\dots,\boldsymbol{z}_N')\) 被解码为深度图和相机参数。
深度。
在 VGGT 中,所有稠密解码器均由稠密预测 Transformer(Dense Prediction Transformer,DPT)层[ranftl21vision]实现。 然而,这些 DPT 预测头的末端卷积模块需要保留多个高分辨率特征图,内存开销很大。 为降低这一成本,本文将工作分辨率高于输入分辨率 \(1/4\) 的模块替换为轻量级上采样头:先通过一个多层感知机(MLP),再执行像素重排操作。 MLP 输出 \(2u^{2}\) 个通道(实现中 \(u=4\)),像素重排操作将其从 \((H' \times W', 2u^{2})\) 重排为 \((uH') \times (uW') \times 2\);两个输出通道分别对应深度和置信度。
本文还探索了完全无卷积的解码器,仅用 MLP 将词元映射为稠密预测。 该设计在基准测试中表现良好,但预测深度图在视觉上会出现块状伪影,尤其是在包含天空、山脉等远距离结构的室外场景中;此类区域的深度无界,因而定义并不明确。 因此,本文保留 DPT 前端计算成本较低的低分辨率卷积层。
相机。
先对相机词元和寄存器 \(\{(\boldsymbol{z}^{\mathrm{cam}}_i,\boldsymbol{z}^{\mathrm{scene}}_i)\}_{i=1}^N\) 应用轻量级 Transformer,再对每个更新后的相机词元应用 MLP,从而联合预测相机 \((\boldsymbol{g}_1,\dots,\boldsymbol{g}_N)\)。 与 VGGT 不同,本文的相机预测头只需单次前向传播即可预测相机参数,无需迭代细化。
训练损失
在 VGGT 中,预测冗余的稠密输出(例如,点图和轨迹)虽然有益,但训练成本很高。 VGGT-Ω改为仅包含一个用于深度预测的稠密预测头(Dense Prediction Head)。 尽管模型不直接预测点图与轨迹,本文仍然通过相应损失监督这些量。 实验发现,这种多任务监督(Multi-Task Supervision)与使用多个稠密预测头的性能几乎相同,同时可节省大量内存。 因此,优化以下损失:
$$
\mathcal{L} = \lambda_{\text{cam}} \mathcal{L}{\text{cam}} + \lambda{\text{depth}} \mathcal{L}{\text{depth}} + \lambda{\text{point}} \mathcal{L}{\text{point}} + \lambda{\text{match}} \mathcal{L}_{\text{match}}
$$ 其中,\(\lambda_{\text{cam}}\)、\(\lambda_{\text{depth}}\)、\(\lambda_{\text{point}}\) 和 \(\lambda_{\text{match}}\) 为权重。
相机损失。
相机损失 $$ \mathcal{L}\text{cam} = \sum{i=1}^N \left| \hat{\boldsymbol{g}}_i - \boldsymbol{g}_i \right| $$ 采用 \(\ell_1\) 目标比较预测相机 \(\hat{\boldsymbol{g}}_i\) 与真实相机 \(\boldsymbol{g}_i\);实验发现,该目标比 VGGT 使用的 Huber 损失更稳定。
深度损失。
遵循 VGGT,深度损失采用偶然不确定性(Aleatoric Uncertainty)和梯度一致性项。 此外,还考虑相对于真实值的相对尺度。 因此有: $$ \mathcal{L}{\text{depth}} = \sum{i=1}^{N} \left[ \left | c_i^{D} \odot \left( 1 + D_i^{-1} \right) \odot e_i \right | + \left | c_i^{D} \odot \nabla e_i \right | \right] - \alpha \sum_{i=1}^{N} \log c_i^{D} $$ ,其中 \(e_i = \hat{D}_i - D_i\),\(c_i^{D}\) 是预测的不确定性图,\(\odot\) 表示逐元素乘积。
点损失。
点图为每个像素分配相应三维点在参考相机坐标系中的坐标。 因此,可通过反投影从深度图和相机参数推导点图。 相应地,点损失 \(\mathcal{L}_{\text{point}}\) 与深度损失 \(\mathcal{L}_{\text{depth}}\) 相同,只需将残差替换为 $$ e_i = \pi^{-1}(\hat{D}_i, \hat{\boldsymbol{g}}_i) - P_i $$ , 其中,\(\pi^{-1}\) 表示反投影,\(P_i\) 为点图。
匹配损失。
匹配损失(Matching Loss)\(\mathcal{L}_{\text{match}}\) 作用于最后一个注意力层输出的词元。 该损失拉近正词元对(对应同一三维位置)的特征,并推远负词元对: $$ \mathcal{L}{\text{match}} = \mathbb{E}{\text{pos}}!\big[-\log \sigma(s)\big] + \mathbb{E}_{\text{neg}}!\big[-\log(1-\sigma(s))\big] $$ , 其中,\(s\) 是经 \(\ell_2\) 归一化后词元间的余弦相似度,\(\sigma\) 是 Sigmoid 函数,\(\mathbb{E}\) 表示分别对正、负样本对取平均,即加权二元交叉熵。 样本对的构建细节见补充材料。
动态重建
VGGT-Ω支持动态场景重建。除其他优势外,这使可用训练数据增加了数个数量级,因为大多数视频都包含运动。 动态重建(Dynamic Reconstruction)需要用统计先验约束运动。 经典的非刚性运动恢复结构[bregler00recovering, dai14a-simple, taylor10non-rigid]采用人工设计的低秩或局部刚性约束,但这类约束可能较为脆弱,泛化能力有限。 VGGT-Ω这类数据驱动模型有望从数据中学习更优的先验。 然而,输出表示决定了相机运动与场景运动的耦合方式。 例如,近期一些方法[wang24dust3r:]使用点图表示场景,并从中恢复相机参数。 这种方案在静态场景中效果良好,但在动态场景中,要么需要像 MonST3R[zhang24monst3r:]一样分割运动像素,要么需要引入动态点图[sucar25dynamic, sucar26v-dpm]等扩展。 另一种方案是预测深度图和射线图[lin25depth]。 然而,射线图会引入成本高昂的稠密输出,还可能使相机信息与逐像素外观变化相互纠缠。 例如,固定相机拍摄舞者时,画面中存在大幅运动,但相机参数保持不变。 因此,如上所述,本文只预测深度图和相机参数,避免运动掩码等显式动态输出。
自监督训练
受二维视觉中常见做法[he20momentum, caron21emerging, oquab24dinov2:, simeoni25dinov3]启发,本文采用教师--学生策略,利用无标注视频进行自监督学习(Self-Supervised Learning)。 具体而言,学生模型(Student)通过梯度下降更新,教师模型(Teacher)则仅通过学生模型参数的指数移动平均更新。 两个网络均以在有监督数据上训练的 VGGT-Ω检查点进行初始化。 给定一个视频序列,将同一组帧输入两个网络,但分别施加独立的随机增强,包括颜色抖动与模糊、随机 \(90^\circ\) 旋转、随机图像块掩蔽以及随机帧重排(会影响参考帧的选择)。 将两路数据恢复为相同顺序后,要求学生模型从两个方面与教师模型保持一致。 \(\ell_2\) 特征匹配损失在多个层上对齐学生模型与教师模型的词元。 回归损失则监督相机和深度。 为防止坍塌,自监督期间会冻结相机和深度预测头。 教师模型参数按 \(\theta^{\mathrm{T}} \leftarrow m\,\theta^{\mathrm{T}} + (1-m)\,\theta^{\mathrm{S}}\) 更新,而不采用梯度下降。 该蒸馏方案由此强制模型对外观变化和帧顺序保持不变性,使其能够从数百万段无标注视频中有效学习。
训练数据
表:静态与动态基准上的相机位姿估计。AUC 越高越好。前馈式模型(DA3、PI3、VGGT)在不同数据集上较为稳健,但在 Sintel 的严格阈值下仍落后于动态优化方法 MegaSaM(例如,AUC@\(3^\circ\) 为 \(16.2\) 对比 \(22.5\))。相比之下,动态优化方法(MegaSaM、MonST3R)在宽基线场景中性能下降(例如,ETH3D 上 AUC@\(30^\circ\) 为 \(38.1\) 对比 \(86.4\))。本文方法在所有场景中显著刷新了最先进结果,例如,将 Sintel 上的 AUC@\(3^\circ\) 从 \(22.5\) 提升至 \(40.0\),相对提升 \(77\%\)。
\begin{table*}[htbp]

\label{tab:camera}

\centering
\scriptsize
\setlength{\tabcolsep}{6pt}
\resizebox{\textwidth}{!}{
\begin{tabular}{c *{6}{cc}}
\toprule
\multirow{3}{*}{\textbf{方法}}
& \multicolumn{6}{c}{\textbf{静态场景}}
& \multicolumn{6}{c}{\textbf{动态场景}} \\
\cmidrule(lr){2-7}\cmidrule(lr){8-13}
& \multicolumn{2}{c}{\textbf{7 Scenes}} & \multicolumn{2}{c}{\textbf{NRGBD}} & \multicolumn{2}{c}{\textbf{ETH3D}} & \multicolumn{2}{c}{\textbf{DyCheck}} & \multicolumn{2}{c}{\textbf{Sintel}} & \multicolumn{2}{c}{\textbf{TUM\text{-}Dynamic}} \\
& 指标 AUC@3° & AUC@30° & AUC@3° & AUC@30° & AUC@3° & AUC@30° & AUC@3° & AUC@30° & AUC@3° & AUC@30° & AUC@3° & AUC@30° \\
\midrule
\phantom{中}{MonST3R}
& 9.0 & 68.3 & 13.9 & 79.7 & 1.7 & 14.3
& 11.5 & 45.4 & 4.3 & 45.8 & 7.7 & 48.5 \\
\phantom{中}MapAnything & 5.8 & 61.4 & 35.2 & 88.9 & 13.2 & 51.0 & 6.1 & 60.3 & 2.9 & 31.6 & 4.3 & 40.2 \\
\phantom{中}{MegaSaM}
& 10.6 & 71.8 & 17.2 & 83.1 & 5.9 & 38.1
& 26.8 & 53.1 & 22.5 & 58.3 & 15.4 & 59.0 \\
\phantom{中}{VGGT}
& 10.9 & 74.4 & 81.7 & 97.7 & 18.8 & 62.1
& 21.0 & 78.7 & 15.0 & 50.0 & 16.6 & 61.2 \\
\phantom{中}{PI3}
& 13.3 & 77.0 & 83.8 & 98.2 & 35.3 & 79.6
& 23.3 & 81.0 & 14.8 & 53.5 & 16.1 & 59.2 \\
\phantom{中}{DA3} & 18.7 & 78.2 & 86.4 & 98.4 & 46.1 & 87.0 & 32.1 & 83.9 & 16.2 & 52.7 & 20.8 & 62.7 \\
\midrule
{本文-1B} & \underline{29.6} & \underline{83.1} & \underline{89.7} & \underline{98.8} & \underline{49.8} & \underline{88.5} & \underline{38.4} & \underline{87.3} & \underline{35.3} & \underline{73.0} & \underline{30.2} & \underline{82.3} \\
{本文-10B} & \textbf{36.4} & \textbf{88.2} & \textbf{92.5} & \textbf{99.1} & \textbf{56.3} & \textbf{90.4} & \textbf{43.7} & \textbf{90.9} & \textbf{40.0} & \textbf{79.1} & \textbf{36.4} & \textbf{87.5} \\
\bottomrule
\end{tabular}
}
\vspace{-1em}
\end{table*}
表:静态与动态基准上的深度估计。指标 \(\delta_{1.25}\) 表示预测深度落在真实值指定倍率范围内的比例(越高越好),AbsRel 为平均绝对相对误差(越低越好)。
\begin{table*}[htbp]

\label{tab:depth}

\centering
\tiny
\setlength{\tabcolsep}{6pt}
\resizebox{\textwidth}{!}{
\begin{tabular}{c *{6}{cc}}
\toprule
\multirow{3}{*}{\textbf{方法}}
& \multicolumn{6}{c}{\textbf{静态场景}}
& \multicolumn{6}{c}{\textbf{动态场景}} \\
\cmidrule(lr){2-7}\cmidrule(lr){8-13}
& \multicolumn{2}{c}{\textbf{7 Scenes}}
& \multicolumn{2}{c}{\textbf{NRGBD}}
& \multicolumn{2}{c}{\textbf{ETH3D}}
& \multicolumn{2}{c}{\textbf{DyCheck}}
& \multicolumn{2}{c}{\textbf{Sintel}}
& \multicolumn{2}{c}{\textbf{TUM\text{-}Dynamic}} \\
& \(\delta_{1.25}\) & {AbsRel}
& \(\delta_{1.25}\) & {AbsRel}
& \(\delta_{1.25}\) & {AbsRel}
& \(\delta_{1.25}\) & {AbsRel}
& \(\delta_{1.25}\) & {AbsRel}
& \(\delta_{1.25}\) & {AbsRel} \\
\midrule
\phantom{中}{MonST3R} & 92.4 & 0.075 & 98.4 & 0.030 & 95.8 & 0.056 & 93.3 & 0.068 & 71.9 & 0.263 & 85.0 & 0.148 \\
\phantom{中}MapAnything & 92.9 & 0.070 & 98.7 & 0.022 & 96.3 & 0.035 & 97.0 & 0.049 & 72.5 & 0.251 & 93.1 & 0.052 \\
\phantom{中}{MegaSaM} & 93.8 & 0.065 & 96.2 & 0.057 & 94.8 & 0.083 & 97.4 & 0.042 & 74.1 & 0.207 & 92.9 & 0.083 \\
\phantom{中}{VGGT}    & 91.9 & 0.073 & 99.1 & 0.019 & 97.4 & 0.036 & 95.2 & 0.055 & 79.2 & 0.189 & 92.2 & 0.064 \\
\phantom{中}{PI3}     & 92.8 & 0.068 & 99.2 & 0.011 & {99.6} & 0.016 & 97.4 & 0.041 & 82.5 & 0.144 & 95.5 & 0.046 \\
\phantom{中}{DA3} & 93.0 & 0.063 & 99.5 & 0.010 & 99.6 & 0.015 & 97.7 & 0.039 & 86.1 & 0.118 & 94.3 & 0.049 \\
\midrule
{本文-1B} & \underline{94.6} & \underline{0.058} & \underline{99.6} & \underline{0.010} & \underline{99.8} & \underline{0.012} & \underline{98.4} & \underline{0.038} & \underline{89.5} & \underline{0.097} & \underline{97.4} & \underline{0.041} \\
{本文-10B} & \textbf{96.3} & \textbf{0.050} & \textbf{99.7} & \textbf{0.007} & \textbf{99.8} & \textbf{0.009} & \textbf{98.7} & \textbf{0.030} & \textbf{93.5} & \textbf{0.081} & \textbf{98.3} & \textbf{0.035} \\
\bottomrule
\end{tabular}
}
\vspace{-10pt}
\end{table*}
VGGT-Ω的一项关键工作是扩展训练数据。为此,我们将大量公开数据集([sec:data-sources])与新开发的标注流程([sec:annotation-pipeline])相结合;该流程能够处理现成视频中的动态内容。
数据来源
我们首先收集了以下公开数据集: Aria series[pan23aria], Bedlam[black23bedlam:], BEHAVIOR-1K[li24behavior-1k:], Co3Dv2[reizenstein21common], uCo3D[liu25uco3d], DL3DV[ling23dl3dv-10k:], Dynamic Replica[karaev23dynamicstereo], EDEN[le21eden:], EFM3D[straub24efm3d:], HOT3D[banerjee24introducing], Habitat[habitat19iccv], Hypersim[roberts21hypersim:], Mapfree[arnold22map-free], Mapillary Metropolis[mapillary25metropolis], MPSD[antequera20mapillary], Megadepth[li18megadepth:], Megasynth[jiang25megasynth:], Mid-Air[fonder19mid-air:], Mvssynth[huang18deepmvs:], ParallelDomain-4D[hoorick24generative], Replica[straub19the-replica], SAIL-VOS[hu21sail-vos], ScanNet Series[dai17scannet:, yeshwanth23scannet:], TartanAirV2[wang20tartanair:], TartanGround[patel25tartanground:], Taskonomy[zamir18taskonomy:], UnrealStereo4K[tosi21smd-nets:], Virtual KITTI[cabon20virtual], Waymo[sun20scalability],以及 WildRGBD[xia24rgbd]. 我们排除了 VGGT 使用的 Kubric[greff22kubric:] 和 PointOdyssey[zheng23pointodyssey:],因为其背景几何是伪造的,会产生无效深度。 此外,我们还使用若干内部数据集,包括艺术家制作的物体资产、刚性和动态合成环境、真实设备采集数据及相关来源。 对于非合成数据集(例如,由 SfM 流程标注的数据),我们通过多视图一致性检查移除含噪深度值,并丢弃有效深度像素过少的序列。 这些数据集总计约含 \(3\)M 个序列,每个序列包含 \(10\) 至 \(20{,}000\) 张图像。
数据标注流程
为进一步扩展训练数据,我们构建了一个大型内部视频集合,包含约 \(40\)M 个互联网风格视频。 首先评估每个视频是否适合重建,例如,滤除带有大面积水印或突兀镜头切换的片段。 通过检查的视频用于[sec:self-supervised-training]所述的自监督训练。 随后,我们提出新流程,为静态和动态场景视频标注相机参数与深度图。 标注质量优先于数量,因此会严格拒绝低质量数据,并丢弃可能属于动态区域的深度标注。 这可能排除极端相机运动或高度动态场景,但合成数据集仍充分覆盖了这些情况。 最终得到约 \(200\)K 个动态场景和 \(600\)K 个静态场景,均具有高质量相机与深度标注。
VLM 预筛选。
我们提示视觉语言模型(Vision-Language Model,VLM)丢弃难以用多视图几何重建的视频。 VLM 将 \(50\%\) 的片段判定为重建难度过高,例如,包含多个镜头、极端运动模糊或大面积叠加层与水印。 另有 \(40\%\) 被判定为可重建,但可能因视差不足、缺少非重复纹理等原因而精度较低。 其余 \(10\%\) 的视频进入下一阶段。 在同一次处理中,VLM 还提取场景是否动态等元数据,供后续阶段使用。
动态掩码提取。
我们使用 Grounding DINO[liu24grounding] 检测人、汽车等潜在可移动物体类别的边界框,并在匹配、跟踪与验证时排除这些区域。
特征匹配与跟踪。
我们组合以下方法提取跨帧匹配与轨迹: SIFT[lowe99object], SuperPoint & SuperGlue[daniel18superpoint:, sarlin20superglue:], ALIKED & LightGlue[zhao23aliked:, lindenberger23lightglue:],以及 VGGSfM Tracker[wang24vggsfm:]. 动态区域内的匹配会被丢弃。
重建与筛选。
当基于 RANSAC 的本质矩阵估计得到的内点过少时,我们用原始 VGGT 初始化相机参数,再依据上述对应关系运行 COLMAP[schonberger16structure-from-motion],迭代执行束调整与筛选。 对于成功重建的序列,我们丢弃未通过启发式检查的样本,例如,图像注册率 \(<99.5\%\)、视场角不在 \([30^\circ,120^\circ]\) 内,或畸变率 \(>0.1\)。 这些标准会严格移除退化运动或极端变焦情况。 随后使用基于图块的多视图立体方法[schonberger16pixelwise]估计逐帧稠密深度图。
多视图一致性。
对于每一帧,我们将深度图反投影到三维空间,再把点重投影至其他视图,并与对应深度比较。 通过跨视图一致性检查的像素被标记为有效。 我们丢弃有效深度像素少于 \(5\%\) 的序列;这通常(但不总是)意味着相机质量较低。
有监督几何筛选。
最终,每个序列都获得相机、深度和有效掩码。 我们用相机上方向向量一致性、视差角和轨迹平滑度等人工设计特征描述各序列。 通过分别人工标注 500 个静态序列和 500 个动态序列,训练分类器以移除低质量重建。 该分类器集成了 XGBoost[chen16xgboost:]、随机森林[breiman01random]和 CatBoost[prokhorenkova18catboost:]。
实验
本节进一步介绍框架细节,将其与当前最先进的刚性和动态重建方法进行基准比较,并对关键设计选择开展消融实验。
实现细节
我们重点研究四种模型变体:参数量分别为 \(200\)M、\(500\)M、\(1\)B 和 \(10\)B,对应 \(12/12/24/16\) 个交替注意力块,隐藏层维度分别为 \(384/768/1024/4096\)。 视觉 Transformer 由 DINOv3[simeoni25dinov3] 初始化,训练期间不冻结。 每个块包含一个全局注意力(或寄存器注意力)层和一个帧内注意力层。 使用 AdamW 优化 \(240\)K 次迭代,其中监督训练、自监督训练和最后一个监督训练阶段分别占 \(160\)K、\(50\)K 和 \(30\)K 次迭代。 学习率在训练前 \(5\%\) 进行线性预热,随后 \(95\%\) 采用余弦衰减;监督训练和自监督训练的峰值学习率分别为 \(2\times10^{-4}\) 和 \(1\times10^{-4}\)。 每个批次的帧数从 \([1,24]\) 中均匀采样。 图像增强包括:在 \([0.33,1.33]\) 范围内随机改变宽高比,同时将图像面积保持在约 \(512 \times 512\) 像素,并应用颜色抖动、灰度转换和随机图块掩码。 训练使用 \(128\) 块 \(96\)GB H100 GPU,并采用 bfloat16 混合精度、梯度检查点和 FSDP。
基准评测
图:与 MegaSaM 的定性比较。 MegaSaM 经常出现几何不一致。 相比之下,我们的方法在稀疏、动态和航拍场景中均能生成全局一致的重建结果。 左列的航拍场景尤其明显:MegaSaM 出现严重的几何漂移和纹理拖影,导致重复图案和扭曲的全局布局。 请注意,右上示例中的第二帧并非正立,使该案例尤其困难。
定量比较。
我们将 VGGT-Ω与近期方法进行比较,包括: (i) 前馈式重建模型;(ii) 基于优化的动态重建方法。 评估使用三个静态数据集(7 Scenes[shotton13scene]、NRGBD[azinovic22neural] 和 ETH3D[schops17a-multi-view])以及三个动态数据集(DyCheck[gao22monocular]、Sintel[butler12a-naturalistic] 和 TUM-Dynamic[sturm12a-benchmark])。 对于每个场景或序列,随机采样 \(10\) 帧。 所有方法均使用其原始发布模型。 对于 DA3,我们使用其最大的 Giant 变体(1B 参数)。
遵循[wang25vggt],我们报告相机位姿估计的标准 AUC(越高越好),其计算方式为:相对旋转和平移误差低于给定角度阈值(例如,\(3^\circ\)、\(30^\circ\))的图像对比例曲线下的面积。 如 [tab:camera] 所示,前馈式模型在静态基准和较宽松阈值下通常表现较强;基于优化且具备动态感知能力的 MegaSaM 在 Sintel 等困难动态序列上更具竞争力,但在宽基线或低纹理场景中性能下降。 相比之下,我们的模型在静态和动态数据集以及严格和宽松阈值下均持续优于所有基线。
我们还使用绝对相对误差(Absolute Relative Error, AbsRel;越低越好)和 \(\delta_{1.25}\)(越高越好)评估预测深度的精度;后者衡量预测深度与真实深度之比处于指定阈值内的像素占比。 如 [tab:depth] 所示,我们的模型在静态基准上优于基线,并在 ETH3D 等现有方法已表现较强的数据集上进一步降低 AbsRel;在动态场景中的提升更为明显,深度误差更低且 \(\delta_{1.25}\) 更高(例如,在 Sintel 上,\(\delta_{1.25}\) 从 \(86.1\) 提升至 \(93.5\),AbsRel 从 \(0.118\) 降至 \(0.081\))。
规模更大的 10B 变体始终优于 1B 模型,表明扩大重建模型规模能够直接提高相机和深度精度。
定性结果。
[fig:qual] 展示了模型在静态和动态场景中的结果,包括交通、人类运动、自然景观和水下环境。
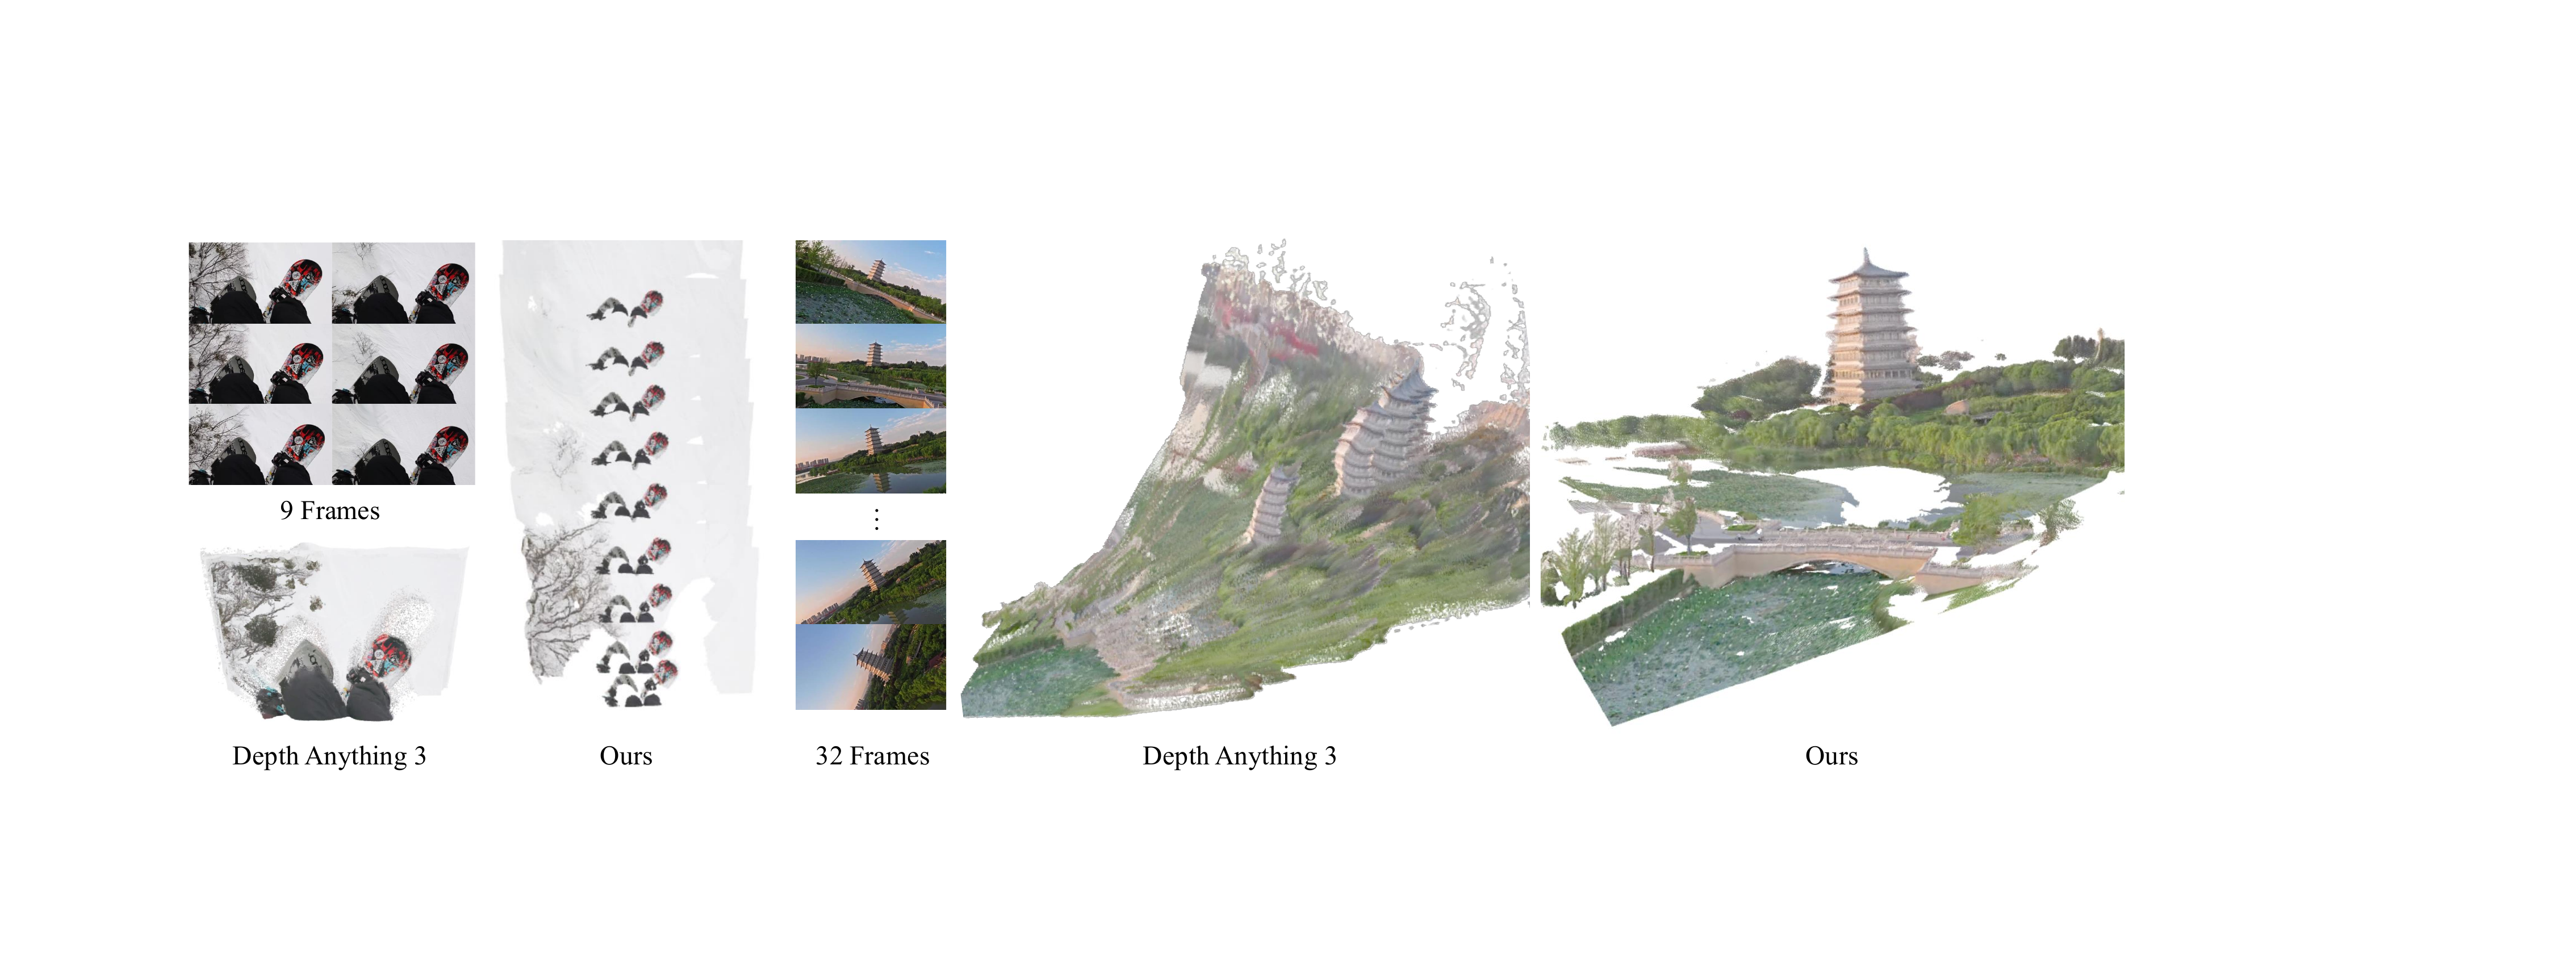
图:与 Depth Anything 3 的定性比较。 左:雪地上方的缆车序列,其中重复地形误导 DA3,使其估计出的相机运动很小甚至为零。 我们的方法恢复了正确的相机轨迹。 右:无人机朝塔飞行时相机发生滚转的序列。 在这种强烈视角变化下,DA3 产生严重的重影和重复塔体结构,而我们的重建结果仍保持全局一致。
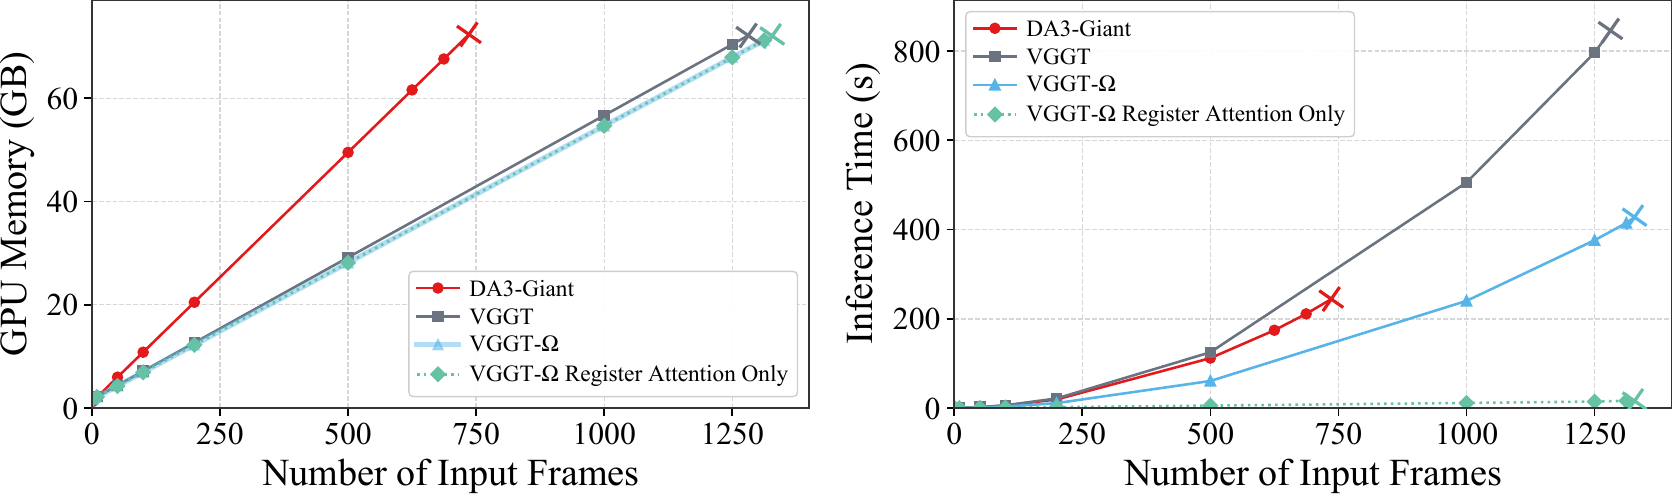
图:内存与速度比较。 我们在启用 flash attention v2 的 80GB A100 GPU 上比较 VGGT、DA3 和 VGGT-Ω的推理内存占用与运行时间。 对于 VGGT,我们首先修正了一个可提升其效率的实现细节(见正文)。 叉号表示各方法首次出现内存不足的设置。
我们还在 [fig:qual_da3,fig:qual_supp] 的困难案例上将 VGGT-Ω与 DA3 和 MegaSaM 进行比较。 在 [fig:qual_da3] 中,DA3 难以处理重复纹理,在雪地缆车序列中估计出的相机运动很小甚至为零;面对强烈的相机滚转时,其在无人机序列中多次重建出同一座塔。 MegaSaM 在具有显著相机滚转的稀疏室内场景(右上)或无纹理墙面(右下)中也可能失效,产生断裂结构或错位平面;某些航拍序列(左侧)同样对其位姿估计构成挑战。 相比之下,VGGT-Ω的重建结果具有全局一致性,这可能得益于从多样化数据中学到的强几何先验。
推理内存与速度。
下面将 VGGT-Ω与 VGGT 和 DA3 的推理内存与速度进行比较(请注意,这与 [sec:architecture] 讨论的训练效率有很大不同)。
进行比较前,我们先修正原始 VGGT 实现。 该模型在推理期间会缓存全部 \(24\) 层的中间张量。 这些缓存张量虽在训练期间有用,但测试时预测头只需四层的中间特征。 因此,我们不再缓存不必要的信息,从而显著降低推理内存占用。
完成修正后,我们在 [fig:mem_speed] 中比较 VGGT、DA3 和 VGGT-Ω。 为保证公平,所有测量均在单块 80GB A100 GPU 上进行,使用 PyTorch scaled_dot_product_attention 和 flash attention v2 后端。 根据各模型的图块尺寸,采用相近的输入分辨率:VGGT 和 DA3 使用 \(518 \times 336\) 的分辨率和 \(14\) 像素的图块,VGGT-Ω 使用 \(512 \times 336\) 的分辨率和 \(16\) 像素的图块。 我们逐步增加输入帧数,直至各方法耗尽内存;[fig:mem_speed] 中的叉号标出了首次内存不足的设置。
在内存效率方面,修正后的 VGGT 与 VGGT-Ω相近,均可在单块 A100 GPU 上处理超过 \(1,\!000\) 帧。 在速度方面,VGGT-Ω更快,主要原因是其采用图块尺寸为 \(16\) 的 DINOv3,而非图块尺寸为 \(14\) 的 DINOv2,使图像词元数量减少约 \(25\%\)。 此外,VGGT-Ω默认以寄存器注意力替换 \(25\%\) 的全局注意力层,从而减少 FLOPs 并获得 \(20\)--\(25\%\) 的加速。 总体而言,VGGT 和 VGGT-Ω在内存与运行时间方面的规模扩展特性均优于 DA3;例如,在我们的测试中,DA3 在约 \(750\) 帧时耗尽内存,而 VGGT 和 VGGT-Ω可处理约 \(1250\) 帧。 一种更激进的 VGGT-Ω变体将所有全局注意力层替换为寄存器注意力,可进一步提速,使 \(1000\) 帧的运行时间从 \(240.2\) 秒降至 \(11.7\) 秒,但会牺牲重建精度([sec:discussion])。
虽然这一现象可能出人意料,但需要强调的是,推理时移除全局注意力的主要收益是速度,而非内存。 如 [fig:mem_speed] 所示,将所有全局注意力层替换为寄存器注意力可大幅提速,但推理峰值内存几乎不变。 这是因为与全局注意力不同,寄存器注意力无需计算所有图像词元对之间的交互。 不过,当 PyTorch scaled_dot_product_attention 使用 flash attention v2 时,完整注意力矩阵并不会在内存中显式实例化。 相反,其内核以分块流式方式计算注意力,在线更新 softmax 归一化并直接累积输出。 峰值内存主要由尺寸与帧数和图像词元数量成正比的张量占用,例如帧内注意力激活或前馈网络中间结果。 这解释了 [fig:mem_speed] 中内存为何随帧数近似线性增长。
消融实验
除非另有说明,消融实验均采用 1B 模型变体:在 \(2\)M 个序列上使用 \(64\) 块 GPU 进行 \(150\)k 步监督训练。 为联合评估相机和深度精度,我们利用相机将深度图反投影至三维空间,并计算预测点与真实点之间的 \(\ell_2\) 距离,将其称为点误差(Point Error)。 之所以使用点误差而非 Chamfer 距离,是因为无序点集上的最近邻匹配容易被墙面和地板等大面积表面主导。 所有模型的训练词元数量大致相同。
模型与数据规模。
如 [fig:scale] 所示,扩大模型规模或数据规模均能持续改善性能。 训练序列数量以 \(10\times\) 的幅度增加时,点误差从 \(0.275\) 单调降至 \(0.073\)。 总体而言,两条曲线的形状表明,幂律可能刻画此类模型的规模扩展规律。
寄存器注意力。
仅使用全局注意力层的变体达到 \(0.071\) 的点误差。 以寄存器注意力替换 25% 的全局注意力层后,性能与原模型几乎相同(\(0.073\))。
多任务学习。
移除点损失和匹配损失后,点误差从 \(0.073\) 增至 \(0.078\)。 作为参考,采用 VGGT 原始的多头多任务设置可达到 \(0.070\),但需要多个稠密预测头,难以进行规模扩展。
自监督训练。
将 \(10\%\) 的监督训练步骤替换为自监督训练后,点误差从 \(0.073\) 略降至 \(0.070\)。 性能提升源于使用更加多样的无标签数据进行训练。 我们还观察到分布外泛化能力有所提升。
标注质量。
为验证标注流程生成的伪真值质量,我们在提供合成相机与深度真值的 Sintel 上将其与 MegaSaM[li25megasam:] 进行比较。 为保证公平,只评估同时满足我们的筛选标准并通过 MegaSaM 验证的序列和像素,排除 \(8/23\) 个序列及所有动态区域。 在该协议下,我们的流程在相机位姿上达到 \(96.4\%\) AUC@\(30^\circ\),在深度上达到 \(99.3\%\) \(\delta_{1.25}\);MegaSaM 的对应结果分别为 \(62.1\%\) 和 \(77.2\%\),验证了所得标注的高质量。 生成伪标签的目标并非最大化产出量,而是仅保留极可能正确的序列和像素,因为实践表明,规模较小但精度较高的伪真值集合比规模更大但噪声更多的集合更有益。 因此,标注流程有意采用保守策略:只要序列存在轻微歧义,或像素无法得到可靠验证,我们就将其丢弃,以免引入噪声监督。
寄存器的应用
机器人。 近期工作探索了利用重建模型提升视觉-语言-动作(VLA)系统空间理解能力的方法[li25spatial, abouzeid25geoaware-vla:]。 我们评估 VGGT-Ω能否作为 VLA 的即插即用几何编码器。 给定输入图像后,从 VGGT-Ω提取寄存器(场景词元),并将其与 OpenVLA-OFT 的原始输入词元拼接[kim25fine-tuning]。 随后按照标准协议训练 OpenVLA-OFT,同时始终冻结 VGGT-Ω。 如 [tab:vla] 所示,具备几何感知能力的寄存器在所有 LIBERO 任务上均持续提升性能[liu23libero:]。
表:LIBERO 基准上的性能。 我们冻结预训练模型,将场景词元作为额外输入馈送至 OpenVLA-OFT,并报告成功率(Success Rate, SR;越高越好)。 显著的性能提升验证了场景词元聚合空间信息的有效性。
\begin{table}[htbp]
\centering

\label{tab:vla}
\scriptsize
\renewcommand{\tabcolsep}{4pt}
\begin{tabular}{cccccc}
\toprule
\multicolumn{1}{c}{方法}
& \begin{tabular}[c]{@{}c@{}}空间\\ SR (\%)\end{tabular}
& \begin{tabular}[c]{@{}c@{}}物体\\ SR (\%)\end{tabular}
& \begin{tabular}[c]{@{}c@{}}目标\\ SR (\%)\end{tabular}
& \begin{tabular}[c]{@{}c@{}}长程\\ SR (\%)\end{tabular}
& \begin{tabular}[c]{@{}c@{}}平均\\ SR (\%)\end{tabular}
\\ \midrule
Diffusion Policy & 78.3 & 92.5 & 68.3 & 50.5 & 72.4 \\
TraceVLA         & 84.6 & 85.2 & 75.1 & 54.1 & 74.8 \\
Octo             & 78.9 & 85.7 & 84.6 & 51.1 & 75.1 \\
OpenVLA          & 84.7 & 88.4 & 79.2 & 53.7 & 76.5 \\
Dita             & 84.2 & 96.3 & 85.4 & 63.8 & 82.4 \\
CoT-VLA          & 87.5 & 91.6 & 87.6 & 69.0 & 83.9 \\
$\pi_0$-FAST     & 96.4 & 96.8 & 88.6 & 60.2 & 85.5 \\
$\pi_0$          & 96.8 & 98.8 & 95.8 & 85.2 & 94.2 \\
UniVLA           & 96.5 & 96.8 & 95.6 & 92.0 & 95.2 \\
OpenVLA-OFT      & 97.6 & 98.4 & 97.9 & 94.5 & 97.1 \\
\midrule
\begin{tabular}[c]{@{}c@{}}OpenVLA-OFT\\ + Our Frozen Scene Tokens\end{tabular} & \textbf{99.3} & \textbf{99.2} & \textbf{99.0} & \textbf{96.7} & \textbf{98.5} \\
\bottomrule
\end{tabular}
\end{table}
语言对齐。
为进一步验证寄存器是否包含高层信息,我们研究其能否与自然语言对齐。 该过程如 [fig:text_alignment] 所示,遵循 CLIP 式对比对齐的思想[radford21learning, zhai23sigmoid]。 为尽可能保持简单,我们使用训练充分的 VGGT-Ω,冻结语言编码器,仅微调本模型。
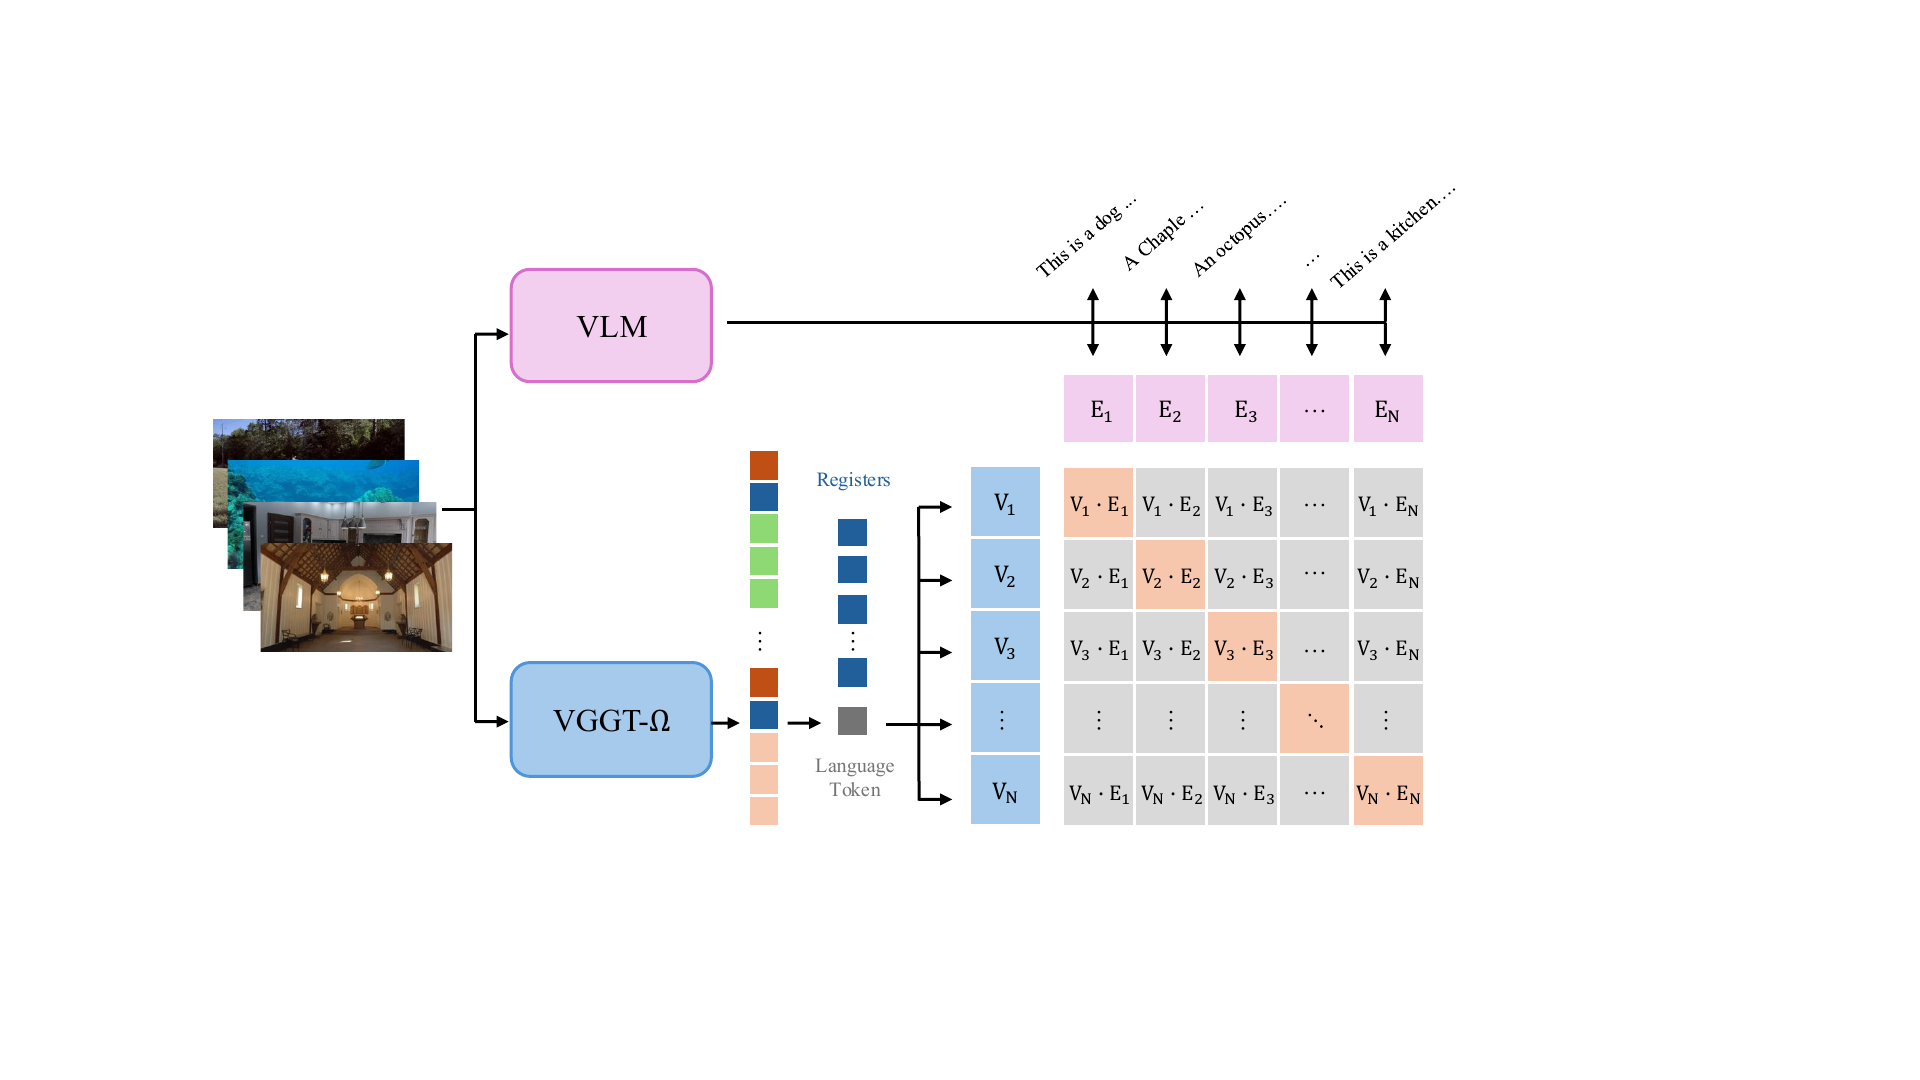
图:语言对齐。 我们通过语言对齐验证寄存器是否包含高层信息。 对于每个序列,VLM 描述场景内容、粗略布局和外观,并对生成的文本词元进行均值池化,形成语言嵌入。 在 VGGT-Ω一侧,一个小型自注意力堆栈以寄存器和可学习语言词元作为输入,再对输出语言词元进行投影,形成寄存器衍生嵌入。 在全局批次的所有序列—描述配对上,使用对称 InfoNCE 损失优化这两个嵌入。
具体而言,我们分别使用视觉语言模型(Vision-Language Model, VLM)和 VGGT-Ω为给定图像序列提取全局描述符,随后将二者对齐。 提取该全局描述符时,VLM 观察所有输入视角,并根据提示将场景内容、粗略布局和外观描述为一个连贯的整体场景。 随后,对 VLM 生成的文本词元隐藏状态进行均值池化和 \(\ell_2\) 归一化。 为从 VGGT-Ω获得全局描述符,一个小型自注意力堆栈以寄存器和一个随机初始化的新可学习语言词元作为输入。 对输出语言词元进行投影和 \(\ell_2\) 归一化,得到 VGGT-Ω中源自寄存器的嵌入。
需要注意的是,引入的语言词元只能读取寄存器,从不直接观察图像图块词元。 因此,成功对齐说明寄存器本身携带可与语言匹配的场景级信息。
我们使用对称 InfoNCE 损失,最大化匹配的寄存器衍生嵌入与 VLM 语言嵌入之间的余弦相似度,同时最小化不匹配样本对的相似度。 模型在与主要重建训练相同的图像序列上进行微调。 与分布式 CLIP 训练相同,嵌入会跨 GPU 聚合,使全局批次提供批内负样本。 VLM 保持冻结;与机器人实验中固定 VGGT-Ω 不同,此处以 \(1\times10^{-5}\) 的恒定学习率端到端微调 VGGT-Ω。
仅以较小学习率迭代 10K 次后,模型便能很好地迁移至语言检索任务。 评估时,我们构建了由 100 个手工筛选网络视频组成的基准,涵盖烹饪、祈祷和赛车等多种场景。
给定完成对齐的 VGGT-Ω所产生的寄存器衍生嵌入,我们使用余弦相似度为每个候选视频检索配对的语言嵌入,并报告 top-\(K\) 准确率。 使用对齐期间采用的 VLM 嵌入时,模型的 top-1 准确率达到 \(76.8\%\),top-3 准确率达到 \(97.0\%\)。 换言之,几乎所有视频的正确语言描述都位列前三名候选结果。 为检验这种对齐能否迁移到特定训练目标之外,我们在不进行任何额外训练的情况下,将 VLM 嵌入替换为纯文本 LLM 嵌入。 具体而言,提示 VLM 生成视频描述,并仅将该描述输入 Qwen3 LLM[yang25qwen3]。 在这种零样本迁移设置下,模型仍取得 \(47.5\%\) 的 top-1 准确率和 \(77.8\%\) 的 top-3 准确率。
总体而言,这些结果表明寄存器携带高层信息,可能具有很强的语义性,并且能够与语言空间对齐。 与此同时,对齐微调后几何任务性能并未下降。 补充材料提供了文本描述示例和提示词。 这可能说明,强几何模型学到的表示能够自然地与语言等其他模态的表示对齐。 这一观察与柏拉图表示假说(Platonic Representation Hypothesis)[huh24position:, han25learning] 一致:在不同模态上训练且能力足够强的模型,往往会趋向共享表示空间。
一般应用。
寄存器为从模型中提取序列级和帧级表示提供了一种通用机制。 通过引入面向特定任务的可学习词元,该设计可自然扩展到其他预测任务。 对于序列级预测,可将可学习词元与寄存器词元拼接,并将其解码为所需输出,类似于上文讨论的语言词元。 对于帧级预测,可在各帧复制同一词元,将其与相应寄存器拼接,并用于生成逐帧估计。 我们已在若干此类任务上开展初步实验,包括度量尺度估计、重力方向估计和人员存在检测,并观察到较有潜力的结果。 这些可能性留待社区进一步探索。 从这一角度看,相机词元也可视为类似寄存器的可学习词元,主要区别在于它接受直接的相机监督。
进一步观察
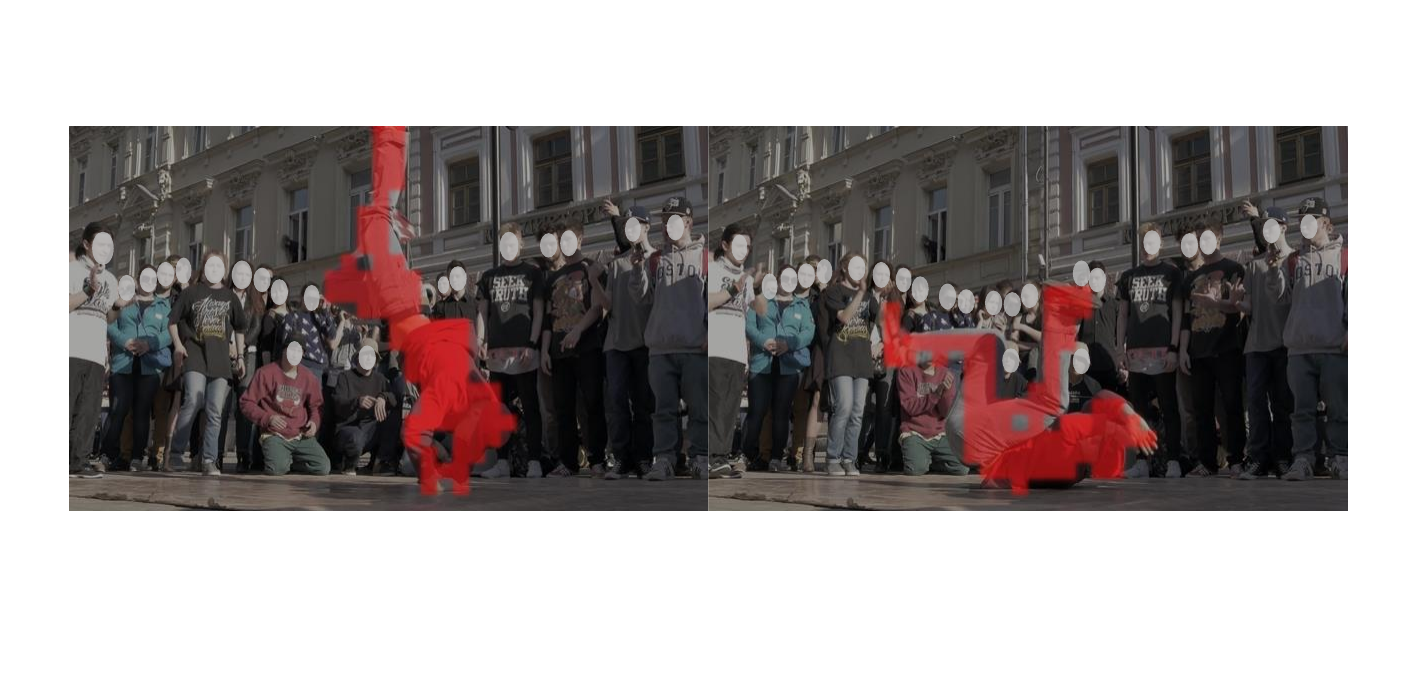
图:运动感知表征。 我们用 \(k\)-means 对经 PCA 降维的中间图像词元进行聚类,结果始终能将移动的舞者与静态人群和背景分开,红色表示高响应区域。 这表明VGGT-Ω无需显式运动监督,即可从重建训练中学得运动感知表征。
在开发VGGT-Ω的过程中,我们得到若干尚未严格验证的经验观察;这些发现仍值得与有意开发类似模型的研究者分享。
模型融合:信息存储在哪里?
为更好理解模型行为,我们将模型融合(Model Souping)[wortsman22model]用作探针。 具体而言,无需进一步训练,直接对特定权重子集取平均,将公开 VGGT 检查点融合进VGGT-Ω。 尽管两者架构不同(例如 VGGT 使用图块大小为 14 的 DINOv2,而 VGGT-Ω 使用图块大小为 16 的 DINOv3 和寄存器注意力),平均后的模型仍能产生视觉上合理的重建,这一点颇为意外。
融合不同权重子集,可以揭示不同类型信息在模型中的存储位置。 首先,深度和视场角信息主要存储在注意力块的前馈网络(FFN)中,尤其是帧内注意力块,其次是全局注意力块。 这与语言模型领域的观察一致[geva21transformer, dai22knowledge, meng22locating]。 例如,[sec:data_quality]指出,模型会记忆训练数据中特殊的含噪信号,如在特定场景中把人体视为地面的一部分。 将 VGGT 帧内注意力块的 FFN 权重以 50%-50% 的比例平均融合进VGGT-Ω后,这些错误得以消除;融合 Q/K/V 投影权重则没有同样效果。 相机外参信息似乎在更高层编码,并非仅由 FFN 权重控制。 最后,对可变输入帧数的泛化能力也与帧内注意力块密切相关。
运动感知。
由于模型能重建包含大幅非相机运动的动态序列,我们进一步考察其是否学会定位运动区域。 为此,我们分析中间词元的特征分布:在时空维度上归一化中间图像词元,用 PCA 降维,再用 \(k\)-means 聚类。整个过程均不使用标签、光流或学习式探针。
如[fig:motion]所示,一个 PCA 簇始终跨帧跟踪移动的舞者,而静态人群和背景留在其他簇中。 这表明,无需显式运动监督,运动判别能力会作为重建目标的副产物自动涌现。 此外,无论训练还是推理,模型从未获得输入帧的时间顺序。
我们还考察了该信号随层深的演化。 浅层(如[fig:motion]中的第 4 层)产生最干净的运动分割,能隔离舞者且背景响应极少;中层(如第 13 层)保留较弱但仍可辨的运动信号;在最深层(如第 23 层),相同聚类过程会突出场景中的所有人物,说明表征逐渐更具全局性和语义性。
预测归一化。
VGGT 曾讨论是否应在线将预测归一化到单位坐标空间,这里进一步分析该问题。 与 VGGT 的观察一致,模型收敛后,使用与不使用预测归一化的定量性能没有差异。 归一化的主要优势体现在定性结果上:最终点云在空间中分布更均匀。 缺点是优化更不稳定,学习曲线更陡峭,也更依赖谨慎的超参数调节以避免梯度爆炸。 若必须归一化预测,建议像 PI3 一样从预训练模型初始化,以稳定训练。
DINO 初始化。
如前所述,VGGT-Ω由 DINOv3 初始化。我们发现,不采用 DINO 初始化(即从头训练)仍可收敛到相近性能,但需要多 4--8\(\times\) 的训练迭代。DINOv3 显著降低了优化难度并提高训练效率。
无效区域预测。
我们参照[wang24moge:, keetha26mapanything:]试验了预测无效区域的额外分支,希望帮助模型忽略天空等区域,避免点云中的天空像素黏附于前景物体。 尽管模型能准确预测无效掩码,天空像素仍出现在深度估计前景中,可能因为这些区域缺少监督信号。 因此,为尽量减少稠密预测头数量,最终模型未加入该预测器。
仅使用寄存器注意力。
我们还测试了完全不使用完整全局注意力、仅使用寄存器注意力的方案。 此时,一帧中的图像词元无法关注其他帧的图像词元,所有帧间信息交换均依赖寄存器。 尽管 FLOPs 降至原模型的 6%,性能也降至原始 VGGT 的水平。对于端侧应用,这一权衡值得探索。
辅助输入。
理论上,引入时间顺序、相机参数、深度图或尺度因子等辅助输入可进一步提高性能。 然而,经验表明,在预训练阶段引入这些先验往往有害,即使在不同训练迭代中随机使用或掩蔽亦然。 相反,初步实验显示,仅在微调阶段提供条件辅助输入非常有效,既能提高任务特定性能,又不破坏学得表征的完整性。 全面探索超出本文范围,但这是一个有前景的未来方向。
合成与真实数据混合。
与 VGGT[wang25vggt]的观察一致,合成数据和真实数据在训练中作用互补。 粗略而言,合成数据更直接地贡献于准确率,真实数据则改善泛化能力;后者的主要作用是让模型适应真实世界外观,并接触更多样的相机轨迹。 实践中,建议每个训练轮次采样约 80% 合成数据和 20% 真实数据。 若能获得足够干净的合成标注,例如解决[sec:data_quality]所述问题后,将合成数据比例提高至约 90% 可能更佳。
如何微调 VGGT/VGGT-Ω。
在新数据域上微调 VGGT/VGGT-Ω以完成重建任务时,我们建议采用两项实践策略。 第一,使用完整学习率调度,即线性预热后接余弦衰减。峰值学习率应保持较小,迭代次数不必很多,但完整走完调度通常优于恒定学习率。 第二,偶然不确定性(置信度)损失在微调期间可能不稳定,因此建议初期移除该损失,尤其当微调数据集很小时。若下游任务需要置信度估计,可单独微调不确定性头。 对于重建之外的任务,建议提高预热比例(如从 5% 提至 10--15%),并使用完整调度周期。
自监督训练。
原则上,自监督训练是扩展训练数据的有力工具。目前它有助于提高模型泛化能力,尤其针对分布外数据,但对大多数基准影响很小;进一步改进并不容易,并行工作也得到类似观察[huang2026self]。 我们投入大量时间探索其他自监督方案,包括与 RayZer[jiang25rayzer:] 和 E-RayZer[zhao26e-rayzer:] 类似的新视图合成变体、生成词元而非像素、NeRF 表征[barron21mip-nerf:]或高斯泼溅[kerbl233d-gaussian]。 还尝试了掩蔽图像词元、跨帧区分物体、引入时间顺序及相关变体。在我们的实现中,只有学生—教师方法有效。 例如,E-RayZer 等方法可能适用于静态场景,却难以处理动态场景。 这一结果有违直觉,因为二维自监督训练很大程度上依赖某种不变性(如 DINO 中的图像增强),重建理应自然编码此类不变性。 我们原本预期自监督重建可从头训练,但成功方案仍需要预训练模型。 因此,尽管[sec:self-supervised-training]中的教师—学生自监督训练并非取得基准结果所必需,且会使训练流程更复杂,我们仍将其分享给社区。 自监督重建仍是开放问题,最终可能需要整合进后文讨论的统一模型或全能模型。
稠密预测头。
原则上,强潜在表征应允许仅用 MLP 解码稠密预测任务,无需依赖卷积层;JiT[li26back]和 LagerNVS[szymanowicz26lagernvs]等近期结果支持这一观点。 这与保持框架简洁、可扩展的目标一致,因此我们曾对此展开探索。 然而,纯 MLP 预测头总会在深度图中产生可见的图块/块状伪影,尽管其定量指标通常优于卷积替代方案,速度更快、显存效率更高,训练梯度也更稳定。 这些伪影会引入本应平滑的几何不连续,对人眼尤其明显。 我们尝试了 mipmap 式监督[barron21mip-nerf:](引入局部深度方差)、概率建模(以多个独立通道的概率混合估计深度)及相关变体,但均无法可靠消除伪影。 有趣的是,该问题在室外场景中远比室内常见,尤其当场景含有远处物体时。 我们推测这与预测目标的数值分布有关:JiT 研究的图像生成输出位于边界明确的数值空间,而深度等几何量的范围实际上无界。 因此我们采用折中方案:保留少量卷积层,后接 MLP 层。 浅层卷积在 \(16\times16\) 或 \(32\times32\) 等低特征分辨率上运行,计算开销很小,却贡献了观察到的大部分空间平滑度提升。 为保持与先前方法的架构可比性,我们使用 DPT 的浅层;实际上,任何特征金字塔式卷积架构都能缓解图块伪影。 尽管VGGT-Ω采用此折中方案,我们仍认为纯 MLP 稠密解码头是有前景且重要的未来方向。
讨论
下面讨论 VGGT-Ω设计中的若干取舍。这些取舍在一定程度上源于我们对前馈式模型如何为研究社区创造最大价值的思考。
优先保持简洁性。
我们发现,若干架构改动可以进一步提升性能。 例如,尽管本文模型只需单次前向传播即可预测相机参数,但采用原始 VGGT[wang25vggt]的迭代细化设计可取得更好的结果。 将原始 RGB 值注入稠密预测头也能改善深度输出。 结合这些及其他技术后,在多个数据集上,AUC@\(3^\circ\) 可进一步提高 4%--6%,\(\delta_{1.25}\) 可提高约 2%;我们预计,进一步针对特定任务进行修改还能带来更多增益。 即便如此,我们仍有意优先保证模型整体的简洁性,以及特征骨干网络(聚合器)所提取表征的质量。 这一选择源于如下观察:骨干网络经过充分训练后,训练一个新的或改进后的预测头通常只需 5--10K 次迭代。 保持架构简洁还能得到更干净的基础模型,便于研究社区在此基础上继续开发。
前馈式重建的优势。
与传统重建流程相比,前馈式重建具有三项重要优势: (a) 效率高, (b) 鲁棒性强, (c) 表征能力强。 首先,其速度明显更快,在某些设置下可达到数十倍乃至数百倍;采用流式处理或多 GPU 并行后,差距还会进一步扩大。 其次,相比束调整等高度依赖显式几何优化的方法,前馈式重建的鲁棒性强得多。 例如,它可以处理视差很小或完全没有视差的情况,而基于三角测量的方法难以应对此类情况。 如实验所示,前馈式重建也易于扩展到动态场景。 第三,也是最重要的一点,前馈式重建能够提取通用的几何感知表征。 三维视觉领域缺少强大且开箱即用的通用特征提取器;在二维视觉领域,已有较早的 VGG16[simonyan15very]和 ResNet[he16deep],更不用说现代二维视觉或视觉--语言基础模型。 本文通过多个示例表明,前馈式重建是为三维任务学习此类表征的一项前景良好的代理任务。
COLMAP[schonberger16structure-from-motion]等基于优化的重建方法仍有其优势。 在条件良好的情况下,束调整能以极高精度估计相机参数,将角度误差降至百分之几度。 对于使用 NeRF[mildenhall20nerf:]或高斯泼溅[kerbl233d-gaussian]进行新视角合成等应用,这种精度仍然很有价值。 前馈式重建与优化并不冲突;相反,它可为束调整等后续优化过程提供良好的初始化。 尽管如此,鉴于 VGGT 提出后前馈式重建在短期内取得的快速进展,我们仍对其未来的精度提升和这一范式的适用性保持乐观。
大模型时代三维/四维技术的作用。
空间理解正日益受到视觉--语言、视觉--语言--动作、视觉--动作及世界模型领域的关注~ chen24spatialvlm:,cheng24spatialrgpt:,zitkovich23rt-2:,cai26depthlm:,kim25openvla:, team25gemini,hu23gaia-1:,li26causal,parker-holder25genie,nvidia25cosmos. 这是开发具身智能体的自然结果,因为它们需要在三维物理世界中运行。 短期来看,重建模型可作为外部工具,用于获取深度和相机参数等显式三维信息。
如本文所述,重建模型还可提供隐式编码空间信息的“结构化”词元。
长期来看,重建可能成为未来统一模型(“全能模型”)的组成部分,即使用语言、视觉等多种模态进行预训练,并面向理解与生成等多种能力的大模型[wang24emu3:, zhou25transfusion:, tong26beyond, team26longcat-next:, wang26ernie, team24chameleon:, wu25janus:, deng25emerging]。
这一目标有望通过在模型训练中加入面向重建的数据来实现,而无需大幅修改架构或训练框架。
例如,可将相机参数作为文本进行自回归预测,并将深度等逐像素量建模为图像生成任务,近期工作[yang26context]已对此展开探索。
下一代重建模型乃至更广泛的感知系统,或将建立在统一模型之上。
首先,最大的收益很可能来自数据,而数据正是重建等感知任务目前的主要瓶颈。 大规模文本与视频语料包含对物理世界丰富的隐式描述。 将几何任务与这些模态联合训练,便可利用这一规模庞大、覆盖更广的监督来源。 其次,大多数感知问题在孤立处理时都存在严重的欠约束。 统一模型会自然施加跨任务一致性,使一个领域中的歧义(例如,深度估计中的无纹理区域)能够借助另一领域的先验(例如,语义上下文)来消解。 第三,从范式层面也有理由朝这一方向发展:近期观察可能表明,相比仅面向感知的视觉模型,生成式视觉模型更易扩展,并且生成模型似乎能够在一定程度上迁移到感知任务[gabeur26image]。 我们预计,更强、更鲁棒的感知模型将来自多模态、多任务训练,而不是孤立的重建或感知目标。
结论
本文提出了VGGT-Ω,一种在静态和动态基准上均取得优异结果的前馈式重建模型。 我们从架构、数据和训练三个方面改进原始 VGGT:引入寄存器注意力,采用带多任务监督的单一稠密预测头,构建处理动态内容的大规模标注流程,并设计利用海量无标签视频的自监督训练方案。 这些设计使模型得以在前所未有的规模上训练。 实验表明,VGGT-Ω的性能会随模型容量和数据规模可预测地提升。 除几何信息外,学得的寄存器还承载有用的全局信息,可改进 VLA 模型并支持语言对齐。 我们希望VGGT-Ω能成为社区进一步研究的有用基础。
致谢。
Jianyuan Wang 获得 Facebook AI Research 的支持。 Christian Rupprecht 部分获得 ERC 启动基金“Volute”(编号 101222037)的支持。
许多人为本工作提供了帮助。 完整致谢请参见项目主页。
supplementary
附录
本补充材料在[sec:impl]中给出更多实现细节,在[sec:data_quality]中讨论常见数据问题,并在[sec:limitation]中分析局限性。
补充细节
本节详细介绍训练设置与架构([sec:impl-training])、正负样本对的构造([sec:impl-pairs])、VLM 提示词([sec:impl-vlm-prompt])、标注筛选标准([sec:impl-filtering])和语言对齐流程([sec:impl-language-alignment])。
训练与架构
训练时,[eq:training-loss]中的损失权重设为 \(\lambda_{\text{cam}} = 5.0\)、\(\lambda_{\text{depth}} = 1.0\)、\(\lambda_{\text{point}} = 0.5\) 和 \(\lambda_{\text{match}} = 0.1\)。 遵循[wang24dust3r:, wang25vggt],我们将每个场景的真实值归一化到单位空间。 具体而言,先将所有量变换到第一台相机的坐标系,计算所有三维点到原点的平均距离,再用该值缩放深度图和平移向量。 与[wang25vggt]相同,此归一化仅用于真实值,不用于预测值。 为稳定训练,我们采用阈值为 \(1.0\) 的梯度范数裁剪,并在注意力层中使用 QKNorm。 每次迭代从 \([1, 24]\) 随机采样输入帧数,并相应设置批大小以充分利用 GPU 显存。 每帧以 \(0.05\) 的概率独立添加矩形掩码,其高和宽从 \([32, 128]\) 像素均匀采样。 掩码区域内的像素设为黑色,对应深度值标记为无效。 颜色抖动采用 PyTorch 实现,亮度、对比度、饱和度和色相参数分别为 \(0.5\)、\(0.5\)、\(0.5\) 和 \(0.1\)。 自监督训练期间,教师模型权重以衰减率 \(0.999\) 的指数移动平均更新。 相机预测头沿用[wang25vggt]的实现:焦距使用 ReLU 激活,四元数和平移参数不使用激活函数。 对于具有时间顺序的序列(例如,视频),我们从局部时间窗口采样帧,而不依据共视关系采样。 由此可能生成极具挑战的重建子集:图像语义相关,却几乎没有视觉重叠。 实验发现,这些样本能提高模型泛化能力。
构造正负样本对
下面补充主文([sec:training-losses])中的匹配损失,详述正负词元对的构造方法。
给定由深度图反投影得到的逐像素三维点,我们先在查询帧中采样有效像素,并将各采样像素归入一个查询图块。 随后利用已知相机内外参,将对应三维点投影至所有其他帧,仅保留同时满足以下条件的投影:(i)落在图像内;(ii)与目标帧深度图保持深度一致(相对容差为 \(1\%\),并排除宽 4 像素的窄图像边界)。
对每个目标帧,我们统计各查询图块有多少三维点落入各目标图块。 由此为每个查询图块得到目标图块上的软对应图,以投影重叠率表示。 我们选择跨视图有效投影充足的查询图块,并随机采样不超过固定数量的图块;采样概率与其对应总数成正比。 对于每个选中的查询图块,所有重叠率 \(>\)10% 的目标图块均构成正词元对。
由于部分序列是动态的,不满足正样本标准并不自动意味着有效负样本。 因此,我们随机采样图块作为查询和目标候选,并施加两项约束以构造负样本对: (i)几何约束,要求候选目标图块中心与查询图块诱导的极线相距足够远(即,具有较大的极线/Sampson 距离); (ii)外观约束,要求两个图块的平均 RGB 值具有足够大的 \(\ell_2\) 距离。 同时满足两项约束的图块视为负样本。 随后对负样本下采样,得到均衡的正负图块对,用于监督最后一层词元的匹配损失。
VLM 提示词
我们使用 VLM 丢弃不适合多视图几何的视频。VLM 提示词如下:
“你是计算机视觉、摄影测量和多视图几何(MVG)专家。”
“分析视频片段,判断其是否适合高质量三维重建。”
“必须依据以下严格标准对视频分类并提取场景元数据。”
步骤 1:检查硬拒绝因素
“评估以下项目。若存在任意一项,则分类为 `REJECT_HARD'”:
-
不连续与剪辑:视频是否包含切镜、叠化、划变、淡入淡出或蒙太奇剪辑?(必须是单个连续镜头。)
-
非物理/二维内容:是否为屏幕录制、静态图像幻灯片、动画或卡通?(必须是真实世界影像。)
-
严重视觉失效:严重运动模糊(边缘丢失)、严重滚动快门(晃动/果冻效应)或数据损坏/画面故障。
-
严重遮挡:是否存在大面积叠加层(大段文字/UI)、水印,或手指遮住镜头等物理遮挡?
-
非针孔投影:影像是否为 360\(^{\circ}\) 等距柱状投影,或未经标定且畸变严重的鱼眼画面?
步骤 2:检查几何与纹理适用性
“若视频通过步骤 1,则评估重建质量。若存在任意一项,则分类为 `REJECT_SOFT':”
-
视差不足:相机是否静止?是否只有旋转(平移摇摄/俯仰)或变焦而无物理平移?(深度恢复需要平移。)
-
纹理问题:场景是否缺少非重复纹理?(如空白白墙、只有纯蓝天空、暗部阴影或网格瓷砖等高度重复图案。)
-
镜面与透明物体:主要特征是否具有反射性(镜子、水、玻璃)或透明?(这会产生“幽灵”几何。)
-
对焦与景深问题:是否存在严重的反复对焦(脉动),或景深过浅导致背景完全虚化(散景)?
-
动态主体占优:移动主体(如说话人头部特写)是否占据画面 \(>90\%\),而可见静态背景很少?
步骤 3:提取元数据
“判断场景动态性:”
-
动态:存在移动物体(行人、行驶车辆、被强风吹动的树木)。
-
静态:场景为刚性,只有相机移动。
输出说明:
“严格按以下模式返回 JSON 对象。不得输出 Markdown 格式,也不得在 JSON 外添加解释。”
{
"classification":
"ACCEPT" | "REJECT_HARD" | "REJECT_SOFT",
"reason": "Brief descriptions of the primary
flaw or 'Good candidate'",
"scene_dynamics": "Static" | "Dynamic"
}
“标签定义:”
REJECT_HARD:因剪辑、合成内容、严重伪影或遮挡而不可用。
REJECT_SOFT:技术上可用,但可能因纯旋转、反射、缺少纹理或对焦问题而失败。
ACCEPT:高质量候选;单镜头、平移/视差清晰、纹理良好、几何刚性。
标注筛选标准
为训练[sec:annotation-pipeline]所述的集成分类器(XGBoost、随机森林和 CatBoost),我们从每个重建结果中提取若干几何特征。 这些特征用于检测共线运动退化、尺度不一致和相机轨迹含噪等常见失败模式。 下面给出流程中最重要特征的定义。
轨迹平滑度。
我们用平移向量 \(\mathbf{t}\) 的加速度量化估计相机轨迹的平滑度。平滑度分数 \(S_\text{trans}\) 定义为加速度模长平方的均值:
$$
S_\text{trans} = \frac{1}{N-2} \sum_{i=1}^{N-2} | \mathbf{t}{i+1} - 2\mathbf{t}_i + \mathbf{t}{i-1} |^2
$$
对于旋转,我们利用旋转向量的二阶差分计算类似指标 \(S_\text{rot}\)。\(S_\text{trans}\) 或 \(S_\text{rot}\) 较高表示轨迹抖动,通常与 SfM 收敛不佳有关。
视差角分析。
为确保多视图立体具有足够基线,我们分析重建稀疏点云的视差角。 对于稀疏点子集 \(\mathcal{P}\),找出可见点 \(p \in \mathcal{P}\) 的相机集合 \(\mathcal{C}_p\),并计算任意相机对 \(c_j, c_k \in \mathcal{C}_p\) 在点 \(p\) 处张成的最大夹角。 最终特征取所有采样点最大夹角的中位数。中位视差较低意味着纯旋转运动退化或距离极远。
点云 PCA 形状(线性度与平面度)。
为检测“掠过式”直线重建(会造成圆柱歧义)等几何退化,我们对归一化点云坐标执行主成分分析(Principal Component Analysis,PCA)。 令 \(v_1 \ge v_2 \ge v_3\) 为点云协方差矩阵的特征值。 定义线性度为 \((v_1 - v_2) / v_1\),平面度为 \((v_2 - v_3) / v_1\),散射度为 \(v_3 / v_1\)。 线性度过高的重建会被标记为线性退化,通常由分类器丢弃。
深度图完整度。
该指标评估稠密重建阶段的密度。对每一帧,计算具有有效有限深度值的像素占总图像分辨率的比例,最终特征为所有帧完整度的平均值。 数值极低通常表示多视图立体阶段失败,常由无纹理表面、强镜面反射或劣质相机导致。
点云噪声水平。
我们通过统计离群点检测估计信噪比。对每个点,计算其到最近邻的平均距离;若该距离超过全局均值两个标准差以上,则将该点归为噪声。 该特征取噪声点比例,用于检测受漂浮伪影和离群点困扰的重建。
该流程只能为刚性像素提供深度值,因此上述指标假设动态像素已被掩蔽。我们假设模型可从合成数据中学会估计动态像素深度。
语言对齐
在[sec:applications]中,我们使用 VLM 为每个训练序列生成序列级语言嵌入。 这里给出确切的 VLM 提示词及代表性生成描述。 生成文本词元的隐状态经均值池化和投影后形成语言嵌入,提示词和图像词元不参与池化。 新生成词元最多为 \(128\) 个,VLM 参数保持冻结。 对齐微调期间按[sec:applications]所述优化VGGT-Ω侧。 无论输入 VLM 还是本文模型,图像均以无序集合形式提供。
语言对齐提示词
这些图像从多个视角展示同一场景。
请把完整场景描述为一个连贯场景,而非多张独立图像。
采用以下格式:
场景:场景类别或环境。
内容:主要物体及粗略空间布局。
外观:材质、颜色或风格等稳定视觉属性。
每个字段用一个短句。
应提及跨多个视图一致的信息,即使它并非在每个视图中都可见。
重点描述共享场景内容、主要物体、粗略布局和稳定外观。
仅当动态物体在多个视图中显著且可辨认时才提及。
不要描述运动、动作或特定帧变化。
不要逐张描述图像。
不要提及相机运动、视角顺序、图像质量、模糊、曝光、光照伪影或不确定性。
描述应简洁、客观且语义密集。
height 0.6pt
代表性描述
0.4pt0pt
场景:一间光线昏暗、泛红色调的房间,内有门、窗和带图案纹理的墙。
内容:房间左侧有一扇关着的门,右侧有一扇窗,另有一面带纹理图案的墙。
外观:墙面带花卉或锦缎图案,地板颜色较深,整体光照呈红色。
场景:带蜿蜒道路的雪林景观。
内容:积雪覆盖的森林中有高大松树、蜿蜒道路和陡坡。
外观:场景对比度较高,上方为乌云,明亮白雪覆盖地面和树木。
场景:室外公共区域。
内容:铺装地面上有一张深绿色塑料野餐桌,桌面为六边形、桌腿为黑色,并配有相应长凳。
外观:桌椅均由统一的深绿色哑光塑料制成,地面铺设浅灰色方砖。
场景:具有现代建筑的城市广场。
内容:中央喷泉设有大型圆形雕塑,周围是铺装步道和建筑。
外观:喷泉主体为银色金属结构,底座较深;周边铺有浅灰色石砖,并有采用玻璃与混凝土立面的现代建筑。
数据质量
数据是训练大型“基础”模型的关键要素之一,但仅有大量数据并不足够;数据质量同样会显著影响模型行为。 对于三维重建,我们发现含噪数据会在自监督和有监督训练中引入特定失败模式。
在自监督训练中,难度不合理的视频(如电视素材中常见的不连续镜头切换)会引起剧烈损失尖峰,甚至导致梯度爆炸和性能下降。 因此,自监督训练仅使用通过[sec:annotation-pipeline]所述 VLM 预筛选的视频;该检查能可靠移除这类样本。
在有监督阶段,含噪数据的影响更隐蔽,却同样重要。 不同类型的标注错误会在推理时转化为特定失败模式;更糟的是,这些模式不影响标准基准中的大多数图像,因而可能无法从定量结果中发现。 只有当新测试样本与训练期间见过的错误标注样本相似时,问题才会显现。 这表明模型虽学会了三维重建的一般原理,也会记忆特殊噪声。下面讨论最具代表性的案例。
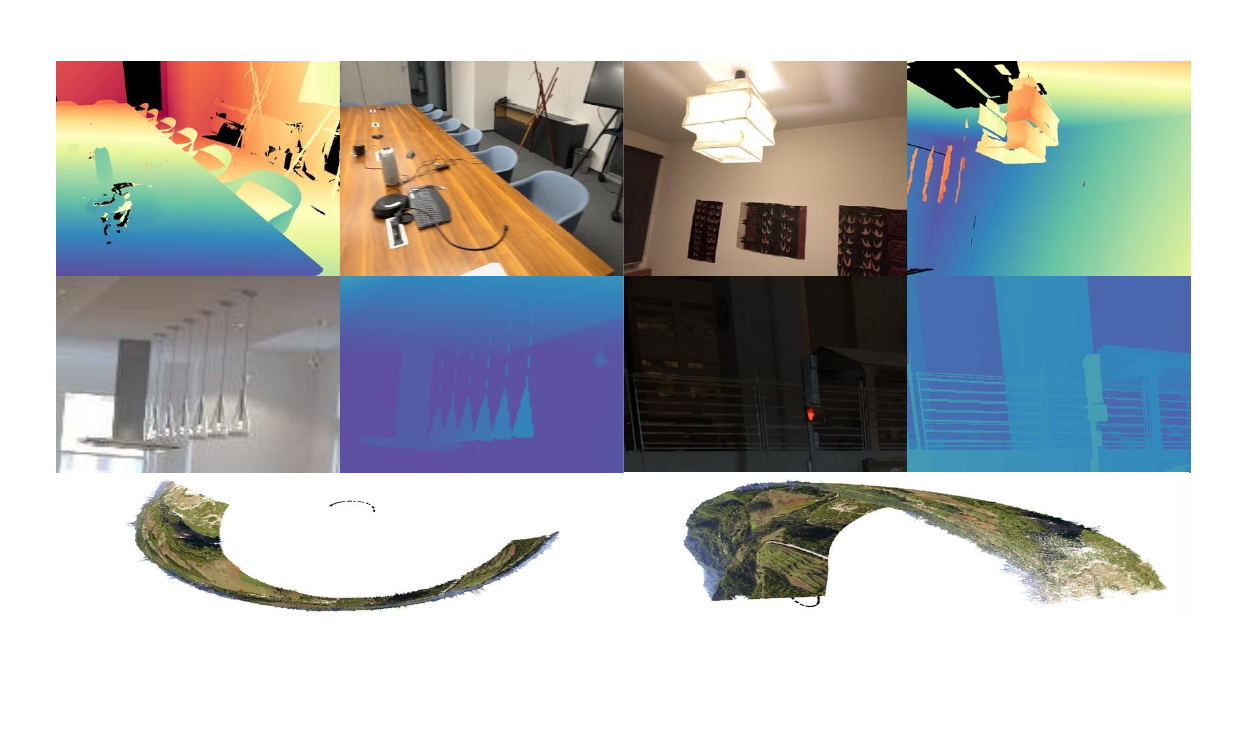
图:常见数据问题。顶行:ScanNet++ 样本。中行:Hypersim 等合成数据集样本。底行:穹顶效应。
传感器。
部分数据集使用 LiDAR 或深度相机等传感器标注真实场景,常见失败模式是前景—背景泄漏。 例如,[fig:data_quality]顶行展示的 ScanNet++ 样本中,椅背深度对应背景地板或墙壁,可能源于传感器采集未对齐或存在孔洞。 悬挂灯具周围也出现虚假深度伪影:渲染深度含有与可见灯具几何不符的碎片化前景结构。 这些伪影可能由过曝或半透明物体附近不可靠的传感器采集或重建造成,因此我们在训练后期排除此类数据集。
细薄结构。
合成数据通常提供更准确的几何标注,但部分合成数据集中的细薄结构仍可能不准。 栅栏杆等物体往往只占数个像素,并位于陡峭深度不连续处。尽管其在 RGB 图像中清晰可见,渲染深度却可能不完整、过度平滑或未对齐。 因此,标签可能将细薄结构赋为其后方墙壁、窗户、地板或远处背景的深度,而非真实物体表面,如[fig:data_quality]中行所示。 推理时,模型可能忽略细薄物体,仅恢复其较粗或较低部分,或使其在深度图中被邻近大表面淹没。 这是现有模型的普遍问题,我们推测更高分辨率输入或更优合成数据可缓解该问题。
虚假背景。
合成数据的另一常见问题是虚假背景。 例如,在 Kubric、PointOdyssey 和 BEDLAM 中,背景深度可能对应 HDRI 渲染所用的代理穹顶或地面几何,而非背景外观暗示的真实三维结构。 这种设计虽适合渲染,却会提供与场景语义不一致的深度值。 对于 BEDLAM 等真实前景与合成背景边界清晰的数据集,我们通过阈值化最大有效前景深度,在训练时滤除背景;其余此类数据则不用于训练。
穹顶效应。
COLMAP[schonberger16structure-from-motion]、MegaSaM[li25megasam:] 和 ViPE[huang25vipe:] 等采用束调整的方法可生成伪真值,但也可能产生[fig:data_quality]底行所示的穹顶效应等退化解。 这通常源于图像集合的全局约束较弱,例如,近乎平行的观察方向、环路闭合不足、三角化夹角较小,或相机自标定不准,特别是互联网视频中常见的径向畸变误差。 此时束调整仍可获得较低重投影误差,却会把恢复的相机和场景几何弯曲成全局不一致的曲面。 这类重建局部看似合理,但大尺度几何错误,不适合作为监督信号。 可采用[sec:data]所述有监督几何筛选,或将标注深度与现有单目深度模型、前馈式重建模型的预测比较,以滤除这类样本。
融入墙体的人体。
在有行人穿行的近静态街景视频中,我们反复观察到一种失败模式:几乎所有现有前馈式重建模型都会把人体吸收到静态背景中,将其估计为邻近墙体或建筑的一部分。 这似乎与现有训练数据集中含糊的边界像素有关。 例如,广泛使用的多视图数据集 MegaDepth 通过 COLMAP 标注旅游摄影图像,而这些图像常含有人物。 在人像边界处,图块匹配立体算法可能把部分像素分配给周围静态建筑,使监督信号把人体局部视为背景。 排除 MegaDepth 或重新估计其深度可显著减少此伪影。
数据歧义。
不同数据集间的标注不一致会导致令人困惑的模型行为。 例如,在 Aria Synthetic Environments 和 HyperSim 等合成数据集中,室外场景常被渲染成贴于窗户上的二维纹理,因此真实深度对应窗面本身;而在其他数据集中,深度值正确表示透过窗户可见的真实物体。 训练语料中这种固有的真实值不匹配会混淆模型,偶尔产生异常预测行为。
近期多个数据集提出了互联网视频标注的替代流程,包括 SceneScribe-1M[wang26scenescribe-1m:]、PointWorld[huang26pointworld:]、Sekai[li25sekai:]、SpatialVID[wang25spatialvid:] 和 OmniWorld[zhou26omniworld:],也值得进一步探索。
局限性
失败案例。
尽管VGGT-Ω总体表现优异,但在特定场景中仍面临困难。 例如,强运动模糊会显著降低性能;视场角突然变化(如数秒内从 \(10^\circ\) 变为 \(160^\circ\))或相机畸变严重时,重建质量也常会下降。 此外,模型在训练早期接触过一些含噪数据(例如,ScanNet++),因此面对包含大量显示器的办公室等场景时,预测有时不稳定。 这些局限主要源于训练数据分布,未来将引入更多样、更具挑战性的序列加以缓解。
被掩蔽的敏感内容。
受隐私和许可限制,训练数据中的人脸、商标等部分内容被掩蔽或模糊处理。 因此,模型偶尔会在这些区域产生异常伪影或不稳定预测。例如,身穿黑色衣物的人体深度预测有时不够平滑。 这些伪影可能导致视觉畸变或观感欠佳的输出。
参考文献
wang24dust3r:— Shuzhe Wang and Vincent Leroy and Yohann Cabon and Boris Chidlovskii and Jerome Revaud. DUSt3R: Geometric 3D Vision Made Easy. cvpr. 2024.leroy24grounding— Vincent Leroy and Yohann Cabon and Jerome Revaud. Grounding Image Matching in 3D with MASt3R. eccv. 2024.wang25vggt— Jianyuan Wang and Minghao Chen and Nikita Karaev and Andrea Vedaldi and Christian Rupprecht and David Novotny. VGGT: Visual Geometry Grounded Transformer. cvpr. 2025.wang25p3— Yifan Wang and Jianjun Zhou and Haoyi Zhu and Wenzheng Chang and Yang Zhou and Zizun Li and Junyi Chen and Jiangmiao Pang and Chunhua Shen and Tong He. \(^3\): Permutation-Equivariant Visual Geometry Learning. arxiv. 2025.lin25depth— Haotong Lin and Sili Chen and Junhao Liew and Donny Y. Chen and Zhenyu Li and Guang Shi and Jiashi Feng and Bingyi Kang. Depth Anything 3: Recovering the Visual Space from Any Views. arxiv. 2025.hartley00multiple— Richard Hartley and Andrew Zisserman. Multiple View Geometry in Computer Vision. 2000.snavely06photo— Noah Snavely and Steven M. Seitz and Richard Szeliski. Photo tourism: exploring photo collections in 3D. tog. 2006.schonberger16structure-from-motion— Sch\"onberger, Johannes Lutz and Frahm, Jan-Michael. Structure-from-Motion Revisited. cvpr. 2016.li25spatial— Li, Fuhao and Song, Wenxuan and Zhao, Han and Wang, Jingbo and Ding, Pengxiang and Wang, Donglin and Zeng, Long and Li, Haoang. Spatial forcing: Implicit spatial representation alignment for vision-language-action model. arxiv. 2025.abouzeid25geoaware-vla:— Abouzeid, Ali and Mansour, Malak and Sun, Qinbo and Sun, Zezhou and Song, Dezhen. Geoaware-VLA: Implicit geometry aware vision-language-action model. arxiv. 2025.zeng25janusvln:— Zeng, Shuang and Qi, Dekang and Chang, Xinyuan and Xiong, Feng and Xie, Shichao and Wu, Xiaolong and Liang, Shiyi and Xu, Mu and Wei, Xing and Guo, Ning. Janusvln: Decoupling semantics and spatiality with dual implicit memory for vision-language navigation. arxiv. 2025.qian26xembodied:— Kangan Qian and ChuChu Xie and Yang Zhong and Jingrui Pang and Siwen Jiao and Sicong Jiang and Zilin Huang and Yunlong Wang and Kun Jiang and Mengmeng Yang and Hao Ye and Guanghao Zhang and Hangjun Ye and Guang Chen and Long Chen and Diange Yang. XEmbodied: A Foundation Model with Enhanced Geometric and Physical Cues for Large-Scale Embodied Environments. arxiv. 2026.zhang26spatialstack:— Zhang, Jiang and Zhou, Shijie and Liu, Bangya and Kadambi, Achuta and Fan, Zhiwen. SpatialStack: Layered Geometry-Language Fusion for 3D VLM Spatial Reasoning. arxiv. 2026.zhang26make— Zhang, Shihua and Shen, Qiuhong and Wang, Shizun and Pan, Tianbo and Wang, Xinchao. Make Geometry Matter for Spatial Reasoning. arxiv. 2026.zheng25learning— Zheng, Duo and Huang, Shijia and Li, Yanyang and Wang, Liwei. Learning from videos for 3D world: Enhancing mllms with 3D vision geometry priors. arxiv. 2025.bonnen26human-level— Tyler Bonnen and Jitendra Malik and Angjoo Kanazawa. Human-level 3D shape perception emerges from multi-view learning. arxiv. 2026.wang26let-geometry— Wang, Chongyu and Huang, Ting and Sun, Chunyu and Ning, Xinyu and Wang, Di and Tang, Hao. Let Geometry GUIDE: Layer-wise Unrolling of Geometric Priors in Multimodal LLMs. arxiv. 2026.huang26gen3r:— Jiaxin Huang and Yuanbo Yang and Bangbang Yang and Lin Ma and Yuewen Ma and Yiyi Liao. Gen3R: 3D Scene Generation Meets Feed-Forward Reconstruction. cvpr. 2026.jang26repurposing— Wooseok Jang and Seonghu Jeon and Jisang Han and Jinhyeok Choi and Minkyung Kwon and Seungryong Kim and Saining Xie and Sainan Liu. Repurposing Geometric Foundation Models for Multi-view Diffusion. arxiv. 2026.yang26cambrian-s:— Shusheng Yang and Jihan Yang and Pinzhi Huang and Ellis L Brown II and Zihao Yang and Yue Yu and Shengbang Tong and Zihan Zheng and Yifan Xu and Muhan Wang and Rob Fergus and Yann LeCun and Li Fei-Fei and Saining Xie. Cambrian-S: Towards spatial supersensing in video. iclr. 2026.szymanowicz26lagernvs— Stanislaw Szymanowicz and Minghao Chen and Jianyuan Wang and Christian Rupprecht and Andrea Vedaldi. LagerNVS: Latent Geometry for Fully Neural Real-time Novel View Synthesis. cvpr. 2026.cao26vggt-det:— Cao, Yang and Wu, Feize and Chen, Dave Zhenyu and Zhong, Yingji and Hong, Lanqing and Xu, Dan. VGGT-Det: Mining VGGT internal priors for sensor-geometry-free multi-view indoor 3D object detection. arxiv. 2026.gao26vggt-segmentor:— Gao, Yulu and Zhang, Bohao and Tang, Zongheng and Liao, Jitong and Wu, Wenjun and Liu, Si. VGGT-Segmentor: Geometry-Enhanced Cross-View Segmentation. arxiv. 2026.zhao25spacemind:— Zhao, Ruosen and Zhang, Zhikang and Xu, Jialei and Chang, Jiahao and Chen, Dong and Li, Lingyun and Sun, Weijian and Wei, Zizhuang. SpaceMind: Camera-Guided Modality Fusion for Spatial Reasoning in Vision-Language Models. arxiv. 2025.yang25dense— Yang, Songlin and Wei, Tianyi and Lan, Yushi and Xiao, Zeqi and Rao, Anyi and Pan, Xingang. Dense Semantic Matching with VGGT Prior. arxiv. 2025.vuong25improving— An Dinh Vuong and Minh Nhat Vu and Ian Reid. Improving Robotic Manipulation with Efficient Geometry-Aware Vision Encoder. arxiv. 2025.rao26augvla-3d:— Zhifeng Rao and Wenlong Chen and Lei Xie and Xia Hua and Dongfu Yin and Zhen Tian and F. Richard Yu. AugVLA-3D: Depth-Driven Feature Augmentation for Vision-Language-Action Models. arxiv. 2026.zhou26generalizing— Changqing Zhou and Yueru Luo and Changhao Chen. Generalizing Visual Geometry Priors to Sparse Gaussian Occupancy Prediction. arxiv. 2026.xu26vggt-mpr:— Jingyi Xu and Zhangshuo Qi and Zhongmiao Yan and Xuyu Gao and Qianyun Jiao and Songpengcheng Xia and Xieyuanli Chen and Ling Pei. VGGT-MPR: VGGT-Enhanced Multimodal Place Recognition in Autonomous Driving Environments. arxiv. 2026.wu26mvggt:— Changli Wu and Haodong Wang and Jiayi Ji and Yutian Yao and Chunsai Du and Jihua Kang and Yanwei Fu and Liujuan Cao. MVGGT: Multimodal Visual Geometry Grounded Transformer for Multiview 3D Referring Expression Segmentation. arxiv. 2026.lee253d-aware— Lee, Seonho and Choi, Jiho and Kang, Inha and Kim, Jiwook and Park, Junsung and Shim, Hyunjung. 3D-Aware Vision-Language Models Fine-Tuning with Geometric Distillation. Proc. EMNLP. 2025.simeoni25dinov3— Oriane Sim\'eoni and Huy V. Vo and Maximilian Seitzer and Federico Baldassarre and Maxime Oquab and Cijo Jose and Vasil Khalidov and Marc Szafraniec and Seungeun Yi and Micha\"el Ramamonjisoa and Francisco Massa and Daniel Haziza and Luca Wehrstedt and Jianyuan Wang and Timoth\'ee Darcet and Th\'eo Moutakanni and Leonel Sentana and Claire Roberts and Andrea Vedaldi and Jamie Tolan and John Brandt and Camille Couprie and Julien Mairal and Herv\'e J\'egou and Patrick Labatut and Piotr Bojanowski. DINOv3. arxiv. 2025.kaplan20scaling— Kaplan, Jared and McCandlish, Sam and Henighan, Tom and Brown, Tom B and Chess, Benjamin and Child, Rewon and Gray, Scott and Radford, Alec and Wu, Jeffrey and Amodei, Dario. Scaling laws for neural language models. arxiv. 2020.zhai22scaling— Zhai, Xiaohua and Kolesnikov, Alexander and Houlsby, Neil and Beyer, Lucas. Scaling vision transformers. cvpr. 2022.darcet24vision— Darcet, Timoth\'ee and Oquab, Maxime and Mairal, Julien and Bojanowski, Piotr. Vision transformers need registers. iclr. 2024.jiang25vision— Nick Jiang and Amil Dravid and Alexei Efros and Yossi Gandelsman. Vision Transformers Don't Need Trained Registers. arxiv. 2025.marouani26revisiting— Alexis Marouani and Oriane Sim\'eoni and Herv\'e J\'egou and Piotr Bojanowski and Huy V. Vo. Revisiting [CLS] and Patch Token Interaction in Vision Transformers. arxiv. 2026.shen26fastvggt:— You Shen and Zhipeng Zhang and Yansong Qu and Xiawu Zheng and Jiayi Ji and Shengchuan Zhang and Liujuan Cao. FastVGGT: Training-Free Acceleration of Visual Geometry Transformer. iclr. 2026.wang25faster— Wang, Chung-Shien Brian and Schmidt, Christian and Piekenbrinck, Jens and Leibe, Bastian. Faster VGGT with Block-Sparse Global Attention. arxiv. 2025.caron21emerging— Mathilde Caron and Hugo Touvron and Ishan Misra and Herv\'e J\'egou and Julien Mairal and Piotr Bojanowski and Armand Joulin. Emerging Properties in Self-Supervised Vision Transformers. iccv. 2021.oquab24dinov2:— Maxime Oquab and Timoth\'ee Darcet and Th\'eo Moutakanni and Huy V. Vo and Marc Szafraniec and Vasil Khalidov and Pierre Fernandez and Daniel HAZIZA and Francisco Massa and Alaaeldin El-Nouby and Mido Assran and Nicolas Ballas and Wojciech Galuba and Russell Howes and Po-Yao Huang and Shang-Wen Li and Ishan Misra and Michael Rabbat and Vasu Sharma and Gabriel Synnaeve and Hu Xu and Herve Jegou and Julien Mairal and Patrick Labatut and Armand Joulin and Piotr Bojanowski. DINOv2: Learning Robust Visual Features without Supervision. Transactions on Machine Learning Research. 2024.tarvainen17mean— Antti Tarvainen and Harri Valpola. Mean teachers are better role models: Weight-averaged consistency targets improve semi-supervised deep learning results. nips. 2017.he20momentum— Kaiming He and Haoqi Fan and Yuxin Wu and Saining Xie and Ross B. Girshick. Momentum Contrast for Unsupervised Visual Representation Learning. cvpr. 2020.faugeras90motion— Olivier D. Faugeras and Stephen J. Maybank. Motion from point matches: Multiplicity of solutions. ijcv. 1990.oliensis00a-critique— Oliensis, John. A critique of structure-from-motion algorithms. cviu. 2000.hartley04multiple— Richard Hartley and Andrew Zisserman. Multiple View Geometry in Computer Vision. 2004.ozyesil17a-survey— Onur \"Ozyesil and V. Voroninski and R. Basri and Amit Singer. A survey of structure from motion. Acta Numerica. 2017.agarwal11building— Agarwal, Sameer and Furukawa, Yasutaka and Snavely, Noah and Simon, Ian and Curless, Brian and Seitz, Steven M and Szeliski, Richard. Building rome in a day. Communications of the ACM. 2011.frahm10building— Frahm, Jan-Michael and Fite-Georgel, Pierre and Gallup, David and Johnson, Tim and Raguram, Rahul and Wu, Changchang and Jen, Yi-Hung and Dunn, Enrique and Clipp, Brian and Lazebnik, Svetlana and others. Building Rome on a cloudless day. eccv. 2010.liu24robust— Liu, Shaohui and Gao, Yidan and Zhang, Tianyi and Pautrat, R\'emi and Sch\"onberger, Johannes L and Larsson, Viktor and Pollefeys, Marc. Robust Incremental Structure-from-Motion with Hybrid Features. eccv. 2024.dellaert12factor— Dellaert, Frank. Factor Graphs and GTSAM: A Hands-on Introduction. 2012. https://gtsam.org/tutorials/intro.htmlyi16lift:— Kwang Moo Yi and Eduard Trulls and Vincent Lepetit and Pascal Fua. LIFT: Learned Invariant Feature Transform. eccv. 2016.daniel18superpoint:— Daniel DeTone and Tomasz Malisiewicz and Andrew Rabinovich. SuperPoint: Self-Supervised Interest Point Detection and Description. Proc. CVPR Workshop. 2018.dusmanu19d2-net:— Mihai Dusmanu and Ignacio Rocco and Tomas Pajdla and Marc Pollefeys and Josef Sivic and Akihiko Torii and Torsten Sattler. D2-Net: A Trainable CNN for Joint Description and Detection of Local Features. cvpr. 2019.tyszkiewicz20disk:— MJ Tyszkiewicz and P Fua and E Trulls. DISK: Learning local features with policy gradient. nips. 2020.sarlin20superglue:— Paul-Edouard Sarlin and Daniel DeTone and Tomasz Malisiewicz and Andrew Rabinovich. SuperGlue: Learning Feature Matching With Graph Neural Networks. cvpr. 2020.chen21learning— Hongkai Chen and Zixin Luo and Jiahui Zhang and Lei Zhou and Xuyang Bai and Zeyu Hu and Chiew-Lan Tai and Long Quan. Learning to Match Features with Seeded Graph Matching Network. cvpr. 2021.shi22clustergnn:— Yan Shi and Jun-Xiong Cai and Yoli Shavit and Tai-Jiang Mu and Wensen Feng and Kai Zhang. ClusterGNN: Cluster-based Coarse-to-Fine Graph Neural Network for Efficient Feature Matching. cvpr. 2022.lindenberger23lightglue:— Philipp Lindenberger and Paul-Edouard Sarlin and Marc Pollefeys. LightGlue: Local Feature Matching at Light Speed. iccv. 2023.zhou17unsupervised— Tinghui Zhou and Matthew Brown and Noah Snavely and David G. Lowe. Unsupervised Learning of Depth and Ego-Motion from Video. cvpr. 2017.ummenhofer17demon:— Benjamin Ummenhofer and Huizhong Zhou and Jonas Uhrig and Nikolaus Mayer and Eddy Ilg and Alexey Dosovitskiy and Thomas Brox. DeMoN: Depth and Motion Network for Learning Monocular Stereo. cvpr. 2017.tang19ba-net:— Tang, Chengzhou and Tan, Ping. BA-Net: Dense bundle adjustment network. iclr. 2019.wei20deepsfm:— Xingkui Wei and Yinda Zhang and Zhuwen Li and Yanwei Fu and Xiangyang Xue. DeepSFM: Structure From Motion Via Deep Bundle Adjustment. eccv. 2020.wang21deep— Jianyuan Wang and Yiran Zhong and Yuchao Dai and Stan Birchfield and Kaihao Zhang and Nikolai Smolyanskiy and Hongdong Li. Deep Two-View Structure-From-Motion Revisited. cvpr. 2021.teed20deepv2d:— Zachary Teed and Jia Deng. DeepV2D: Video to Depth with Differentiable Structure from Motion. iclr. 2020.teed21droid-slam:— Zachary Teed and Jia Deng. DROID-SLAM: Deep Visual SLAM for Monocular, Stereo, and RGB-D Cameras. nips. 2021.brachmann24scene— Brachmann, Eric and Wynn, Jamie and Chen, Shuai and Cavallari, Tommaso and Monszpart, \'Aron and Turmukhambetov, Daniyar and Prisacariu, Victor Adrian. Scene Coordinate Reconstruction: Posing of Image Collections via Incremental Learning of a Relocalizer. eccv. 2024.wang23posediffusion:— Jianyuan Wang and Christian Rupprecht and David Novotny. PoseDiffusion: Solving Pose Estimation via Diffusion-aided Bundle Adjustment. iccv. 2023.wang24vggsfm:— Jianyuan Wang and Nikita Karaev and Christian Rupprecht and David Novotny. VGGSfM: Visual Geometry Grounded Deep Structure From Motion. cvpr. 2024.duisterhof25mast3r-sfm:— Bardienus Duisterhof and Lojze Zust and Philippe Weinzaepfel and Vincent Leroy and Yohann Cabon and Jerome Revaud. MASt3R-SfM: a Fully-Integrated Solution for Unconstrained Structure-from-Motion. threedv. 2025.niemeyer20differentiable— Niemeyer, Michael and Mescheder, Lars and Oechsle, Michael and Geiger, Andreas. Differentiable volumetric rendering: Learning implicit 3D representations without 3D supervision. cvpr. 2020.fu22geo-neus:— Qiancheng Fu and Qingshan Xu and Yew Soon Ong and Wenbing Tao. Geo-Neus: Geometry-Consistent Neural Implicit Surfaces Learning for Multi-view Reconstruction. nips. 2022.wei21nerfingmvs:— Wei, Yi and Liu, Shaohui and Rao, Yongming and Zhao, Wang and Lu, Jiwen and Zhou, Jie. NerfingMVS: Guided Optimization of Neural Radiance Fields for Indoor Multi-View Stereo. iccv. 2021.yariv20multiview— Lior Yariv and Yoni Kasten and Dror Moran and Meirav Galun and Matan Atzmon and Ronen Basri and Yaron Lipman. Multiview Neural Surface Reconstruction by Disentangling Geometry and Appearance. nips. 2020.yao18mvsnet:— Yao Yao and Zixin Luo and Shiwei Li and Tian Fang and Long Quan. MVSNet: Depth Inference for Unstructured Multi-view Stereo. eccv. 2018.gu20cascade— Gu, Xiaodong and Fan, Zhiwen and Zhu, Siyu and Dai, Zuozhuo and Tan, Feitong and Tan, Ping. Cascade cost volume for high-resolution multi-view stereo and stereo matching. cvpr. 2020.ma22multiview— Ma, Zeyu and Teed, Zachary and Deng, Jia. Multiview Stereo with Cascaded Epipolar RAFT. eccv. 2022.peng22rethinking— Rui Peng and Rongjie Wang and Zhenyu Wang and Yawen Lai and Ronggang Wang. Rethinking Depth Estimation for Multi-View Stereo: A Unified Representation. cvpr. 2022.zhang23geomvsnet:— Zhe Zhang and Rui Peng and Yuxi Hu and Ronggang Wang. GeoMVSNet: Learning Multi-View Stereo with Geometry Perception. cvpr. 2023.wang24spann3r:— Wang, Hengyi and Agapito, Lourdes. Spann3R: 3D Reconstruction with Spatial Memory. threedv. 2024.wang25continuous— Qianqian Wang and Yifei Zhang and Aleksander Holynski and Alexei A. Efros and Angjoo Kanazawa. Continuous 3D Perception Model with Persistent State. cvpr. 2025.tang25mv-dust3r:— Zhenggang Tang and Yuchen Fan and Dilin Wang and Hongyu Xu and Rakesh Ranjan and Alexander Schwing and Zhicheng Yan. MV-DUSt3R+: Single-Stage Scene Reconstruction from Sparse Views In 2 Seconds. cvpr. 2025.wu25point3r:— Yuqi Wu and Wenzhao Zheng and Jie Zhou and Jiwen Lu. Point3R: Streaming 3D Reconstruction with Explicit Spatial Pointer Memory. nips. 2025.zhang25flare:— Shangzhan Zhang and Jianyuan Wang and Yinghao Xu and Nan Xue and Christian Rupprecht and Xiaowei Zhou and Yujun Shen and Gordon Wetzstein. FLARE: Feed-forward Geometry, Appearance and Camera Estimation from Uncalibrated Sparse Views. cvpr. 2025.yang25fast3r:— Yang, Jianing and Sax, Alexander and Liang, Kevin J and Henaff, Mikael and Tang, Hao and Cao, Ang and Chai, Joyce and Meier, Franziska and Feiszli, Matt. Fast3R: Towards 3D Reconstruction of 1000+ Images in One Forward Pass. cvpr. 2025.elflein25light3r-sfm:— Sven Elflein and Qunjie Zhou and Laura Leal-Taix\'e. Light3R-SfM: Towards Feed-forward Structure-from-Motion. cvpr. 2025.keetha26mapanything:— Nikhil Keetha and Norman M\"uller and Johannes Sch\"onberger and Lorenzo Porzi and Yuchen Zhang and Tobias Fischer and Arno Knapitsch and Duncan Zauss and Ethan Weber and Nelson Antunes and Jonathon Luiten and Manuel Lopez-Antequera and Samuel Rota Bul`o and Christian Richardt and Deva Ramanan and Sebastian Scherer and Peter Kontschieder. MapAnything: Universal Feed-Forward Metric 3D Reconstruction. threedv. 2026.xiao25spatialtrackerv2:— Xiao, Yuxi and Wang, Jianyuan and Xue, Nan and Karaev, Nikita and Makarov, Yuri and Kang, Bingyi and Zhu, Xing and Bao, Hujun and Shen, Yujun and Zhou, Xiaowei. SpatialTrackerV2: 3D Point Tracking Made Easy. iccv. 2025.chen25ttt3r:— Chen, Xingyu and Chen, Yue and Xiu, Yuliang and Geiger, Andreas and Chen, Anpei. TTT3R: 3D Reconstruction as Test-Time Training. arxiv. 2025.deng25vggt-long:— Deng, Kai and Ti, Zexin and Xu, Jiawei and Yang, Jian and Xie, Jin. VGGT-Long: Chunk it, Loop it, Align it---Pushing VGGT's Limits on Kilometer-scale Long RGB Sequences. arxiv. 2025.lan26stream3r:— Lan, Yushi and Luo, Yihang and Hong, Fangzhou and Zhou, Shangchen and Chen, Honghua and Lyu, Zhaoyang and Yang, Shuai and Dai, Bo and Loy, Chen Change and Pan, Xingang. STream3R: Scalable Sequential 3D Reconstruction with Causal Transformer. iclr. 2026.maggio25vggt-slam:— Maggio, Dominic and Lim, Hyungtae and Carlone, Luca. VGGT-SLAM: Dense RGB SLAM Optimized on the \(SL(4)\) Manifold. nips. 2025.li25wint3r:— Li, Zizun and Zhou, Jianjun and Wang, Yifan and Guo, Haoyu and Chang, Wenzheng and Zhou, Yang and Zhu, Haoyi and Chen, Junyi and Shen, Chunhua and He, Tong. WinT3R: Window-Based Streaming Reconstruction with Camera Token Pool. iclr. 2025.huang25longsplat:— Huang, Guichen and Wang, Ruoyu and Gao, Xiangjun and Sun, Che and Wu, Yuwei and Gao, Shenghua and Jia, Yunde. LongSplat: Online Generalizable 3D Gaussian Splatting from Long Sequence Images. iccv. 2025.yuan25test3r:— Yuan, Yuheng and Shen, Qiuhong and Wang, Shizun and Yang, Xingyi and Wang, Xinchao. Test3R: Learning to Reconstruct 3D at Test Time. nips. 2025.deng26sail-recon:— Deng, Junyuan and Li, Heng and Xie, Tao and Ren, Weiqiang and Zhang, Qian and Tan, Ping and Guo, Xiaoyang. SAIL-Recon: Large SfM by Augmenting Scene Regression with Localization. threedv. 2026.jiang25anysplat:— Lihan Jiang and Yucheng Mao and Linning Xu and Tao Lu and Kerui Ren and Yichen Jin and Xudong Xu and Mulin Yu and Jiangmiao Pang and Feng Zhao and Dahua Lin and Bo Dai. AnySplat: Feed-forward 3D Gaussian Splatting from Unconstrained Views. arxiv. 2025.cabon25must3r:— Cabon, Yohann and Stoffl, Lucas and Antsfeld, Leonid and Csurka, Gabriela and Chidlovskii, Boris and Revaud, Jerome and Leroy, Vincent. MUSt3R: Multi-view Network for Stereo 3D Reconstruction. cvpr. 2025.liu25plana3r:— Liu, Changkun and Tan, Bin and Ke, Zeran and Zhang, Shangzhan and Liu, Jiachen and Qian, Ming and Xue, Nan and Shen, Yujun and Braud, Tristan. PLANA3R: Zero-shot Metric Planar 3D Reconstruction via Feed-Forward Planar Splatting. arxiv. 2025.li25rig3r:— Li, Samuel and Kachana, Pujith and Chidananda, Prajwal and Nair, Saurabh and Furukawa, Yasutaka and Brown, Matthew. Rig3R: Rig-Aware Conditioning for Learned 3D Reconstruction. nips. 2025.zang26robust— Zang, Ying and Han, Yidong and Ding, Chaotao and Hu, Yuanqi and Ji, Deyi and Zhu, Qi and Li, Xuanfu and Ma, Jin and Sun, Lingyun and Chen, Tianrun and Zhu, Lanyun. Robust 4D Visual Geometry Transformer with Uncertainty-Aware Priors. arxiv. 2026.chen26hd-vggt:— Chen, Tianrun and Hu, Yuanqi and Han, Yidong and Xu, Hanjie and Ji, Deyi and Zhu, Qi and Yu, Chunan and Zhang, Xin and Chen, Cheng and Ding, Chaotao and Zang, Ying and Li, Xuanfu and Ma, Jin and Zhu, Lanyun. HD-VGGT: High-Resolution Visual Geometry Transformer. arxiv. 2026.liu26streamcachevggt:— Xuanyi Liu and Chunan Yu and Deyi Ji and Qi Zhu and Lingyun Sun and Xuanfu Li and Jin Ma and Tianrun Chen and Lanyun Zhu. StreamCacheVGGT: Streaming Visual Geometry Transformers with Robust Scoring and Hybrid Cache Compression. arxiv. 2026.zhuo26streaming— Zhuo, Dong and Zheng, Wenzhao and Guo, Jiahe and Wu, Yuqi and Zhou, Jie and Lu, Jiwen. Streaming Visual Geometry Transformer. iclr. 2026.jung26more:— Jung, Dongki and Choi, Jaehoon and Lee, Yonghan and Eum, Sungmin and Kwon, Heesung and Manocha, Dinesh. MoRe: Monocular Geometry Refinement via Graph Optimization for Cross-View Consistency. wacv. 2026.mahdi25evict3r:— Mahdi, Soroush and Ayar, Fardin and Javanmardi, Ehsan and Tsukada, Manabu and Javanmardi, Mahdi. Evict3R: Training-Free Token Eviction for Memory-Bounded Streaming Visual Geometry Transformers. arxiv. 2025.wang26lidar-vggt:— Wang, Lijie and Guo, Lianjie and Xu, Ziyi and Wang, Qianhao and Gao, Fei and Chen, Xieyuanli. LiDAR-VGGT: Cross-Modal Coarse-to-Fine Fusion for Globally Consistent and Metric-Scale Dense Mapping. IEEE Robotics and Automation Letters (RA-L). 2026.qi25fupad:— Qi, Dexin and Tao, Tao and Zhang, Zhihong and Mei, Xuesong. FuPaD: Scalable Pose Estimation by Fusing Patch-Wise VGGT with Dense Bundle Adjustment. Proc. ICIRA. 2025.mazur264d-primitive-mache:— Kirill Mazur and Marwan Taher and Andrew J. Davison. 4D Primitive-M\^ach\'e: Glueing Primitives for Persistent 4D Scene Reconstruction. cvpr. 2026.chen26ttt3r:— Xingyu Chen and Yue Chen and Yuliang Xiu and Andreas Geiger and Anpei Chen. TTT3R: 3D Reconstruction as Test-Time Training. iclr. 2026.jin26zipmap:— Haian Jin and Rundi Wu and Tianyuan Zhang and Ruiqi Gao and Jonathan T. Barron and Noah Snavely and Aleksander Holynski. ZipMap: Linear-Time Stateful 3D Reconstruction via Test-Time Training. cvpr. 2026.zhang26loger:— Junyi Zhang and Charles Herrmann and Junhwa Hur and Chen Sun and Ming-Hsuan Yang and Forrester Cole and Trevor Darrell and Deqing Sun. LoGeR: Long-Context Geometric Reconstruction with Hybrid Memory. arxiv. 2026.chen26geometric— Lin-Zhuo Chen and Jian Gao and Yihang Chen and Ka Leong Cheng and Yipengjing Sun and Liangxiao Hu and Nan Xue and Xing Zhu and Yujun Shen and Yao Yao and Yinghao Xu. Geometric Context Transformer for Streaming 3D Reconstruction. arxiv. 2026.taher25kv-tracker:— Taher, Marwan and Alzugaray, Ignacio and Mazur, Kirill and Kong, Xin and Davison, Andrew J.. KV-Tracker: Real-Time Pose Tracking with Transformers. arxiv. 2025.wang25amb3r:— Hengyi Wang and Lourdes Agapito. AMB3R: Accurate Feed-forward Metric-scale 3D Reconstruction with Backend. arxiv. 2025.fang26dens3r:— Xianze Fang and Jingnan Gao and Zhe Wang and Zhuo Chen and Xingyu Ren and Jiangjing Lyu and Qiaomu Ren and Zhonglei Yang and Xiaokang Yang and Yichao Yan and Chengfei Lyu. Dens3R: A foundation model for 3D geometry prediction. iclr. 2026.gao25more:— Gao, Jingnan and Wang, Zhe and Fang, Xianze and Ren, Xingyu and Chen, Zhuo and Liu, Shengqi and Cheng, Yuhao and Lyu, Jiangjing and Yang, Xiaokang and Yan, Yichao. MoRE: 3D Visual Geometry Reconstruction Meets Mixture-of-Experts. arxiv. 2025.wang26moe3d:— Wang, Zichen and Cao, Ang and Wang, Liam J and Park, Jeong Joon. MoE3D: A Mixture-of-Experts Module for 3D Reconstruction. arxiv. 2026.bratulic25on-geometric— Bratuli\'c, Jelena and Mittal, Sudhanshu and Brox, Thomas and Rupprecht, Christian. On Geometric Understanding and Learned Data Priors in VGGT. arxiv. 2025.huang26self-improving— Huang, Nan and Yu, Pengcheng and Zeng, Weijia and Rehg, James M and Kanazawa, Angjoo and Feng, Haiwen and Wang, Qianqian. Self-Improving 4D Perception via Self-Distillation. arxiv. 2026.liu26camgeo:— Liu, Xuanyi and Ji, Deyi and Liu, Liqun and Zhu, Lanyun and Chen, Xuhang and Xu, Qianxiong and Shu, Peng and Yu, Huan and Jiang, Jie and Gao, Feng and Ma, Siwei. CamGeo: Sparse Camera-Conditioned Image-to-Video Generation with 3D Geometry Priors. icml. 2026.deng25unipr-3d:— Tianchen Deng and Xun Chen and Ziming Li and Hongming Shen and Danwei Wang and Javier Civera and Hesheng Wang. UniPR-3D: Towards Universal Visual Place Recognition with Visual Geometry Grounded Transformer. arxiv. 2025.bregler00recovering— Christoph Bregler and Aaron Hertzmann and Henning Biermann. Recovering Non-Rigid 3D Shape from Image Streams. cvpr. 2000.torresani08nonrigid— Torresani, Lorenzo and Hertzmann, Aaron and Bregler, Chris. Nonrigid structure-from-motion: Estimating shape and motion with hierarchical priors. tpami. 2008.li25megasam:— Zhengqi Li and Richard Tucker and Forrester Cole and Qianqian Wang and Linyi Jin and Vickie Ye and Angjoo Kanazawa and Aleksander Holynski and Noah Snavely. MegaSaM: Accurate, Fast and Robust Structure and Motion from Casual Dynamic Videos. Computer Vision and Pattern Recognition (CVPR). 2025.huang25vipe:— Jiahui Huang and Qunjie Zhou and Hesam Rabeti and Aleksandr Korovko and Huan Ling and Xuanchi Ren and Tianchang Shen and Jun Gao and Dmitry Slepichev and Chen-Hsuan Lin and Jiawei Ren and Kevin Xie and Joydeep Biswas and Laura Leal-Taixe and Sanja Fidler. ViPE: Video Pose Engine for 3D Geometric Perception. arxiv. 2025.zhang24monst3r:— Junyi Zhang and Charles Herrmann and Junhwa Hur and Varun Jampani and Trevor Darrell and Forrester Cole and Deqing Sun and Ming-Hsuan Yang. MonST3R: A Simple Approach for Estimating Geometry in the Presence of Motion. arxiv. 2024.han25d2ust3r:— Jisang Han and Honggyu An and Jaewoo Jung and Takuya Narihira and Junyoung Seo and Kazumi Fukuda and Chaehyun Kim and Sunghwan Hong and Yuki Mitsufuji and Seungryong Kim. D\(^2\)USt3R: Enhancing 3D Reconstruction with 4D Pointmaps for Dynamic Scenes. arxiv. 2025.lu25align3r:— Jiahao Lu and Tianyu Huang and Peng Li and Zhiyang Dou and Cheng Lin and Zhiming Cui and Zhen Dong and Sai-Kit Yeung and Wenping Wang and Yuan Liu. Align3R: Aligned Monocular Depth Estimation for Dynamic Videos. cvpr. 2025.jiang25geo4d— Zeren Jiang and Chuanxia Zheng and Iro Laina and Diane Larlus and Andrea Vedaldi. Geo4D: Leveraging Video Generators for Geometric 4D Scene Reconstruction. iccv. 2025.zhou25page-4d:— Kaichen Zhou and Yuhan Wang and Grace Chen and Xinhai Chang and Gaspard Beaudouin and Fangneng Zhan and Paul Pu Liang and Mengyu Wang. PAGE-4D: Disentangled Pose and Geometry Estimation for 4D Perception. arXiv. 2025.chen25human3r:— Chen, Yue and Chen, Xingyu and Xue, Yuxuan and Chen, Anpei and Xiu, Yuliang and Pons-Moll, Gerard. Human3R: Everyone Everywhere All at Once. arxiv. 2025.feng25st4rtrack:— Haiwen Feng and Junyi Zhang and Qianqian Wang and Yufei Ye and Pengcheng Yu and Michael J. Black and Trevor Darrell and Angjoo Kanazawa. St4RTrack: Simultaneous 4D Reconstruction and Tracking in the World. iccv. 2025.sucar25dynamic— Edgar Sucar and Zihang Lai and Eldar Insafutdinov and Andrea Vedaldi. Dynamic Point Maps: A Versatile Representation for Dynamic 3D Reconstruction. iccv. 2025.sucar26v-dpm— Edgar Sucar and Eldar Insafutdinov and Zihang Lai and Andrea Vedaldi. V-DPM: Video Reconstruction with Dynamic Point Maps. cvpr. 2026.yao25uni4d:— David Yifan Yao and Albert J. Zhai and Shenlong Wang. Uni4D: Unifying Visual Foundation Models for 4D Modeling from a Single Video. arxiv. 2025.karhade2025any4d— Karhade, Jay and Keetha, Nikhil and Zhang, Yuchen and Gupta, Tanisha and Sharma, Akash and Scherer, Sebastian and Ramanan, Deva. Any4D: Unified feed-forward metric 4d reconstruction. arXiv preprint arXiv:2512.10935. 2025.zhang25efficiently— Chuhan Zhang and Guillaume Le Moing and Skanda Koppula and Ignacio Rocco and Liliane Momeni and Junyu Xie and Shuyang Sun and Rahul Sukthankar and Jo\"elle K. Barral and Raia Hadsell and Zoubin Ghahramani and Andrew Zisserman and Junlin Zhang and Mehdi S. M. Sajjadi. Efficiently Reconstructing Dynamic Scenes One D4RT at a Time. arxiv. 2025.shi26vision— Cheng Shi and Yizhou Yu and Sibei Yang. Vision Transformers Need More Than Registers. arxiv. 2026.lappe25register— Lappe, Alexander and Giese, Martin A. Register and [CLS] tokens induce a decoupling of local and global features in large ViTs. nips. 2025.ranftl21vision— Ren\'e Ranftl and Alexey Bochkovskiy and Vladlen Koltun. Vision Transformers for Dense Prediction. iccv. 2021.dai14a-simple— Dai, Yuchao and Li, Hongdong and He, Mingyi. A Simple Prior-Free Method for Non-rigid Structure-from-Motion Factorization. ijcv. 2014.taylor10non-rigid— Taylor, Jonathan and Jepson, Allan D and Kutulakos, Kiriakos N. Non-rigid structure from locally-rigid motion. cvpr. 2010.pan23aria— Pan, Xiaqing and Charron, Nicholas and Yang, Yongqian and Peters, Scott and Whelan, Thomas and Kong, Chen and Parkhi, Omkar and Newcombe, Richard and Ren, Yuheng (Carl). Aria Digital Twin: A New Benchmark Dataset for Egocentric 3D Machine Perception. iccv. 2023.black23bedlam:— Michael J. Black and Priyanka Patel and Joachim Tesch and Jinlong Yang. BEDLAM: A Synthetic Dataset of Bodies Exhibiting Detailed Lifelike Animated Motion. cvpr. 2023.li24behavior-1k:— Chengshu Li and Ruohan Zhang and Josiah Wong and Cem Gokmen and Sanjana Srivastava and Roberto Mart\'-Mart\' and Chen Wang and Gabrael Levine and Wensi Ai and Benjamin Martinez and Hang Yin and Michael Lingelbach and Minjune Hwang and Ayano Hiranaka and Sujay Garlanka and Arman Aydin and Sharon Lee and Jiankai Sun and Mona Anvari and Manasi Sharma and Dhruva Bansal and Samuel Hunter and Kyu-Young Kim and Alan Lou and Caleb R Matthews and Ivan Villa-Renteria and Jerry Huayang Tang and Claire Tang and Fei Xia and Yunzhu Li and Silvio Savarese and Hyowon Gweon and C. Karen Liu and Jiajun Wu and Li Fei-Fei. BEHAVIOR-1K: A Human-Centered, Embodied AI Benchmark with 1,000 Everyday Activities and Realistic Simulation. arxiv. 2024.reizenstein21common— Jeremy Reizenstein and Roman Shapovalov and Philipp Henzler and Luca Sbordone and Patrick Labatut and David Novotny. Common Objects in 3D: Large-Scale Learning and Evaluation of Real-life 3D Category Reconstruction. iccv. 2021.liu25uco3d— Xingchen Liu and Piyush Tayal and Jianyuan Wang and Jesus Zarzar and Tom Monnier and Konstantinos Tertikas and Jiali Duan and Antoine Toisoul and Jason Y. Zhang and Natalia Neverova and Andrea Vedaldi and Roman Shapovalov and David Novotny. uCO3D UnCommon Objects in 3D. cvpr. 2025.ling23dl3dv-10k:— Lu Ling and Yichen Sheng and Zhi Tu and Wentian Zhao and Cheng Xin and Kun Wan and Lantao Yu and Qianyu Guo and Zixun Yu and Yawen Lu and Xuanmao Li and Xingpeng Sun and Rohan Ashok and Aniruddha Mukherjee and Hao Kang and Xiangrui Kong and Gang Hua and Tianyi Zhang and Bedrich Benes and Aniket Bera. DL3DV-10K: A Large-Scale Scene Dataset for Deep Learning-based 3D Vision. cvpr. 2024.karaev23dynamicstereo— Nikita Karaev and Ignacio Rocco and Benjamin Graham and Natalia Neverova and Andrea Vedaldi and Christian Rupprecht. DynamicStereo: Consistent Dynamic Depth from Stereo Videos. cvpr. 2023.le21eden:— Le, Hoang-An and Mensink, Thomas and Das, Partha and Karaoglu, Sezer and Gevers, Theo. Eden: Multimodal synthetic dataset of enclosed garden scenes. wacv. 2021.straub24efm3d:— Straub, Julian and DeTone, Daniel and Shen, Tianwei and Yang, Nan and Sweeney, Chris and Newcombe, Richard. EFM3D: A benchmark for measuring progress towards 3D egocentric foundation models. arxiv. 2024.banerjee24introducing— Prithviraj Banerjee and Sindi Shkodrani and Pierre Moulon and Shreyas Hampali and Fan Zhang and Jade Fountain and Edward Miller and Selen Basol and Richard Newcombe and Robert Wang and Jakob Julian Engel and Tomas Hodan. Introducing HOT3D: An Egocentric Dataset for 3D Hand and Object Tracking. arxiv. 2024.habitat19iccv— Manolis Savva and Abhishek Kadian and Oleksandr Maksymets and Yili Zhao and Erik Wijmans and Bhavana Jain and Julian Straub and Jia Liu and Vladlen Koltun and Jitendra Malik and Devi Parikh and Dhruv Batra. Habitat: A Platform for Embodied AI Research. iccv. 2019.roberts21hypersim:— Mike Roberts and Jason Ramapuram and Anurag Ranjan and Atulit Kumar and Miguel Angel Bautista and Nathan Paczan and Russ Webb and Joshua M. Susskind. Hypersim: A Photorealistic Synthetic Dataset for Holistic Indoor Scene Understanding. iccv. 2021.arnold22map-free— Arnold, Eduardo and Wynn, Jamie and Vicente, Sara and Garcia-Hernando, Guillermo and Monszpart, Aron and Prisacariu, Victor and Turmukhambetov, Daniyar and Brachmann, Eric. Map-free visual relocalization: Metric pose relative to a single image. eccv. 2022.mapillary25metropolis— Mapillary. Metropolis Dataset. 2025. https://www.mapillary.com/dataset/metropolisantequera20mapillary— Manuel L\'opez Antequera and Pau Gargallo and Markus Hofinger and Samuel Rota Bul`o and Yubin Kuang and Peter Kontschieder. Mapillary Planet-Scale Depth Dataset. eccv. 2020.li18megadepth:— Li, Zhengqi and Snavely, Noah. MegaDepth: Learning single-view depth prediction from internet photos. cvpr. 2018.jiang25megasynth:— Hanwen Jiang and Zexiang Xu and Desai Xie and Ziwen Chen and Haian Jin and Fujun Luan and Zhixin Shu and Kai Zhang and Sai Bi and Xin Sun and Jiuxiang Gu and Qixing Huang and Georgios Pavlakos and Hao Tan. MegaSynth: Scaling up 3D scene reconstruction with synthesized data. cvpr. 2025.fonder19mid-air:— Michael Fonder and Marc Van Droogenbroeck. Mid-Air: A multi-modal dataset for extremely low altitude drone flights. Proc. CVPR Workshop. 2019.huang18deepmvs:— Huang, Po-Han and Matzen, Kevin and Kopf, Johannes and Ahuja, Narendra and Huang, Jia-Bin. DeepMVS: Learning Multi-View Stereopsis. cvpr. 2018.hoorick24generative— Basile Van Hoorick and Rundi Wu and Ege Ozguroglu and Kyle Sargent and Ruoshi Liu and Pavel Tokmakov and Achal Dave and Changxi Zheng and Carl Vondrick. Generative Camera Dolly: Extreme Monocular Dynamic Novel View Synthesis. arXiv. 2024.straub19the-replica— Julian Straub and Thomas Whelan and Lingni Ma and Yufan Chen and Erik Wijmans and Simon Green and Jakob J. Engel and Raul Mur-Artal and Carl Yuheng Ren and Shobhit Verma and Anton Clarkson and Mingfei Yan and Brian Budge and Yajie Yan and Xiaqing Pan and June Yon and Yuyang Zou and Kimberly Leon and Nigel Carter and Jesus Briales and Tyler Gillingham and Elias Mueggler and Luis Pesqueira and Manolis Savva and Dhruv Batra and Hauke M. Strasdat and Renzo De Nardi and Michael Goesele and Steven Lovegrove and Richard A. Newcombe. The Replica dataset: A digital replica of indoor spaces. arxiv. 2019.hu21sail-vos— Hu, Yuan-Ting and Wang, Jiahong and Yeh, Raymond A and Schwing, Alexander G. SAIL-VOS 3D: A synthetic dataset and baselines for object detection and 3D mesh reconstruction from video data. cvpr. 2021.dai17scannet:— Dai, Angela and Chang, Angel X and Savva, Manolis and Halber, Maciej and Funkhouser, Thomas and Nie, Matthias. ScanNet: Richly-annotated 3D reconstructions of indoor scenes. cvpr. 2017.yeshwanth23scannet:— Chandan Yeshwanth and Yueh-Cheng Liu and Matthias Nie and Angela Dai. ScanNet++: A High-Fidelity Dataset of 3D Indoor Scenes. IEEE International Conference on Computer Vision (ICCV). 2023.wang20tartanair:— Wang, Wenshan and Zhu, Delong and Wang, Xiangwei and Hu, Yaoyu and Qiu, Yuheng and Wang, Chen and Hu, Yafei and Kapoor, Ashish and Scherer, Sebastian. TartanAir: A Dataset to Push the Limits of Visual SLAM. iros. 2020.patel25tartanground:— Patel, Manthan and Yang, Fan and Qiu, Yuheng and Cadena, Cesar and Scherer, Sebastian and Hutter, Marco and Wang, Wenshan. TartanGround: A large-scale dataset for ground robot perception and navigation. iros. 2025.zamir18taskonomy:— Amir Roshan Zamir and Alexander Sax and William B. Shen and Leonidas J. Guibas and Jitendra Malik and Silvio Savarese. Taskonomy: Disentangling Task Transfer Learning. cvpr. 2018.tosi21smd-nets:— Tosi, Fabio and Liao, Yiyi and Schmitt, Carolin and Geiger, Andreas. SMD-Nets: Stereo mixture density networks. cvpr. 2021.cabon20virtual— Cabon, Yohann and Murray, Naila and Humenberger, Martin. Virtual KITTI 2. arxiv. 2020.sun20scalability— Pei Sun and Henrik Kretzschmar and Xerxes Dotiwalla and Aurelien Chouard and Vijaysai Patnaik and Paul Tsui and James Guo and Yin Zhou and Yuning Chai and Benjamin Caine and Vijay Vasudevan and Wei Han and Jiquan Ngiam and Hang Zhao and Aleksei Timofeev and Scott Ettinger and Maxim Krivokon and Amy Gao and Aditya Joshi and Yu Zhang and Jonathon Shlens and Zhifeng Chen and Dragomir Anguelov. Scalability in Perception for Autonomous Driving: Waymo Open Dataset. cvpr. 2020.xia24rgbd— Hongchi Xia and Yang Fu and Sifei Liu and Xiaolong Wang. RGBD Objects in the Wild: Scaling Real-World 3D Object Learning from RGB-D Videos. cvpr. 2024.greff22kubric:— Klaus Greff and Francois Belletti and Lucas Beyer and Carl Doersch and Yilun Du and Daniel Duckworth and David J Fleet and Dan Gnanapragasam and Florian Golemo and Charles Herrmann and Thomas Kipf and Abhijit Kundu and Dmitry Lagun and Issam Laradji and Hsueh-Ti (Derek) Liu and Henning Meyer and Yishu Miao and Derek Nowrouzezahrai and Cengiz Oztireli and Etienne Pot and Noha Radwan and Daniel Rebain and Sara Sabour and Mehdi S. M. Sajjadi and Matan Sela and Vincent Sitzmann and Austin Stone and Deqing Sun and Suhani Vora and Ziyu Wang and Tianhao Wu and Kwang Moo Yi and Fangcheng Zhong and Andrea Tagliasacchi. Kubric: a scalable dataset generator. cvpr. 2022.zheng23pointodyssey:— Zheng, Yang and Harley, Adam W and Shen, Bokui and Wetzstein, Gordon and Guibas, Leonidas J. PointOdyssey: A large-scale synthetic dataset for long-term point tracking. cvpr. 2023.liu24grounding— Shilong Liu and Zhaoyang Zeng and Tianhe Ren and Feng Li and Hao Zhang and Jie Yang and Qing Jiang and Chunyuan Li and Jianwei Yang and Hang Su and Jun Zhu and Lei Zhang. Grounding DINO: Marrying DINO with Grounded Pre-Training for Open-Set Object Detection. eccv. 2024.lowe99object— David G. Lowe. Object Recognition from Local Scale-Invariant Features. iccv. 1999.zhao23aliked:— Zhao, Xiaoming and Wu, Xingming and Chen, Weihai and Chen, Peter CY and Xu, Qingsong and Li, Zhengguo. ALIKED: A Lighter Keypoint and Descriptor Extraction Network via Deformable Transformation. IEEE Trans. on Instrumentation and Measurement. 2023.schonberger16pixelwise— Sch\"onberger, Johannes Lutz and Zheng, Enliang and Pollefeys, Marc and Frahm, Jan-Michael. Pixelwise View Selection for Unstructured Multi-View Stereo. eccv. 2016.chen16xgboost:— Chen, Tianqi and Guestrin, Carlos. Xgboost: A scalable tree boosting system. Proc. Knowledge Discovery and Data Mining. 2016.breiman01random— Leo Breiman. Random Forests. Machine learning. 2001.prokhorenkova18catboost:— Prokhorenkova, Liudmila and Gusev, Gleb and Vorobev, Aleksandr and Dorogush, Anna Veronika and Gulin, Andrey. CatBoost: unbiased boosting with categorical features. nips. 2018.shotton13scene— Shotton, Jamie and Glocker, Ben and Zach, Christopher and Izadi, Shahram and Criminisi, Antonio and Fitzgibbon, Andrew. Scene coordinate regression forests for camera relocalization in RGB-D images. cvpr. 2013.azinovic22neural— Azinovi\'c, Dejan and Martin-Brualla, Ricardo and Goldman, Dan B and Nie, Matthias and Thies, Justus. Neural RGB-D surface reconstruction. cvpr. 2022.schops17a-multi-view— Schops, Thomas and Schonberger, Johannes L and Galliani, Silvano and Sattler, Torsten and Schindler, Konrad and Pollefeys, Marc and Geiger, Andreas. A multi-view stereo benchmark with high-resolution images and multi-camera videos. cvpr. 2017.gao22monocular— Hang Gao and Ruilong Li and Shubham Tulsiani and Bryan Russell and Angjoo Kanazawa. Monocular Dynamic View Synthesis: A Reality Check. nips. 2022.butler12a-naturalistic— Daniel J. Butler and Jonas Wulff and Garrett B. Stanley and Michael J. Black. A Naturalistic Open Source Movie for Optical Flow Evaluation. eccv. 2012.sturm12a-benchmark— J\"urgen Sturm and Nikolas Engelhard and Felix Endres and Wolfram Burgard and Daniel Cremers. A benchmark for the evaluation of RGB-D SLAM systems. iros. 2012.kim25fine-tuning— Moo Jin Kim and Chelsea Finn and Percy Liang. Fine-Tuning Vision-Language-Action Models: Optimizing Speed and Success. rss. 2025.liu23libero:— Liu, Bo and Zhu, Yifeng and Gao, Chongkai and Feng, Yihao and Liu, Qiang and Zhu, Yuke and Stone, Peter. LIBERO: Benchmarking Knowledge Transfer for Lifelong Robot Learning. nips. 2023.radford21learning— Alec Radford and Jong Wook Kim and Chris Hallacy and Aditya Ramesh and Gabriel Goh and Sandhini Agarwal and Girish Sastry and Amanda Askell and Pamela Mishkin and Jack Clark and Gretchen Krueger and Ilya Sutskever. Learning Transferable Visual Models From Natural Language Supervision. icml. 2021.zhai23sigmoid— Zhai, Xiaohua and Mustafa, Basil and Kolesnikov, Alexander and Beyer, Lucas. Sigmoid Loss for Language Image Pre-Training. cvpr. 2023.yang25qwen3— An Yang and Anfeng Li and Baosong Yang and Beichen Zhang and Binyuan Hui and Bo Zheng and Bowen Yu and Chang Gao and Chengen Huang and Chenxu Lv and Chujie Zheng and Dayiheng Liu and Fan Zhou and Fei Huang and Feng Hu and Hao Ge and Haoran Wei and Huan Lin and Jialong Tang and Jian Yang and Jianhong Tu and Jianwei Zhang and Jianxin Yang and Jiaxi Yang and Jing Zhou and Jingren Zhou and Junyang Lin and Kai Dang and Keqin Bao and Kexin Yang and Le Yu and Lianghao Deng and Mei Li and Mingfeng Xue and Mingze Li and Pei Zhang and Peng Wang and Qin Zhu and Rui Men and Ruize Gao and Shixuan Liu and Shuang Luo and Tianhao Li and Tianyi Tang and Wenbiao Yin and Xingzhang Ren and Xinyu Wang and Xinyu Zhang and Xuancheng Ren and Yang Fan and Yang Su and Yichang Zhang and Yinger Zhang and Yu Wan and Yuqiong Liu and Zekun Wang and Zeyu Cui and Zhenru Zhang and Zhipeng Zhou and Zihan Qiu. Qwen3 Technical Report. arxiv. 2025.huh24position:— Huh, Minyoung and Cheung, Brian and Wang, Tongzhou and Isola, Phillip. Position: The Platonic Representation Hypothesis. icml. 2024.han25learning— Han, Junlin and Tong, Shengbang and Fan, David and Ren, Yufan and Sinha, Koustuv and Torr, Philip and Kokkinos, Filippos. Learning to see before seeing: Demystifying llm visual priors from language pre-training. Proc. NeurIPS Workshop. 2025.wortsman22model— Mitchell Wortsman and Gabriel Ilharco and Samir Yitzhak Gadre and Rebecca Roelofs and Raphael Gontijo Lopes and Ari S. Morcos and Hongseok Namkoong and Ali Farhadi and Yair Carmon and Simon Kornblith and Ludwig Schmidt. Model soups: averaging weights of multiple fine-tuned models improves accuracy without increasing inference time. icml. 2022.geva21transformer— Geva, Mor and Schuster, Roei and Berant, Jonathan and Levy, Omer. Transformer feed-forward layers are key-value memories. Proc. Empirical Methods in Natural Language Processing. 2021.dai22knowledge— Dai, Damai and Dong, Li and Hao, Yaru and Sui, Zhifang and Chang, Baobao and Wei, Furu. Knowledge neurons in pretrained transformers. Proc. ACL. 2022.meng22locating— Meng, Kevin and Bau, David and Andonian, Alex and Belinkov, Yonatan. Locating and editing factual associations in GPT. nips. 2022.wang24moge:— Ruicheng Wang and Sicheng Xu and Cassie Dai and Jianfeng Xiang and Yu Deng and Xin Tong and Jiaolong Yang. MoGe: Unlocking Accurate Monocular Geometry Estimation for Open-Domain Images with Optimal Training Supervision. arxiv. 2024.huang2026self— Huang, Nan and Yu, Pengcheng and Zeng, Weijia and Rehg, James M and Kanazawa, Angjoo and Feng, Haiwen and Wang, Qianqian. Self-Improving 4D Perception via Self-Distillation. arXiv preprint arXiv:2604.08532. 2026.jiang25rayzer:— Hanwen Jiang and Hao Tan and Peng Wang and Haian Jin and Yue Zhao and Sai Bi and Kai Zhang and Fujun Luan and Kalyan Sunkavalli and Qixing Huang and Georgios Pavlakos. RayZer: A Self-supervised Large View Synthesis Model. iccv. 2025.zhao26e-rayzer:— Qitao Zhao and Hao Tan and Qianqian Wang and Sai Bi and Kai Zhang and Kalyan Sunkavalli and Shubham Tulsiani and Hanwen Jiang. E-RayZer: Self-supervised 3D Reconstruction as Spatial Visual Pre-training. cvpr. 2026.barron21mip-nerf:— Jonathan T. Barron and Ben Mildenhall and Matthew Tancik and Peter Hedman and Ricardo Martin-Brualla and Pratul P. Srinivasan. Mip-NeRF: A Multiscale Representation for Anti-Aliasing Neural Radiance Fields. iccv. 2021.kerbl233d-gaussian— Kerbl, Bernhard and Kopanas, Georgios and Leimk\"uhler, Thomas and Drettakis, George. 3D Gaussian Splatting for Real-Time Radiance Field Rendering. siggraph. 2023.li26back— Tianhong Li and Kaiming He. Back to Basics: Let Denoising Generative Models Denoise. arxiv. 2026.simonyan15very— Karen Simonyan and Andrew Zisserman. Very Deep Convolutional Networks for Large-Scale Image Recognition. iclr. 2015.he16deep— Kaiming He and Xiangyu Zhang and Shaoqing Ren and Jian Sun. Deep Residual Learning for Image Recognition. cvpr. 2016.mildenhall20nerf:— Ben Mildenhall and Pratul P. Srinivasan and Matthew Tancik and Jonathan T. Barron and Ravi Ramamoorthi and Ren Ng. NeRF: Representing Scenes as Neural Radiance Fields for View Synthesis. eccv. 2020.chen24spatialvlm:— Chen, Boyuan and Xu, Zhuo and Kirmani, Sean and Ichter, Brain and Sadigh, Dorsa and Guibas, Leonidas and Xia, Fei. SpatialVLM: Endowing Vision-Language Models with Spatial Reasoning Capabilities. cvpr. 2024.cheng24spatialrgpt:— Cheng, An-Chieh and Yin, Hongxu and Fu, Yang and Guo, Qiushan and Yang, Ruihan and Kautz, Jan and Wang, Xiaolong and Liu, Sifei. SpatialRGPT: Grounded Spatial Reasoning in Vision-Language Models. nips. 2024.zitkovich23rt-2:— Brianna Zitkovich and Tianhe Yu and Sichun Xu and Peng Xu and Ted Xiao and Fei Xia and Jialin Wu and Paul Wohlhart and Stefan Welker and Ayzaan Wahid and Quan Vuong and Vincent Vanhoucke and Huong T. Tran and Radu Soricut and Anikait Singh and Jaspiar Singh and Pierre Sermanet and Pannag R. Sanketi and Grecia Salazar and Michael S. Ryoo and Krista Reymann and Kanishka Rao and Karl Pertsch and Igor Mordatch and Henryk Michalewski and Yao Lu and Sergey Levine and Lisa Lee and Tsang-Wei Edward Lee and Isabel Leal and Yuheng Kuang and Dmitry Kalashnikov and Ryan Julian and Nikhil J. Joshi and Alex Irpan and Brian Ichter and Jasmine Hsu and Alexander Herzog and Karol Hausman and Keerthana Gopalakrishnan and Chuyuan Fu and Pete Florence and Chelsea Finn and Kumar Avinava Dubey and Danny Driess and Tianli Ding and Krzysztof Marcin Choromanski and Xi Chen and Yevgen Chebotar and Justice Carbajal and Noah Brown and Anthony Brohan and Montserrat Gonzalez Arenas and Kehang Han. RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control. corl. 2023.cai26depthlm:— Zhipeng Cai and Ching-Feng Yeh and Hu Xu and Zhuang Liu and Gregory Meyer and Xinjie Lei and Changsheng Zhao and Shang-Wen Li and Vikas Chandra and Yangyang Shi. DepthLM: Metric Depth From Vision Language Models. iclr. 2026.kim25openvla:— Moo Jin Kim and Karl Pertsch and Siddharth Karamcheti and Ted Xiao and Ashwin Balakrishna and Suraj Nair and Rafael Rafailov and Ethan Foster and Grace Lam and Pannag Sanketi and Quan Vuong and Thomas Kollar and Benjamin Burchfiel and Russ Tedrake and Dorsa Sadigh and Sergey Levine and Percy Liang and Chelsea Finn. OpenVLA: An Open-Source Vision-Language-Action Model. Proc. CoRL. 2025.team25gemini— Gemini Robotics Team and Saminda Abeyruwan and Joshua Ainslie and Jean-Baptiste Alayrac and Montserrat Gonzalez Arenas and Travis Armstrong and Ashwin Balakrishna and Robert Baruch and Maria Bauza and Michiel Blokzijl and Steven Bohez and Konstantinos Bousmalis and Anthony Brohan and Thomas Buschmann and Arunkumar Byravan and Serkan Cabi and Ken Caluwaerts and Federico Casarini and Oscar Chang and Jose Enrique Chen and Xi Chen and Hao-Tien Lewis Chiang and Krzysztof Choromanski and David D'Ambrosio and Sudeep Dasari and Todor Davchev and Coline Devin and Norman Di Palo and Tianli Ding and Adil Dostmohamed and Danny Driess and Yilun Du and Debidatta Dwibedi and Michael Elabd and Claudio Fantacci and Cody Fong and Erik Frey and Chuyuan Fu and Marissa Giustina and Keerthana Gopalakrishnan and Laura Graesser and Leonard Hasenclever and Nicolas Heess and Brandon Hernaez and Alexander Herzog and R. Alex Hofer and Jan Humplik and Atil Iscen and Mithun George Jacob and Deepali Jain and Ryan Julian and Dmitry Kalashnikov and M. Emre Karagozler and Stefani Karp and Chase Kew and Jerad Kirkland and Sean Kirmani and Yuheng Kuang and Thomas Lampe and Antoine Laurens and Isabel Leal and Alex X. Lee and Tsang-Wei Edward Lee and Jacky Liang and Yixin Lin and Sharath Maddineni and Anirudha Majumdar and Assaf Hurwitz Michaely and Robert Moreno and Michael Neunert and Francesco Nori and Carolina Parada and Emilio Parisotto and Peter Pastor and Acorn Pooley and Kanishka Rao and Krista Reymann and Dorsa Sadigh and Stefano Saliceti and Pannag Sanketi and Pierre Sermanet and Dhruv Shah and Mohit Sharma and Kathryn Shea and Charles Shu and Vikas Sindhwani and Sumeet Singh and Radu Soricut and Jost Tobias Springenberg and Rachel Sterneck and Razvan Surdulescu and Jie Tan and Jonathan Tompson and Vincent Vanhoucke and Jake Varley and Grace Vesom and Giulia Vezzani and Oriol Vinyals and Ayzaan Wahid and Stefan Welker and Paul Wohlhart and Fei Xia and Ted Xiao and Annie Xie and Jinyu Xie and Peng Xu and Sichun Xu and Ying Xu and Zhuo Xu and Yuxiang Yang and Rui Yao and Sergey Yaroshenko and Wenhao Yu and Wentao Yuan and Jingwei Zhang and Tingnan Zhang and Allan Zhou and Yuxiang Zhou. Gemini Robotics: Bringing AI into the Physical World. arxiv. 2025.hu23gaia-1:— Hu, Anthony and Russell, Lloyd and Yeo, Hudson and Murez, Zak and Fedoseev, George and Kendall, Alex and Shotton, Jamie and Corrado, Gianluca. GAIA-1: A Generative World Model for Autonomous Driving. arxiv. 2023.li26causal— Lin Li and Qihang Zhang and Yiming Luo and Shuai Yang and Ruilin Wang and Fei Han and Mingrui Yu and Zelin Gao and Nan Xue and Xing Zhu and Yujun Shen and Yinghao Xu. Causal World Modeling for Robot Control. Robotics: Science and Systems. 2026.parker-holder25genie— Parker-Holder, Jack and Fruchter, Shlomi. Genie 3: A New Frontier for World Models. 2025. https://deepmind.google/blog/genie-3-a-new-frontier-for-world-models/nvidia25cosmos— NVIDIA and Niket Agarwal and Arslan Ali and Maciej Bala and Yogesh Balaji and Erik Barker and Tiffany Cai and Prithvijit Chattopadhyay and Yongxin Chen and Yin Cui and Yifan Ding and Daniel Dworakowski and Jiaojiao Fan and Michele Fenzi and Francesco Ferroni and Sanja Fidler and Dieter Fox and Songwei Ge and Yunhao Ge and Jinwei Gu and Siddharth Gururani and Ethan He and Jiahui Huang and Jacob Huffman and Pooya Jannaty and Jingyi Jin and Seung Wook Kim and Gergely Kl\'ar and Grace Lam and Shiyi Lan and Laura Leal-Taixe and Anqi Li and Zhaoshuo Li and Chen-Hsuan Lin and Tsung-Yi Lin and Huan Ling and Ming-Yu Liu and Xian Liu and Alice Luo and Qianli Ma and Hanzi Mao and Kaichun Mo and Arsalan Mousavian and Seungjun Nah and Sriharsha Niverty and David Page and Despoina Paschalidou and Zeeshan Patel and Lindsey Pavao and Morteza Ramezanali and Fitsum Reda and Xiaowei Ren and Vasanth Rao Naik Sabavat and Ed Schmerling and Stella Shi and Bartosz Stefaniak and Shitao Tang and Lyne Tchapmi and Przemek Tredak and Wei-Cheng Tseng and Jibin Varghese and Hao Wang and Haoxiang Wang and Heng Wang and Ting-Chun Wang and Fangyin Wei and Xinyue Wei and Jay Zhangjie Wu and Jiashu Xu and Wei Yang and Lin Yen-Chen and Xiaohui Zeng and Yu Zeng and Jing Zhang and Qinsheng Zhang and Yuxuan Zhang and Qingqing Zhao and Artur Zolkowski. Cosmos World Foundation Model Platform for Physical AI. arxiv. 2025.wang24emu3:— Xinlong Wang and Xiaosong Zhang and Zhengxiong Luo and Quan Sun and Yufeng Cui and Jinsheng Wang and Fan Zhang and Yueze Wang and Zhen Li and Qiying Yu and Yingli Zhao and Yulong Ao and Xuebin Min and Tao Li and Boya Wu and Bo Zhao and Bowen Zhang and Liangdong Wang and Guang Liu and Zheqi He and Xi Yang and Jingjing Liu and Yonghua Lin and Tiejun Huang and Zhongyuan Wang. Emu3: Next-token prediction is all you need. arxiv. 2024.zhou25transfusion:— Chunting Zhou and Lili Yu and Arun Babu and Kushal Tirumala and Michihiro Yasunaga and Leonid Shamis and Jacob Kahn and Xuezhe Ma and Luke Zettlemoyer and Omer Levy. Transfusion: Predict the Next Token and Diffuse Images with One Multi-Modal Model. iclr. 2025.tong26beyond— Shengbang Tong and David Fan and John Nguyen and Ellis Brown and Gaoyue Zhou and Shengyi Qian and Boyang Zheng and Th\'eophane Vallaeys and Junlin Han and Rob Fergus and Naila Murray and Marjan Ghazvininejad and Mike Lewis and Nicolas Ballas and Amir Bar and Michael Rabbat and Jakob Verbeek and Luke Zettlemoyer and Koustuv Sinha and Yann LeCun and Saining Xie. Beyond Language Modeling: An Exploration of Multimodal Pretraining. arxiv. 2026.team26longcat-next:— Meituan LongCat Team. LongCat-Next: Lexicalizing Modalities as Discrete Tokens. arxiv. 2026.wang26ernie— Haifeng Wang and Hua Wu and Tian Wu and Yu Sun and Jing Liu and Dianhai Yu and Yanjun Ma and Jingzhou He and Zhongjun He and Dou Hong and Qiwen Liu and Shuohuan Wang and Junyuan Shang and Zhenyu Zhang and Yuchen Ding and Jinle Zeng and Jiabin Yang and Liang Shen and Ruibiao Chen and Weichong Yin and Siyu Ding and Dai Dai and Shikun Feng and Siqi Bao and Bolei He and Yan Chen and Zhenyu Jiao and Ruiqing Zhang and Zeyu Chen and Qingqing Dang and Kaipeng Deng and Jiajun Jiang and Enlei Gong and Guoxia Wang and Yanlin Sha and Yi Liu and Yehan Zheng and Weijian Xu and Jiaxiang Liu and Zengfeng Zeng and Yingqi Qu and Zhongli Li and Zhengkun Zhang and Xiyang Wang and Zixiang Xu and Xinchao Xu and Zhengjie Huang and Dong Wang and Bingjin Chen and Yue Chang and Xing Yuan and Shiwei Huang and Qiao Zhao and Xinzhe Ding and Shuangshuang Qiao and Baoshan Yang and Bihong Tang and Bin Li and Bingquan Wang and Binhan Tang and Binxiong Zheng and Bo Cui and Bo Ke and Bo Zhang and Bowen Zhang and Boyan Zhang and Boyang Liu and Caiji Zhang and Can Li and Chang Xu and Chao Pang and Chao Zhang and Chaoyi Yuan and Chen Chen and Cheng Cui and Chenlin Yin and Chun Gan and Chunguang Chai and Chuyu Fang and Cuiyun Han and Dan Zhang and Danlei Feng and Danxiang Zhu and Dong Sun and Dongbo Li and Dongdong Li and Dongdong Liu and Dongxue Liu and Fan Ding and Fan Hu and Fan Li and Fan Mo and Feisheng Wu and Fengwei Liu and Gangqiang Hu and Gaofeng Lu and Gaopeng Yong and Gexiao Tian and Guan Wang and Guangchen Ni and Guangshuo Wu and Guanzhong Wang and Guihua Liu and Guishun Li and Haibin Li and Haijian Liang and Haipeng Ming and Haisu Wang and Haiyang Lu and Haiye Lin and Han Zhou and Hangting Lou and Hanwen Du and Hanzhi Zhang and Hao Chen and Hao Du and Hao Liu and Hao Zhou and Haochen Jiang and Haodong Tian and Haoshuang Wang and Haozhe Geng and Heju Yin and Hong Chen and Hongchen Xue and Hongen Liu and Honggeng Zhang and Hongji Xu and Hongwei Chen and Hongyang Zhang and Hongyuan Zhang and Hua Lu and Huan Chen and Huan Wang and Huang He and Hui Liu and Hui Zhong and Huibin Ruan and Jiafeng Lu and Jiage Liang and Jiahao Hu and Jiahao Hu and Jiajie Yang and Jialin Li and Jian Chen and Jian Wu and Jianfeng Yang and Jianguang Jiang and Jianhua Wang and Jianye Chen and Jiaodi Liu and Jiarui Zhou and Jiawei Lv and Jiaxin Zhou and Jiaxuan Liu and Jie Han and Jie Sun and Jiefan Fang and Jihan Liu and Jihua Liu and Jing Hu and Jing Qian and Jing Yan and Jingdong Du and Jingdong Wang and Jingjing Wu and Jingyong Li and Jinheng Wang and Jinjin Li and Jinliang Lu and Jinlin Yu and Jinnan Liu and Jixiang Feng and Jiyi Huang and Jiyuan Zhang and Jun Liang and Jun Xia and Jun Yu and Junda Chen and Junhao Feng and Junhong Xiang and Junliang Li and Kai Liu and Kailun Chen and Kairan Su and Kang Hu and Kangkang Zhou and Ke Chen and Ke Wei and Kui Huang and Kun Wu and Kunbin Chen and Lei Han and Lei Sun and Lei Wen and Linghui Meng and Linhao Yu and Liping Ouyang and Liwen Zhang and Longbin Ji and Longzhi Wang and Meng Sun and Meng Tian and Mengfei Li and Mengqi Zeng and Mengyu Zhang and Ming Hong and Mingcheng Zhou and Mingming Huang and Mingxin Chen and Mingzhu Cai and Naibin Gu and Nemin Qiu and Nian Wang and Peng Qiu and Peng Zhao and Pengyu Zou and Qi Wang and Qi Xin and Qian Wang and Qiang Zhu and Qianhui Luo and Qianwei Yang and Qianyue He and Qifei Wu and Qinrui Li and Qiwen Bao and Quan Zhang and Quanxiang Liu and Qunyi Xie and Rongrui Zhan and Rufeng Dai and Rui Peng and Ruian Liu and Ruihao Xu and Ruijie Wang and Ruixi Zhang and Ruixuan Liu and Runsheng Shi and Ruting Wang and Senbo Kang and Shan Lu and Shaofei Yu and Shaotian Gong and Shenwei Hu and Shifeng Zheng and Shihao Guo and Shilong Fan and Shiqin Liu and Shiwei Gu and Shixi Zhang and Shuai Yao and Shuang Zhang and Shuangqiao Liu and Shuhao Liang and Shuwei He and Shuwen Yang and Sijun He and Siming Dai and Siming Wu and Siyi Long and Songhe Deng and Suhui Dong and Suyin Liang and Teng Hu and Tianchan Xu and Tianliang Lv and Tianmeng Yang and Tianyi Wei and Tiezhu Gao and Ting Sun and Ting Zhang and Tingdan Luo and Wei He and Wei Luan and Wei Yin and Wei Zhang and Wei Zhou and Weibao Gong and Weibin Li and Weicheng Huang and Weichong Dang and Weiguo Zhu and Weilong Zhang and Weiqi Tan and Wen Huang and Wenbin Chang and Wenjing Du and Wenlong Miao and Wenpei Luo and Wenquan Wu and Xi Shi and Xi Zhao and Xiang Gao and Xiangguo Zhang and Xiangrui Yu and Xiangsen Wang and Xiangzhe Wang and Xianlong Luo and Xianying Ma and Xiao Tan and Xiaocong Lin and Xiaofei Wang and Xiaofeng Peng and Xiaofeng Wu and Xiaojian Xu and Xiaolan Yuan and Xiaopeng Cui and Xiaotian Han and Xiaoxiong Liu and Xiaoxu Fei and Xiaoxuan Wu and Xiaoyu Wang and Xiaoyu Zhang and Xin Sun and Xin Wang and Xinhui Huang and Xinming Zhu and Xintong Yu and Xinyi Xu and Xinyu Wang and Xiuxian Li and XuanShi Zhu and Xue Xu and Xueying Lv and Xuhong Li and Xulong Wei and Xuyi Chen and Yabing Shi and Yafeng Wang and Yamei Li and Yan Liu and Yanfu Cheng and Yang Gao and Yang Liang and Yang Wang and Yang Wang and Yang Yang and Yanlong Liu and Yannian Fu and Yanpeng Wang and Yanzheng Lin and Yao Chen and Yaozong Shen and Yaqian Han and Yehua Yang and Yekun Chai and Yesong Wang and Yi Song and Yichen Zhang and Yifei Wang and Yifeng Guo and Yifeng Kou and Yilong Chen and Yilong Guo and Yiming Wang and Ying Chen and Ying Wang and Yingsheng Wu and Yingzhan Lin and Yinqi Yang and Yiran Xing and Yishu Lei and Yixiang Tu and Yiyan Chen and Yong Zhang and Yonghua Li and Yongqiang Ma and Yongxing Dai and Yongyue Zhang and Yu Ran and Yu Sun and Yu-Wen Michael Zhang and Yuang Liu and Yuanle Liu and Yuanyuan Zhou and Yubo Zhang and Yuchen Han and Yucheng Wang and Yude Gao and Yuedong Luo and Yuehu Dong and Yufeng Hu and Yuhui Cao and Yuhui Yun and Yukun Chen and Yukun Gao and Yukun Li and Yumeng Zhang and Yun Fan and Yun Ma and Yunfei Zhang and Yunshen Xie and Yuping Xu and Yuqin Zhang and Yuqing Liu and Yurui Li and Yuwen Wang and Yuxiang Lu and Zefeng Cai and Zelin Zhao and Zelun Zhang and Zenan Lin and Zezhao Dong and Zhaowu Pan and Zhaoyu Liu and Zhe Dong and Zhe Zhang and Zhen Zhang and Zhengfan Wu and Zhengrui Wei and Zhengsheng Ning and Zhenxing Li and Zhenyu Li and Zhenyu Qian and Zhenyun Li and Zhi Li and Zhichao Chen and Zhicheng Dong and Zhida Feng and Zhifan Feng and Zhihao Deng and Zhijin Yu and Zhiyang Chen and Zhonghui Zheng and Zhuangzhuang Guo and Zhujun Zhang and Zhuo Sun and Zichang Liu and Zihan Lin and Zihao Huang and Zihe Zhu and Ziheng Zhao and Ziping Chen and Zixuan Zhu and Ziyang Xu and Ziyi Liang and Ziyuan Gao. ERNIE 5.0 Technical Report. arxiv. 2026.team24chameleon:— Team, Chameleon. Chameleon: Mixed-Modal Early-Fusion Foundation Models. arxiv. 2024.wu25janus:— Chengyue Wu and Xiaokang Chen and Zhiyu Wu and Yiyang Ma and Xingchao Liu and Zizheng Pan and Wen Liu and Zhenda Xie and Xingkai Yu and Chong Ruan and Ping Luo. Janus: Decoupling visual encoding for unified multimodal understanding and generation. cvpr. 2025.deng25emerging— Chaorui Deng and Deyao Zhu and Kunchang Li and Chenhui Gou and Feng Li and Zeyu Wang and Shu Zhong and Weihao Yu and Xiaonan Nie and Ziang Song and Guang Shi and Haoqi Fan. Emerging Properties in Unified Multimodal Pretraining. arxiv. 2025.yang26context— Ceyuan Yang and Zhijie Lin and Yang Zhao and Fei Xiao and Hao He and Qi Zhao and Chaorui Deng and Kunchang Li and Zihan Ding and Yuwei Guo and Fuyun Wang and Fangqi Zhu and Xiaonan Nie and Shenhan Zhu and Shanchuan Lin and Hongsheng Li and Weilin Huang and Guang Shi and Haoqi Fan. Context Unrolling in Omni Models. arxiv. 2026.gabeur26image— Valentin Gabeur and Shangbang Long and Songyou Peng and Paul Voigtlaender and Shuyang Sun and Yanan Bao and Karen Truong and Zhicheng Wang and Wenlei Zhou and Jonathan T. Barron and Kyle Genova and Nithish Kannen and Sherry Ben and Yandong Li and Mandy Guo and Suhas Yogin and Yiming Gu and Huizhong Chen and Oliver Wang and Saining Xie and Howard Zhou and Kaiming He and Thomas Funkhouser and Jean-Baptiste Alayrac and Radu Soricut. Image Generators are Generalist Vision Learners. arxiv. 2026.wang26scenescribe-1m:— Yunnan Wang and Kecheng Zheng and Jianyuan Wang and Minghao Chen and David Novotny and Christian Rupprecht and Yinghao Xu and Xing Zhu and Wenjun Zeng and Xin Jin and Yujun Shen. SceneScribe-1M: A Large-Scale Video Dataset with Comprehensive Geometric and Semantic Annotations. cvpr. 2026.huang26pointworld:— Huang, Wenlong and Chao, Yu-Wei and Mousavian, Arsalan and Liu, Ming-Yu and Fox, Dieter and Mo, Kaichun and Fei-Fei, Li. PointWorld: Scaling 3D World Models for In-The-Wild Robotic Manipulation. arxiv. 2026.li25sekai:— Zhen Li and Chuanhao Li and Xiaofeng Mao and Shaoheng Lin and Ming Li and Shitian Zhao and Zhaopan Xu and Xinyue Li and Yukang Feng and Jianwen Sun and Zizhen Li and Fanrui Zhang and Jiaxin Ai and Zhixiang Wang and Yuwei Wu and Tong He and Yunde Jia and Kaipeng Zhang. Sekai: A Video Dataset towards World Exploration. arxiv. 2025.wang25spatialvid:— Jiahao Wang and Yufeng Yuan and Rujie Zheng and Youtian Lin and Jian Gao and Lin-Zhuo Chen and Yajie Bao and Yi Zhang and Chang Zeng and Yanxi Zhou and Xiaoxiao Long and Hao Zhu and Zhaoxiang Zhang and Xun Cao and Yao Yao. SpatialVID: A Large-Scale Video Dataset with Spatial Annotations. arxiv. 2025.zhou26omniworld:— Yang Zhou and Yifan Wang and Jianjun Zhou and Wenzheng Chang and Haoyu Guo and Zizun Li and Kaijing Ma and Xinyue Li and Yating Wang and Haoyi Zhu and Mingyu Liu and Dingning Liu and Jiange Yang and Zhoujie Fu and Junyi Chen and Chunhua Shen and Jiangmiao Pang and Kaipeng Zhang and Tong He. OmniWorld: A multi-domain and multi-modal dataset for 4D world modeling. iclr. 2026.