ASENA:用于具身导航的自进化智能体
An-Chieh Cheng、Isabella Liu、Edmund Bu、Johan Bjorck、Hongxu Yin、Zhengyi Luo、Jan Kautz、Linxi “Jim” Fan、Yuke Zhu、Sifei Liu
NVIDIA;加州大学圣迭戈分校
摘要
本文提出 ASENA——一个将通用编程智能体与机器人感知、计算、监督执行及持久化经验相连接的具身智能体系统。在模型权重保持固定的情况下,智能体能够编写并执行程序、检查记录的结果、修复故障,以及复用笔记和可执行技能。本文还提出 ASENA-VLN——一种作为可选工具接入该可编程系统的 4B 单目导航策略。ASENA-VLN采用共享视觉--语言解码器预测长距离路线和短时域行为的机体坐标系轨迹;该解码器基于路线指令、视觉问答以及新整理的几何推导原子导航任务数据集进行训练。作为独立策略,ASENA-VLN在 R2R 和 RxR 上分别取得 68.7% 和 70.2% 的成功率,达到当前最佳水平。与编程智能体集成后,学习式导航使 ASENA在两个智能体基准上的成功率均提高 11 个百分点,同时缩短执行时间。借助持久化工作区演进和模拟器反馈,在反复出现的 100 个任务子集上迭代十轮后,R2R 的成功率从 72% 进一步提高到 98%,RxR 则从 65% 提高到 89%。在具身问答(Embodied Question Answering, EQA)任务上,ASENA以更少的交互步数达到当前最佳准确率。最后,Unitree G1 上的真实世界演示在无预构建地图的条件下结合了搜索、视觉检查、空间推理与动作合成,表明在线编程能够将机器人行为扩展至路线跟随和预定义技能之外。
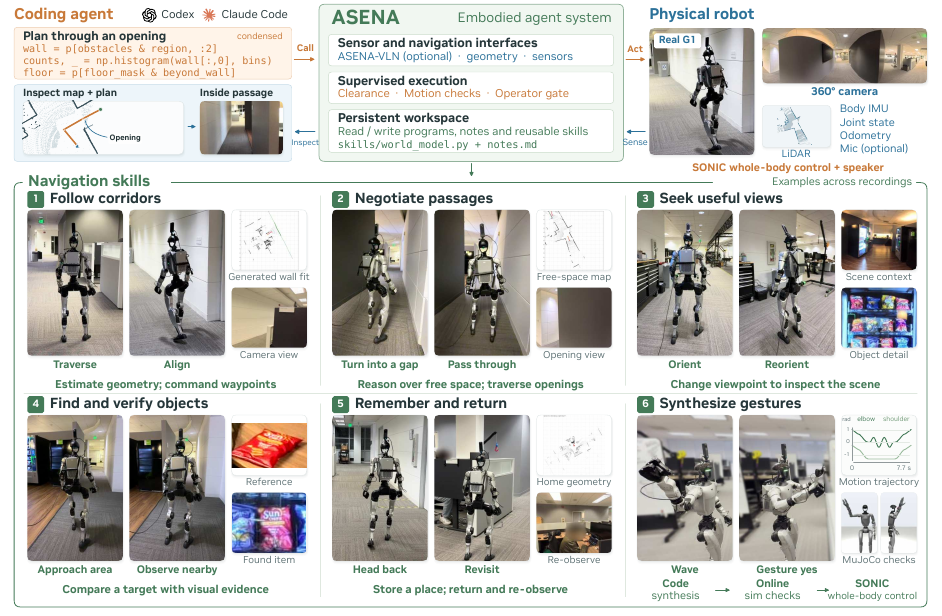
图:ASENA 将编程智能体与实体机器人技能相连接。程序结合感知、计算、监督执行与可复用技能,并将学习式导航作为可选工具。图中的编程示例通过分析 LiDAR 几何信息规划一条穿过开口的路线;插图展示了机器人随后在通道内的观测。底部各图展示系统演进所得的部分技能。项目主页:https://asena-bot.github.io。
引言
实用的导航机器人不能只会抵达目的地。若被要求检查自动售货机中是否有某件商品并返回答案,机器人必须判断搜索位置、识别商品、记住用户位置,并传达搜索结果。因此,导航只是更大任务的一部分,后续步骤取决于机器人的观测。
学习式导航策略提供运动能力,但此类请求还要求机器人判断需要检查、计算和传达的内容。这些流程依赖新的观测,且可能超出预定义技能的范围。编程智能体可在任务执行期间通过程序化接口访问感知、计算、仿真与动作,进而构建并修订这些流程。实体部署还需要与结果关联的反馈、在程序变化后仍然有效的安全防护机制,以及用于保留实用流程的持久化工作区。
本文提出提供上述能力的具身智能体系统 ASENA(图(fig:teaser))。智能体能够读取传感器数据、推导几何信息、执行代码、检查生成的可视化结果并请求机器人动作。ASENA通过共享接口、监督执行及相互关联的执行记录连接这些操作。持久化工作区用于存储笔记和可执行技能,使系统能够在模型权重保持固定的情况下,通过修订程序实现改进。
在具备适当训练数据时,学习式策略可进一步扩展这套可编程工具集。将运动委托给专用策略,既能减少智能体的重复决策,也能支持难以用几何规则描述的导航行为。本文开发了 ASENA-VLN——一种基于路线指令和几何推导导航原子训练的 4B 单目导航策略。在视觉语言导航(Visual-Language Navigation, VLN) [anderson2018r2r,ku2020rxr,zhang2024navid,cheng2025navila,wei2025streamvln]的基础上,ASENA-VLN能够为长距离路线和短时域目标预测机体坐标系轨迹,例如接近物体或穿过门口。本文整理了新的原子导航数据集,直接监督这些可复用的细粒度行为,并对传统路线级训练形成补充。该策略仍是可选工具:程序可以直接调用它、将其与几何导航结合,或使用其他可用操作完成任务。
本文的主要贡献包括:(1)提出一个具身智能体系统,使编程智能体能够进行可检查、受监督的任务编程并持续获取技能;(2)提出达到当前最佳水平的单目导航策略,同时支持路线跟随和可复用的原子技能;(3)通过评估表明,模型权重保持固定时的工作区演进能够提升任务性能。本文在仿真环境中评估导航与具身问答(EQA),并在无预构建地图的真实 Unitree G1 机器人上演示复杂指令跟随与用户交互。
相关工作
以代码为策略
Code as Policies [liang2022codeaspolicies]在程序中组合感知与控制 API。CaP-X [fu2026capx]提出 CaP-Gym,并以基准测试研究 API 抽象和执行反馈如何影响面向操作任务的编程智能体。ASPIRE [lu2026aspire]利用多模态执行轨迹诊断故障、修复机器人程序并保留可复用技能。
智能体自我改进
Voyager [wang2023voyager]保留并修复可执行技能。Reflexion [shinn2023reflexion]在不更新权重的情况下保留文本反馈。ENPIRE [xiao2026enpire]将真实机器人复位与验证同智能体驱动的程序合成及策略训练相结合。相比之下,ASENA研究如何在所有模型权重保持固定的情况下,围绕预训练导航策略演进持久化工作区。本文在仿真环境中量化工作区演进,并在实体机器人上展示由此获得的监督执行能力。
语言引导导航
DUET 和 ETPNav [chen2022duet,an2023etpnav]等拓扑方法,以及 NaVid、NaVILA 和 StreamVLN [zhang2024navid,cheng2025navila,wei2025streamvln]等视频到动作策略,均致力于视觉指令跟随。LM-Nav [shah2023lm]组合多个预训练模型,InstructNav [long2024instructnav]则将零样本推理与通用运动基元相结合。DualVLN 和 Qwen-RobotNav [wei2025dualvln,qwen2026robotnav]将高层推理与学习式导航策略集成,Uni-LaViRA [ding2026unilavira]研究统一的语言--视觉--动作转换。本文的 VLN 策略与视频到动作导航策略最为相关,但侧重轻量级 4B 模型及其细粒度原子能力;编程智能体可以将这些能力与其他工具和保留程序组合使用。本文既评估该策略的独立导航性能,也评估它在完整具身智能体系统中的效用。
具身问答
Explore-EQA [ren2024exploreeqa]研究主动探索,直至智能体能够以足够高的置信度作答;3D-Mem 和 GraphEQA [yang2025threedmem,saxena2025grapheqa]则将观测组织为空间记忆。MemoryEQA [zhai2025memoryeqa]将这一设定扩展到更长时域的多目标问题,FAST-EQA [zhang2026fasteqa]则侧重高效收集证据。本文使用这些 EQA 设定评估 ASENA组合感知、导航和记忆工具的能力,以及在模型权重保持固定的情况下,通过修订持久化笔记和可执行技能实现改进的能力。
方法
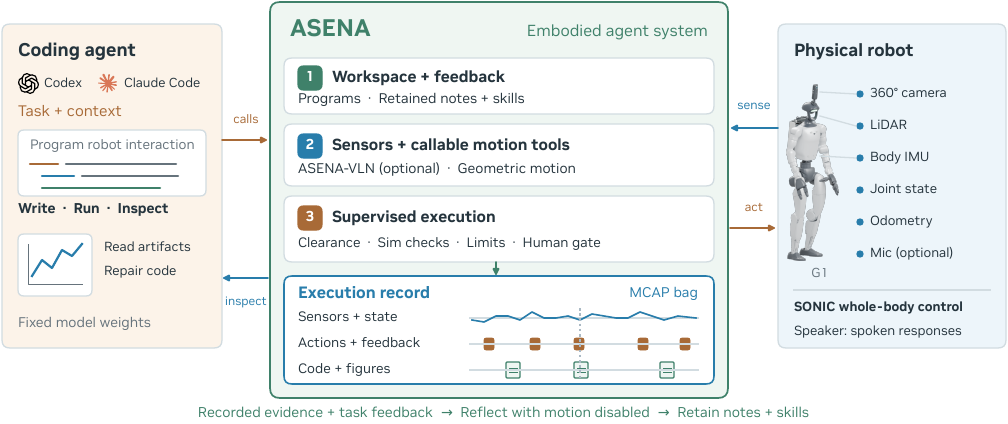
图:ASENA将编程智能体连接至实体机器人。 该系统集成机器人感知、持久化工作区、监督执行以及可选的学习式导航策略。每次运行均存储为 MCAP 记录 [foxglove2024mcap],将传感器与机器人状态同动作、操作员反馈、代码和可视化结果对齐, 以供检查与回放。机器人运动禁用期间,智能体会反思这些记录并更新笔记与技能。
ASENA为编程智能体提供实体机器人的程序化访问能力 (图(fig:overview))。该系统将感知、计算、可视化、仿真和动作整合到统一的编写--运行--检查流程中。 每次运行均受物理安全保护机制约束,并被记录下来以供后续检查、修复和复用。智能体还可在同一接口中 将学习式导航策略作为可选工具调用。
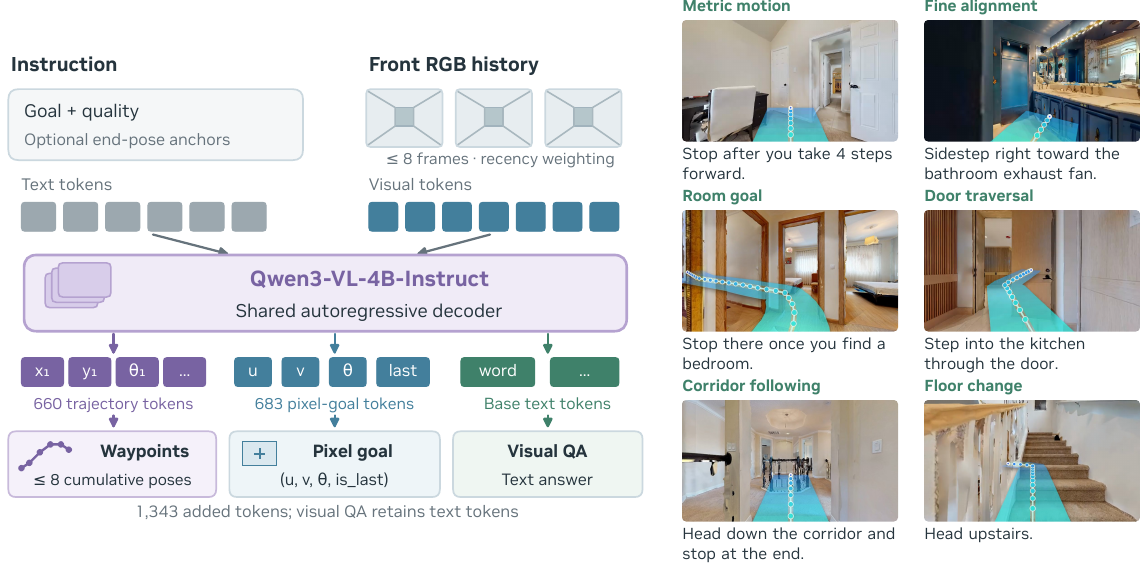
图:导航策略架构与原子训练示例。 左:语言和单目历史观测输入共享自回归解码器。不同词元块分别编码轨迹和像素目标;视觉问答使用文本词元。 运动词元解码为机体坐标系航点。架构图标仅为示意。右:带有指令和叠加轨迹的训练观测记录; 叠加轨迹未使用度量相机投影。更多示例见 (fig:atomic-training-gallery)。
以机器人反馈验证程序
程序必须依据物理反馈检验其假设。在 G1 上,ASENA开放 360 度相机、LiDAR、里程计、机体 IMU 和关节状态。编程智能体处理并可视化这些输入,以估计几何结构、检查物体并监控执行。当动作偏离预期时, 智能体可检查记录的证据并修改程序。
生成程序请求的所有物理动作均通过 ASENA的执行接口,并由 SONIC 全身控制器 [luo2025sonic] 执行,同时受下述验证与审批机制约束。在此接口中,智能体可使用几何导航工具,显式推理航点和安全间距, 也可调用学习式策略执行语言条件运动。
ASENA将感知、控制和安全接口封装为可调用的原子技能,例如接近物体、穿过门口、说话或做手势。 智能体将这些操作与计算和交互逻辑相结合,构建规模更大的可复用技能;在保留相同物理执行接口的同时, 对任务级程序进行调整。
安全保护机制
与桌面操作相比,人形机器人的全身运动会引入更广泛的安全风险:机器人在共享物理空间中移动整个机体时 必须保持平衡。由于合成程序能快速改变这种行为,本文采用独立于程序生成过程的安全保护机制控制物理执行。 首先在 MuJoCo 中在线验证合成手势,检查姿态连续性、关节与运动限位以及采样自碰撞。若提案未通过验证, 则将违反的约束返回给智能体进行修复。此外,任何已验证动作由 SONIC [luo2025sonic] 执行前, 仍须获得操作员批准。
在导航中,本文使用基于 LiDAR 的占据地图进行路径规划和障碍间距检查,并采用独立安全保护机制实施运动限制; 当里程计数据过期或电池电量过低时,该机制会拒绝命令。心跳触发停止和人工紧急停止进一步保障执行安全。 这些机制贯穿程序合成、仿真验证、人工授权和物理执行,形成分层安全保护。
表:独立单目 VLN-CE 策略在 R2R 和 RxR 的 val_unseen 划分上的结果。与已有工作相比,ASENA-VLN-4B 达到当前最佳性能,导航误差显著更低,nDTW 更高。
\begin{table*}[t]
  \centering
  \caption{独立单目 VLN-CE 策略在 R2R 和 RxR 的 val\_unseen 划分上的结果。与已有工作相比,ASENA-VLN-4B 达到当前最佳性能,导航误差显著更低,nDTW 更高。}
  \label{tab:vln-policy}
  \footnotesize
  \setlength{\tabcolsep}{6pt}
  \renewcommand{\arraystretch}{1.02}
  \begin{tabularx}{\textwidth}{l*{8}{Y}}
    \toprule
    & \multicolumn{4}{c}{R2R} & \multicolumn{4}{c}{RxR} \\
    \cmidrule(lr){2-5}\cmidrule(lr){6-9}
    方法 & NE $\downarrow$ & OSR $\uparrow$ & SR $\uparrow$ & SPL $\uparrow$
           & NE $\downarrow$ & nDTW $\uparrow$ & SR $\uparrow$ & SPL $\uparrow$ \\
    \midrule

  NaVid~\cite{zhang2024navid} & 5.72 & 49.2 & 41.9 & 36.5 & 5.72 & -- & 45.7 & 38.2 \\
  Uni-NaVid~\cite{zhang2025uninavid} & 5.58 & 53.3 & 47.0 & 42.7 & 6.24 & -- & 48.7 & 40.9 \\
  NaVILA~\cite{cheng2025navila} & 5.22 & 62.5 & 54.0 & 49.0 & 6.77 & 58.8 & 49.3 & 44.0 \\
  StreamVLN~\cite{wei2025streamvln} & 4.98 & 64.2 & 56.9 & 51.9 & 6.22 & 61.9 & 52.9 & 46.0 \\
  NaVIDA~\cite{zhu2026navida} & 4.32 & 69.5 & 61.4 & 54.7 & 5.23 & 67.0 & 57.4 & 49.6 \\
  JanusVLN~\cite{zeng2026janusvln} & 4.78 & 65.2 & 60.5 & 56.8 & 6.06 & 62.1 & 56.2 & 47.5 \\
  DecoVLN~\cite{xin2026decovln} & 5.01 & 63.5 & 56.3 & 50.5 & 5.73 & 63.5 & 54.2 & 46.3 \\
  ActiveVLN~\cite{zhang2026activevln} & 5.31 & 58.3 & 50.1 & 43.7 & 5.84 & 58.1 & 50.7 & 41.2 \\
  Qwen-VLA-Instruct~\cite{wang2026qwenvla} & 5.10 & 69.0 & 57.5 & 51.2 & 5.80 & 57.1 & 59.6 & 47.8 \\
  InternVLA-N1 (S2, SPF)~\cite{cai2025internvlan1} & 4.25 & 68.3 & 60.9 & 55.2 & 5.71 & 46.8 & 63.5 & 55.0 \\
  RynnBrain-Nav-8B (SPF)~\cite{dang2026rynnbrain} & 4.92 & 71.6 & 58.6 & 49.6 & 6.20 & 59.6 & 56.1 & 49.6 \\
  DualVLN~\cite{wei2025dualvln} & \underline{4.05} & 70.7 & 64.3 & 58.5 & 4.58 & \underline{70.0} & 61.4 & 51.8 \\
  InternVLA-N1~\cite{cai2025internvlan1} & 4.83 & 63.3 & 58.2 & 54.0 & 5.91 & 65.3 & 53.5 & 46.1 \\
  Qwen-RobotNav-4B~\cite{qwen2026robotnav} & 4.22 & \textbf{73.6} & \underline{66.9} & \underline{60.5} & \underline{4.15} & 68.6 & \textbf{71.3} & \textbf{61.5} \\
    \midrule

  \rowcolor{asenashade}
  ASENA-VLN-4B & \textbf{3.52} & \underline{72.6} & \textbf{68.7} & \textbf{64.2} & \textbf{3.90} & \textbf{73.1} & \underline{70.2} & \underline{59.7} \\
    \bottomrule
  \end{tabularx}
\end{table*}
表:物体目标导航:成对报告 SR/SPL(%,两者均为 \(\uparrow\))。 \(^\ddagger\) 表示 HM3D v1 结果,突出显示时不计入这些结果。
\begin{table}[t]
  \centering
  \caption{物体目标导航:成对报告 SR/SPL(\%,两者均为 $\uparrow$)。
  $^\ddagger$ 表示 HM3D v1 结果,突出显示时不计入这些结果。}
  \label{tab:objectnav}
  \footnotesize
  \setlength{\tabcolsep}{2pt}
  \renewcommand{\arraystretch}{1.04}
  \begin{tabularx}{\columnwidth}{l*{4}{Y}}
    \toprule
    & HM3D & \multicolumn{3}{c}{HM3D-OVON} \\
    \cmidrule(lr){3-5}
    方法 & v2 验证集 & 已见 & 合成 & 未见 \\
    \midrule

    VLFM & 63.6/32.5 & 35.2/18.6 & 32.4/17.3 & 35.2/19.6 \\
    OpenFMNav$^{\ddagger}$ & 52.5/24.1 & -- & -- & -- \\
    SG-Nav & 49.6/25.5 & -- & -- & -- \\
    TriHelper$^{\ddagger}$ & 56.5/25.3 & -- & -- & -- \\
    WMNav$^{\ddagger}$ & 58.1/31.2 & -- & -- & -- \\
    CogNav$^{\ddagger}$ & 72.5/26.2 & -- & -- & -- \\
    Uni-NaVid$^{\ddagger}$ & 73.7/37.1 & 41.3/21.1 & 43.9/21.8 & 39.5/19.8 \\
    DAgRL+OD & -- & 38.5/21.1 & 39.0/21.4 & 37.1/19.8 \\
    MTU3D & -- & 55.0/23.6 & 45.0/14.7 & 40.8/12.1 \\
    NavFoM & -- & 40.1/27.1 & 45.4/32.6 & 45.2/\underline{31.9} \\
    ABot-N0 & -- & 55.3/\underline{32.1} & 55.4/\underline{33.2} & \underline{54.0}/30.5 \\
    ApexNav & \underline{76.2}/\underline{38.0} & -- & -- & -- \\
    Qwen-RobotNav-4B & 75.6/30.6 & \underline{57.7}/24.4 & \underline{60.1}/25.1 & 53.1/20.9 \\
    Qwen-RobotNav-8B & 71.2/33.0 & 56.1/28.5 & 57.8/28.8 & 51.2/24.0 \\
    \midrule

    \rowcolor{asenashade}
    \asena & \textbf{80.8}/\textbf{38.1} & \textbf{60.5}/\textbf{33.5} & \textbf{65.8}/\textbf{37.9} & \textbf{64.9}/\textbf{38.4} \\
    \bottomrule
  \end{tabularx}
  \par\smallskip
\end{table}
表:在 R2R 和 RxR Agentic Split 上进行自进化前的导航结果。NE 的单位为米,OSR/SR/SPL 以百分比表示。调用数/回合为 100 个回合的平均工具调用次数。绿色百分比表示相对于同一后端不使用 VLN 时的降幅。
\begin{table*}[t]
\centering
\caption{在 R2R 和 RxR Agentic Split 上进行自进化前的导航结果。NE 的单位为米,OSR/SR/SPL 以百分比表示。调用数/回合为 100 个回合的平均工具调用次数。绿色百分比表示相对于同一后端不使用 VLN 时的降幅。}
\label{tab:navigation}
\footnotesize
\setlength{\tabcolsep}{1.8pt}
\definecolor{callgain}{RGB}{25,112,78}
\newcommand{\callreduction}[1]{{\scriptsize\textcolor{callgain}{$\downarrow$\,#1\%}}}
\begin{tabularx}{\textwidth}{lc*{4}{Y}rl*{3}{Y}rl}
\toprule
 & & \multicolumn{6}{c}{R2R Agentic Split} & \multicolumn{5}{c}{RxR Agentic Split} \\
\cmidrule(lr){3-8}\cmidrule(lr){9-13}
方法/编程智能体 & VLN 工具 & NE $\downarrow$ & OSR $\uparrow$ & SR $\uparrow$ & SPL $\uparrow$ & \multicolumn{2}{c}{调用数/回合 $\downarrow$} & NE $\downarrow$ & SR $\uparrow$ & SPL $\uparrow$ & \multicolumn{2}{c}{调用数/回合 $\downarrow$} \\
\midrule
\multicolumn{13}{l}{\emph{已发表的零样本方法}} \\

InstructNav~\cite{long2024instructnav} & -- & 6.89 & 47.0 & 31.0 & 24.0 & -- & & -- & -- & -- & -- & \\
Open-Nav~\cite{qiao2025opennav} & -- & 6.70 & 23.0 & 19.0 & 16.1 & -- & & -- & -- & -- & -- & \\
CA-Nav~\cite{chen2024canav} & -- & 7.58 & 48.0 & 25.3 & 10.8 & -- & & 10.4 & 19.0 & 6.0 & -- & \\
GC-VLN~\cite{yin2025gcvln} & -- & 7.30 & 41.8 & 33.6 & 16.3 & -- & & 8.80 & 33.8 & 13.8 & -- & \\
Three-Step Nav~\cite{zheng2026threestepnav} & -- & 5.87 & 39.0 & 34.0 & 29.1 & -- & & 9.21 & 22.0 & 16.1 & -- & \\
Uni-LaViRA~\cite{ding2026unilavira} & -- & 3.66 & 73.7 & 60.7 & 47.7 & -- & & 6.48 & 51.3 & 34.0 & -- & \\

Minimal (\claudesonnet, SDK)~\cite{zhou2026embodied} & -- & 5.80 & 61.3 & 51.3 & 37.8 & -- & & -- & -- & -- & -- & \\
\midrule
\multicolumn{13}{l}{\emph{\asena{}策略与新工作区智能体}} \\
\rowcolor{asenashade}

ASENA-VLN-4B & -- & 3.16 & 82.0 & 78.0 & 70.7 & -- & & 4.54 & 62.0 & 52.9 & -- & \\
\specialrule{0.3pt}{0pt}{0pt}
\rowcolor{asenashade}

\asena (\claudesonnet) & $\times$ & \underline{5.23} & \underline{70.0} & \underline{61.0} & \underline{34.2} & \underline{83.32} & & \underline{5.80} & \underline{50.0} & \underline{31.9} & \underline{103.83} & \\
\rowcolor{asenashade}

\asena (\claudesonnet) & $\checkmark$ & \textbf{3.31} & \textbf{83.0} & \textbf{72.0} & \textbf{54.9} & \textbf{33.96} & \callreduction{59.2} & \textbf{4.94} & \textbf{61.0} & \textbf{45.5} & \textbf{38.91} & \callreduction{62.5} \\
\specialrule{0.3pt}{0pt}{0pt}
\rowcolor{asenashade}

\asena (\gptastra) & $\times$ & \textbf{1.84} & \textbf{90.0} & \underline{87.0} & \underline{72.4} & \underline{26.37} & & \textbf{0.82} & \textbf{93.0} & \textbf{78.0} & \underline{40.80} & \\
\rowcolor{asenashade}

\asena (\gptastra) & $\checkmark$ & \underline{2.18} & \underline{89.0} & \textbf{88.0} & \textbf{72.8} & \textbf{14.00} & \callreduction{46.9} & \underline{1.65} & \underline{86.0} & \underline{64.0} & \textbf{19.98} & \callreduction{51.0} \\
\bottomrule
\end{tabularx}
\end{table*}
将执行转化为保留经验
ASENA以 MCAP 格式 [foxglove2024mcap]记录运行过程,将传感器与机器人状态同动作、 操作员反馈、代码和可视化结果对齐。通过回放这些证据,智能体能够定位执行偏离预期之处,并修复相应程序。
修复故障后,ASENA可保留解决方案以供后续任务使用。将修订版本 \(k\) 的工作区表示为 \(W_k=(N_k,S_k)\),其中 \(N_k\) 包含笔记,\(S_k\) 包含可执行技能。固定的编程模型在解决任务时查阅该工作区。 两次修订之间,独立且权重固定的改进器使用执行轨迹 \(\mathcal{T}_k\) 和反馈 \(f_k\) 更新工作区:
$$
W_{k+1}=I_\phi(W_k,\mathcal{T}_k,f_k).
$$
模型和控制器权重保持固定。在仿真中,私有工作进程可在各轮之间编辑工作区,而冻结评估期间禁用写入。 在 G1 上,执行记录和可选的操作员反馈支持技能修订。每个修订后的程序在物理执行前仍须通过独立安全检查, 并获得操作员批准。
学习可复用的视觉导航策略
ASENA-VLN减少智能体在复杂路线上的重复推理。该可选工具根据语言和近期单目观测预测有界的机体坐标系轨迹。 编程智能体决定何时调用该工具、检查进度,并将其与其他工具结合使用。策略训练在同一编程接口内扩展了导航能力。
单一解码器,不同输出表示
本文为轻量级 Qwen3-VL-4B-Instruct [qwen2025qwen3vl] 扩展了轨迹与像素目标专用词元词表 (图(fig:policy-architecture))。模型接收最多八帧前视图像和一条结构化 JSON 指令,使该策略易于作为 可调用工具使用。输入指定简洁的导航命令,还可选择包含期望终止姿态、锚定物体或运动约束。按新近程度加权的 视觉词元在保留时间上下文的同时突出最新观测。共享自回归解码器预测最多八个累积机体坐标系航点, 每个航点表示为 \((x,y,\theta)\)。各轴上的固定分箱将轨迹词元转换为显式运动目标,无需单独的连续动作头。 像素目标词元通过引导模型在图像中定位预期目的地提供辅助监督,而视觉问答保留模型原有的文本词表。 由于像素目标无法直接执行,还需额外的运动规划器,或在仿真中使用最短路径跟随器,因此本文所有评估均采用 轨迹词元预测而非像素目标。
精选的原子导航数据
可调用导航策略既须遵循较长路线,也须执行精确的局部命令。因此,本文在 MP3D 和 HM3D 中构建九种原子导航任务, 涵盖移动指定距离、旋转至目标航向、从给定方向接近物体、与目标对齐、进入房间、穿过门口、沿走廊行进以及 楼层间移动等行为。每项任务均依据测地距离、可见性和场景几何结构生成并验证,确保每条指令描述可行且可测量的 运动。每条指令均配有航点轨迹和辅助像素目标监督。这些数据直接教授任务程序可调用和组合的可复用细粒度操作。
本文使用这些原子任务、短时域 ObjectNav,以及来自 R2R、RxR、ScaleVLN 和 SRDF [anderson2018r2r,ku2020rxr,wang2023scalevln,wang2025srdf] 的视觉语言导航数据混合训练 ASENA-VLN。为适配可调用策略接口,本文使用 GPT-5.5 [openai2026gpt55] 将这些数据集的原始指令重新描述为 结构化 JSON 格式,其中包含简洁导航命令,并在适用时包含终止姿态、锚定物体和运动约束。训练数据还纳入多视图 VQA 数据 [sensenova-si],以增强模型的空间理解能力。训练从数据中抽取 430 万个样本,轨迹预测与空间 VQA 的混合比例为 3:1。
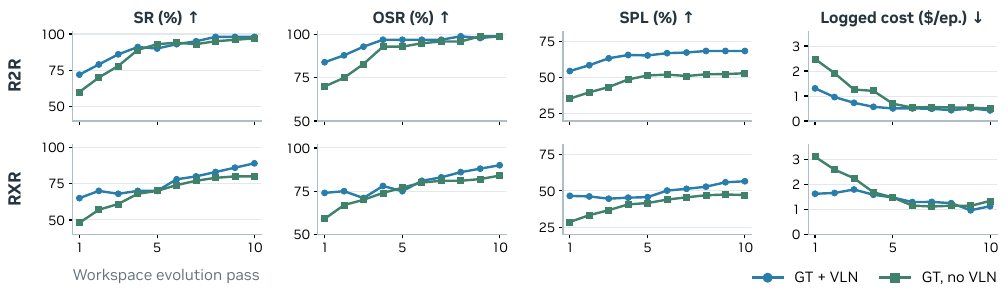
图:导航工作区的自进化。 随着进化轮次增加,成功相关指标(SR、OSR 和 SPL)均有所提升,而每轮成本总体下降。 使用 VLN 工具能持续提升 SPL,使智能体更高效地到达目的地。
评估与应用
首先将ASENA-VLN作为独立的指令跟随策略进行评估,随后在目标物体导航任务上 评估完整的ASENA系统。接着研究模型权重固定时,学习式导航策略与工作区中的 保留经验如何影响编程智能体的性能。最后,在仿真环境中评估具身问答,并在 Unitree G1 机器人上展示该系统。
独立 VLN 策略
表(tab:vln-policy)在不采用编程智能体规划的情况下,分别使用 R2R 的较短指令 以及 RxR 更长、更详细的路线独立评估ASENA-VLN。
前进步长设为 0.25 m,旋转步长设为 15 度。导航误差(Navigation Error, NE) 表示以米为单位的最终目标距离。预言成功率(Oracle Success Rate, OSR)衡量智能体 是否进入目标区域,而成功率(Success Rate, SR)要求智能体在目标区域内停止。 路径长度加权成功率(Success Weighted by Path Length, SPL)衡量路径效率,归一化 动态时间规整(Normalized Dynamic Time Warping, nDTW)衡量轨迹与参考路线的 相似度。这四项指标均以百分比表示。仿真器最短路径跟随器(Simulator Shortest-Path Follower, SPF)供像素目标方法使用。
目标物体导航
表(tab:objectnav)将评估从沿给定路线行进扩展到搜索初始可能不可见的物体。 由于ASENA-VLN主要针对原子导航行为而非全局探索进行训练,我们将其与独立的 视觉语言模型(Vision-Language Model, VLM) [google2026gemini31flashlite] 结合,由后者规划搜索位置,并利用新观测到的证据更新计划。在 HM3D-v2 和 HM3D-OVON 上,这种全局搜索推理与学习式局部导航相结合的方案,相较于 文献 [qwen2026robotnav,zhu2026sysnav]中已发表的方法取得了当前最佳结果。 对于已见、同义和未见的 OVON 物体类别,其性能均保持稳定,表明该系统能够应对 物体描述以及寻找物体所需路线的变化。
智能体与策略的互补能力
表(tab:navigation)研究编程智能体与ASENA-VLN各自对导航性能的贡献。我们比较 已发表的零样本方法、独立的ASENA-VLN,以及采用两种编程后端实例化的ASENA。 沿用 Uni-LaViRA 和 Open-Nav [ding2026unilavira,qiao2025opennav]的缩减集评估 方式,R2R 与 RxR 的智能体划分(Agentic Splits)各包含 100 个任务。 在每个基准的十个场景中,所有策略与智能体变体均使用相同的任务 ID,且每个编程 智能体均从全新的工作区开始。Claude Sonnet 5采用高推理强度运行,GPT-6 Astra采用 最高推理强度运行。四个 RxR 回合产生了非有限的 NE 或 SPL 值;计算 SR 时将其 视为失败,NE 与 SPL 则基于其余 96 个回合计算。
表:具身问答。不同覆盖范围下的准确率(%)与平均归一化步数。
\begin{table}[t]
\centering
\caption{具身问答。不同覆盖范围下的准确率(\%)与平均归一化步数。}
\label{tab:eqa}
\footnotesize
\setlength{\tabcolsep}{2pt}
\begin{tabularx}{\columnwidth}{l*{4}{Y}}
\toprule
 & \multicolumn{2}{c}{HM-EQA} & \multicolumn{2}{c}{MT-HM3D} \\
\cmidrule(lr){2-3}\cmidrule(lr){4-5}
方法 & 准确率$\uparrow$ & 步数$\downarrow$ & 准确率$\uparrow$ & 步数$\downarrow$ \\
\midrule

Explore-EQA~\cite{ren2024exploreeqa} & 58.4 & .52 & 35.1 & .64 \\
3D-Mem~\cite{yang2025threedmem} & 50.4 & .63 & -- & -- \\
Fine-EQA~\cite{jiang2025fineeqa} & 56.0 & .54 & -- & -- \\
GraphEQA~\cite{saxena2025grapheqa} & 63.5 & .20 & 45.6 & .45 \\
MemoryEQA (Qwen2VL-7B)~\cite{zhai2025memoryeqa} & -- & -- & 51.2 & .40 \\
MemoryEQA (GPT-4o)~\cite{zhai2025memoryeqa} & 63.4 & .40 & 55.1 & .41 \\
FAST-EQA~\cite{zhang2026fasteqa} & 69.2 & .65 & 50.5 & .52 \\
Qwen-RobotNav~\cite{qwen2026robotnav} & 76.7 & .15 & 54.4 & .19 \\
\midrule
\rowcolor{asenashade}

\asena base (low effort) & 70.9 & .15 & 64.8 & \underline{.10} \\
\rowcolor{asenashade}

\asena hand-designed (efficient) & 72.2 & \textbf{.11} & 63.8 & .11 \\
\rowcolor{asenashade}

\asena hand-designed (quality) & \underline{78.8} & .22 & \textbf{67.1} & .24 \\
\rowcolor{asenashade}

\asena self-evolved 17 (low) & 74.8 & \underline{.13} & 64.9 & \textbf{.08} \\
\rowcolor{asenashade}

\asena self-evolved 17 (high) & \textbf{81.2} & .25 & \underline{65.5} & .22 \\
\bottomrule
\end{tabularx}

\end{table}
表:冻结的 EQA 工作区:准确率(%)与归一化探索步数。阴影表示最终工作区。
\begin{table}[t]
  \centering
  \caption{冻结的 EQA 工作区:准确率(\%)与归一化探索步数。阴影表示最终工作区。}
  \label{tab:eqaevolve}
  \footnotesize
  \setlength{\tabcolsep}{3.2pt}
  \begin{tabularx}{\columnwidth}{ll*{4}{Y}}
    \toprule
    & & \multicolumn{2}{c}{HM-EQA} & \multicolumn{2}{c}{MT-HM3D} \\
    \cmidrule(lr){3-4}\cmidrule(lr){5-6}
    轮次 & 推理强度 & 准确率$\uparrow$ & 步数$\downarrow$ & 准确率$\uparrow$ & 步数$\downarrow$ \\
    \midrule

    基线 & 低 & 70.9 & .153 & 64.8 & .101 \\

    4 & 低 & 73.4 & \underline{.136} & \textbf{66.5} & \underline{.091} \\

    9 & 低 & \underline{75.8} & .147 & \underline{65.5} & .116 \\

    11 & 低 & 75.4 & .152 & 65.3 & .114 \\
    \rowcolor{asenashade}

    17 & 低 & 74.8 & \textbf{.127} & 64.9 & \textbf{.076} \\
    \rowcolor{asenashade}

    17 & 高 & \textbf{81.2} & .253 & \underline{65.5} & .224 \\
    \bottomrule
  \end{tabularx}
\end{table}
强编程智能体无需学习式导航策略也能有效导航
仅使用几何与编程工具,GPT-6 Astra便取得当前最佳性能,并超过独立的ASENA-VLN。 在 R2R 上,其成功率也接近已报告的人类表现,即 90% SR。凭借强大的推理能力, 该智能体无需依赖学习式导航策略,即可理解指令、构建路线、监控进度并从错误中 恢复。这些结果表明,编程智能体本身就是强大的零样本导航系统。
学习式导航提升较弱编程后端的性能
ASENA-VLN对Claude Sonnet 5的帮助更为明显。加入该策略后,成功率与路径效率均有 提升,R2R 和 RxR 上的 SR 均提高 11 个百分点。因此,专用策略能够弥补路线执行 方面的不足,使较弱的编程后端完成更多任务。相比之下,GPT-6 Astra即使不使用该 策略也有很强的表现,因而从中获益较少;在 RxR 上,启用该策略甚至略微降低其 成功率。因此,学习式导航的价值取决于编程后端,以及后端将策略预测融入规划的 有效程度。
学习式导航减少重复的智能体交互
单次ASENA-VLN调用可执行多个运动决策,从而减少重复的观测与动作请求。对于每种 后端和基准,平均工具调用次数均有所下降(表(tab:navigation)):GPT-6 Astra在 R2R/RxR 上分别下降 46.9%/51.0%,Claude Sonnet 5则分别下降 59.2%/62.5%。 因此,即使成功率变化不大,该策略也能承担低层导航。这些调用次数的下降表明, 学习式导航在提升较弱后端性能的同时,也可减少智能体交互,与强智能体的直接 编程控制形成互补。
保留经验提升重复任务的性能
通过重复提供相同的任务、场景、指令与初始位姿来评估工作区演化。在每一轮中, 16 个采用高推理强度的Claude Sonnet 5工作智能体执行任务,并可在各自的私有工作区 中保留程序、笔记与先前的动作序列。两轮之间,一个改进智能体利用这些智能体的 轨迹与反馈更新规范工作区。在 R2R 和 RxR 上,分别开展使用和不使用ASENA-VLN 的实验,并采用真实反馈,同时固定所有模型、策略与控制器权重。
如图(fig:navevolve)所示,四组实验的成功率均随轮次提升。在 R2R 上,使用与 不使用ASENA-VLN的变体最终成功率相近;对于更长的 RxR 指令,该策略仍保持更明显 的优势。在两个基准上,配备工具的工作区也保持更高的 SPL,表明即使最终成功率 趋于一致,ASENA-VLN仍能提高路径效率。随着工作区演化,记录的工作智能体与改进 智能体成本也随之下降。这些结果表明,无需更新模型权重,保留经验即可提升重复 任务的性能并降低成本,而学习式导航仍能带来效率优势。
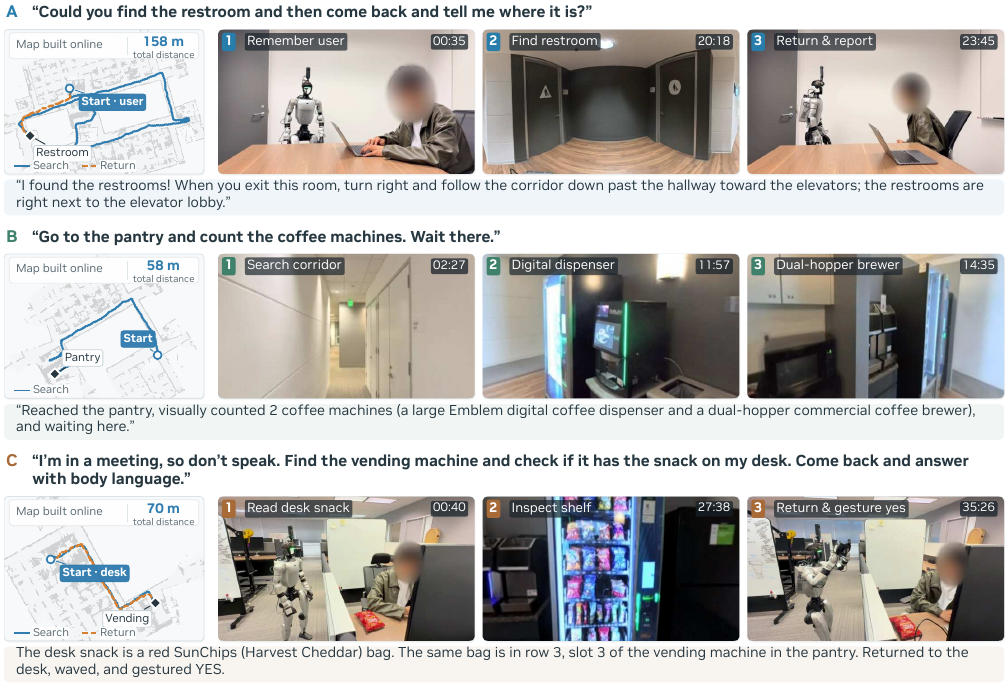
图:G1 机器人上的真实世界导航与交互。 三项监督任务将在线地图和记录的轨迹与观测及响应对应起来。蓝色实线与橙色虚线 分别表示搜索和返回。距离根据行驶里程计估算。提示与响应经精简后展示。
具身问答
具身问答(Embodied Question Answering, EQA)要求智能体探索环境、收集相关视觉 证据,并以尽可能少的运动回答问题。使用 HM-EQA 和 MT-HM3D 发布的初始位姿评估 ASENA [ren2024exploreeqa,zhai2025memoryeqa]。按照 Explore-EQA 的瞬移协议, 对于面积为 \(A\) 的场景,每个回合的名义步数预算为 \(3\sqrt{A}\)。报告答案准确率与 归一化探索步数,后者定义为智能体消耗步数占该名义预算的比例。
手工设计的参考配置
EQA 智能体组合使用导航、视觉检查、物体搜索、地点记忆与答案生成工具。首先构建 两个手工设计的配置作为参考点。质量配置优先收集足够证据以正确回答问题, 且不接收任何明确要求减少探索的指令。高效配置则通过提示将探索步数视为 有限资源,更有选择地收集证据。在 HM-EQA 上,为高效智能体设置相当于名义预算 30% 的目标预算,同时为两种配置保留相同的仿真器硬上限。这些配置给出了人工 设计的准确率与效率运行点,并非针对单一组件的受控消融实验。
工作区演化协议
接着研究智能体能否通过修改工作区改善这一权衡。构建固定演化池,其中包含训练 场景中的 398 个 HM-EQA 问题和 1,183 个 MT-HM3D 问题。每一轮中,16 个工作 智能体从每个基准抽取 50 个问题,使用私有工作区执行任务并反思结果。独立的改进 智能体汇总其轨迹与修改,以更新规范工作区;所有模型权重始终保持固定。未被工作 智能体抽取的问题用于监控,其汇总结果也会提供给改进智能体。
工作区演化改善成本--准确率权衡
冻结工作区后,第 17 轮在 HM-EQA 上取得最高准确率(81.2%),第 4 轮则在 MT-HM3D 上表现最佳(66.5%)(表(tab:eqaevolve))。在低推理强度下,演化后 的工作区以与手工设计的高效配置相近的步数取得了更高准确率 (表(tab:eqa))。随着工作区获得新流程并完善现有指导,不同修订版本的改进 幅度有所变化,形成不同的准确率与探索效率权衡。
学习式导航减少探索
在 132 个 MT-HM3D 问题的配对消融实验中,ASENA-VLN使归一化探索步数的中位数 降低约 19%,而准确率几乎不变。与前述 R2R 和 RxR 结果一致,学习式导航通过 减少重复的智能体交互来提高效率。
真实世界应用
使用 Unitree G1 在三项监督任务上评估ASENA(图(fig:robot))。每项任务中, 机器人都需要在此前未见且没有预建地图的环境中搜索初始不可见的目标。机器人在线 收集视觉与几何证据,并利用记忆和多模态交互完成用户请求。
在洗手间任务中,机器人定位电梯厅附近的门,基于在线地图推理出从用户位置出发的 更短路线,并返回提供路线指引。在茶水间任务中,机器人找到房间,检查饮水机与 咖啡冲煮机,并报告有两台咖啡机。零食比较任务要求机器人检查参考零食、找到自动 售货机、判断是否有相同商品、返回用户身边,并生成全身姿态动作作为回答。这些 任务展示了开放世界搜索、证据收集、空间推理、记忆与多模态交互。总体而言,它们 说明在线程序修订如何突破预定义技能库,将导航扩展到自适应搜索与用户交互。
图(fig:teaser)展示了精简后的记录代码,该代码将 LiDAR 几何信息转换为地图, 并提出航路点(橙色)。通过安全检查并获得操作员批准后,执行过程返回相机观测, 供后续推理使用。生成的姿态动作在由 SONIC 执行前须通过在线仿真检查。
讨论与结论
ASENA统一了编程智能体编程、监督执行与持久化技能,在模型权重固定的情况下提升 重复任务的性能。可选的 4B 单目ASENA-VLN策略基于精选的原子导航数据训练,以更少 的智能体交互在 R2R/RxR 上取得领先的成功率。ASENA也取得了领先的 EQA 准确率。 在 G1 上,在线编程将导航扩展至搜索、检查与交互,其中包括在线合成并验证的全身 响应动作。
真实世界任务需要 10--20 分钟,因此仍需加快推理与执行速度。未来工作将强化面向 动态环境的安全防护,并将工作区演化扩展到学习式导航策略的更新。
致谢
感谢 Jarred Travers、Amanpreet Singh、Peter Pham、Jinhyung (David) Park、Xiangchen Tian 和 Tingwu Wang 对真实机器人基础设施提供的帮助。
参考文献
- [anderson2018r2r] P. Anderson, Q. Wu, D. Teney et al., ``Vision-and-language navigation: Interpreting visually-grounded navigation instructions in real environments,'' in CVPR, 2018.
- [ku2020rxr] A. Ku, P. Anderson, R. Patel, E. Ie, and J. Baldridge, ``Room-across-room: Multilingual vision-and-language navigation with dense spatiotemporal grounding,'' in EMNLP, 2020.
- [zhang2024navid] J. Zhang, K. Wang, R. Xu et al., ``NaVid: Video-based VLM plans the next step for vision-and-language navigation,'' in RSS, 2024.
- [cheng2025navila] A.-C. Cheng, Y. Ji, Z. Yang et al., ``NaVILA: Legged robot vision-language-action model for navigation,'' in RSS, 2025.
- [wei2025streamvln] M. Wei, C. Wan, X. Yu et al., ``StreamVLN: Streaming vision-and-language navigation via slowfast context modeling,'' in ICRA, 2026.
- [liang2022codeaspolicies] J. Liang, W. Huang, F. Xia et al., ``Code as policies: Language model programs for embodied control,'' in ICRA, 2023, pp. 9493--9500.
- [fu2026capx] L. Fu, J. Yu, K. El-Refai et al., ``CaP-X: A framework for benchmarking and improving coding agents for robot manipulation,'' arXiv preprint arXiv:2603.22435, 2026.
- [lu2026aspire] R. Lu, Y. Wu, E. Kou et al., ``ASPIRE: Agentic /skills discovery for robotics,'' arXiv preprint arXiv:2607.00272, 2026.
- [wang2023voyager] G. Wang, Y. Xie, Y. Jiang et al., ``Voyager: An open-ended embodied agent with large language models,'' Transactions on Machine Learning Research, 2024.
- [shinn2023reflexion] N. Shinn, F. Cassano, A. Gopinath, K. Narasimhan, and S. Yao, ``Reflexion: Language agents with verbal reinforcement learning,'' in NeurIPS, 2023.
- [xiao2026enpire] W. Xiao, J. Xie, T. Zhang et al., ``ENPIRE: Agentic robot policy self-improvement in the real world,'' arXiv preprint arXiv:2606.19980, 2026.
- [chen2022duet] S. Chen, P.-L. Guhur, M. Tapaswi, C. Schmid, and I. Laptev, ``Think global, act local: Dual-scale graph transformer for vision-and-language navigation,'' in CVPR, 2022.
- [an2023etpnav] D. An, H. Wang, W. Wang et al., ``ETPNav: Evolving topological planning for vision-language navigation in continuous environments,'' TPAMI, vol. 47, no. 7, pp. 5130--5145, 2025.
- [shah2023lm] D. Shah, B. Osi\'nski, B. Ichter, and S. Levine, ``LM-Nav: Robotic navigation with large pre-trained models of language, vision, and action,'' in CoRL, 2023.
- [long2024instructnav] Y. Long, W. Cai, H. Wang, G. Zhan, and H. Dong, ``InstructNav: Zero-shot system for generic instruction navigation in unexplored environment,'' in CoRL, 2025.
- [wei2025dualvln] M. Wei, C. Wan, J. Peng et al., ``Ground slow, move fast: A dual-system foundation model for generalizable vision-language navigation,'' in ICLR, 2026.
- [qwen2026robotnav] Qwen Team, ``Qwen-RobotNav technical report: A scalable navigation model designed for an agentic navigation system,'' 2026, arXiv:2606.18112.
- [ding2026unilavira] H. Ding, S. Zhang, Z. Xu et al., ``Uni-LaViRA: Language-vision-robot actions translation for unified embodied navigation,'' arXiv preprint arXiv:2605.27582, 2026.
- [ren2024exploreeqa] A. Z. Ren, J. Clark, A. Dixit, M. Itkina, A. Majumdar, and D. Sadigh, ``Explore until confident: Efficient exploration for embodied question answering,'' in RSS, 2024.
- [yang2025threedmem] Y. Yang, H. Yang, J. Zhou et al., ``3D-Mem: 3D scene memory for embodied exploration and reasoning,'' in CVPR, 2025.
- [saxena2025grapheqa] S. Saxena, B. Buchanan, C. Paxton et al., ``GraphEQA: Using 3D semantic scene graphs for real-time embodied question answering,'' in CoRL, 2025.
- [zhai2025memoryeqa] M. Zhai, Z. Gao, Y. Wu, and Y. Jia, ``Memory-centric embodied question answering,'' 2025, arXiv:2505.13948.
- [zhang2026fasteqa] H. Zhang, N. Savaliya, F. Siddiqui, and E. Sachdeva, ``FAST-EQA: Efficient embodied question answering with global and local region relevancy,'' in WACV, 2026.
- [foxglove2024mcap] Foxglove Developers, ``MCAP: Serialization-agnostic log container file format,'' https://github.com/foxglove/mcap, 2024, accessed: September 15, 2026.
- [luo2025sonic] Z. Luo, Y. Yuan, T. Wang et al., ``SONIC: Supersizing motion tracking for natural humanoid whole-body control,'' Science Robotics, vol. 11, no. 117, p. eaed4592, 2026.
- [zhang2025uninavid] J. Zhang, K. Wang, S. Wang et al., ``Uni-NaVid: A video-based vision-language-action model for unifying embodied navigation tasks,'' in RSS, 2025.
- [zhu2026navida] W. Zhu, Z. Zhang, X. Wang et al., ``NaVIDA: Vision-language navigation with inverse dynamics augmentation,'' arXiv preprint arXiv:2601.18188, 2026.
- [zeng2026janusvln] S. Zeng, D. Qi, X. Chang et al., ``JanusVLN: Decoupling semantics and spatiality with dual implicit memory for vision-language navigation,'' in ICLR, 2026.
- [xin2026decovln] Z. Xin, W. Li, Y. Jiang et al., ``DecoVLN: Decoupling observation, reasoning, and correction for vision-and-language navigation,'' in CVPR, 2026.
- [zhang2026activevln] Z. Zhang, W. Zhu, H. Pan et al., ``ActiveVLN: Towards active exploration via multi-turn RL in vision-and-language navigation,'' in ICRA, 2026.
- [wang2026qwenvla] Q. Wang, M. Li, J. Guan et al., ``Qwen-VLA: Unifying vision-language-action modeling across tasks, environments, and robot embodiments,'' arXiv preprint arXiv:2605.30280, 2026.
- [cai2025internvlan1] Intern Robotics, ``InternVLA-N1: An open dual-system vision-language navigation foundation model with learned latent plans,'' 2025, technical report, Shanghai AI Laboratory.
- [dang2026rynnbrain] R. Dang, J. Guo, B. Hou et al., ``RynnBrain: Open embodied foundation models,'' arXiv preprint arXiv:2602.14979, 2026.
- [qiao2025opennav] Y. Qiao, W. Lyu, H. Wang et al., ``Open-Nav: Exploring zero-shot vision-and-language navigation in continuous environment with open-source LLMs,'' in ICRA, 2025.
- [chen2024canav] K. Chen, D. An, Y. Huang et al., ``Constraint-aware zero-shot vision-language navigation in continuous environments,'' TPAMI, vol. 47, no. 11, pp. 10 441--10 456, 2025.
- [yin2025gcvln] H. Yin, H. Wei, X. Xu, W. Guo, J. Zhou, and J. Lu, ``GC-VLN: Instruction as graph constraints for training-free vision-and-language navigation,'' in CoRL, 2025.
- [zheng2026threestepnav] W. Zheng, Y. Ge, and L. Itti, ``Three-Step Nav: A hierarchical global-local planner for zero-shot vision-and-language navigation,'' in AISTATS, 2026.
- [zhou2026embodied] J. Zhou, X. Zhao, G. Zhou et al., ``Embodied agents take control: Minimal-interface zero-shot agents rival industrial-scale policies in vision-and-language navigation,'' arXiv preprint arXiv:2607.26148, 2026.
- [qwen2025qwen3vl] S. Bai, Y. Cai, R. Chen et al., ``Qwen3-VL technical report,'' 2025, arXiv:2511.21631.
- [wang2023scalevln] Z. Wang, J. Li, Y. Hong et al., ``Scaling data generation in vision-and-language navigation,'' in ICCV, 2023.
- [wang2025srdf] Z. Wang, J. Li, Y. Hong et al., ``Bootstrapping language-guided navigation learning with self-refining data flywheel,'' in ICLR, 2025.
- [openai2026gpt55] OpenAI, ``GPT-5.5,'' 2026.
- [sensenova-si] Z. Cai, R. Wang, C. Gu et al., ``Scaling spatial intelligence with multimodal foundation models,'' in CVPR, 2026.
- [google2026gemini31flashlite] Google DeepMind, ``Gemini 3.1 Flash-Lite model card,'' Google DeepMind, Tech. Rep., 2026.
- [zhu2026sysnav] H. Zhu, Z. Li, Z. Liu et al., ``SysNav: Multi-level systematic cooperation enables real-world, cross-embodiment object navigation,'' arXiv preprint arXiv:2603.06914, 2026.
- [jiang2025fineeqa] K. Jiang, Y. Liu, W. Chen et al., ``Beyond the destination: A novel benchmark for exploration-aware embodied question answering,'' in ICCV, 2025.
- [hong2020subinstruction] Y. Hong, C. Rodriguez, Q. Wu, and S. Gould, ``Sub-instruction aware vision-and-language navigation,'' in Proceedings of the 2020 Conference on Empirical Methods in Natural Language Processing (EMNLP). 1em plus 0.5em minus 0.4em Association for Computational Linguistics, 2020, pp. 3360--3376.
- [ramakrishnan2021hm3d] S. K. Ramakrishnan, A. Gokaslan, E. Wijmans et al., ``Habitat-matterport 3D dataset (HM3D): 1000 large-scale 3D environments for embodied AI,'' in Proceedings of the Neural Information Processing Systems Track on Datasets and Benchmarks, vol. 1, 2021.
- [insta360x5webcam] Insta360, ``X5: Webcam live streaming tutorial using OBS,'' https://onlinemanual.insta360.com/x5/en-us/camera/appuse/obs, accessed September 9, 2026.
- [livoxmid360specs] Livox, ``MID-360 specifications,'' https://www.livoxtech.com/mid-360/specs, accessed September 9, 2026.
补充材料
原子指令格式与训练数据
表:存储的导航标注。策略接收目标文本、质量以及可选的终止位姿锚点 ((tab:atomic_examples_nv))。基于坐标的点目标采用独立输入格式。
\begin{table}[H]
    \centering
    \footnotesize
    \setlength{\tabcolsep}{6pt}
    \begin{tabularx}{\linewidth}{@{}ll>{\raggedright\arraybackslash}X@{}}
        \toprule
        \textbf{存储字段} & \textbf{类型} & \textbf{含义} \\
        \midrule
        \makecell[l]{\textbf{goal\_type}\\\textbf{goal\_value}} & category; text &
            目标类别与文本。重写标题的记录可以仅存储目的地短语,而原始指令和
            生成的原子任务保留完整指令。类别包括物体、区域、自身、范围和点。 \\
        \textbf{route\_steps} & 有序列表 &
            单独标注时使用的有序方向和地标提示。 \\
        \textbf{constraints} & 列表 &
            避障、穿越或相对位置要求。 \\
        \textbf{end\_pose} & 锚点列表 &
            根据场景几何推导的目标、空间关系和距离,以物体、房间或机器人起始
            位置为参照。 \\
        \textbf{quality} & 1--5 &
            用于策略条件控制的质量标注或指定设置。R2R/RxR评估取值为5。 \\
        \bottomrule
    \end{tabularx}
    \caption{存储的导航标注。策略接收目标文本、质量以及可选的终止位姿锚点
    (\Cref{tab:atomic_examples_nv})。基于坐标的点目标采用独立输入格式。}
    \label{tab:atomic_format}
\end{table}
表:ASENA-VLN的训练数据池。数据池大小计入质量与后退动作过滤、替代 视角、思维链(CoT)变体、重复的轨迹结束窗口以及采样权重。各项计数独立取整, 且包含重复样本;其表示可用数据池规模,而非训练期间实际使用的样本数。 采样细节见(sec:supp:training_scope)。
\begin{table}[H]
    \centering
    \footnotesize
    \setlength{\tabcolsep}{6pt}
    \begin{tabular}{llcc}
        \toprule
        \textbf{数据集} & \textbf{监督信号} & \textbf{加权数据池(百万)} & \textbf{环境} \\
        \midrule

        R2R~\citep{anderson2018r2r}             & 轨迹,像素,CoT & 1.502 & MP3D \\
        R2R(增强)                              & 轨迹,像素       & 3.290 & MP3D \\
        FGR2R~\citep{hong2020subinstruction}    & 轨迹,像素       & 0.704 & MP3D \\
        RxR~\citep{ku2020rxr}                   & 轨迹,像素,CoT & 4.191 & MP3D \\
        RxR(增强)                              & 轨迹,像素       & 4.836 & MP3D \\
        ScaleVLN~\citep{wang2023scalevln}       & 轨迹,像素,CoT & 3.120 & HM3D \\
        SRDF~\citep{wang2025srdf}               & 轨迹,像素       & 3.916 & HM3D \\
        ObjectNav MP3D v3                       & 轨迹,像素       & 0.707 & MP3D \\
        ObjectNav HM3D v3~\citep{ramakrishnan2021hm3d} & 轨迹,像素 & 2.888 & HM3D \\
        Nav-atoms(合成,MP3D)                 & 轨迹,像素       & 1.443 & MP3D \\
        Nav-atoms(合成,HM3D)                 & 轨迹,像素       & 1.825 & HM3D \\
        VLN-MME及其他通用VQA                    & VQA              & 0.964 & 多种 \\
        SenseNova-SI~\citep{sensenova-si}       & VQA              & 8.164 & 多种 \\
        \midrule
        \textbf{轨迹数据池}                    &                  & \textbf{28.422} & \\
        \textbf{VQA数据池}                     &                  & \textbf{9.128} & \\
        \bottomrule
    \end{tabular}
    \caption{\capravln{}的训练数据池。数据池大小计入质量与后退动作过滤、替代
    视角、思维链(CoT)变体、重复的轨迹结束窗口以及采样权重。各项计数独立取整,
    且包含重复样本;其表示可用数据池规模,而非训练期间实际使用的样本数。
    采样细节见\Cref{sec:supp:training_scope}。}
    \label{tab:training_data}
\end{table}
训练采样
训练使用64台设备,有效批量大小为512。每台设备每步处理三个轨迹样本和一个 视觉问答(Visual Question Answering, VQA)样本,并跨两步累积梯度。训练至 第8,400步时共抽取4,300,800个样本(含重复样本),达到第0.1178轮。VQA数据池 将一轮定义为71,309次更新。由于轨迹数据池更大,每轮仅采样其中一部分。为强化 停止行为,对每个符合条件的轨迹结束窗口额外复制五份。数据池还包含替代视角、 思维链(Chain-of-Thought, CoT)变体和重复观测。
Jetson Thor量化与运行时性能
为在G1的Jetson AGX Thor上运行该策略,使用NVIDIA ModelOpt进行训练后FP8量化, 并用TensorRT-Edge-LLM构建推理引擎。这些测量采用训练至第8,400步的早期 ASENA-VLN检查点,与(tab:vln-policy)中的基准策略不同。所有FP8变体均量化 语言模型;标记为``BF16视觉''的变体将含4.15亿参数的视觉编码器保持为BF16。 所有变体中的嵌入层和输出投影层均不量化。
仅用于导航的引擎需要预测运动词元,而非通用文本。因此,将输出词表从152,596项 缩减至768项,同时保留全部660个轨迹词元。由此从每个解码步计算的输出投影层中 移除3.887亿个参数。
表:Unitree G1的Jetson AGX Thor上的策略推理。这些测量采用与基准策略 不同的早期检查点。所有变体的批量大小均为1,使用相同的八帧混合分辨率历史, 并执行32步贪心解码。总计为三个组件之和;加速比根据未取整的总和计算。BF16 端到端实测延迟为2,735 ms。导出大小指对应ONNX文件的大小。BF16模型加载后 占用8.28 GiB分配内存,此数值并非峰值运行内存。BF16结果为五次预热运行的 中位数:预填充时间等于首词元延迟减去视觉编码时间,解码则将余下31个词元的 耗时缩放至32步。TensorRT-Edge-LLM的视觉编码和预填充数值为10次运行均值, 解码数值为五次运行的中位数。
\begin{table}[H]
    \centering
    \footnotesize
    \setlength{\tabcolsep}{4pt}
    \begin{tabular}{lrrrrrr}
        \toprule
        \textbf{变体} & \textbf{导出大小} & \textbf{视觉编码} & \textbf{预填充} &
        \textbf{解码(32步)} & \textbf{总计} & \textbf{加速比} \\
        & \textbf{(GiB)} & \multicolumn{4}{c}{\textbf{延迟(ms)}} & \\
        \midrule

        PyTorch BF16                 & 9.01 & 167.3 & 363.4 & 2,275.5 & 2,806 & 1.00$\times$ \\

        FP8,BF16视觉编码器            & 5.63 & 73.3 & 128.7 & 847.4 & 1,050 & 2.67$\times$ \\
        FP8,BF16视觉编码器,缩减词表  & 4.91 & 78.3 & 125.5 & 694.1 & 898 & 3.13$\times$ \\
        FP8,缩减词表                  & 4.53 & 64.9 & 129.1 & 683.4 & 877 & 3.20$\times$ \\
        \bottomrule
    \end{tabular}
    \caption{Unitree G1的Jetson AGX Thor上的策略推理。这些测量采用与基准策略
    不同的早期检查点。所有变体的批量大小均为1,使用相同的八帧混合分辨率历史,
    并执行32步贪心解码。总计为三个组件之和;加速比根据未取整的总和计算。BF16
    端到端实测延迟为2,735\,ms。导出大小指对应ONNX文件的大小。BF16模型加载后
    占用8.28\,GiB分配内存,此数值并非峰值运行内存。BF16结果为五次预热运行的
    中位数:预填充时间等于首词元延迟减去视觉编码时间,解码则将余下31个词元的
    耗时缩放至32步。TensorRT-Edge-LLM的视觉编码和预填充数值为10次运行均值,
    解码数值为五次运行的中位数。}
    \label{tab:quant_latency}
\end{table}
表:早期量化模型及其BF16版本在256个留出输入上的预测一致率。首航点一致 要求第一个预测的\((x,y,\theta)\)元组匹配;完整轨迹精确一致要求整条预测轨迹 匹配。这些指标衡量输出一致性,而非导航成功率。
\begin{table}[H]
    \centering
    \footnotesize
    \setlength{\tabcolsep}{8pt}
    \begin{tabular}{lcc}
        \toprule
        \textbf{变体} & \textbf{首航点一致率} &
        \textbf{完整轨迹精确一致率} \\
        \midrule

        FP8                       & 90.23\% & 75.39\% \\
        FP8,BF16视觉编码器       & 91.41\% & 82.81\% \\
        \bottomrule
    \end{tabular}
    \caption{早期量化模型及其BF16版本在256个留出输入上的预测一致率。首航点一致
    要求第一个预测的$(x,y,\theta)$元组匹配;完整轨迹精确一致要求整条预测轨迹
    匹配。这些指标衡量输出一致性,而非导航成功率。}
    \label{tab:quant_fidelity}
\end{table}
(tab:quant_latency)展示了各推理阶段的耗时。采用缩减词表的FP8后,各组件 延迟之和从2,806 ms降至877 ms;在相同输入设置下,相比PyTorch BF16加速 3.20\(\times\)。解码仍是开销最大的阶段,耗时683.4 ms,占FP8总时延的78%。 无需改变视觉编码或预填充即可降低该开销:在采用BF16视觉编码器的变体中,缩减 词表使解码耗时从847.4降至694.1 ms(下降18.1%),其余两个阶段基本不变。
(tab:quant_fidelity)检验量化预测在留出输入上与BF16模型的吻合程度。视觉 编码器保持BF16可提高首个航点和完整轨迹的一致率。这些检验衡量输出一致性, 导航成功率仍需单独进行滚动评估。设备端检验还确认了导航词元ID有效,且八航点 轨迹格式正确。
原子导航数据集样本
{4pt}
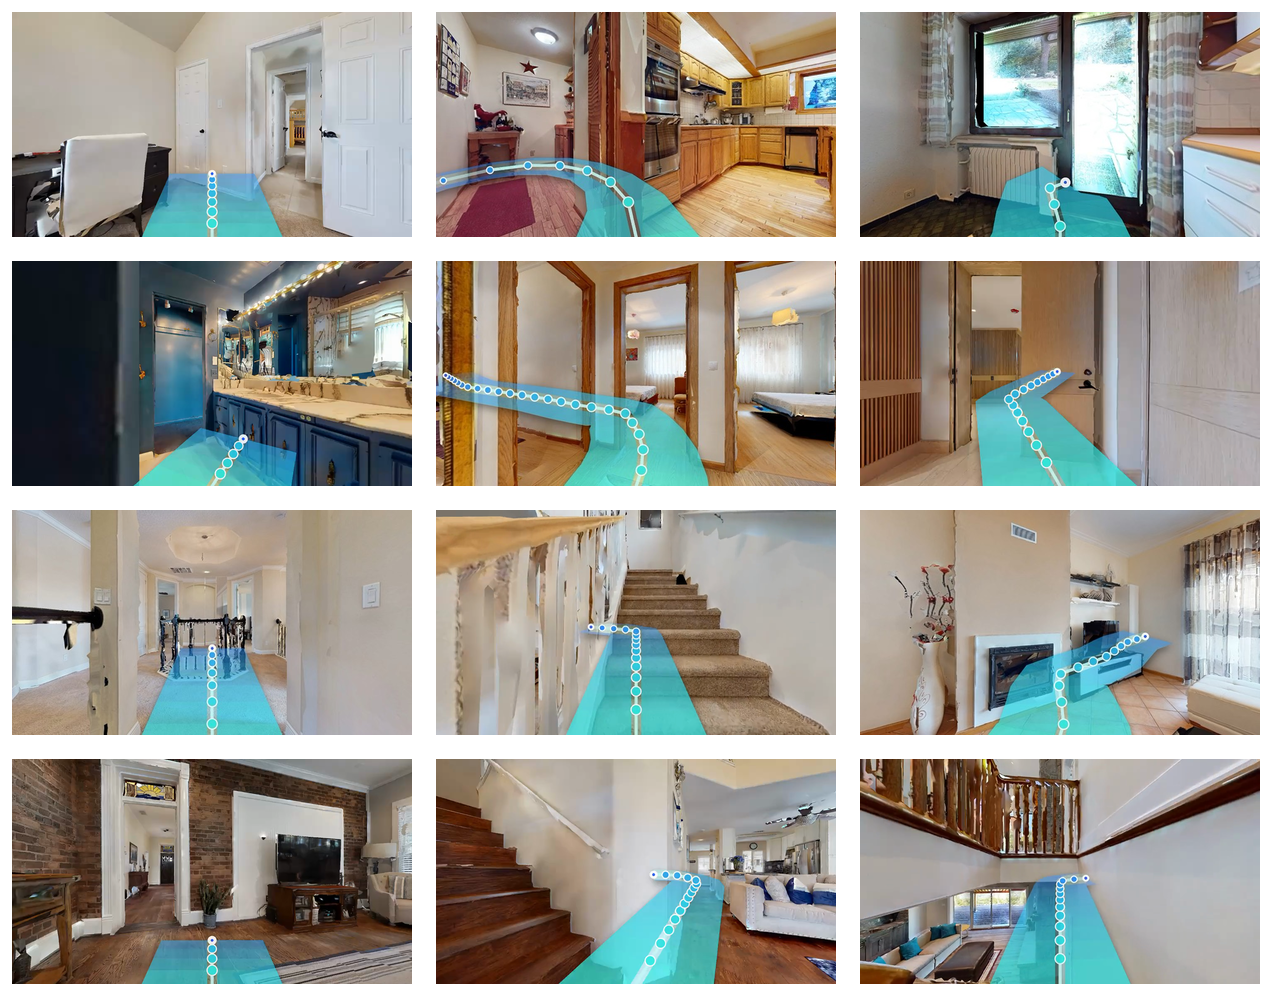
图:原子导航训练样本。每个观测都与一条指令和叠加轨迹配对。 叠加轨迹未采用度量相机投影。样本涵盖度量运动、旋转、相对目标、对齐、 房间目标、门、走廊和楼层变换。
导航指令与策略输入
{3pt} {6pt}
(tab:atomic_examples_nv)展示了导航指令如何表示为策略输入。每个输入包含 目标文本和质量设置。可选的终止位姿锚点描述机器人应在物体、房间或起始位置 的何种相对位置停下。
表:导航指令与策略输入。每个JSON输入包含目标文本和质量设置, 还可包含指定机器人终止位置的终止位姿锚点。
\begin{table}[H]
\centering
\small
\setlength{\tabcolsep}{7pt}
\caption{\textbf{导航指令与策略输入。}每个JSON输入包含目标文本和质量设置,
还可包含指定机器人终止位置的终止位姿锚点。}
\label{tab:atomic_examples_nv}
\begin{tabularx}{\linewidth}{@{}p{0.44\linewidth}X@{}}
\toprule
导航指令 & 策略输入(JSON) \\
\midrule
\textbf{Route following}\par Descend down the stairs. Turn left and stop in the room.  & \begin{minipage}[t]{\linewidth}\raggedright\ttfamily\fontsize{8}{9.5}\selectfont \{"goal": "Descend down the stairs. Turn left and stop in the room. ",\\ "quality": 5\}\end{minipage} \\
\addlinespace[8pt]
\textbf{Metric motion}\par Could you move forward 1 meters for me? & \begin{minipage}[t]{\linewidth}\raggedright\ttfamily\fontsize{8}{9.5}\selectfont \{"goal": "Could you move forward 1 meters for me?",\\ "quality": 5,\\ "end\_pose": [\{\\   "target": "agent\_start",\\   "relation": "forward",\\   "distance\_m": 1.0\\ \}]\}\end{minipage} \\
\addlinespace[8pt]
\textbf{Relative object goal}\par Walk over to the built-in dishwasher off to your left. & \begin{minipage}[t]{\linewidth}\raggedright\ttfamily\fontsize{8}{9.5}\selectfont \{"goal": "Walk over to the built-in dishwasher off to your left.",\\ "quality": 5,\\ "end\_pose": [\{\\   "target": "built-in dishwasher",\\   "relation": "near",\\   "distance\_m": 0.55\\ \}]\}\end{minipage} \\
\addlinespace[8pt]
\textbf{Room goal}\par Stop there once you find a bedroom. & \begin{minipage}[t]{\linewidth}\raggedright\ttfamily\fontsize{8}{9.5}\selectfont \{"goal": "Stop there once you find a bedroom.",\\ "quality": 5,\\ "end\_pose": [\{\\   "target": "bedroom",\\   "relation": "inside",\\   "distance\_m": 0.0\\ \}]\}\end{minipage} \\
\addlinespace[8pt]
\textbf{Floor change}\par Make your way downstairs to the hallway. & \begin{minipage}[t]{\linewidth}\raggedright\ttfamily\fontsize{8}{9.5}\selectfont \{"goal": "Make your way downstairs to the hallway.",\\ "quality": 5,\\ "end\_pose": [\{\\   "target": "hallway",\\   "relation": "inside",\\   "distance\_m": 0.0\\ \}]\}\end{minipage} \\
\bottomrule\end{tabularx}\end{table}
方向、路线提示和约束保留在指令文本中。终止位姿距离以米表示,并四舍五入至
小数点后两位。房间目标使用关系inside,距离为0.0。五个样本的质量
均设为5。策略同时接收该指令输入与视觉历史。
G1硬件与导航设置
{6pt} {4pt}
G1配备安装在桅杆上的全景相机和倒置的Livox Mid-360激光雷达 ((fig:g1_hardware_nv))。Jetson AGX Thor运行本地传感器与运动服务。 相机接口同时支持Insta360 X5和Ricoh Theta X。(tab:g1_hardware_nv) 列出传感器与状态输出,(tab:g1_drive_nv)汇总导航设置和指令限制。
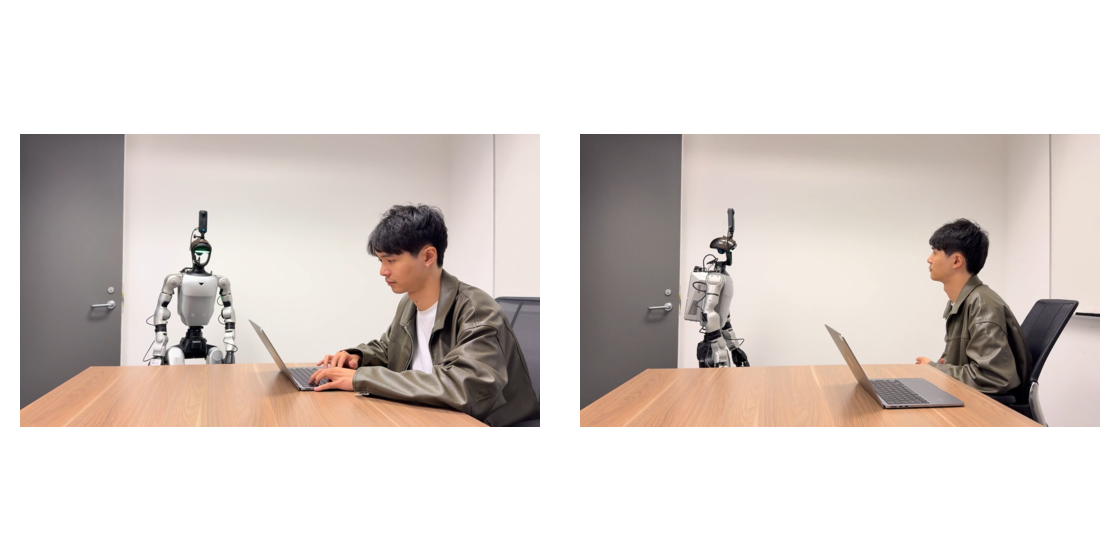
图:G1传感器安装位置。正视图和侧视图展示传感器在机器人上的位置。
表:传感器与状态接口。标称规格与配置的发布频率。激光雷达角度 采用制造商定义的方向。
\begin{table}[H]
\centering
\small
\setlength{\tabcolsep}{5pt}
\renewcommand{\arraystretch}{1.12}
\caption{\textbf{传感器与状态接口。}标称规格与配置的发布频率。激光雷达角度
采用制造商定义的方向。}
\label{tab:g1_hardware_nv}
\begin{tabularx}{\linewidth}{@{}p{0.18\linewidth}>{\raggedright\arraybackslash}X >{\raggedright\arraybackslash}X@{}}
\toprule
组件 & 原生输入/规格 & 配置输出 \\
\midrule

Insta360 X5 & USB panorama: $2880\!\times\!1440$; 30\,fps~\citep{insta360x5webcam}
  & 6\,Hz JPEG;180\degree{}偏航校正 \\
Livox Mid-360 & 200,000点/s;视场:水平360\degree,垂直$-7\degree$至$52\degree$~\citep{livoxmid360specs}
  & SLAM桥接:10\,Hz;每批最多20,000点 \\
机体状态 & 29个关节的位置/速度;IMU、里程计和模式
  & 20\,Hz \\
\bottomrule
\end{tabularx}
\end{table}
表:导航设置与安全保护机制。慢速行走控制器限制单条指令和路径段的 速度、持续时间与幅度。
\begin{table}[H]
\centering
\small
\setlength{\tabcolsep}{5pt}
\renewcommand{\arraystretch}{1.1}
\caption{\textbf{导航设置与安全保护机制。}慢速行走控制器限制单条指令和路径段的
速度、持续时间与幅度。}
\label{tab:g1_drive_nv}
\begin{tabularx}{\linewidth}{@{}>{\raggedright\arraybackslash}X l >{\raggedright\arraybackslash}X l@{}}
\toprule
参数 & 数值 & 参数 & 数值 \\
\midrule

指令发布频率 & 10\,Hz & 路径前视距离 & 0.40\,m \\
平移速度范围 & 0.12--0.35\,m/s & 制动提前时间 & 0.60\,s \\
近目标速度($\le0.5$\,m) & 0.25\,m/s & 速度指令有效期 & 2.0\,s \\
到达容差 & 0.10\,m;4\degree & 活跃任务心跳超时 & 3.0\,s \\
移动/转向指令限制 & 2.0\,m;180\degree & 路径分段限制 & 6.0\,m;16个点 \\
移动任务超时 & 25\,s & 路径任务超时 & 45\,s \\
\bottomrule
\end{tabularx}
\end{table}
慢速行走设置控制运动速度、停止容差、指令幅度和超时,可在运行时调整;系统还 提供独立的行走步态。相机偏航校正设定全景图的水平方向。机器人头部和身体会 部分遮挡倒置激光雷达的视场。