LongStream:长序列流式自回归视觉几何
作者: Chong Cheng、Xianda Chen、Tao Xie、Wei Yin、Weiqiang Ren、Qian Zhang、Xiaoyang Guo、Hao Wang
机构: 香港科技大学(广州)、地平线机器人、浙江大学、中南大学
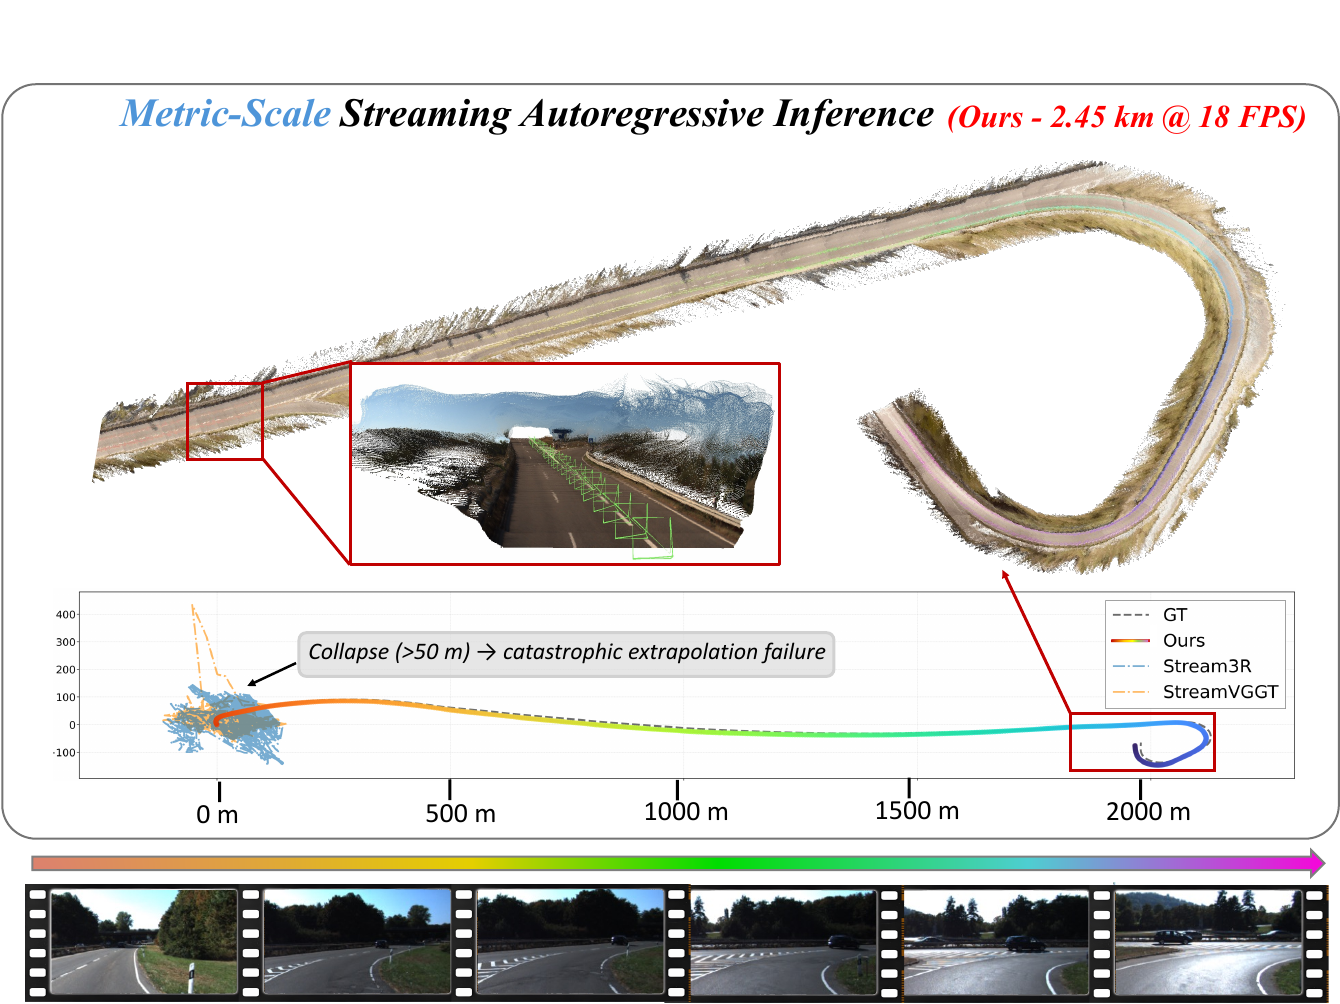
图:面向度量尺度场景重建的流式自回归模型对比。 现有流式模型(例如 Stream3R、StreamVGGT)受外推误差影响,在数十米范围内便会崩溃。相比之下,LongStream 可稳定完成公里级重建。其规范解耦表述与缓存一致训练保持度量精度和几何稳定性,并在数公里长序列上维持 18 FPS。
摘要
长序列流式三维重建(Streaming 3D Reconstruction)仍是一项重要的开放性挑战。 现有自回归模型在处理长序列时往往失效,因为其将位姿锚定于第一帧,进而导致注意力衰减、尺度漂移(Scale Drift)和外推误差。 本文提出 LongStream,这是一种规范解耦(Gauge-Decoupled)的流式视觉几何模型,可在严格在线且未来帧不可见(Future-Invisible)的设定下,对数千帧序列进行度量尺度(Metric Scale)场景重建。 本文方法包含三个方面。首先,舍弃第一帧锚点并预测关键帧相对位姿(Keyframe-Relative Pose),将长距离外推重新表述为难度恒定的局部任务。其次,提出正交尺度学习(Orthogonal Scale Learning),将几何与尺度估计完全解耦,以抑制漂移。 最后,我们发现 Transformer 存在注意力偏置问题,包括对注意力汇聚点(Attention Sink)的依赖和长期 KV 缓存(KV Cache)饱和。 为此,本文提出缓存一致训练(Cache-Consistent Training,CCT)并结合周期性缓存刷新(Periodic Cache Refresh)。该方法抑制超长序列中的注意力偏置与污染,缩小训练与推理之间的差距。 实验表明,LongStream 达到当前最佳性能,能够以 18 FPS 对公里级序列进行稳定的度量尺度重建。项目主页:https://3dagentworld.github.io/longstream/
引言
几何重建是从图像序列中联合估计相机位姿与稠密三维结构的技术 [Schonberger_2016_CVPR, schoenberger2016mvs, cheng2025graphguidedscenereconstructionimages, yao2018mvsnetdepthinferenceunstructured, song2024gvkfgaussianvoxelkernel, 10.1145/3664647.3681168],也是自动驾驶、增强现实/虚拟现实(Augmented Reality/Virtual Reality,AR/VR)和具身机器人等应用的基础技术 [10.1145/3664647.3681641, shen2025adhmraligningdiffusionbasedhuman]。这些领域要求系统能够实时、稳健地处理长序列视频流。
传统流程 [Schonberger_2016_CVPR, schoenberger2016mvs, yao2018mvsnetdepthinferenceunstructured, yao2019recurrent, Wang_2024]与近期基于 Transformer 的方法 [wang2024dust3r, leroy2024grounding, wang2025vggt, wang2025pi, hu2025vggt4dminingmotioncues, wang2025jasmine]虽达到当前最佳精度,但本质上均为离线方法。每当加入新帧时,它们都需重新处理整个序列 [lan2025stream3r, zhuo2025streaming],造成大量冗余计算,因而无法实时运行。 为解决这一问题,研究者提出了流式模型。STream3R [lan2025stream3r] 和 StreamVGGT [zhuo2025streaming] 等近期工作采用因果 Transformer 与 KV 缓存逐步构建重建结果。然而,这些模型处理长序列时会遭遇灾难性的外推失效。如图1和图 [fig:memory] 所示,现有流式方法虽能以线性时间逐步重建场景,但其轨迹在数十米内便会崩溃,最终导致跟踪完全失效。
我们认为,这种失效源于当前模型固有的“规范耦合(Gauge-Coupled)”设计。这些模型锚定于第一帧坐标系,并通过训练回归绝对位姿。 这种设计迫使模型学习位置固定的映射,使长序列预测愈加困难。受硬件限制,模型在训练批次中只能接触较小的帧索引,因此在推理时难以可靠外推至较大索引。由此,“短序列训练、长序列测试”偏差 [press2022trainshorttestlong, dai2019transformerxlattentivelanguagemodels]造成了域差距。
为此,本文提出 LongStream——一种“规范解耦”的流式自回归几何框架。该框架从理论上解耦全局 \(SE(3)\) 坐标与度量尺度的规范自由度。
首先,为处理长序列中的坐标规范问题,我们移除固定的第一帧锚点,转而回归关键帧相对位姿。由此,欠定的长距离外推问题被重新表述为难度恒定的局部估计任务,使预测不受全局坐标选择影响。
其次,为解决 Sim(3) 尺度漂移问题,本文引入正交尺度学习机制 [yang2024depthanythingunleashingpower],在目标函数层面解耦几何学习与度量尺度估计。几何分支在尺度不变空间中优化形状,专用尺度头则独立预测全局尺度因子。这种设计有效减少尺度纠缠,确保稳定的度量输出。
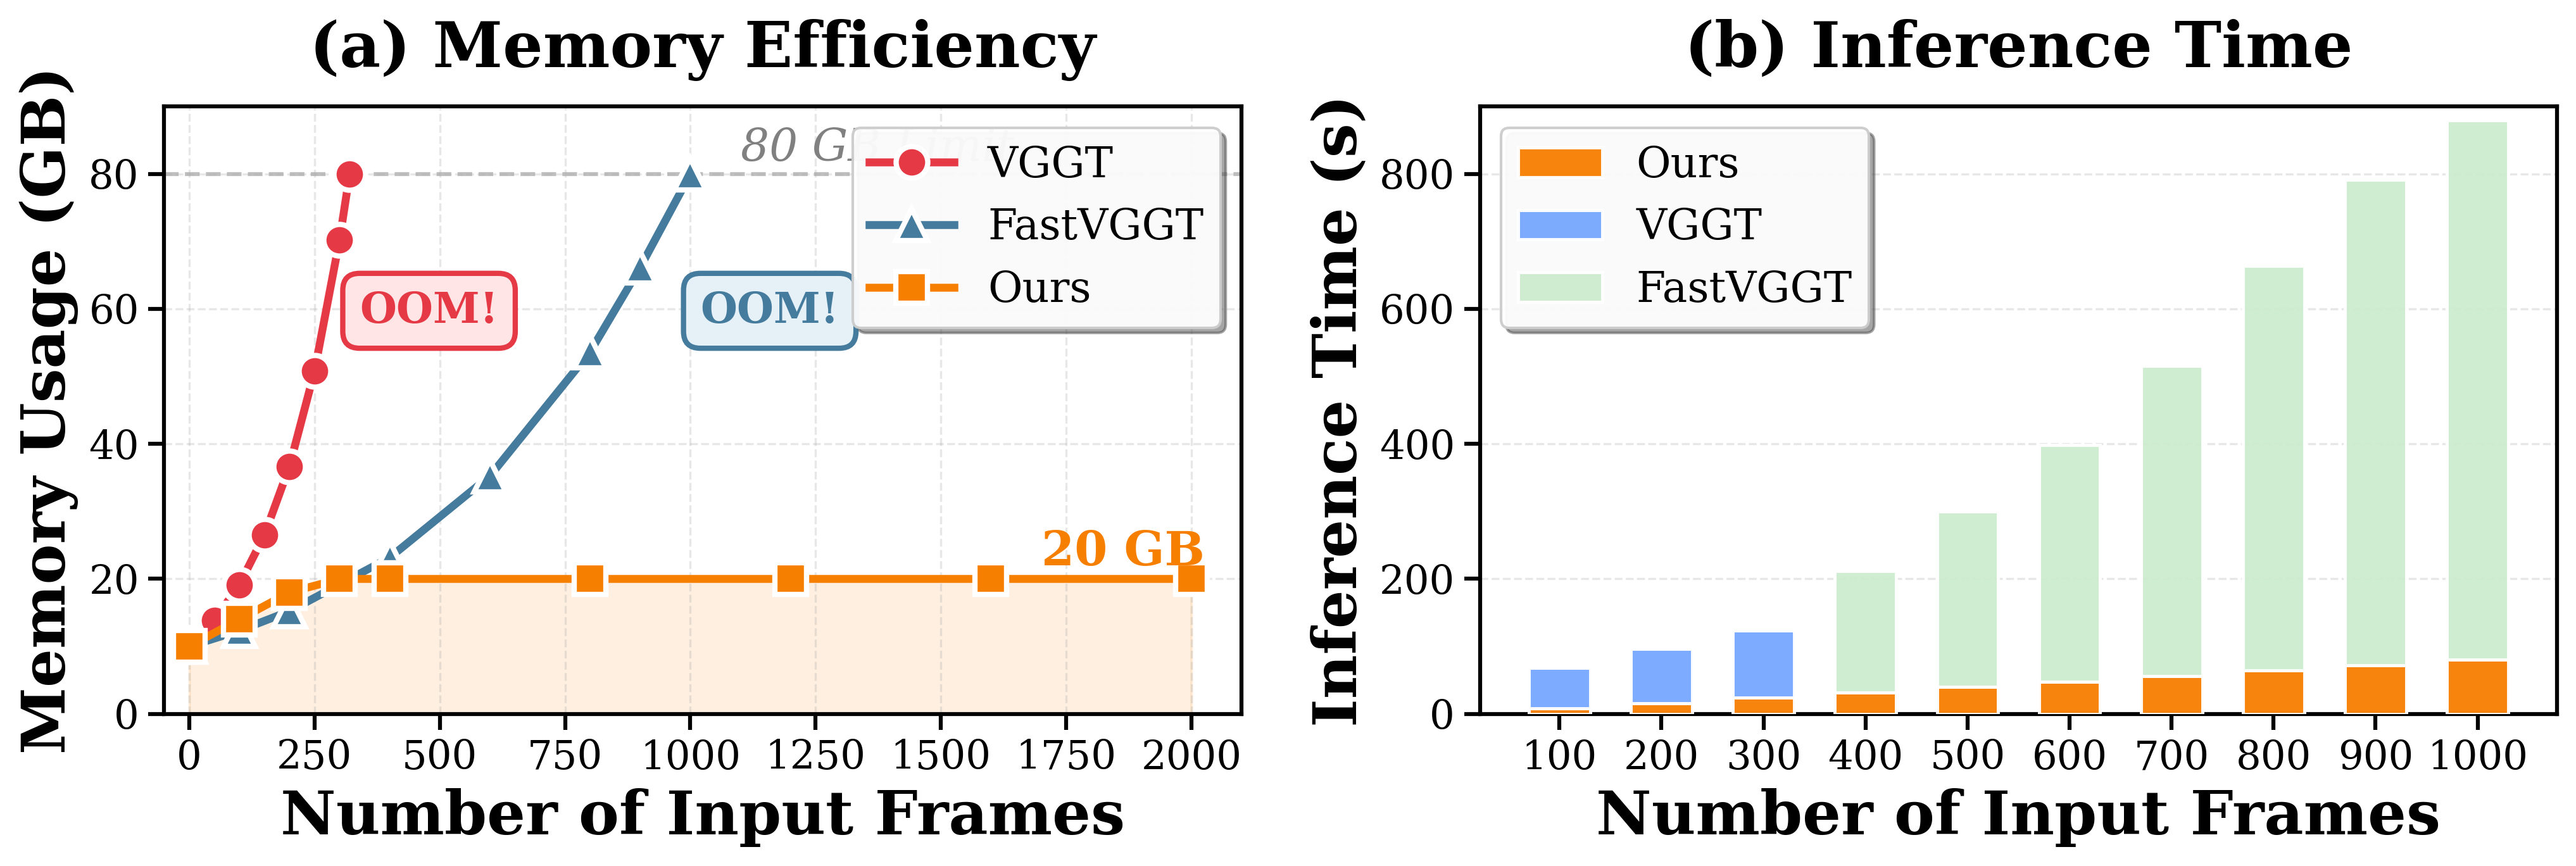
图:内存与运行时间对比。 本文方法的内存占用和延迟保持稳定,而 VGGT 与 FastVGGT 随序列增长迅速上升,并在长序列上发生内存溢出(Out of Memory,OOM)。
除规范解耦表述外,流式 Transformer 架构本身也存在挑战。我们发现,注意力汇聚点 [xiao2024efficientstreaminglanguagemodels](即对第一帧词元的偏置依赖)与长期 KV 缓存污染是时序性能退化和漂移的主要原因。 为解决这些问题,本文提出缓存一致训练方案,在训练时显式传递并裁剪缓存,使训练与推理的上下文保持一致。此外,周期性缓存刷新会边缘化陈旧上下文、缓解长期记忆饱和并稳定几何估计。
在室外数据集(KITTI、vKITTI、Waymo)和室内数据集(TUM-RGBD、ETH3D、7Scenes)上的实验表明,LongStream 实现了当前最佳的流式重建性能,能够在公里级序列上进行实时(18 FPS)的度量尺度 AR 重建。本文的贡献总结如下:
-
本文提出 LongStream,这是一种以“规范解耦”设计为核心的流式几何基础模型。该模型预测关键帧相对位姿,并采用正交尺度解耦,从系统层面消除对第一帧锚点的依赖,有效缓解长序列外推失效。
-
本文发现,对注意力汇聚点的依赖与 KV 缓存污染是长时域(Long-Horizon)性能退化的主要原因。缓存一致训练方案与周期性缓存刷新可稳定时序注意力并减少几何漂移。
-
室内外基准上的实验表明,在严格在线且未来帧不可见的设定下,LongStream 达到当前最佳性能,并在长序列上保持实时吞吐率与稳定的度量尺度。
相关工作
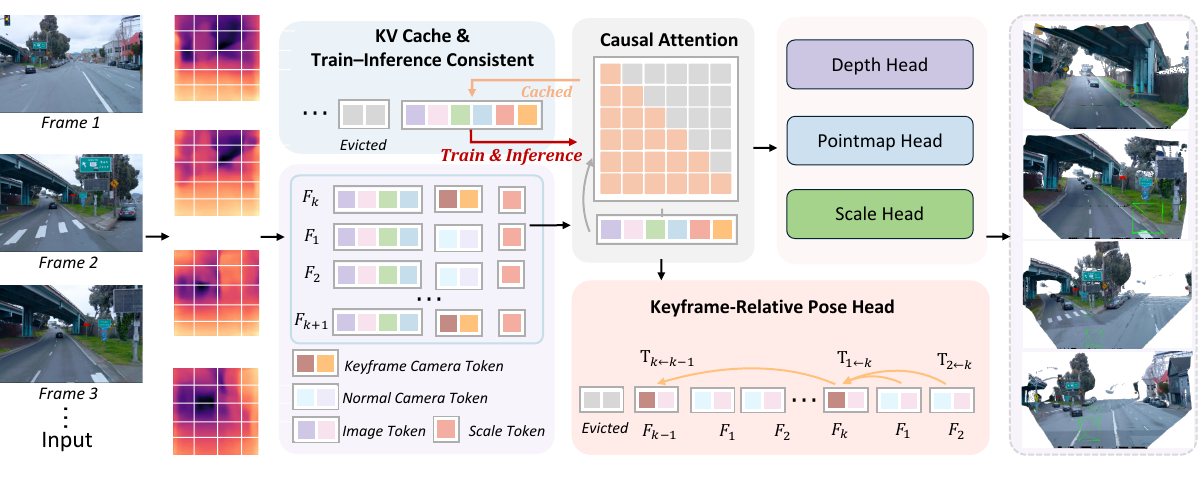
图:本文提出的 LongStream 概览。 对于流式输入,ViT 编码器提取图像块词元,并加入关键帧、普通帧和尺度词元。这些词元通过共享 KV 缓存的因果注意力进行融合;训练与推理阶段均以一致方式使用该缓存,从而实现缓存一致的流式建模。网络预测关键帧相对位姿 \(\mathbf{T}_{i\leftarrow k}\)、深度、点图(Pointmap)和全局尺度, 从而在长序列上实现稳定的度量尺度重建。
经典 SfM 与 MVS。
运动恢复结构(Structure-from-Motion,SfM)与多视图立体(Multi-View Stereo,MVS)流程 [Schonberger_2016_CVPR, schoenberger2016mvs, yao2018mvsnetdepthinferenceunstructured, yao2019recurrent, Galliani_2015_ICCV, fu2022geoneusgeometryconsistentneuralimplicit, cheng2025graphguidedscenereconstructionimages] 通过建模图像对应关系之间的几何联系重建三维场景。 SfM 通过特征匹配与光束法平差(Bundle Adjustment)估计相机位姿和稀疏结构 [Schonberger_2016_CVPR, schoenberger2016mvs],MVS 则利用平面扫描或代价体得到的逐像素深度对结构进行稠密化 [yao2018mvsnetdepthinferenceunstructured, yao2019recurrent, Galliani_2015_ICCV, fu2022geoneusgeometryconsistentneuralimplicit, cheng2025graphguidedscenereconstructionimages]。 这类依赖大量优化并使用手工特征的流程虽然精度较高且可解释性强,但难以扩展到大型或动态场景,也难以实时部署。
离线三维重建。
早期端到端方法主要在图像对上训练 [charatan2024pixelsplat, xu2025freesplatter, zhang2024monst3r, zhang2024gs]。 与体素、网格或隐式场相比,点图计算效率更高且适合实时应用 [sitzmann2019deepvoxels, gkioxari2019mesh, park2019deepsdf, mildenhall2021nerf, cheng2025reggsunposedsparseviews],可用于同步定位与建图(Simultaneous Localization and Mapping,SLAM)和神经渲染 [murai2025mast3r, kerbl20233d, cheng2025unposed3dgsreconstructionprobabilistic, cheng2025outdoormonocularslamglobal, yu2025rgbonlygaussiansplattingslam]。 DUSt3R [wang2024dust3r] 无需相机内参,即可从两幅图像回归点图和相对位姿,但仍局限于成对处理并需要全局对齐。 MASt3R [leroy2024grounding] 引入稠密特征与双向匹配,以提升标定和匹配的稳健性,但仍以图像对为单位运行,处理多视图场景时需要代价高昂的融合。 VGGT [wang2025vggt] 可通过一次前馈过程从多视图输入预测位姿、深度、点图和轨迹,但依赖固定参考帧与绝对位姿监督,因而产生参考帧偏置和尺度偏置。 \(\pi^3\) [wang2025pi] 通过置换等变设计消除参考视图偏置并预测局部点图,但其输出在全局相似变换下仍存在歧义,且不具备度量尺度。
流式三维重建。
流式方法逐帧更新几何。 经典单目 SLAM 与基于学习的变体 [davison2007monoslam, liu2025slam3r, zhu2024nicer, choy20163d, yu2021pixelnerf, wang2021ibrnet]逐步恢复结构与运动。 CUT3R [wang2025continuous] 维护循环状态以在线输出度量点图,但其循环神经网络(Recurrent Neural Network,RNN)骨干难以建模长期依赖,性能会在长序列上退化。 Stream3R [lan2025stream3r] 采用带 KV 缓存的因果 Transformer,虽可扩展至长视频流,但随着缓存词元占据主导,注意力会发生崩溃。 StreamVGGT [zhuo2025streaming] 引入时序因果注意力和缓存更新,并通过蒸馏提升一致性;然而,缓存污染仍使长时域稳定性难以保证。 总体而言,现有流式方法的性能会随序列增长而显著下降,且无法泛化至更长的视频流。
方法
整体框架
本文提出 LongStream,这是一种规范解耦(Gauge-Decoupled)的流式几何框架。如图 [fig:framework] 所示,该框架在统一的时空 Transformer 中联合预测位姿、深度和尺度。 ViT 编码器生成图像块词元,并以相机(Camera)、寄存器(Register)和尺度(Scale)词元对其进行增强,以区分关键帧角色。 这些词元由带共享KV 缓存(KV Cache)的因果聚合器融合,从而支持长序列流式推理。 对于每一帧,模型预测关键帧相对位姿(Keyframe-Relative Pose)\(\mathbf{T}_{i\leftarrow k}\)、深度、点图(Pointmap)以及全局尺度 \(s\)。 训练与推理采用相同的布局,从而实现规范解耦且稳定的度量尺度(Metric Scale)重建。下面详细介绍各个设计组件。
规范解耦表述
本文旨在克服现有流式模型依赖规范耦合(Gauge-Coupled)设计所带来的局限。 我们认为,稳健的几何学习系统在理论上必须对规范自由度保持不变,即不受任意全局坐标和度量尺度影响。 为此,本文提出一个系统分离 \(SE(3)\) 与 \(Sim(3)\) 自由度的框架。
在 \(SE(3)\) 规范中,我们舍弃绝对位姿回归,将位姿学习重新定义为 规范不变(Gauge-Invariant)的相对位姿估计 [ba, 8354808]。 学习目标变为:
其中,\(\mathbf{T}_i\) 和 \(\mathbf{T}_k\) 表示世界坐标系到相机坐标系的绝对位姿,第 \(k\) 帧为前一个关键帧。 对于任意世界坐标系重参数化 \(S \in SE(3)\),该表述在数学上均保持规范不变性。 这一解耦设计同时实现两个目标:一是将大索引引发的分布外(Out-of-Distribution)长距离外推问题 [lan2025stream3r, zhuo2025streaming],转化为索引间隔 \((i-k)\) 有界、难度恒定的分布内(In-Distribution)局部任务;二是缓解固定锚点偏置,后者会导致以首帧为锚点的因果模型不稳定。
在 \(Sim(3)\) 规范中,我们采用尺度不变(Scale-Invariant,SI-Log)思想 [yang2024depthanythingunleashingpower] 解决混乱的尺度纠缠问题。 本文采用正交尺度学习(Orthogonal Scale Learning)机制,在架构和目标函数两个层面分离几何学习与度量尺度估计。 几何分支经过归一化,并依据尺度不变原则进行监督 [yang2024depthanythingunleashingpower];专用尺度头(Scale Head)则预测全局尺度因子 \(s\)。
网络架构
给定输入图像 \(I_i\),模型为每一帧 \(i\) 预测其相对于参考关键帧 \(k\) 的相对位姿, \(\mathbf{p}_{i\leftarrow k}=[\mathbf{t}_{i\leftarrow k},\,\mathbf{q}_{i\leftarrow k},\,f_{i\leftarrow k}]\), 其中 \(\mathbf{t}\) 为平移,\(\mathbf{q}\) 为单位四元数,\(f\) 为焦距偏移。 模型还输出深度图 \(D_i\)、对应的世界坐标点云 \(X_i\)、全局尺度因子 \(s\) 以及帧表示 \(h_i\):
其中 \(h_i\) 表示帧级特征表示。
沿用 VGGT 类流式模型的架构 [wang2025vggt, lan2025stream3r, zhuo2025streaming],本文模型由基于 DINOv2 [oquab2024dinov2learningrobustvisual] 的词元化器、因果 Transformer 聚合器,以及面向相对位姿、深度、点图和尺度的任务专用预测头组成。 几何采用关键帧相对方式建模:每一帧预测其相对于当前关键帧 \(k\) 的位姿和点图,使流式重建不再依赖固定的首帧坐标系。
对于每一帧 \(I_i\),词元化器提取图像块特征 \(x_i^p \in \mathbb{R}^{P\times C}\),并使用相机词元和寄存器词元进行增强,其中关键帧与非关键帧使用不同的词元。 此外,引入共享尺度词元以实现 \(Sim(3)\) 解耦。 所有词元拼接为 \(H^{(0)} \in \mathbb{R}^{B\times S\times(P+T)\times C}\),随后由一组 Transformer 块处理;这些块在严格因果掩码下交替执行帧内注意力和全局注意力:
其输出被送入位姿头、深度头和点图头进行迭代细化。
相对位姿头(Relative Pose Head)。 该预测头从聚合器接收帧特征和关键帧特征,并显式预测当前帧 \(i\) 相对于参考关键帧 \(k\) 的相对变换 \(\mathbf{T}_{i\leftarrow k}\):
其中,平移 \(\mathbf{t}_{i\leftarrow k}\in\mathbb{R}^3\)、旋转 \(\mathbf{q}_{i\leftarrow k}\in\mathbb{H}\)(单位四元数)和焦距偏移 \(f_{i\leftarrow k}\in\mathbb{R}^2\) 共同构成相对相机位姿:
对于世界坐标系的任意右乘变换,该定义均保持不变,从而消除对固定世界锚点的依赖。
为确保模型仅学习 \((i,k)\) 之间的相对关系,本文采用参考帧感知注意力(Reference-Aware Attention)方案。 对于分配给关键帧 \(k\) 的非关键帧 \(i\),在因果掩码或窗口掩码下,其词元仅关注来自 \(k\) 以及 \(k\) 到 \(i\) 之间各帧的词元。 相应地,关键帧词元仅关注来自前一关键帧 \(k\!-\!1\) 以及 \(k\!-\!1\) 到 \(k\) 之间各帧的词元,而非完整历史。 聚合完成后,我们通过拼接和线性投影融合当前帧及其参考关键帧的位姿词元:
最后,沿用 RAFT [teed2020raft] 的设计,该预测头采用 AdaLN 调制的 Transformer,通过增量更新 \(\mathbf{p}^{(t+1)} = \mathbf{p}^{(t)} + \Delta\mathbf{p}^{(t)}\) 迭代预测相对位姿 \(\mathbf{p}_{rel}=[\mathbf{t},\mathbf{q},f]\)。
尺度头。 为实现 \(Sim(3)\) 规范不变性,本文设计了显式尺度头,它接收专用的尺度词元(Scale Token);这一设计与同期工作 MapAnything [keetha2026mapanythinguniversalfeedforwardmetric] 的尺度词元思想相似。
尺度头预测不受约束的对数尺度变量 \(x_s \in \mathbb{R}\),随后对其取指数,得到严格为正的尺度因子:
其中,\(\mathbf{h}_{scale}\) 是聚合器最后一层中尺度词元的特征。 尺度 \(s\) 仅作用于平移、深度和点图输出,旋转与视场角保持不变。 尺度头仅在提供真实度量尺度的数据集上训练。
深度头与点图头。 深度头(Depth Head)和点图头(Pointmap Head)接收聚合后的帧级与图像块级特征,为每一帧预测深度图 \(D_i\in\mathbb{R}^{H\times W}\)、对应的世界坐标点 \(X_i\in\mathbb{R}^{H\times W\times3}\),以及逐像素置信度分数。
这些分支与尺度头协同工作:几何在尺度不变空间内优化,而 ScaleToken 独立学习全局缩放因子,从而实现完整的 \(Sim(3)\) 规范解耦。
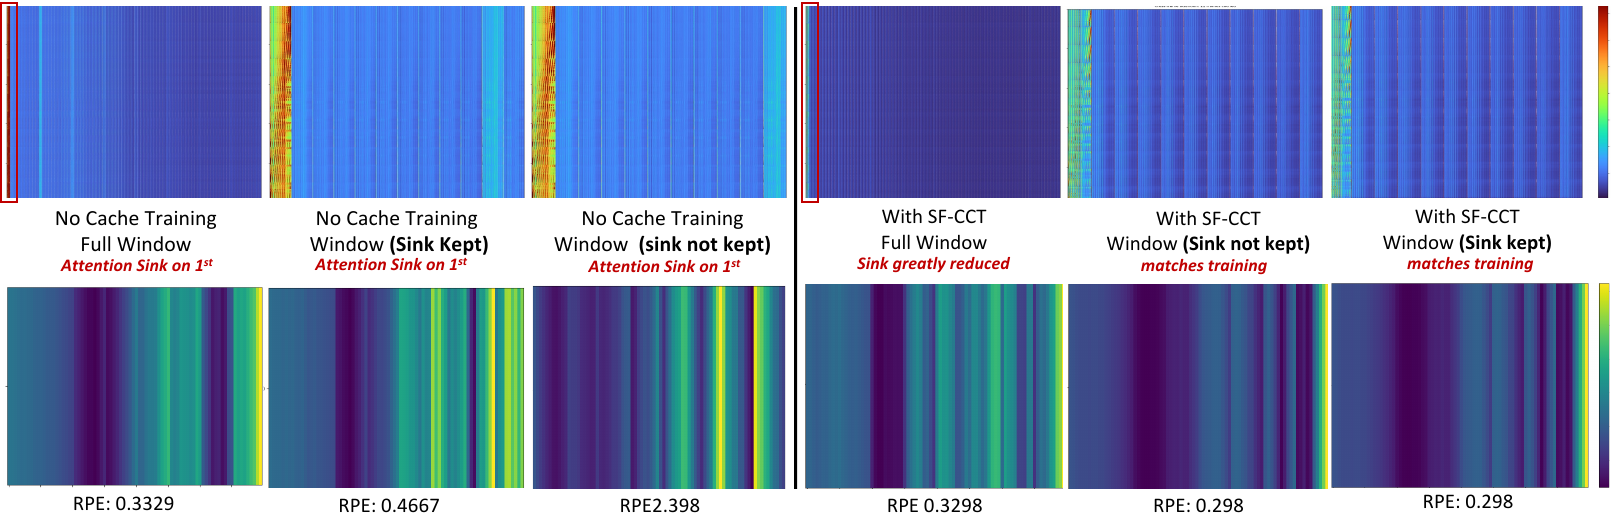
图:缓存一致训练(Cache-Consistent Training,CCT)。 图中展示不同训练–推理设置下的注意力图(上)和相对位姿误差(Relative Pose Error,RPE)热力图(下)。 不采用 CCT 时(左),因果推理会形成明显的注意力汇聚点(Attention Sink);窗口式推理在保留该汇聚点时会将其放大,而移除时则会崩溃。 采用 CCT 后(右),因果模式中的汇聚点受到显著抑制,在两种窗口模式中也同样得到抑制,由此获得稳定且最优的精度。 浅蓝色表示对关键帧的注意。
概率框架与损失函数
为在统一概率框架内实现规范解耦设计,本文将总体目标表述为:给定输入序列,最大化几何、运动与尺度的联合似然。 令 \(I\) 表示图像帧,\(X\) 表示三维点图,\(D\) 表示深度,\(p\) 表示相对位姿,\(s\) 表示全局尺度。 本文最小化负对数后验(Negative Log Posterior):
其中,各项对应后验分解中的一个条件因子:
该因子分解使学习过程与第 [sec:gauge_decoupling] 节介绍的 \(SE(3)\) 和 \(Sim(3)\) 规范不变表述保持一致。
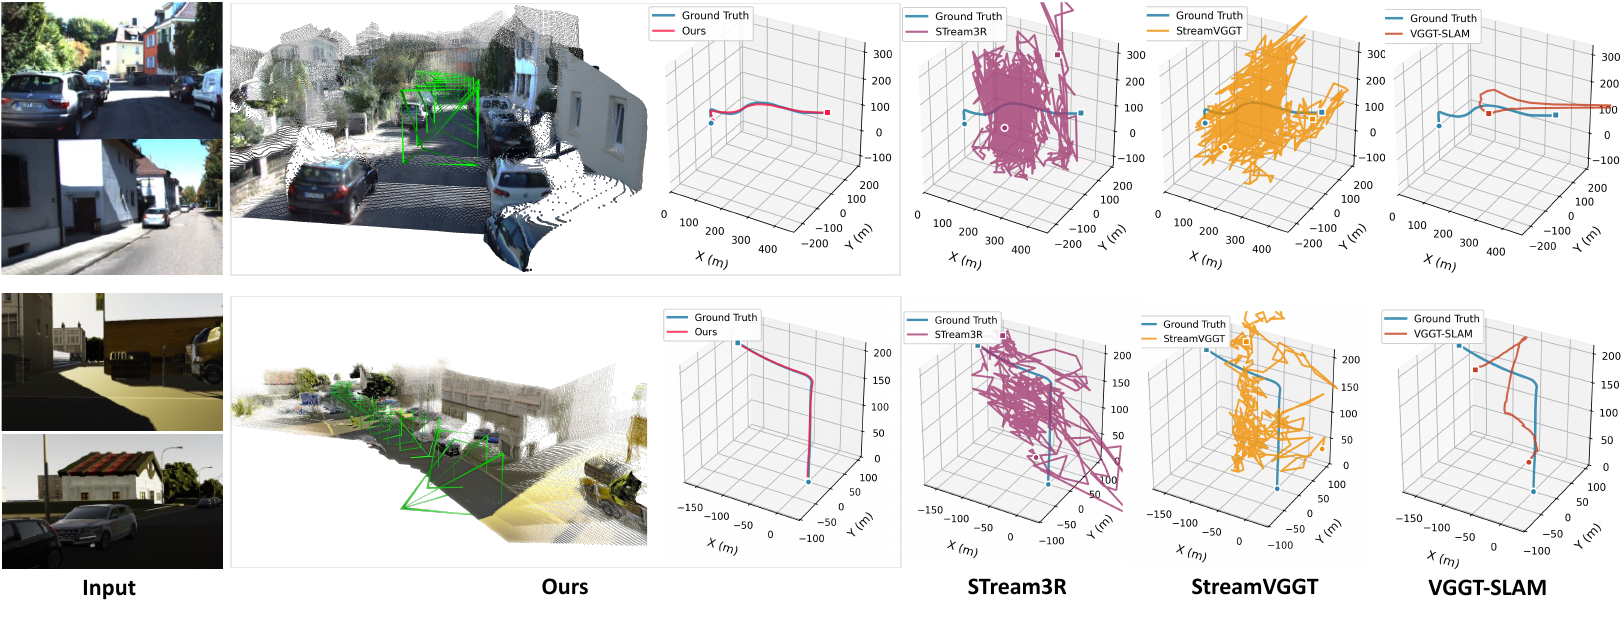
图:长序列位姿估计的定性对比。 我们在跨度达数百米的 KITTI 和 vKITTI 序列上,将 LongStream 与流式方法和 SLAM 基线进行比较。Stream3R 与 StreamVGGT 在长轨迹上不断累积漂移,而 VGGT-SLAM 在第二个 vKITTI 序列上耗尽内存。LongStream 在所有场景中均保持稳定且一致的位姿,即使存在大幅度回环运动也能维持轨迹连续性。
表:KITTI 数据集上的 ATE 定量对比。 上半部分列出基于优化的基线,下半部分给出流式方法。本文方法在所有序列上均取得最高精度。
\begin{table*}[t]
\centering
\footnotesize
\setlength{\tabcolsep}{3pt}
\begin{tabular}{l ccccc ccccc c |c}
\toprule
\multirow{3}{*}{\textbf{方法}} & \multicolumn{11}{c}{\textbf{KITTI~\cite{Geiger2012CVPR}}(ATE $\downarrow$)} & \multirow{3}{*}{\textbf{平均}} \\
\cmidrule(lr){2-12}
& \makecell{00 \\ \tiny 4542x, 3.7km} & \makecell{01 \\ \tiny 1101x, 2.5km} & \makecell{02 \\ \tiny 4661x, 5.1km} & \makecell{03 \\ \tiny 801x, 0.6km} & \makecell{04 \\ \tiny 271x, 0.4km} & \makecell{05 \\ \tiny 2761x, 2.2km} & \makecell{06 \\ \tiny 1101x, 1.2km} & \makecell{07 \\ \tiny 1101x, 0.7km} & \makecell{08 \\ \tiny 4071x, 3.2km} & \makecell{09 \\ \tiny 1591x, 1.7km} & \makecell{10 \\ \tiny 1201x, 0.9km} & \\
\midrule
FastVGGT     & *      & 705.39   & *      & 62.38    & 10.27    & 157.74   & 124.43   & 69.27    & *      & 190.10   & 194.75   & 189.29   \\
MASt3R-SLAM  & *      & 530.37   & *      & 18.87    & 88.98    & 159.430   & 92.00    & *      & *   & *       & *   & 177.93   \\
VGGT-SLAM    & *       & 607.16   & *       & 169.83   & 13.12    & *       & *       & *       & *       & *       & *   & 263.37   \\
\midrule
CUT3R        & 185.89   & 651.52   & 296.98   & 148.06   & 22.17    & 155.61   & 132.54   & 77.03    & 238.39   & 205.94   & 193.39   & 209.78   \\
TTT3R        & 190.93   & 546.84   & 218.77   & 105.28   & 11.62    & 153.12   & 132.94   & 70.95    & 180.57   & 211.01   & 133.00   & 177.73   \\
STream3R     & 190.98   & 681.95   & 301.40   & 158.25   & 102.73   & 159.85   & 135.03   & 90.37    & 261.15   & 216.31   & 207.49   & 227.77   \\
StreamVGGT   & 191.93   & 653.06   & 303.35   & 157.50   & 108.24   & 160.46   & 133.71   & 89.00    & 263.95   & 216.69   & 209.80   & 226.15   \\
\midrule
\textbf{本文方法} & \textbf{92.55} & \textbf{46.01} & \textbf{134.70} & \textbf{3.81} & \textbf{1.95} & \textbf{84.69} & \textbf{23.12} & \textbf{14.93} & \textbf{62.07} & \textbf{85.61} & \textbf{21.48} & \textbf{51.90} \\
\bottomrule

\end{tabular}

\vspace{-8pt}
\caption{\textbf{KITTI 数据集上的 ATE 定量对比。} 上半部分列出基于优化的基线,下半部分给出流式方法。本文方法在所有序列上均取得最高精度。}
\vspace{-10pt}

\end{table*}
相对位姿损失。
相对位姿损失 \(\mathcal{L}_{pose}\) 对应于 \(p(p\mid I)\),并在多次迭代更新中监督 RelPoseHead 的输出 \(\mathbf{p}_{rel}=[\mathbf{t},\mathbf{q},f]\):
其中,\(\ell\) 表示 L1 损失,\(f_{i\leftarrow k}\) 为焦距偏移。 为保持规范解耦,平移项 \(\ell_t\) 在归一化坐标空间内计算,以确保平移监督不会隐式编码全局尺度。
几何损失。
受 SI [yang2024depthanythingunleashingpower] 启发,几何损失 \(\mathcal{L}_{geom}\)(形状优化)对应于 \(p(X\mid p,s,I)\),并在归一化空间内计算:
归一化消除了显式尺度依赖,确保 \(\partial\mathcal{L}/\partial s=0\)。 因此,\(\mathcal{L}_{geom}\) 仅监督主干网络学习正确的三维结构。
尺度损失。
尺度损失 \(\mathcal{L}_{scale}\) 对全局尺度 \(s\) 进行正则化。 由于尺度是乘性的,我们在对数空间比较预测尺度与真实尺度,以衡量相对误差并稳定梯度:
其中,\(s_{gt}\) 是根据标定后的真实深度计算得到的度量尺度。 该损失仅用于经过度量标定的样本;对于非度量数据,仅使用几何损失和深度损失进行训练。
算法:缓存一致训练
\begin{algorithm}[t]
\begin{algorithmic}[1]
\State \textbf{输入:}数据块 $\{c_1,\dots,c_N\}$,初始缓存 $\mathrm{KV}^{(0)}=\emptyset$
\For{$i=1$ to $N$}
    \State $(\text{out}_i,\,\mathrm{KV}^{\text{new}}) = \text{model}(c_i,\,\mathrm{KV}^{(i-1)})$
    \State $\mathrm{KV}^{(i)} = \text{trim}(\mathrm{KV}^{\text{new}},\,\text{window\_size})$
\EndFor
\end{algorithmic}

\end{algorithm}
KV 缓存与训练–推理一致性
流式 Transformer 的既有研究表明,模型往往依赖注意力汇聚点 [xiao2024efficientstreaminglanguagemodels, xu2025streamingvlmrealtimeunderstandinginfinite, yang2025longliverealtimeinteractivelong, shin2026motionstreamrealtimevideogeneration] 来稳定注意力;缺少该汇聚点时,滑动窗口越过首帧便可能触发模型崩溃(Model Collapse)。
然而,这种锚定方式会使模型脆弱地依赖首帧。在长序列中,它会导致几何饱和(Geometric Saturation) [yang2025longliverealtimeinteractivelong],具体表现为注意力不稳定、关键帧跳变以及位姿误差持续增长。 即使采用相对位姿监督,这些问题仍然存在,说明汇聚点锚定本身会引入非对称的位置偏置。
我们认为,“短时域崩溃(Short-Horizon Collapse)”并非由移除汇聚点直接导致,而是训练–推理不匹配的症状。 因此,本文提出算法 [afcct] 所示的缓存一致训练(CCT),通过在数据块之间显式传递并裁剪 KV 缓存,使训练与推理的可见范围保持一致。 训练期间,我们移除恒定的汇聚点词元,并在滑动窗口中采用纯因果掩码;同时,在数据块之间显式传递并裁剪 KV 缓存,使缓存可见性与推理过程一致。
如图 [fig:attention] 所示,CCT 使分块训练与逐帧推理之间的注意力模式在数学上等价,迫使模型在没有持久锚点的纯滑动窗口中运行,从而消除对汇聚点的依赖。
对于超长序列,累积的 KV 仍会导致长期记忆饱和和几何漂移。 因此,本文采用周期性缓存刷新(Periodic Cache Refresh):每隔 \(N\) 个关键帧重置汇聚点帧与 KV 缓存,对陈旧上下文执行硬边缘化,这类似于 SLAM 中的状态边缘化。
该策略在清除退化特征的同时保持几何连续性,无需额外计算即可周期性重置记忆;由于整个模型在关键帧相对坐标系中运行,因此可以在任意关键帧刷新缓存,而不会破坏一致性或降低精度。
结合 CCT 与周期性缓存刷新后,模型能够在数千帧上实现稳定且具备泛化能力的流式处理,同时保持一致的几何精度和行为良好的注意力分布。
实验
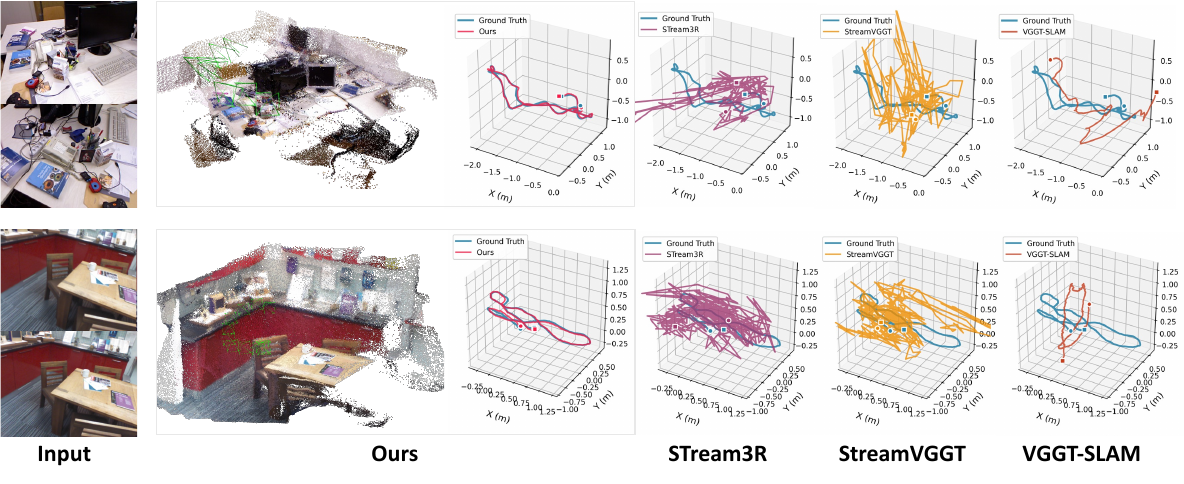
图:室内序列的定性对比。我们在具有剧烈视角变化、遮挡和反复回退的挑战性场景上进行评估。Stream3R、StreamVGGT 和 VGGT-SLAM 在这些高度曲折的轨迹上产生漂移,而 LongStream 在整个序列中均能保持稳定位姿和一致的三维结构。符号 * 表示运行过程中出现内存不足错误或超过三次跟踪失败。
表:在 TUM [sturm12iros]、Oxford Spires [tao2025oxfordspiresdatasetbenchmarking] 和 Waymo [sun2020scalabilityperceptionautonomousdriving] 上的定量对比。上部:基于优化的方法;下部:流式方法。本文方法在这些小尺度轨迹上表现出良好的鲁棒性,并在所有在线基准上取得最佳性能。\(^{\dagger}\) 表示结果引自 [maggio2025vggtslamdensergbslam]。
\begin{table}[t]
\centering
\small
\setlength{\tabcolsep}{6pt}
\renewcommand{\arraystretch}{1.2}
\resizebox{0.42\textwidth}{!}{
\begin{tabular}{lccc}
\toprule
\multirow{2}{*}{\textbf{方法}} &
\textbf{TUM}~\cite{sturm12iros} &
\textbf{Oxford Spires}~\cite{tao2025oxfordspiresdatasetbenchmarking} &
\textbf{Waymo}~\cite{sun2020scalabilityperceptionautonomousdriving} \\
\cmidrule(lr){2-4}
& ATE $\downarrow$ & ATE $\downarrow$ & ATE $\downarrow$ \\
\midrule
FastVGGT      & 0.418    & 36.577   & 1.281 \\
MASt3R-SLAM   & 0.082  & 37.728   & 7.625 \\
VGGT-SLAM     & 0.123 (0.053$^{\dagger}$)  & 31.003   & 7.431 \\
\midrule
CUT3R         & 0.542  & 32.440   & 9.396 \\
TTT3R         & 0.308  & 36.214   & 3.486 \\
STream3R      & 0.633  & 37.569   & 42.203 \\
StreamVGGT    & 0.627  & 37.255   & 45.101 \\
\midrule
本文方法      & \textbf{0.076} & \textbf{19.815} & \textbf{0.737} \\
\bottomrule
\end{tabular}
}

\vspace{-6pt}
\caption{\textbf{在 TUM~\cite{sturm12iros}、Oxford Spires~\cite{tao2025oxfordspiresdatasetbenchmarking} 和 Waymo~\cite{sun2020scalabilityperceptionautonomousdriving} 上的定量对比。}上部:基于优化的方法;下部:流式方法。本文方法在这些小尺度轨迹上表现出良好的鲁棒性,并在所有在线基准上取得最佳性能。$^{\dagger}$ 表示结果引自~\cite{maggio2025vggtslamdensergbslam}。}
\vspace{-8pt}

\end{table}
表:在 vKITTI 上的定量对比。上部:基于优化的方法;下部:流式方法。本文方法在所有序列上均取得最高精度。
\begin{table}[t]
\centering
\small
\setlength{\tabcolsep}{1.8pt}
\renewcommand{\arraystretch}{1.2}
\resizebox{0.48\textwidth}{!}{
\begin{tabular}{lccccc|c}
\toprule
\multirow{3}{*}{方法} &
\multicolumn{6}{c}{vKITTI~\cite{cabon2020virtual} (ATE $\downarrow$)} \\
\cmidrule(lr){2-7}
& \makecell{\footnotesize 场景 01 \\ $447\times, 332m$}
& \makecell{\footnotesize 场景 02 \\ $223\times, 113m$}
& \makecell{\footnotesize 场景 06 \\ $270\times, 51m$}
& \makecell{\footnotesize 场景 18 \\ $339\times, 254m$}
& \makecell{\footnotesize 场景 20 \\ $837\times, 711m$}
& \makecell{\textbf{平均}} \\
\midrule
FastVGGT      & 3.435  & 0.311  & 0.120  & 2.050  & 101.667 & 31.427 \\
MASt3R-SLAM   & 83.771 & 20.206 & 3.840  & 68.875 & 231.064 & 98.714 \\
VGGT-SLAM     & 25.128 & 0.237  & 0.281  & 1.641  & 68.840  & 23.667 \\
\midrule
CUT3R         & 50.968 & 29.913 & 0.820  & 29.012 & 127.583 & 55.276 \\
TTT3R         & 29.877 & 11.785 & 0.598  & 7.445  & 71.208  & 28.099 \\
STream3R      & 68.280 & 26.450 & 8.185  & 43.597 & 198.279 & 82.815 \\
StreamVGGT    & 71.616 & 15.349 & 10.274 & 23.900 & 221.407 & 83.916 \\
\midrule
本文方法      & \textbf{1.422} & \textbf{0.185} & \textbf{0.303} & \textbf{0.683} & \textbf{4.030}  & \textbf{1.610} \\

\bottomrule
\end{tabular}
}

\vspace{-6pt}
\caption{\textbf{在 vKITTI 上的定量对比。}上部:基于优化的方法;下部:流式方法。本文方法在所有序列上均取得最高精度。}
\vspace{-16pt}

\end{table}
实现细节
模型配置。 LongStream 以 VGGT 初始化,并保留其由全局注意力与帧级注意力交替组成的 \(24\) 层骨干网络,参数量约为 \(1.3B\)。
训练时采用固定的可见性布局、一致的滑动窗口以及大小为十的关键帧间隔,使每个批次包含多次关键帧切换。 优化器采用 AdamW 和余弦衰减,峰值学习率为 \(4\times10^{-6}\),并设置 \(1k\) 步预热。所有图像、深度和点图均缩放至最长边不超过 \(518\) 像素,同时采用宽高比抖动、间隔采样和跨块打乱。
训练方法。
LongStream 采用两阶段训练方案:第一阶段在 \(32\) 块 A100 GPU 上以批大小 \(22\) 进行 \(50k\) 次批次独立训练,耗时三天;第二阶段采用与流式推理匹配的缓存一致训练(Cache-Consistent Training,CCT),序列长度从 \(10\) 到 \(80\) 之间采样,缓存窗口大小设为 \(10\)。 仅在具有已标定真值时使用度量尺度监督。 推理时,LongStream 在单块 GPU 上可达到 \(18\) FPS。更多实现细节见附录。
训练数据。 LongStream 使用多领域数据集集合进行训练,包括
Kubric [greff22kubric:]、 WildRGB [xia2024rgbd]、 ScanNet [dai2017scannet]、 HyperSim [hypersim]、 Mapillary [MPSD_2020_ECCV]、 Replica [straub2019replica]、 MVS-Synth [mvssynth]、 PointOdyssey [zheng2023point]、 Virtual KITTI [cabon2020virtual]、 Aria Synthetic Environments [Pan_2023_ICCV]、 Aria Digital Twin [Pan_2023_ICCV]、 Objaverse [deitke2023objaverse]、Spring [mehl2023springhighresolutionhighdetaildataset] 和 Waymo Open [sun2020scalabilityperceptionautonomousdriving]。 BlendedMVS [yao2020blendedmvs]、Co3Dv2 [reizenstein21common]、MegaDepth [li2018megadepth] 和 DL3DV [ling2024dl3dv] 不提供度量尺度真值,因而不参与尺度训练;其余训练数据集均提供度量监督。
基线方法。
我们将 LongStream 与离线 Transformer、流式模型和 SLAM 类系统进行比较。由于 VGGT [wang2025vggt] 和 \(\pi^3\) [wang2025pi] 在长视频片段上均超出内存限制,因此使用 FastVGGT [shen2025fastvggttrainingfreeaccelerationvisual] 作为可实际运行的替代方案。流式基线包括 CUT3R [wang2025continuous]、TTT3R、STream3R [lan2025stream3r] 和 StreamVGGT [zhuo2025streaming]。MASt3R-SLAM [murai2025mast3r] 与 VGGT-SLAM [maggio2025vggtslamdensergbslam] 是基于优化的 SLAM 基线。VGGT-SLAM 以 16/32 帧为块进行推理,因此可以访问每个块内的未来帧。所有方法均采用官方默认设置,并在统一协议下评估。
表:在 7Scenes 和 TUM 上的定量对比。评估指标为 Chamfer 距离(Chamfer Distance,CD,越低越好)和 F1@0.25(越高越好)。 最佳结果以粗体标出,次佳结果以下划线标出。
\begin{table}
\centering
\small
\setlength{\tabcolsep}{6pt}
\renewcommand{\arraystretch}{1.2}
\resizebox{0.4\textwidth}{!}{
\begin{tabular}{lcc|cc}
\toprule
\multirow{2}{*}{\textbf{方法}} &
\multicolumn{2}{c|}{\textbf{7Scenes}} &
\multicolumn{2}{c}{\textbf{TUM}} \\
\cmidrule(lr){2-3} \cmidrule(lr){4-5}
& CD $\downarrow$ & F1@0.25 $\uparrow$
& CD $\downarrow$ & F1@0.25 $\uparrow$ \\
\midrule
FastVGGT
& 6.373 & \textbf{0.710}
& \underline{0.104} & \underline{0.926} \\
MASt3R-SLAM
& 5.987 & 0.691
& \textbf{0.057} & \textbf{0.954} \\
VGGT-SLAM
& 6.306 & \underline{0.696}
& 1.993 & 0.633 \\
\midrule
CUT3R
& 6.281 & 0.274
& 0.474 & 0.533 \\
TTT3R
& 6.231 & 0.260
& 0.249 & 0.792 \\
STream3R
& \underline{6.353} & 0.479
& 1.126 & 0.444 \\
StreamVGGT
& 6.630 & \underline{0.483}
& 0.680 & 0.402 \\
\midrule
本文方法
& \textbf{2.260} & 0.641
& 0.225 & 0.673 \\
\bottomrule
\end{tabular}
}
\caption{\textbf{在 7Scenes 和 TUM 上的定量对比。}评估指标为 Chamfer 距离(Chamfer Distance,CD,越低越好)和 F1@0.25(越高越好)。
最佳结果以\textbf{粗体}标出,次佳结果以\underline{下划线}标出。}

\end{table}
定量结果
相机位姿估计。
我们在 vKITTI [cabon2020virtual](训练集)、Waymo [sun2020scalabilityperceptionautonomousdriving](留出集)以及训练中未见的 KITTI [kerbl20233d]、TUM-RGBD [sturm12iros] 和 Oxford Spires [tao2025oxfordspiresdatasetbenchmarking] 数据集上评估绝对轨迹误差(Absolute Trajectory Error,ATE)。 如表 [tab:kitti_result]–[tab:vkitti_results] 所示,随着序列长度增加,流式基线的误差呈非线性增长,这可能源于长时域历史信息的饱和与污染,而 LongStream 始终保持稳定。离线模型在长视频片段上经常出现内存不足(Out of Memory,OOM)和跟踪丢失。尽管完全以流式方式运行,LongStream 仍以 \(18\) FPS 达到当前最佳精度,并在不同环境间展现出稳健的泛化能力。
三维重建。
我们在 7Scenes 和 TUM 的测试序列上进行不经下采样的完整序列重建,并报告 CD 和 F1@0.25。 如表 [tab:7scenes_tum] 和图 [fig:tum] 所示,LongStream 在两个基准上均具备与离线方法相当的性能。 这些数据集的空间范围较小且帧覆盖密集,导致指标大体处于饱和状态。 在 7Scenes 上,部分方法采用全部帧评估时会在某些场景中失败,所得 CD 值高出数个数量级,从而抬高平均 CD。
尺度估计。 我们在 vKITTI 上评估恢复出的度量尺度精度。
LongStream 在整个序列中均能生成稳定的尺度估计,相对于真值的尺度比达到 \(0.9905\)。
表:相对位姿、尺度头、CCT 和缓存刷新的消融研究。绿色表示启用,红色表示禁用。第 2 行与第 3 行之间的 ATE 差距由少数较大的轨迹离群值造成。尺度误差表示绝对尺度偏差,越低越好。
\begin{table}
\centering
\small
\setlength{\tabcolsep}{6pt}
\resizebox{0.47\textwidth}{!}{
\renewcommand{\arraystretch}{1.2}
\begin{tabular}{lccc|cccc}
\toprule
\textbf{相对位姿} & \textbf{尺度头} & \textbf{CCT} & \textbf{缓存刷新} &
\textbf{ATE $\downarrow$} & \textbf{RPE $\downarrow$} & \textbf{尺度误差 $\downarrow$} \\
\midrule
\xmark & \xmark & \xmark & \xmark & 8.043 & 2.207 & - \\
\cmark & \xmark & \xmark & \xmark & 2.819 & 0.750 & -\\
\cmark & \cmark & \xmark & \xmark & 2.645 & 0.484 & 0.010 \\
\cmark & \cmark & \cmark & \xmark & 0.984 & 0.454 & 0.032 \\
\cmark & \cmark & \cmark & \cmark & 0.115 & 0.126 & 0.035 \\
\bottomrule
\end{tabular}
}
\caption{\textbf{相对位姿、尺度头、CCT 和缓存刷新的消融研究。}绿色表示启用,红色表示禁用。第 2 行与第 3 行之间的 ATE 差距由少数较大的轨迹离群值造成。尺度误差表示绝对尺度偏差,越低越好。}
\vspace{-10pt}

\end{table}
定性结果
图 [fig:kitti] 和图 [fig:tum] 分别可视化了公里级与房间尺度序列上的轨迹,验证了模型在大小两类空间范围内均能稳定预测位姿。 在室外场景中(图 [fig:kitti]),STream3R 和 StreamVGGT 等现有流式方法在长轨迹上出现累积漂移,而基于优化的 VGGT-SLAM 在更长序列上受到内存限制并发生跟踪丢失。 相比之下,LongStream 在数百米范围内保持轨迹连续性与度量精度,并在没有显式回环闭合模块的情况下成功闭合大型回环。
在室内环境中(图 [fig:tum]),面对具有剧烈视角变化、遮挡和反复回退的高度曲折相机轨迹,模型同样表现出良好的鲁棒性。 基线方法在这些不规则运动模式下往往产生不稳定位姿或明显漂移,而 LongStream 能保持连贯的全局轨迹。
消融研究
我们在单个 vKITTI 序列上进行消融实验,以验证 LongStream 的四个核心组件: 关键帧相对位姿头、尺度分支、缓存一致训练(CCT)和周期性缓存 刷新。如表 [tab:ablation_relpose_kvcache] 所示,组合所有模块可将 ATE 从 \(8.043\) 降至 \(0.115\),降幅接近两个数量级。
规范解耦的位姿与尺度。
从绝对位姿回归切换至本文的规范解耦形式可带来最大性能增益 (第 1 行 → 第 2 行),表明将局部几何与全局坐标分离对于泛化到训练窗口之外至关重要。尺度分支是保持度量一致性的必要条件;移除 该分支后,模型无法在整个序列中生成稳定的全局尺度。
时序缓存一致性。
周期性缓存刷新可防止无限流中的长期记忆饱和,而专用尺度分支对于保持度量一致性至关重要。
与基线相比,组合所有组件可使最终 ATE 降低近两个数量级。更详细的分析见 附录。
结论
LongStream 可在超长序列上实现稳定的度量尺度重建,克服现有方法的漂移与外推失效问题。其规范解耦位姿设计与缓存一致训练可在数千帧范围内保持几何和尺度一致,并在多种室内外数据集上取得较高精度与实时性能。
局限性。 该模型仍假设场景大体静态,依赖启发式关键帧调度,且在极长窗口中点图一致性会轻微下降。这些局限为未来提升模型的稳健性与通用性指明了方向。
致谢
本研究得到国家自然科学基金(编号 62406267)、广东省项目(编号 2024QN11X072)、广州市—香港科技大学(广州)联合资助计划(编号 2025A03J3956)以及广州市教育项目(编号 2024312122)的支持。
参考文献
-
wang2024dust3r— Wang, Shuzhe, Leroy, Vincent, Cabon, Yohann, Chidlovskii, Boris, Revaud, Jerome. Dust3r: Geometric 3d vision made easy. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2024. -
leroy2024grounding— Leroy, Vincent, Cabon, Yohann, Revaud, J{\'e}r{\^o}me. Grounding image matching in 3d with mast3r. European Conference on Computer Vision, 2024. -
wang2025vggt— Wang, Jianyuan, Chen, Minghao, Karaev, Nikita, Vedaldi, Andrea, Rupprecht, Christian, Novotny, David. VGGT: Visual Geometry Grounded Transformer. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2025. -
wang2025pi— Wang, Yifan, Zhou, Jianjun, Zhu, Haoyi, Chang, Wenzheng, Zhou, Yang, Li, Zizun, Chen, Junyi, Pang, Jiangmiao, Shen, Chunhua, He, Tong. \(\pi^3\): Permutation-Equivariant Visual Geometry Learning. arXiv preprint arXiv:2507.13347, 2025. -
wang2025continuous— Wang, Qianqian, Zhang, Yifei, Holynski, Aleksander, Efros, Alexei A, Kanazawa, Angjoo. Continuous 3d perception model with persistent state. Proceedings of the Computer Vision and Pattern Recognition Conference, 2025. -
lan2025stream3r— Lan, Yushi, Luo, Yihang, Hong, Fangzhou, Zhou, Shangchen, Chen, Honghua, Lyu, Zhaoyang, Yang, Shuai, Dai, Bo, Loy, Chen Change, Pan, Xingang. STream3R: Scalable Sequential 3D Reconstruction with Causal Transformer. arXiv preprint arXiv:2508.10893, 2025. -
zhuo2025streaming— Zhuo, Dong, Zheng, Wenzhao, Guo, Jiahe, Wu, Yuqi, Zhou, Jie, Lu, Jiwen. Streaming 4d visual geometry transformer. arXiv preprint arXiv:2507.11539, 2025. -
Schonberger_2016_CVPR— Schonberger, Johannes L., Frahm, Jan-Michael. Structure-From-Motion Revisited. Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 2016. -
schoenberger2016mvs— Sch\"{o}nberger, Johannes Lutz, Zheng, Enliang, Pollefeys, Marc, Frahm, Jan-Michael. Pixelwise View Selection for Unstructured Multi-View Stereo. European Conference on Computer Vision (ECCV), 2016. -
cheng2025graphguidedscenereconstructionimages— Chong Cheng, Gaochao Song, Yiyang Yao, Qinzheng Zhou, Gangjian Zhang, Hao Wang. Graph-Guided Scene Reconstruction from Images with 3D Gaussian Splatting, 2025. https://arxiv.org/abs/2502.17377. -
yao2018mvsnetdepthinferenceunstructured— Yao, Yao, Luo, Zixin, Li, Shiwei, Fang, Tian, Quan, Long. MVSNet: Depth Inference for Unstructured Multi-view Stereo. Computer Vision -- ECCV 2018, 2018. -
yao2019recurrent— Yao, Yao, Luo, Zixin, Li, Shiwei, Shen, Tianwei, Fang, Tian, Quan, Long. Recurrent MVSNet for High-resolution Multi-view Stereo Depth Inference. Computer Vision and Pattern Recognition (CVPR), 2019. -
Galliani_2015_ICCV— Galliani, Silvano, Lasinger, Katrin, Schindler, Konrad. Massively Parallel Multiview Stereopsis by Surface Normal Diffusion. Proceedings of the IEEE International Conference on Computer Vision (ICCV), 2015. -
fu2022geoneusgeometryconsistentneuralimplicit— Qiancheng Fu, Qingshan Xu, Yew-Soon Ong, Wenbing Tao. Geo-Neus: Geometry-Consistent Neural Implicit Surfaces Learning for Multi-view Reconstruction, 2022. https://arxiv.org/abs/2205.15848. -
wang2023visualgeometrygroundeddeep— Jianyuan Wang, Nikita Karaev, Christian Rupprecht, David Novotny. Visual Geometry Grounded Deep Structure From Motion, 2023. https://arxiv.org/abs/2312.04563. -
press2022trainshorttestlong— Ofir Press, Noah A. Smith, Mike Lewis. Train Short, Test Long: Attention with Linear Biases Enables Input Length Extrapolation, 2022. https://arxiv.org/abs/2108.12409. -
xiao2024efficientstreaminglanguagemodels— Guangxuan Xiao, Yuandong Tian, Beidi Chen, Song Han, Mike Lewis. Efficient Streaming Language Models with Attention Sinks, 2024. https://arxiv.org/abs/2309.17453. -
dai2019transformerxlattentivelanguagemodels— Zihang Dai, Zhilin Yang, Yiming Yang, Jaime Carbonell, Quoc V. Le, Ruslan Salakhutdinov. Transformer-XL: Attentive Language Models Beyond a Fixed-Length Context, 2019. https://arxiv.org/abs/1901.02860. -
yang2024depthanythingunleashingpower— Lihe Yang, Bingyi Kang, Zilong Huang, Xiaogang Xu, Jiashi Feng, Hengshuang Zhao. Depth Anything: Unleashing the Power of Large-Scale Unlabeled Data, 2024. https://arxiv.org/abs/2401.10891. -
Geiger2012CVPR— Geiger, Andreas, Lenz, Philip, Urtasun, Raquel. Are we ready for autonomous driving? The KITTI vision benchmark suite. 2012 IEEE Conference on Computer Vision and Pattern Recognition, 2012. -
sun2020scalabilityperceptionautonomousdriving— Pei Sun, Henrik Kretzschmar, Xerxes Dotiwalla, Aurelien Chouard, Vijaysai Patnaik, Paul Tsui, James Guo, Yin Zhou, Yuning Chai, Benjamin Caine, Vijay Vasudevan, Wei Han, Jiquan Ngiam, Hang Zhao, Aleksei Timofeev, Scott Ettinger, Maxim Krivokon, Amy Gao, Aditya Joshi, Sheng Zhao, Shuyang Cheng, Yu Zhang, Jonathon Shlens, Zhifeng Chen, Dragomir Anguelov. Scalability in Perception for Autonomous Driving: Waymo Open Dataset, 2020. https://arxiv.org/abs/1912.04838. -
mehl2023springhighresolutionhighdetaildataset— Lukas Mehl, Jenny Schmalfuss, Azin Jahedi, Yaroslava Nalivayko, Andrés Bruhn. Spring: A High-Resolution High-Detail Dataset and Benchmark for Scene Flow, Optical Flow and Stereo, 2023. https://arxiv.org/abs/2303.01943. -
ba— Triggs, Bill, McLauchlan, Philip F., Hartley, Richard I., Fitzgibbon, Andrew W.. Bundle Adjustment --- A Modern Synthesis. Vision Algorithms: Theory and Practice, 2000. -
8354808— Zhang, Zichao, Gallego, Guillermo, Scaramuzza, Davide. On the Comparison of Gauge Freedom Handling in Optimization-Based Visual-Inertial State Estimation. IEEE Robotics and Automation Letters, 2018. -
charatan2024pixelsplat— Charatan, David, Li, Sizhe Lester, Tagliasacchi, Andrea, Sitzmann, Vincent. pixelsplat: 3d gaussian splats from image pairs for scalable generalizable 3d reconstruction. Proceedings of the IEEE/CVF conference on computer vision and pattern recognition, 2024. -
xu2025freesplatter— Xu, Jiale, Gao, Shenghua, Shan, Ying. Freesplatter: Pose-free gaussian splatting for sparse-view 3d reconstruction. Proceedings of the IEEE/CVF International Conference on Computer Vision, 2025. -
zhang2024monst3r— Junyi Zhang, Charles Herrmann, Junhwa Hur, Varun Jampani, Trevor Darrell, Forrester Cole, Deqing Sun, Ming-Hsuan Yang. MonST3R: A Simple Approach for Estimating Geometry in the Presence of Motion, 2025. https://arxiv.org/abs/2410.03825. -
zhang2024gs— Zhang, Kai, Bi, Sai, Tan, Hao, Xiangli, Yuanbo, Zhao, Nanxuan, Sunkavalli, Kalyan, Xu, Zexiang. Gs-lrm: Large reconstruction model for 3d gaussian splatting. European Conference on Computer Vision, 2024. -
davison2007monoslam— Davison, Andrew J, Reid, Ian D, Molton, Nicholas D, Stasse, Olivier. MonoSLAM: Real-time single camera SLAM. IEEE transactions on pattern analysis and machine intelligence, 2007. -
zhu2024nicer— Zhu, Zihan, Peng, Songyou, Larsson, Viktor, Cui, Zhaopeng, Oswald, Martin R, Geiger, Andreas, Pollefeys, Marc. Nicer-slam: Neural implicit scene encoding for rgb slam. 2024 International Conference on 3D Vision (3DV), 2024. -
choy20163d— Choy, Christopher B, Xu, Danfei, Gwak, JunYoung, Chen, Kevin, Savarese, Silvio. 3d-r2n2: A unified approach for single and multi-view 3d object reconstruction. European conference on computer vision, 2016. -
yu2021pixelnerf— Yu, Alex, Ye, Vickie, Tancik, Matthew, Kanazawa, Angjoo. pixelnerf: Neural radiance fields from one or few images. Proceedings of the IEEE/CVF conference on computer vision and pattern recognition, 2021. -
wang2021ibrnet— Wang, Qianqian, Wang, Zhicheng, Genova, Kyle, Srinivasan, Pratul P, Zhou, Howard, Barron, Jonathan T, Martin-Brualla, Ricardo, Snavely, Noah, Funkhouser, Thomas. Ibrnet: Learning multi-view image-based rendering. Proceedings of the IEEE/CVF conference on computer vision and pattern recognition, 2021. -
sitzmann2019deepvoxels— Sitzmann, Vincent, Thies, Justus, Heide, Felix, Nie{\ss}ner, Matthias, Wetzstein, Gordon, Zollhofer, Michael. Deepvoxels: Learning persistent 3d feature embeddings. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2019. -
gkioxari2019mesh— Gkioxari, Georgia, Malik, Jitendra, Johnson, Justin. Mesh r-cnn. Proceedings of the IEEE/CVF international conference on computer vision, 2019. -
park2019deepsdf— Park, Jeong Joon, Florence, Peter, Straub, Julian, Newcombe, Richard, Lovegrove, Steven. Deepsdf: Learning continuous signed distance functions for shape representation. Proceedings of the IEEE/CVF conference on computer vision and pattern recognition, 2019. -
mildenhall2021nerf— Mildenhall, Ben, Srinivasan, Pratul P, Tancik, Matthew, Barron, Jonathan T, Ramamoorthi, Ravi, Ng, Ren. Nerf: Representing scenes as neural radiance fields for view synthesis. Communications of the ACM, 2021. -
murai2025mast3r— Murai, Riku, Dexheimer, Eric, Davison, Andrew J. MASt3R-SLAM: Real-time dense SLAM with 3D reconstruction priors. Proceedings of the Computer Vision and Pattern Recognition Conference, 2025. -
liu2025slam3r— Liu, Yuzheng, Dong, Siyan, Wang, Shuzhe, Yin, Yingda, Yang, Yanchao, Fan, Qingnan, Chen, Baoquan. Slam3r: Real-time dense scene reconstruction from monocular rgb videos. Proceedings of the Computer Vision and Pattern Recognition Conference, 2025. -
kerbl20233d— Kerbl, Bernhard, Kopanas, Georgios, Leimk{\"u}hler, Thomas, Drettakis, George. 3D Gaussian splatting for real-time radiance field rendering.. ACM Trans. Graph., 2023. -
oquab2024dinov2learningrobustvisual— Maxime Oquab, Timothée Darcet, Théo Moutakanni, Huy Vo, Marc Szafraniec, Vasil Khalidov, Pierre Fernandez, Daniel Haziza, Francisco Massa, Alaaeldin El-Nouby, Mahmoud Assran, Nicolas Ballas, Wojciech Galuba, Russell Howes, Po-Yao Huang, Shang-Wen Li, Ishan Misra, Michael Rabbat, Vasu Sharma, Gabriel Synnaeve, Hu Xu, Hervé Jegou, Julien Mairal, Patrick Labatut, Armand Joulin, Piotr Bojanowski. DINOv2: Learning Robust Visual Features without Supervision, 2024. https://arxiv.org/abs/2304.07193. -
teed2020raft— Teed, Zachary, Deng, Jia. RAFT: Recurrent All-Pairs Field Transforms for Optical Flow. European Conference on Computer Vision (ECCV), 2020. -
xu2025streamingvlmrealtimeunderstandinginfinite— Ruyi Xu, Guangxuan Xiao, Yukang Chen, Liuning He, Kelly Peng, Yao Lu, Song Han. StreamingVLM: Real-Time Understanding for Infinite Video Streams, 2025. https://arxiv.org/abs/2510.09608. -
yang2025longliverealtimeinteractivelong— Shuai Yang, Wei Huang, Ruihang Chu, Yicheng Xiao, Yuyang Zhao, Xianbang Wang, Muyang Li, Enze Xie, Yingcong Chen, Yao Lu, Song Han, Yukang Chen. LongLive: Real-time Interactive Long Video Generation, 2025. https://arxiv.org/abs/2509.22622. -
deitke2023objaverse— Deitke, Matt, Schwenk, Dustin, Salvador, Jordi, Weihs, Luca, Michel, Oscar, VanderBilt, Eli, Schmidt, Ludwig, Ehsani, Kiana, Kembhavi, Aniruddha, Farhadi, Ali. Objaverse: A universe of annotated 3d objects. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2023. -
Pan_2023_ICCV— Pan, Xiaqing, Charron, Nicholas, Yang, Yongqian, Peters, Scott, Whelan, Thomas, Kong, Chen, Parkhi, Omkar, Newcombe, Richard, Ren, Yuheng (Carl). Aria Digital Twin: A New Benchmark Dataset for Egocentric 3D Machine Perception. Proceedings of the IEEE/CVF International Conference on Computer Vision (ICCV), 2023. -
cabon2020virtual— Yohann Cabon, Naila Murray, Martin Humenberger. Virtual KITTI 2, 2020. https://arxiv.org/abs/2001.10773. -
zheng2023point— Yang Zheng, Adam W. Harley, Bokui Shen, Gordon Wetzstein, Leonidas J. Guibas. PointOdyssey: A Large-Scale Synthetic Dataset for Long-Term Point Tracking. ICCV, 2023. -
mvssynth— Huang, Po-Han, Matzen, Kevin, Kopf, Johannes, Ahuja, Narendra, Huang, Jia-Bin. DeepMVS: Learning Multi-View Stereopsis. IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 2018. -
straub2019replica— Julian Straub, Thomas Whelan, Lingni Ma, Yufan Chen, Erik Wijmans, Simon Green, Jakob J. Engel, Raul Mur-Artal, Carl Ren, Shobhit Verma, Anton Clarkson, Mingfei Yan, Brian Budge, Yajie Yan, Xiaqing Pan, June Yon, Yuyang Zou, Kimberly Leon, Nigel Carter, Jesus Briales, Tyler Gillingham, Elias Mueggler, Luis Pesqueira, Manolis Savva, Dhruv Batra, Hauke M. Strasdat, Renzo De Nardi, Michael Goesele, Steven Lovegrove, Richard Newcombe. The Replica Dataset: A Digital Replica of Indoor Spaces, 2019. https://arxiv.org/abs/1906.05797. -
MPSD_2020_ECCV— Lopez-Antequera, Manuel, Gargallo, Pau, Hofinger, Markus, Rota Bulò, Samuel, Kuang, Yubin, Kontschieder, Peter. Mapillary Planet-Scale Depth Dataset. Proceedings of the European Conference on Computer Vision (ECCV), 2020. -
hypersim— Mike Roberts AND Jason Ramapuram AND Anurag Ranjan AND Atulit Kumar AND Miguel Angel Bautista AND Nathan Paczan AND Russ Webb AND Joshua M. Susskind. Hypersim: A Photorealistic Synthetic Dataset for Holistic Indoor Scene Understanding. International Conference on Computer Vision (ICCV) 2021, 2021. -
dai2017scannet— Dai, Angela, Chang, Angel X, Savva, Manolis, Halber, Maciej, Funkhouser, Thomas, Nie{\ss}ner, Matthias. Scannet: Richly-annotated 3d reconstructions of indoor scenes. Proceedings of the IEEE conference on computer vision and pattern recognition, 2017. -
xia2024rgbd— Hongchi Xia, Yang Fu, Sifei Liu, Xiaolong Wang. RGBD Objects in the Wild: Scaling Real-World 3D Object Learning from RGB-D Videos, 2024. -
yao2020blendedmvs— Yao, Yao, Luo, Zixin, Li, Shiwei, Zhang, Jingyang, Ren, Yufan, Zhou, Lei, Fang, Tian, Quan, Long. Blendedmvs: A large-scale dataset for generalized multi-view stereo networks. Proceedings of the IEEE/CVF conference on computer vision and pattern recognition, 2020. -
ling2024dl3dv— Ling, Lu, Sheng, Yichen, Tu, Zhi, Zhao, Wentian, Xin, Cheng, Wan, Kun, Yu, Lantao, Guo, Qianyu, Yu, Zixun, Lu, Yawen, others. Dl3dv-10k: A large-scale scene dataset for deep learning-based 3d vision. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2024. -
li2018megadepth— Li, Zhengqi, Snavely, Noah. Megadepth: Learning single-view depth prediction from internet photos. Proceedings of the IEEE conference on computer vision and pattern recognition, 2018. -
greff22kubric:— Klaus Greff, Francois Belletti, Lucas Beyer, Carl Doersch, Yilun Du, Daniel Duckworth, David J Fleet, Dan Gnanapragasam, Florian Golemo, Charles Herrmann, Thomas Kipf, Abhijit Kundu, Dmitry Lagun, Issam Laradji, Hsueh-Ti (Derek) Liu, Henning Meyer, Yishu Miao, Derek Nowrouzezahrai, Cengiz Oztireli, Etienne Pot, Noha Radwan, Daniel Rebain, Sara Sabour, Mehdi S. M. Sajjadi, Matan Sela, Vincent Sitzmann, Austin Stone, Deqing Sun, Suhani Vora, Ziyu Wang, Tianhao Wu, Kwang Moo Yi, Fangcheng Zhong, Andrea Tagliasacchi. Kubric: a scalable dataset generator, 2022. -
reizenstein21common— Jeremy Reizenstein, Roman Shapovalov, Philipp Henzler, Luca Sbordone, Patrick Labatut, David Novotny. Common Objects in 3D: Large-Scale Learning and Evaluation of Real-life 3D Category Reconstruction, 2021. -
shen2025fastvggttrainingfreeaccelerationvisual— You Shen, Zhipeng Zhang, Yansong Qu, Xiawu Zheng, Jiayi Ji, Shengchuan Zhang, Liujuan Cao. FastVGGT: Training-Free Acceleration of Visual Geometry Transformer, 2025. https://arxiv.org/abs/2509.02560. -
maggio2025vggtslamdensergbslam— Dominic Maggio, Hyungtae Lim, Luca Carlone. VGGT-SLAM: Dense RGB SLAM Optimized on the SL(4) Manifold, 2025. https://arxiv.org/abs/2505.12549. -
tao2025oxfordspiresdatasetbenchmarking— Yifu Tao, Miguel Ángel Muñoz-Bañón, Lintong Zhang, Jiahao Wang, Lanke Frank Tarimo Fu, Maurice Fallon. The Oxford Spires Dataset: Benchmarking Large-Scale LiDAR-Visual Localisation, Reconstruction and Radiance Field Methods, 2025. https://arxiv.org/abs/2411.10546. -
sturm12iros— J. Sturm, N. Engelhard, F. Endres, W. Burgard, D. Cremers. A Benchmark for the Evaluation of RGB-D SLAM Systems. Proc. of the International Conference on Intelligent Robot Systems (IROS), 2012. -
cheng2025reggsunposedsparseviews— Chong Cheng, Yu Hu, Sicheng Yu, Beizhen Zhao, Zijian Wang, Hao Wang. RegGS: Unposed Sparse Views Gaussian Splatting with 3DGS Registration, 2025. https://arxiv.org/abs/2507.08136. -
cheng2025outdoormonocularslamglobal— Chong Cheng, Sicheng Yu, Zijian Wang, Yifan Zhou, Hao Wang. Outdoor Monocular SLAM with Global Scale-Consistent 3D Gaussian Pointmaps, 2025. https://arxiv.org/abs/2507.03737. -
yu2025rgbonlygaussiansplattingslam— Sicheng Yu, Chong Cheng, Yifan Zhou, Xiaojun Yang, Hao Wang. RGB-Only Gaussian Splatting SLAM for Unbounded Outdoor Scenes, 2025. https://arxiv.org/abs/2502.15633. -
song2024gvkfgaussianvoxelkernel— Gaochao Song, Chong Cheng, Hao Wang. GVKF: Gaussian Voxel Kernel Functions for Highly Efficient Surface Reconstruction in Open Scenes, 2024. https://arxiv.org/abs/2411.01853. -
cheng2025unposed3dgsreconstructionprobabilistic— Chong Cheng, Zijian Wang, Sicheng Yu, Yu Hu, Nanjie Yao, Hao Wang. Unposed 3DGS Reconstruction with Probabilistic Procrustes Mapping, 2025. https://arxiv.org/abs/2507.18541. -
hu2025vggt4dminingmotioncues— Yu Hu, Chong Cheng, Sicheng Yu, Xiaoyang Guo, Hao Wang. VGGT4D: Mining Motion Cues in Visual Geometry Transformers for 4D Scene Reconstruction, 2025. https://arxiv.org/abs/2511.19971. -
Wang_2024— Wang, Jiyuan, Lin, Chunyu, Nie, Lang, Huang, Shujun, Zhao, Yao, Pan, Xing, Ai, Rui. WeatherDepth: Curriculum Contrastive Learning for Self-Supervised Depth Estimation under Adverse Weather Conditions. 2024 IEEE International Conference on Robotics and Automation (ICRA), 2024. http://dx.doi.org/10.1109/icra57147.2024.10611100. -
10.1145/3664647.3681168— Wang, Jiyuan, Lin, Chunyu, Nie, Lang, Liao, Kang, Shao, Shuwei, Zhao, Yao. Digging into Contrastive Learning for Robust Depth Estimation with Diffusion Models. Proceedings of the 32nd ACM International Conference on Multimedia, 2024. https://doi.org/10.1145/3664647.3681168. -
wang2025jasmine— Wang, Jiyuan, Lin, Chunyu, Guan, Cheng, Nie, Lang, He, Jing, Li, Haodong, Liao, Kang, Zhao, Yao. Jasmine: Harnessing Diffusion Prior for Self-supervised Depth Estimation. arXiv preprint arXiv:2503.15905, 2025. -
10.1145/3664647.3681641— Shen, Wenhao, Yin, Wanqi, Wang, Hao, Wei, Chen, Cai, Zhongang, Yang, Lei, Lin, Guosheng. HMR-Adapter: A Lightweight Adapter with Dual-Path Cross Augmentation for Expressive Human Mesh Recovery. Proceedings of the 32nd ACM International Conference on Multimedia, 2024. https://doi.org/10.1145/3664647.3681641. -
shen2025adhmraligningdiffusionbasedhuman— Wenhao Shen, Wanqi Yin, Xiaofeng Yang, Cheng Chen, Chaoyue Song, Zhongang Cai, Lei Yang, Hao Wang, Guosheng Lin. ADHMR: Aligning Diffusion-based Human Mesh Recovery via Direct Preference Optimization, 2025. https://arxiv.org/abs/2505.10250. -
shin2026motionstreamrealtimevideogeneration— Joonghyuk Shin, Zhengqi Li, Richard Zhang, Jun-Yan Zhu, Jaesik Park, Eli Shechtman, Xun Huang. MotionStream: Real-Time Video Generation with Interactive Motion Controls, 2026. https://arxiv.org/abs/2511.01266. -
keetha2026mapanythinguniversalfeedforwardmetric— Nikhil Keetha, Norman Müller, Johannes Schönberger, Lorenzo Porzi, Yuchen Zhang, Tobias Fischer, Arno Knapitsch, Duncan Zauss, Ethan Weber, Nelson Antunes, Jonathon Luiten, Manuel Lopez-Antequera, Samuel Rota Bulò, Christian Richardt, Deva Ramanan, Sebastian Scherer, Peter Kontschieder. MapAnything: Universal Feed-Forward Metric 3D Reconstruction, 2026. https://arxiv.org/abs/2509.13414.
补充材料
相对位姿与尺度的规范不变性
本附录给出简要证明:(1) LongStream 使用的关键帧相对位姿严格不受全局坐标系选择影响;(2) 几何目标与尺度目标正交解耦。
关键帧相对位姿的 SE(3) 规范不变性
本文证明学习目标
在任意全局 \(SE(3)\) 规范变换下均保持不变,从而保证训练不受世界坐标系任意选择的影响。
规范变换。
令 \(\mathbf{G} \in SE(3)\) 将世界坐标系 \(\mathcal{W}\) 重新参数化为 \(\mathcal{W}'\)。对于任意三维点 \(\mathbf{x}\):
绝对位姿的变换。
对于世界坐标系到相机坐标系的位姿 \(\mathbf{T}\),其在 \(\mathcal{W}'\) 中的对应位姿为
该关系源于相机坐标系下的坐标必须保持不变。
关键帧相对位姿的不变性。
将式 [eq:T-transform] 应用于帧 \(i\) 和 \(k\):
则 \(\mathcal{W}'\) 中的相对位姿为
因此,
这表明该目标严格满足 \(SE(3)\) 规范不变性。
尺度的 Sim(3) 正交解耦
下面证明归一化几何目标与全局尺度因子无关,从而保证形状与尺度通过不同的梯度路径优化。
令预测的度量点云为
其中,\(s>0\) 为尺度头预测的全局尺度。
令 \(\mathrm{Norm}(\cdot)\) 为一阶齐次函数:
几何损失中使用的归一化预测为
因此,几何损失
与 \(s\) 无关,因而有
这证实全局尺度与形状优化完全解耦,并且仅通过专用尺度目标学习。
\medskip
综上,关键帧相对位姿具有严格的 \(SE(3)\) 规范不变性,归一化几何则保证 \(Sim(3)\) 尺度正交性。二者共同构成面向长序列流式重建、具有明确理论依据的规范一致训练目标。
图:缓存一致训练(Cache-Consistent Training,CCT)。 图中展示了不同训练—推理设置下的注意力图(上)和相对位姿误差(Relative Pose Error,RPE)热力图(下)。 不使用 CCT 时(左),因果推理会形成强烈的注意力汇聚点;窗口化推理若保留该汇聚点,会进一步将其放大,若移除则会崩溃。 使用 CCT 时(右),该汇聚点在因果模式下受到显著抑制,在两种窗口模式下也同样受到抑制,从而获得稳定且最佳的精度。 浅蓝色表示对关键帧的注意力。
补充注意力可视化分析
如图 [sup:attention] 所示,我们通过可视化帧级注意力,分析模型在流式推理期间如何将注意力分配给历史帧。通过对目标帧词元求和并对源帧词元取平均,将词元间注意力聚合为 \(S \times S\) 的帧间矩阵。因果全窗口视图最多包含 \(80\) 个可见帧,而滑动窗口视图仅包含 \(10\) 个,这一差异也反映在可视化结果中。
批训练基线表现出明显的时序偏差:模型对第一帧(即“汇聚点”)和更远处的帧分配了不成比例的高注意力,却对与局部几何一致性最相关的近期帧关注不足。直观而言,几何模型应主要依赖时间上相邻的帧;然而,这种不平衡会使 RPE 快速增长,并导致远距离预测不稳定。在窗口化推理中,保留汇聚点会加速性能退化,移除汇聚点则会导致崩溃,表明该基线严重依赖初始帧。
采用本文的 KV 缓存一致训练(CCT)后,注意力分布更加均衡。模型降低了对第一帧的依赖,并将相对更多的注意力分配给邻近帧,从而在全窗口与滑动窗口推理中均表现得更加稳定。不过,当序列长度接近 \(\sim 80\) 帧时,仍可观察到注意力逐渐转向更早的历史帧,这与缓存饱和效应一致。
总体而言,这些可视化揭示了长序列性能退化的内在机制:基线模型会形成强烈的首帧吸引与远距离偏差,而 CCT 则促使注意力模式更符合时序几何一致性。
长序列稳定性分析
表 [tab:ate_520018670] 报告了 Waymo #520018670(135 m)和 KITTI #03(561 m)上的长序列结果。随着序列长度增加,包括基线方法和未使用缓存刷新的 LongStream 在内的流式方法均表现出非线性误差增长。这表明在严格在线约束下,更长的历史信息或重访不一定能提升性能,反而可能随序列增长放大长时域效应。相比之下,LongStream 通过消除首帧锚定,并采用带周期性缓存刷新的缓存一致训练来缓解长历史效应,从而在长序列上保持稳定。
表:随着序列长度增加,Waymo #520018670(左,135 m)和 KITTI #03(右,561 m)上的 ATE(m)。w/o SW 表示不使用缓存刷新与滑动窗口的变体。
\begin{table}
\centering
\small
\setlength{\tabcolsep}{3.5pt}
\renewcommand{\arraystretch}{0.92}
\begin{tabular}{lcccc|cc}
\toprule
方法 & 15x & 30x & 60x & 199x & 30x & 801x\\
\midrule
CUT3R      & 0.159 & 1.421 & 2.505  & 8.591 & 3.867 & 148.06\\
TTT3R      & 0.153 & 0.873 & 1.127  & 5.505 & 1.957 & 105.28\\
Stream3R   & 0.181 & 1.329 & 2.998 & 21.440 & 3.412 & 158.25\\

VGGT-SLAM  & 0.172 & 0.518 & 0.992 & 3.740 & 0.929 & 169.83\\
\midrule
本文方法(w/o SW) & \textbf{0.151} & 0.192 & 0.477  & 1.699 & 0.347 & 20.83\\
本文方法       & \textbf{0.151} & \textbf{0.183} & \textbf{0.343}  & \textbf{0.723} & \textbf{0.164} & \textbf{3.81} \\
\bottomrule
\end{tabular}
\caption{随着序列长度增加,Waymo \#520018670(左,135 m)和 KITTI \#03(右,561 m)上的 ATE(m)。w/o SW 表示不使用缓存刷新与滑动窗口的变体。}

\end{table}
补充超参数分析
本节给出详细的超参数消融研究。这些实验在 vKITTI 数据集上进行,用于验证本文的设计选择。
关键帧间隔的影响
我们首先考察模型对关键帧间隔 \(N\) 的敏感性。如表 [tab:supp_interval] 所示,采用 \(N=1\) 这类极短间隔会使系统退化为逐帧跟踪,导致误差快速累积。相反,将间隔增大至 \(15\) 同样会降低性能。 这是因为训练块固定为 22 帧。关键帧切换过于稀疏时,模型获得的监督信号太少,无法可靠学习切换行为。
表:关键帧间隔的影响。\(N=10\) 在漂移累积与训练动态之间取得最佳权衡。
\begin{table}
    \centering
    \small
    \setlength{\tabcolsep}{12pt}
    \begin{tabular}{ccc}
        \toprule
        间隔 $N$ & ATE $\downarrow$ & RPE $\downarrow$ \\
        \midrule
        1  & 4.047 & 0.565 \\
        3  & 3.384 & 0.514 \\
        8  & 0.122 & 0.131 \\
        10 & \textbf{0.115} & \textbf{0.126} \\
        15 & 1.398 & 0.412 \\
        \bottomrule
    \end{tabular}
    \caption{\textbf{关键帧间隔的影响。}$N=10$ 在漂移累积与训练动态之间取得最佳权衡。}

\end{table}
缓存窗口大小的影响
我们进一步研究缓存窗口大小 \(W\) 的影响。如表 [tab:supp_window] 所示,窗口大小为 \(10\) 已足以维持上下文,而增至 \(30\) 会显著降低精度,使 ATE 升至 \(0.516\)。这一实验证据支持“几何饱和”理论:过长的历史缓存会积累过时特征,进而污染注意力机制。因此,本文采用大小为 \(10\) 的窗口,在防止长期漂移的同时降低计算成本。
表:缓存窗口大小的影响。\(W=10\) 可在维持充足上下文的同时防止几何饱和。
\begin{table}
    \centering
    \small
    \setlength{\tabcolsep}{12pt}
    \begin{tabular}{ccc}
        \toprule
        窗口 $W$ & ATE $\downarrow$ & RPE $\downarrow$ \\
        \midrule
        10 & \textbf{0.115} & \textbf{0.126} \\
        20 & 0.119 & 0.129 \\
        30 & 0.516 & 0.293 \\
        \bottomrule
    \end{tabular}
    \caption{\textbf{缓存窗口大小的影响。}$W=10$ 可在维持充足上下文的同时防止几何饱和。}

\end{table}
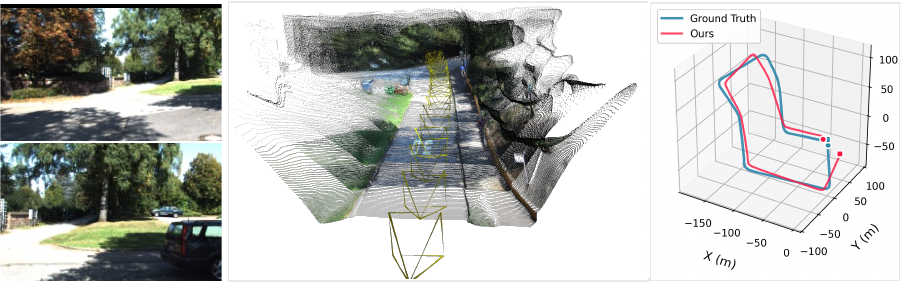
图:在没有回环闭合校正时,LongStream 重访同一位置会出现轻微漂移。加入在线回环闭合线索是提升全局一致性的潜在方向。
补充局限性
如图 [sup:add] 所示,LongStream 未进行显式回环闭合优化,因此无法利用离线全局光束法平差所能实现的强轨迹校正。尽管本文提出的相对位姿形式和缓存一致训练已能在长时域内保持稳定的漂移特性,但引入轻量级在线回环闭合线索有望进一步提升全局一致性,尤其是在大型回环中。本文将其留作未来工作。