具身导航基础模型
原文标题: Embodied Navigation Foundation Model
作者: Jiazhao Zhang、Anqi Li、Yunpeng Qi、Minghan Li、Jiahang Liu、Shaoan Wang、Haoran Liu、Gengze Zhou、Yuze Wu、Xingxing Li、Yuxin Fan、Wenjun Li、Zhibo Chen、Fei Gao、Qi Wu、Zhizheng Zhang、He Wang
机构: 北京大学、银河通用、中国科学技术大学、北京智源人工智能研究院、阿德莱德大学、浙江大学、Differential Robotics
项目主页: https://pku-epic.github.io/NavFoM-Web/
说明: * 表示共同第一作者,\(\dagger\) 表示通讯作者。
摘要
导航是具身智能的一项基础能力,体现了在物理环境中进行感知与交互所需的智能。为获得此类智能,近期研究借助视觉—语言模型(Vision-Language Model,VLM);这类模型具有很强的泛化能力,其建模形式也很适合导航。然而,现有方法大多仍局限于狭窄的任务设定和具身平台特定的架构。
本文提出跨具身、跨任务的导航基础模型(Navigation Foundation Model,NavFoM)。该模型基于八百万条导航样本训练,覆盖四足机器人、无人机、轮式机器人和车辆,以及视觉—语言导航(Vision-and-Language Navigation,VLN)、目标搜索、目标跟踪和自动驾驶等多种任务。NavFoM 采用统一架构,能够处理来自不同相机配置和不同导航时间跨度的多模态导航输入。
为适配多样的相机配置与时间跨度,NavFoM 引入指示词元,将具身平台的相机视点信息与任务的时间上下文嵌入其中。为满足真实世界部署需求,NavFoM 还在有限的词元长度预算内采用动态调整的采样策略,控制全部观测词元。
在七个公开基准上的广泛评估表明,无需针对特定任务微调,本模型便能在不同导航任务与具身平台上取得最先进或极具竞争力的性能。更多真实世界实验进一步验证了本方法的强泛化能力和实际适用性。
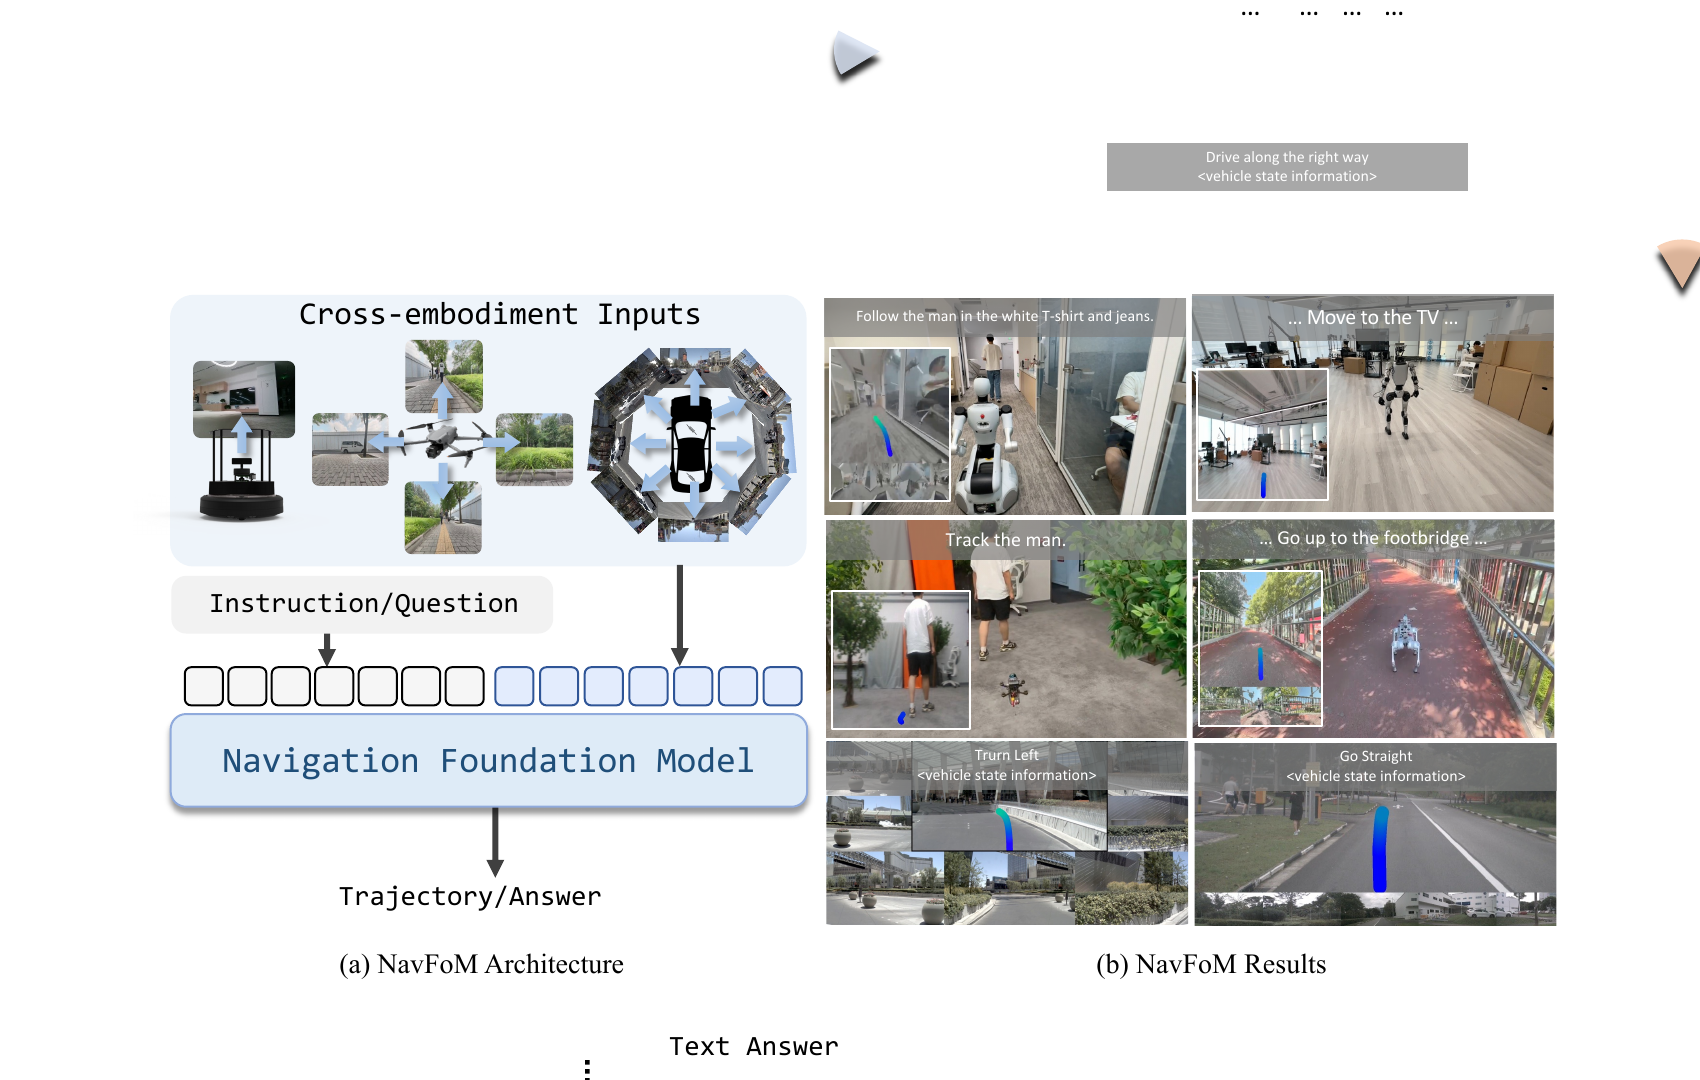
图 1:模型架构(左)与真实世界实验结果(右)。实验涵盖本方法的跨任务与跨具身性能。
1 引言
对具身智能体和人类而言,导航都是一项基础能力,使其能够在物理环境中智能移动并完成指定任务 [shah2023gnm; bar2025navigation; Zhang2024VisionandLanguageNT]。稳健导航要求深入理解环境上下文和任务指令;这些信息通常以视觉与语言观测的形式呈现,与 VLM 的输入形式相似。近年来,VLM 从大规模开放世界数据中学习,在检索、分类和图像描述等任务上展现出显著的零样本泛化能力,且无须依赖领域特定微调 [liu2023llava; qwen2; guo2025seed1]。相比之下,具身导航 [habitat19iccv; deitke2022procthor] 仍受限于狭窄的任务领域、具身平台特定的架构以及受约束的指令形式。
通用导航日益受到研究关注 [zhang2024navid; cheng2024navila; shah2023gnm; long2024instructnav],但既有研究受限的设计和有限的领域适用性阻碍了相关进展。在跨任务导航中,先前方法 [zhang2024uni; yin2025unigoal; zhu2025mtu] 通常假设机器人采用一致的相机配置,并统一视觉—语言导航、目标搜索和目标跟踪等多种任务。在跨具身导航中,现有方法 [eftekhar2024one; hirose2023exaug] 隐式学习具身平台物理外形的先验,但往往局限于特定导航任务。导航任务与具身平台之间现存的割裂表明,领域内仍缺少能够在多种具身平台上处理不同任务的导航基础模型。
本文致力于构建跨任务、跨具身的具身导航基础模型 NavFoM,并使用覆盖多种具身平台与任务的八百万条导航样本进行训练。人类主要依靠视觉感知输入即可完成广泛的导航任务,近期纯视觉导航方法也取得了成功 [shah2023gnm; zeng2024poliformer]。受此启发,本文将通用导航建模为:处理自我中心视频(由安装在机器人上的一个或多个相机采集)与语言指令,并预测后续轨迹以完成指令。该形式与多数现有导航任务设定兼容 [openscene2023; wang2024openuav]。
为在不同相机配置下对齐可泛化的具身平台,本文提出时间—视点指示(Temporal-Viewpoint Indicator,TVI)词元,同时标识相机配置的视点与导航时间跨度的时间信息。通过动态调整 TVI 词元,本方法能够跨不同相机配置进行联合微调,并支持与图像问答和视频问答样本共同训练 [shen2024longvu; li2023llama]。为应对硬件内存开销和推理速度等实际部署约束,本文进一步提出预算感知时间采样(Budget-Aware Temporal Sampling,BATS)策略,根据受词元预算约束的遗忘曲线动态采样导航历史词元。这一词元采样方法在性能与推理速度之间取得平衡,增强了真实世界部署的实用性。
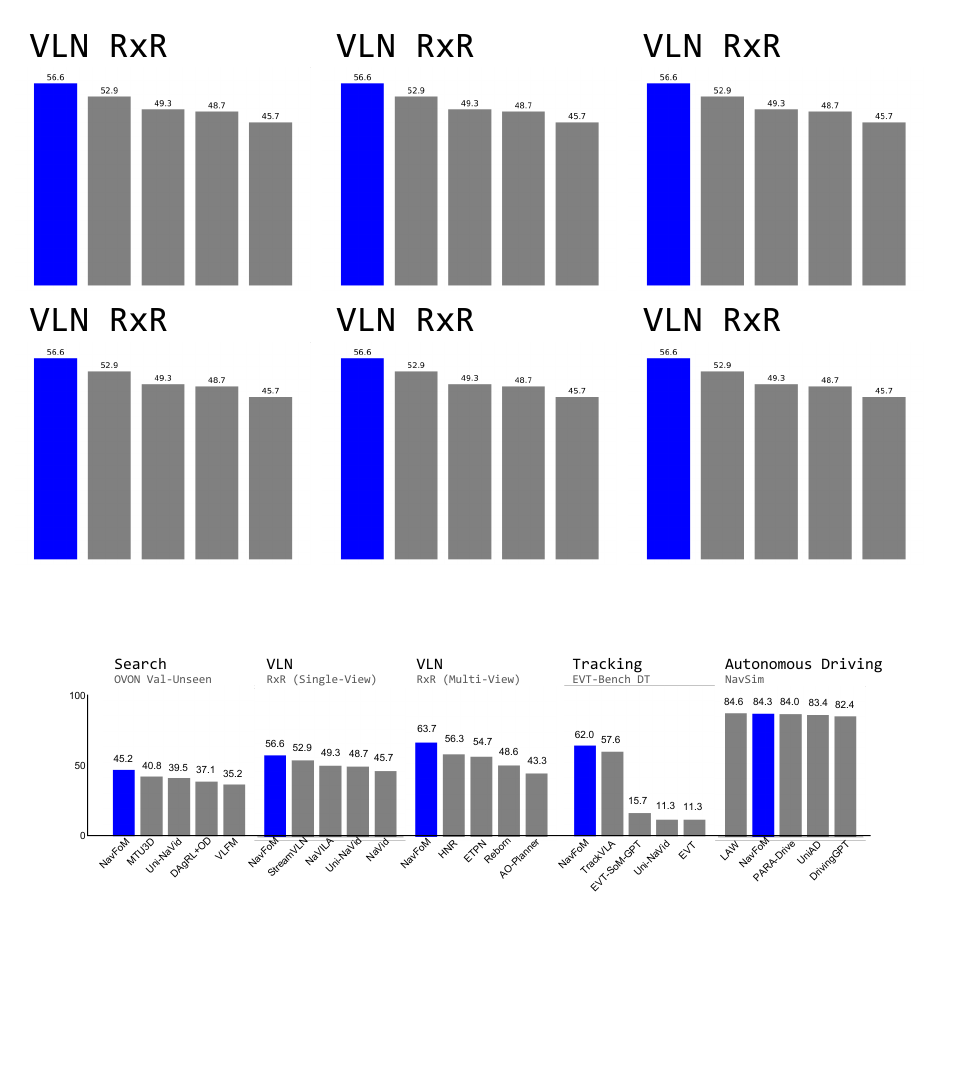
图 2:NavFoM 的基准性能。每个基准上均与最先进(State-of-the-Art,SOTA)基线比较,更多细节见第 4 节。
本文汇集了一个全面且多样的导航数据集,共包含 802 万条样本,来源包括公开导航数据集 [habitat19iccv; wang2025trackvla; openscene2023; wang2024openuav] 和 Web 视频伪导航数据 [li2025sekai]。该数据集包含来自四足机器人、无人机、轮式机器人和车辆的跨具身轨迹,覆盖视觉—语言导航、目标搜索、目标跟踪和自动驾驶等广泛任务。这些导航样本包含多样的指令和需要多项技能的场景,使 NavFoM 能够获得泛化的导航能力。本文还收集了 476 万条开放世界知识样本 [shen2024longvu; li2023llama],这些样本来自图像问答和视频问答任务。遵循 [zhang2024navid],以端到端方式对导航数据及图像、视频问答数据进行联合微调,从而支持 NavFoM 的大规模综合训练。
实验表明,NavFoM 显著推进了通用导航研究。无需针对特定任务微调,NavFoM 便在面向多种具身平台的各类公开基准上达到 SOTA 或具有竞争力的性能。在 VLN-CE RxR [anderson2020rxr] 上,与先前基线相比,NavFoM 在多相机设定下将成功率(SR)从 \(56.3\%\) 提升至 \(64.4\%\),在单相机设定下则从 \(51.8\%\) 提升至 \(57.4\%\)。在 HM3D-OVON [yokoyama2024hm3d] 上,本方法在零样本设定下达到 \(45.2\%\) 的 SR,超过先前经微调的 SOTA 方法(\(43.6\%\) SR)。在目标搜索、跟踪和自动驾驶的多个基准上也取得了同样优异的结果。本文进一步在多种真实机器人平台上验证 NavFoM,包括人形机器人、四足机器人、无人机和轮式机器人。这些结果凸显了模型的强泛化能力,也表明通用导航研究取得了可喜进展。
2 相关工作
用于导航的大模型。 将大语言模型(Large Language Model,LLM)和 VLM 融入机器人导航,推动该领域从传统学习方法转向利用预训练知识获得开放世界理解与强泛化能力。一条直接的技术路线 [zhou2023navgpt; shah2022lmnav; qiao2023march] 是以零样本方式使用现成的 LLM。这类工作通过思维链机制 [pan2023langnav; long2023discuss; lin2025navcot] 和结构化推理框架 [chen2024mapgpt; qiao2025open] 增强可解释性。然而,将稠密视觉信息抽象为文本会造成环境观测稀疏,且仅适用于静态环境。
另一条路线 [cheng2024navila; zhang2024navid; zhang2024uni; wei2025streamvln; wang2025trackvla] 使用导航数据对基于视频或图像 [zhou2025navgpt2; zheng2024towards; zhang-etal-2025-mapnav] 的 VLM 进行端到端微调,使其掌握导航能力。然而,现有方法大多关注同构具身平台,忽视了不同具身平台与任务之间潜在的训练协同效应。本文初步尝试将导航策略拓展至更广泛的跨具身、跨任务导航领域。
跨具身导航。 开发能够在形状、尺寸和传感器配置各异的具身平台之间泛化的导航模型,仍是具身智能领域的一项重大挑战。近期研究 [shah2023gnm; shah2023vint; yang2024pushing; wang2020environment; eftekhar2024one; hirose2023exaug; putta2024embodiment; curtis2024embodiment; wang2025x; zhang2025nava] 表明,在大规模跨具身数据集上训练的 Transformer 策略,无需人工对齐观测空间与动作空间,便有望在多种机器人平台上取得稳健性能。然而,这些模型处理多模态输入时通常未纳入明确的时空线索;由于不同具身平台对数据的几何解释各异,这可能引发歧义。该方式还可能造成数据利用效率低下,并限制模型向分布外具身平台的泛化能力 [eftekhar2024one; wang2025rethinking]。相比之下,NavFoM 引入了编码观测配置的时间—空间指示词元,使模型能够更准确地理解来自不同具身平台的多模态输入。
跨任务导航。 具身智能领域的最新进展 [o2024open; team2024octo; kim2024openvla; bjorck2025gr00t; black2024pi_0; intelligence2025pi_; bu2025univla; bu2025agibot; qu2025embodiedonevision] 表明,基于基础模型构建的通用模型能够在多种任务之间有效迁移知识。在导航领域,先前研究 [zhou2024same; wang2022towards; long2024instructnav; song2025towards; zhang2024uni; gao2025octonav; yin2025unigoal; ruan2025reactive] 表明,整合不同类型导航任务的数据可以提升模型在各类导航场景中的性能。早期工作 VIENNA [wang2022towards] 使用强化学习在模拟器中训练智能体。近期,Uni-Navid [zhang2024uni] 基于视频 VLM 开发了通用模型,通过视觉—语言导航、目标物体导航、具身问答和人员跟随四类任务上的跨任务学习,掌握泛化的导航技能。然而,这些方法局限于受约束的环境(例如室内可控环境),本文则拓展至更广泛的场景(例如自动驾驶和无人机导航),并以统一形式涵盖所有任务。在该框架中,模型以 RGB 视频和自然语言指令为输入,输出可执行轨迹。
3 方法
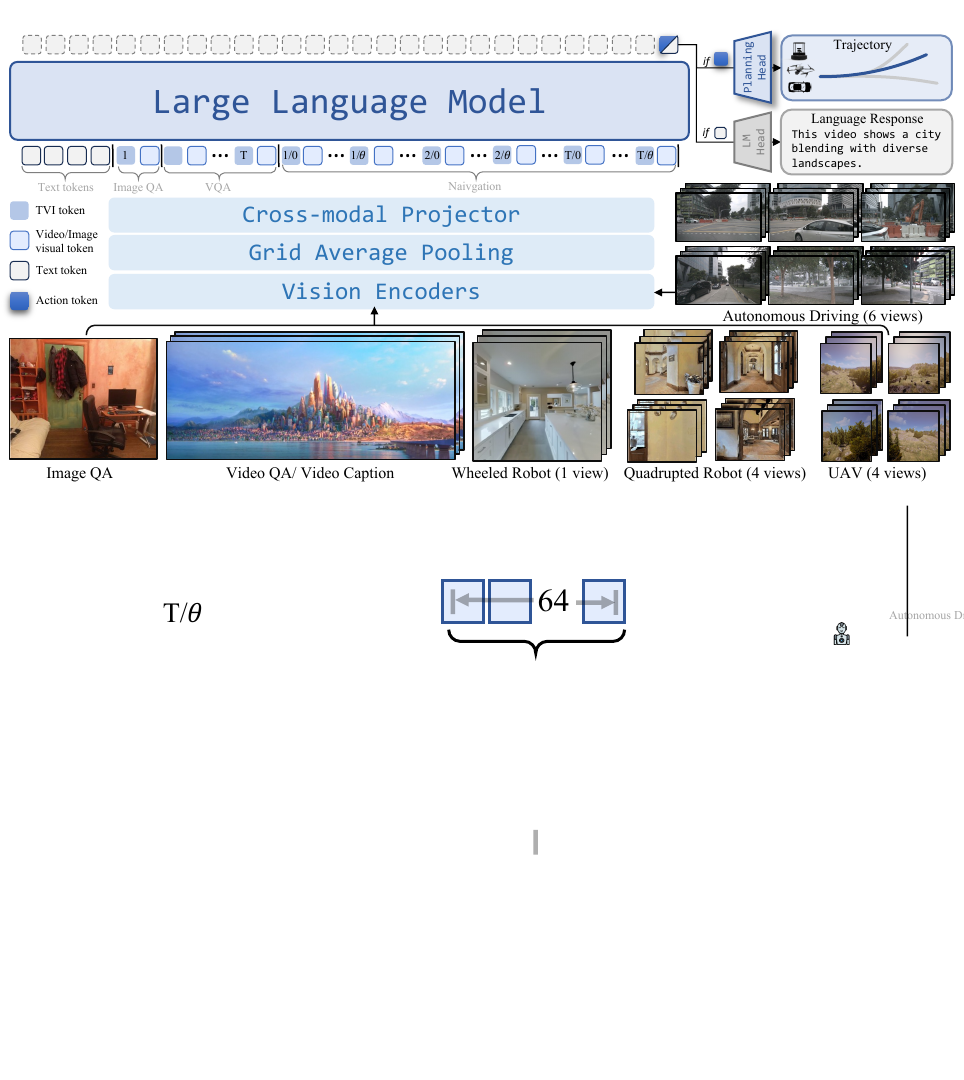
图 3:NavFoM 流程。统一框架处理图像问答、视频问答和导航;TVI 词元组织文本与视觉词元。问答任务使用自回归语言建模头,导航任务使用规划头直接预测轨迹。
通用导航任务。 本文考虑一种通用导航设置:移动具身接收文本指令 \(L\),以及在时间步 \(\{1,\ldots,T\}\) 由 \(N\) 个不同相机在线采集的图像序列 \(I_{1:T}^{1:N}\in\mathbb{R}^{W\times H\times3}\)。给定这些观测与指令,模型 \(\pi\) 需要预测导航轨迹 \(\tau=\{\mathbf a_1,\mathbf a_2,\ldots\}\),其中每个 \(\mathbf a\in\mathbb{R}^4=(x,y,z,\theta)\) 表示包含位置与朝向的航点。\(z\) 仅用于无人机,\(\theta\) 表示偏航角;由于任务不要求敏捷飞行动作,偏航角即可满足要求。模型按照映射 \(\pi(L,I_{1:T}^{1:N})\mapsto\tau_T\) 驱动移动具身完成指令。
基本架构。 本文将基础视频 VLM [li2023llama; shen2024longvu] 扩展为同时处理导航与问答的双分支架构 [wang2025trackvla]。导航分支先用视觉编码器和跨模态投影器 [liu2023llava] 编码观测图像 \(I_{1:T}^{1:N}\),得到视觉词元 \(E_{1:T}^{1:N}\);再遵循现有语言模型做法嵌入指令,生成语言词元 \(E_L\)。视觉词元经 TVI 和 BATS 组织后,与语言词元拼接并输入 LLM,以预测动作词元;该词元随后由规划模型解码,生成基于航点的轨迹:
对于问答任务,遵循 [liu2023llava] 以自回归方式进行下一词元预测。与已有工作 [zhang2024navid; zhang2024uni; wang2025trackvla; cheng2024navila] 一致,本模型支持对导航与问答样本联合微调。
3.1 导航基础模型
观测编码。 给定时间步 \(T\) 从 \(N\) 个相机视点采集的自我中心 RGB 序列 \(I_{1:T}^{1:N}\in\mathbb{R}^{W\times H\times3}\),采用预训练视觉编码器 DINOv2 [oquab2023dinov2] 与 SigLIP [zhai2023siglip] 提取视觉特征 \(\mathbf V_{1:T}^{\text{dino/SigLIP}}\in\mathbb{R}^{P\times C}\);这一组合已得到广泛使用 [kim2024openvla; tong2024eyes]。其中 \(P\) 是图像块数量(设为 576),\(C\) 是嵌入维度。为节省词元并提高计算效率,沿通道维直接拼接 \(V_{1:T}^{\text{dino}}\) 与 \(V_{1:T}^{\text{siglip}}\),将所得表示记为 \(V_{1:T}\)。
在线导航视频会产生大量帧和视觉特征,因此对视觉特征采用网格平均池化 [zhang2024navid; zhang2024uni],生成两个分辨率尺度的紧凑表示:
\(V^{\text{fine}}\in\mathbb{R}^{64\times C}\) 提供细粒度观测,\(V^{\text{coarse}}\in\mathbb{R}^{4\times C}\) 提供粗粒度观测。最新导航观测和图像问答(时间步 \(T\))使用细粒度特征,导航历史与视频数据(时间步 \(1:T\))使用粗粒度特征。最后,遵循现有 VLM [liu2023llava; li2023llama],用两层 MLP 跨模态投影器 \(\mathcal P(\cdot)\) 将视觉特征投影至 LLM 潜在空间:\(\mathbf E_T^V=\mathcal P(V_{1:T}^{1:N})\)。
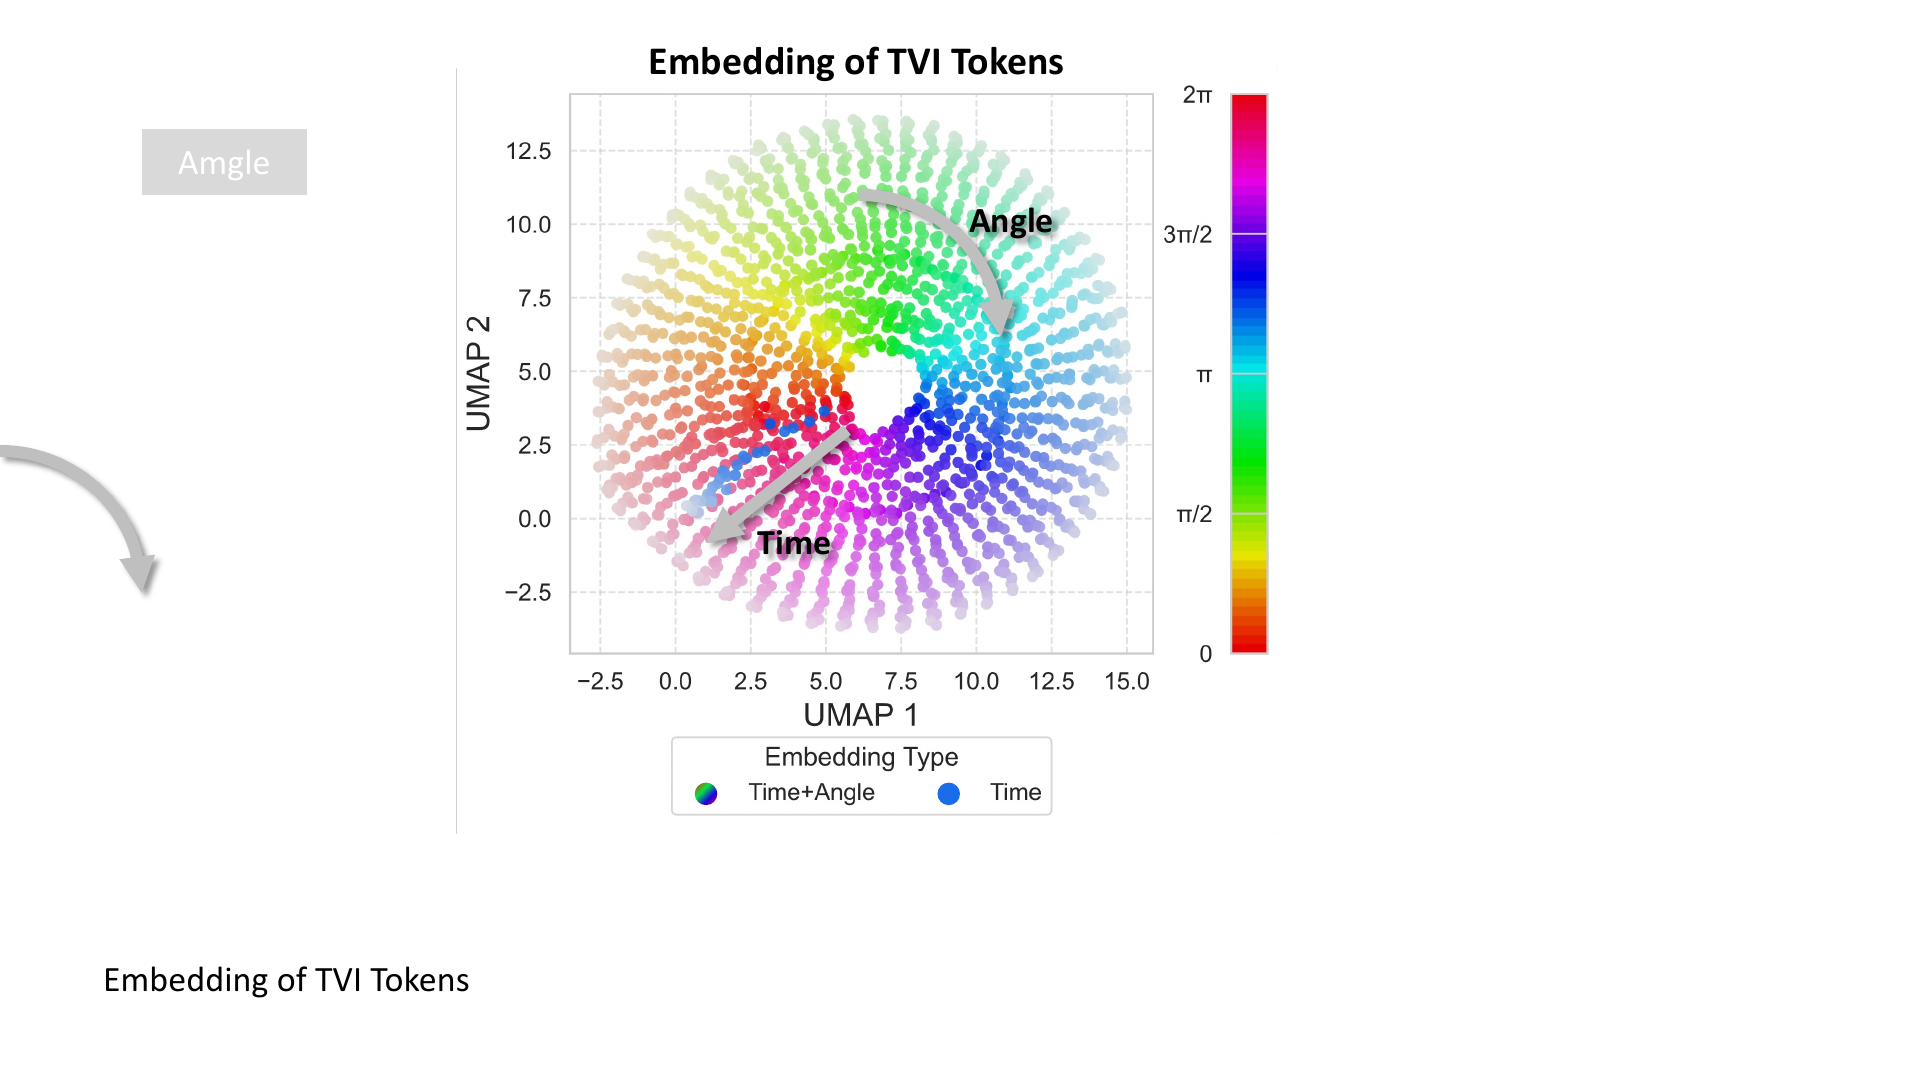
图 4:TVI 词元可视化。使用 UMAP [mcinnes2018umap] 将高维嵌入映射到二维空间。
3.1.1 时间—视点指示(TVI)词元
视觉词元本身不包含视点和时间信息,因此多视点导航模型的关键挑战是使 LLM 能辨别哪些词元对应不同时间步或不同相机视点。以往方法或局限于特定相机配置/具身 [long2024instructnav; gao2025octonav],或仅拼接所有视点图像的词元 [zheng2024towards; fu2025orion],未发挥 LLM 词元组织的灵活性。为灵活处理任意相机布局,本文提出 TVI 词元。其设计受专用词元在时间、模态及任务标识方面有效性的启发 [guo2025seed1; chen2023minigpt]。指示词元用于图像问答、视频问答和导航,并应满足三项属性:
- 视点感知: 角度嵌入保持方位角的环状连续性(例如 \(0\equiv2\pi\)),使嵌入距离反映几何邻近性(例如当 \(\epsilon\ne\pi\) 时,\(d(0,\epsilon)<d(0,\pi)\))。
- 时间感知: 唯一标识所有相机视点下各帧的时间顺序,并对不规则采样间隔保持稳健。
- 可分离性: 指示词元可以仅编码视点或时间信息,也可以完全不编码这些信息。
TVI 词元 \(\mathbf E_{\mathrm{TVI}}\in\mathbb{R}^C\)(时间步和视角分别为 \(t\) 与 \(\phi\))由角度嵌入 \(\operatorname{AnglePE}(\phi)\)、时间嵌入 \(\operatorname{TimePE}(t)\) 和可学习基础嵌入 \(\mathbf E_{\mathrm{Base}}\) 组成:
\(\operatorname{AnglePE}(\phi)\) 分别对方位角的余弦值与正弦值应用正弦位置编码 [vaswani2017attention],再拼接二者;\(\operatorname{TimePE}(t)\) 是 \(t\) 的正弦位置编码。\(\mathcal P_{\mathrm{time}}\) 与 \(\mathcal P_{\mathrm{angle}}\) 均为两层 MLP,设计类似 [liu2023llava]。
导航任务包含时间与视点信息;视频问答包含时间信息;图像问答仅使用 \(E_{\mathrm{Base}}\) 指示其后为视觉词元。该策略能灵活组织差异显著的样本类型,并有助于 LLM 学习。图 4 的聚类结果显示,词元可按视点 \(\theta\)(彩虹色条)和时间步 \(t\)(颜色明度)区分。尽管还可采用位置编码等方式引入多视点信息 [zheng2024towards],消融实验表明,额外指示词元在训练期间最稳健,评估表现也最好。原因可能是此类词元不会扰动现成的视觉词元空间;相关文献 [guo2025seed1; chen2023minigpt] 也报告了相似发现。
3.1.2 预算感知时间采样(BATS)
在线导航视频会产生过多视觉词元,增加推理与训练时间并阻碍真实部署。以往方法包括:(1) 词元合并 [zhang2024uni],会引入额外训练开销并导致评估时推理速度不一致;(2) 均匀采样 [cheng2024navila],由于缺少短期上下文,往往不能充分捕获近期观测。相机视点数量可变时,两种策略还都需要额外调整。
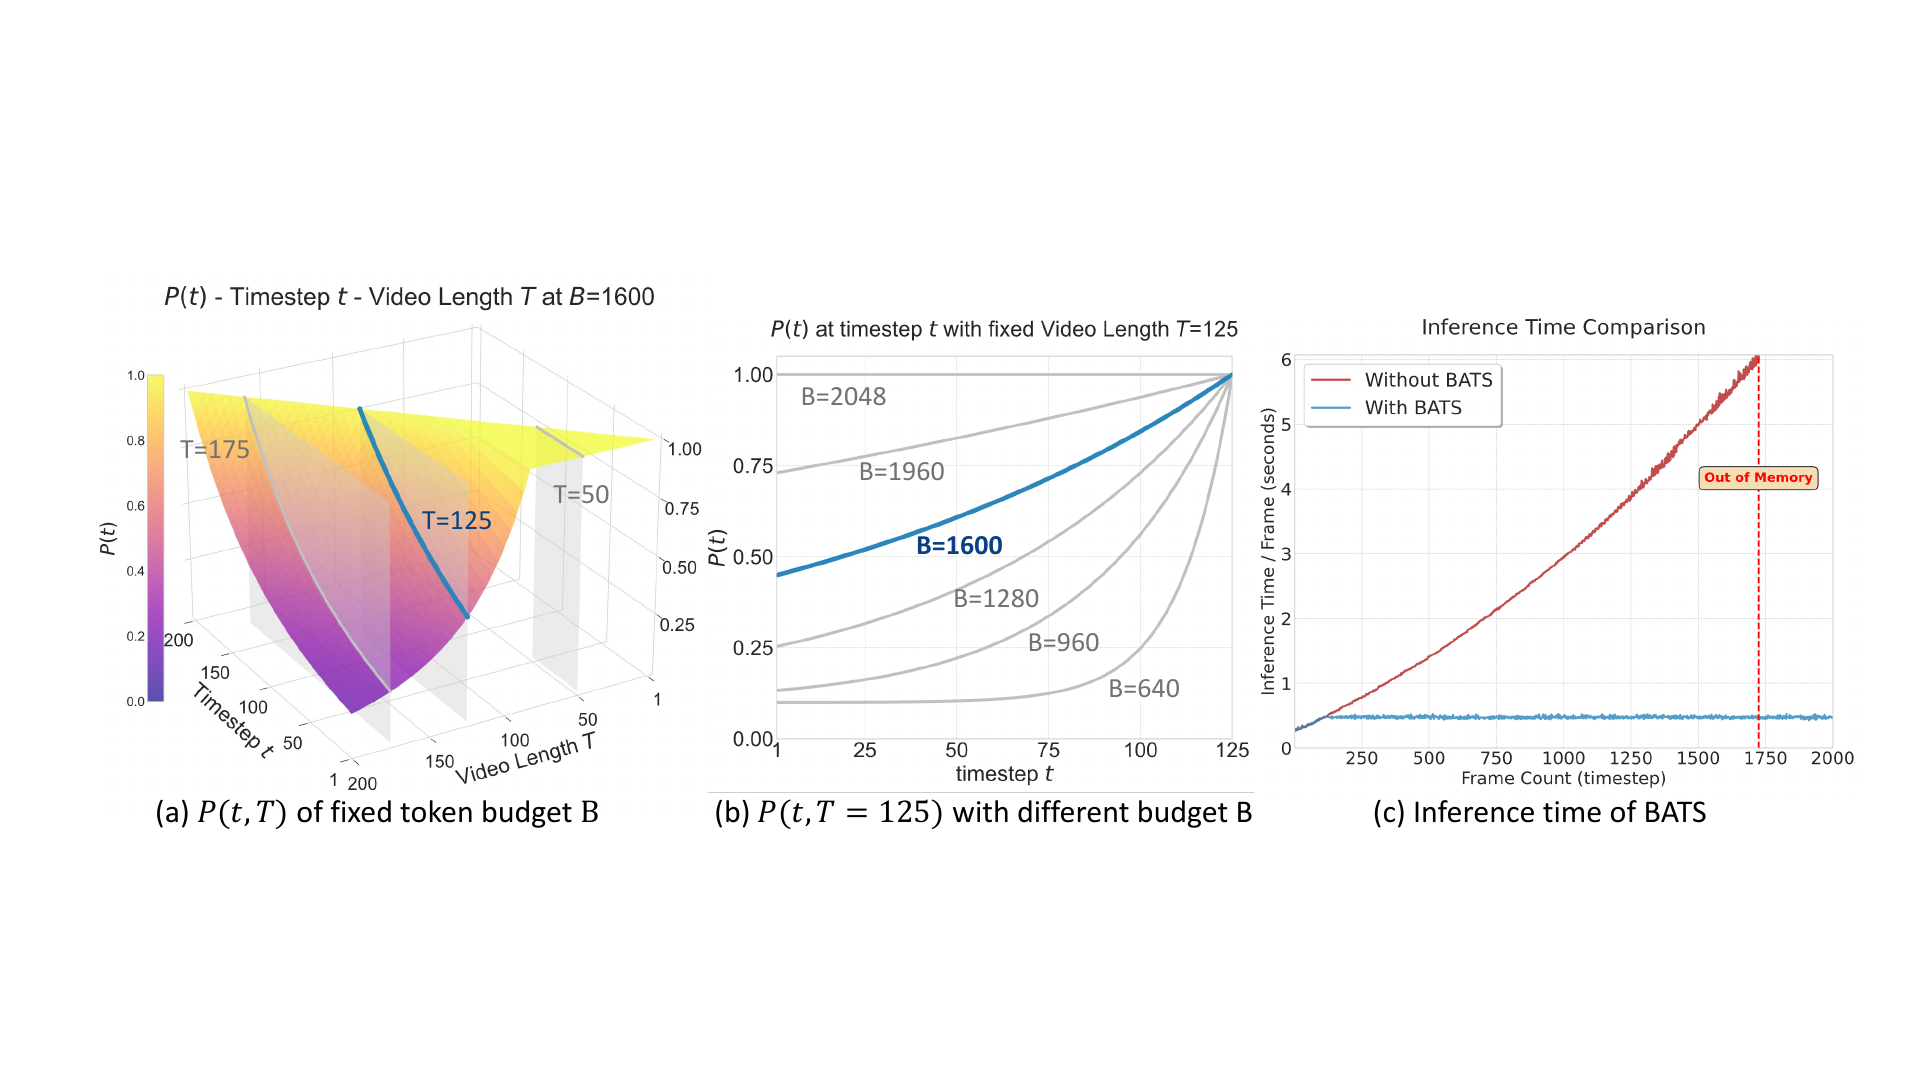
图 5:BATS 及其耗时。(a) 固定词元预算 \(B=1600\) 时不同时间步的采样概率;(b) 固定最大时间步 \(T=125\) 时不同预算下的概率;(c) 使用和不使用 BATS 的推理耗时。
BATS 的目标是:(a) 限制最大词元长度,以适应推理速度和 GPU 显存限制;(b) 保留更多近期信息,同时维持足够历史上下文;(c) 直接适配不同相机数量。给定词元预算 \(B_{\mathrm{token}}\) 和多视点视频 \(I_{1:T}^{1:N}\),当帧词元超过预算时,根据受遗忘曲线启发的指数形式计算每帧采样概率:
其中 \(\epsilon=0.1\) 确保概率下界,\(k\) 是指数衰减率。采样帧数期望为:
词元数量期望 \(((4+1)\mathbb E_{\mathrm{frame}}+(64+1))N\) 被约束为不超过 \(B_{\mathrm{token}}\),因此:
帧数 \(T\) 足够大时,采样帧数收敛于其期望。不同 \(T\) 对应的 \(k\) 可用 Brent 方法 [brent2013algorithms] 离线求解。由于设置了下界 \(\epsilon\),\(T\) 很大时方程可能无解;例如四相机、\(B_{\mathrm{token}}=2048\) 时,\(T=1120\)。这种情况很少出现,因为 VLN-CE RxR [anderson2020rxr] 的大多数轨迹约为 122 步。实验显示,预算更高时 BATS 自适应保留更多历史词元;预算较低时仍维持合理下界,并在整个导航过程中保持稳定推理速度。
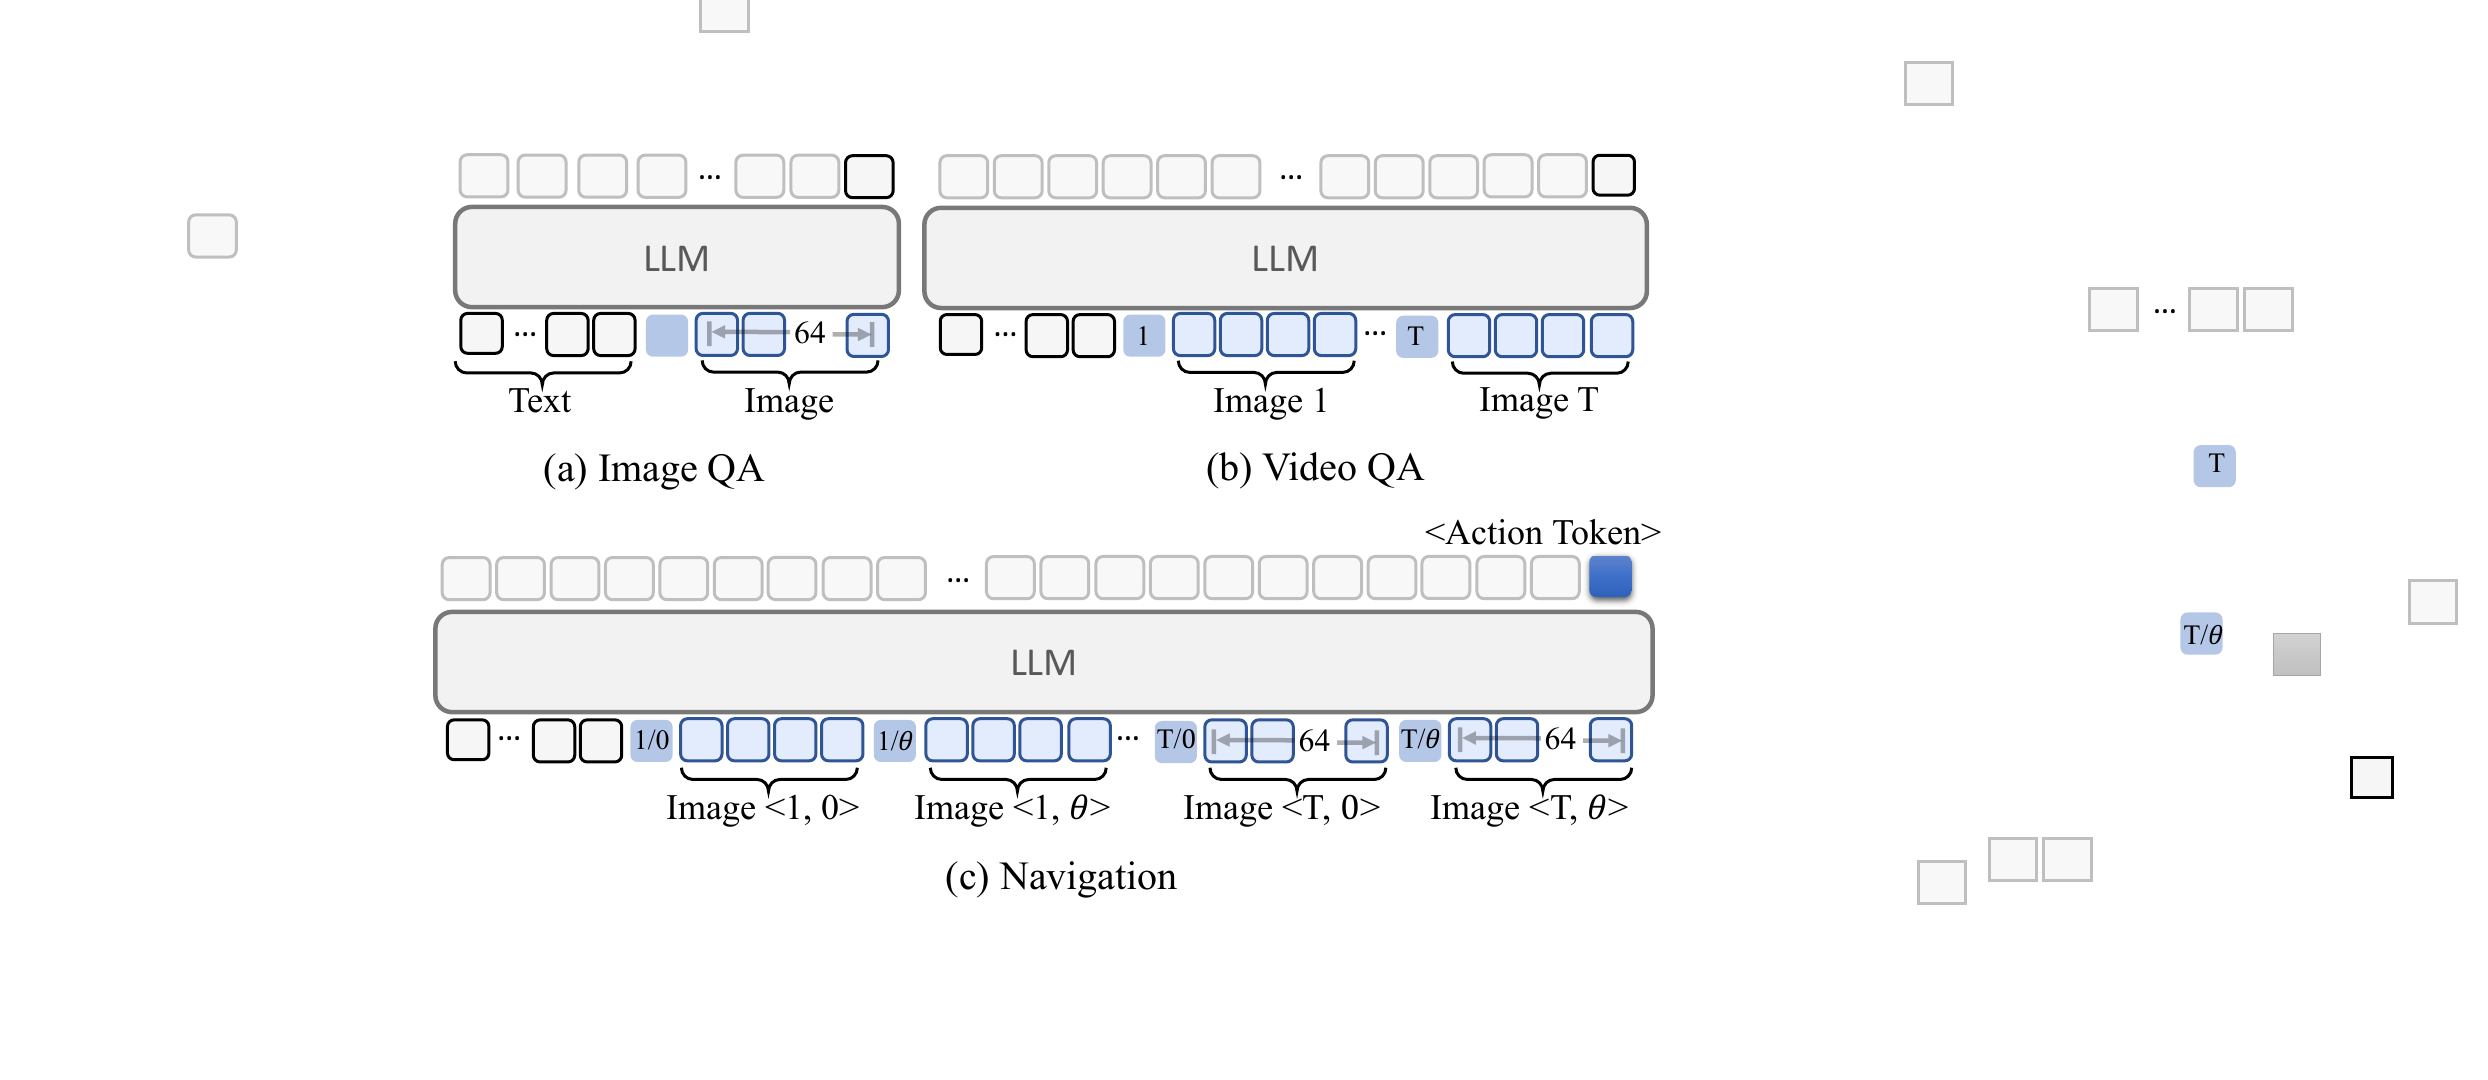
图 6:不同任务的词元组织策略。图像问答使用细粒度视觉词元和基础 TVI 嵌入;视频问答使用粗粒度词元、基础与时间嵌入;导航同时使用粗/细粒度词元以及基础、时间和角度嵌入。
3.1.3 LLM 前向传播
词元组织。 获得经 BATS 采样的视觉词元 \(E_{1:T}^{1:N}\) 与语言词元 \(E_L\) 后,用 TVI 词元组织并送入 LLM。图像问答使用 \(E_{\mathrm{Base}}\) 和细粒度视觉词元(每幅图像 64 个);视频问答用 \(\mathbf E_{\mathrm{Base}}+\mathcal P_{\mathrm{time}}(\operatorname{TimePE}(t))\) 编码每帧时间信息,并使用粗粒度词元(每帧 4 个);导航用 \(\mathbf E_{\mathrm{Base}}+\mathcal P_{\mathrm{time}}(\operatorname{TimePE}(t))+\mathcal P_{\mathrm{angle}}(\operatorname{AnglePE}(\phi))\) 同时表示时间与视点。最新观测使用细粒度词元,历史观测使用粗粒度词元。这一组织方式支持统一处理图像问答、视频问答和导航。
轨迹预测。 给定 LLM 输出的动作隐状态 \(E_T^A\),三层 MLP 规划模型 \(\mathcal A_\theta\) 提取轨迹 \(\tau_T\)。原始轨迹尺度从数米(室内)到数十米(自动驾驶和无人机)不等,直接预测会造成航点分布发散。因此使用任务特定缩放因子 \(\alpha_{\mathrm{task}}\) 将航点归一化到 \([-1,1]\),室内、无人机和汽车使用不同因子:
归一化轨迹乘以 \(\alpha_{\mathrm{task}}\) 恢复绝对值。轨迹损失为 \(L_{\mathrm{nav}}=\operatorname{MSE}(\tau^{\mathrm{idx}},\tau_{\mathrm{gt}}^{\mathrm{idx}})\),其中 idx 表示有效动作索引。轮式机器人/汽车使用 \(\mathbf a^{\mathrm{idx}}=(x,y,\theta)\),无人机使用 \((x,y,z,\theta)\)。问答任务采用下一词元预测的交叉熵损失 \(L_{\mathrm{QA}}\)。混合批次总损失为 \(L=\beta L_{\mathrm{nav}}+L_{\mathrm{QA}}\),其中 \(\beta=10\),用于放大数值较小的导航均方误差损失。
3.2 数据
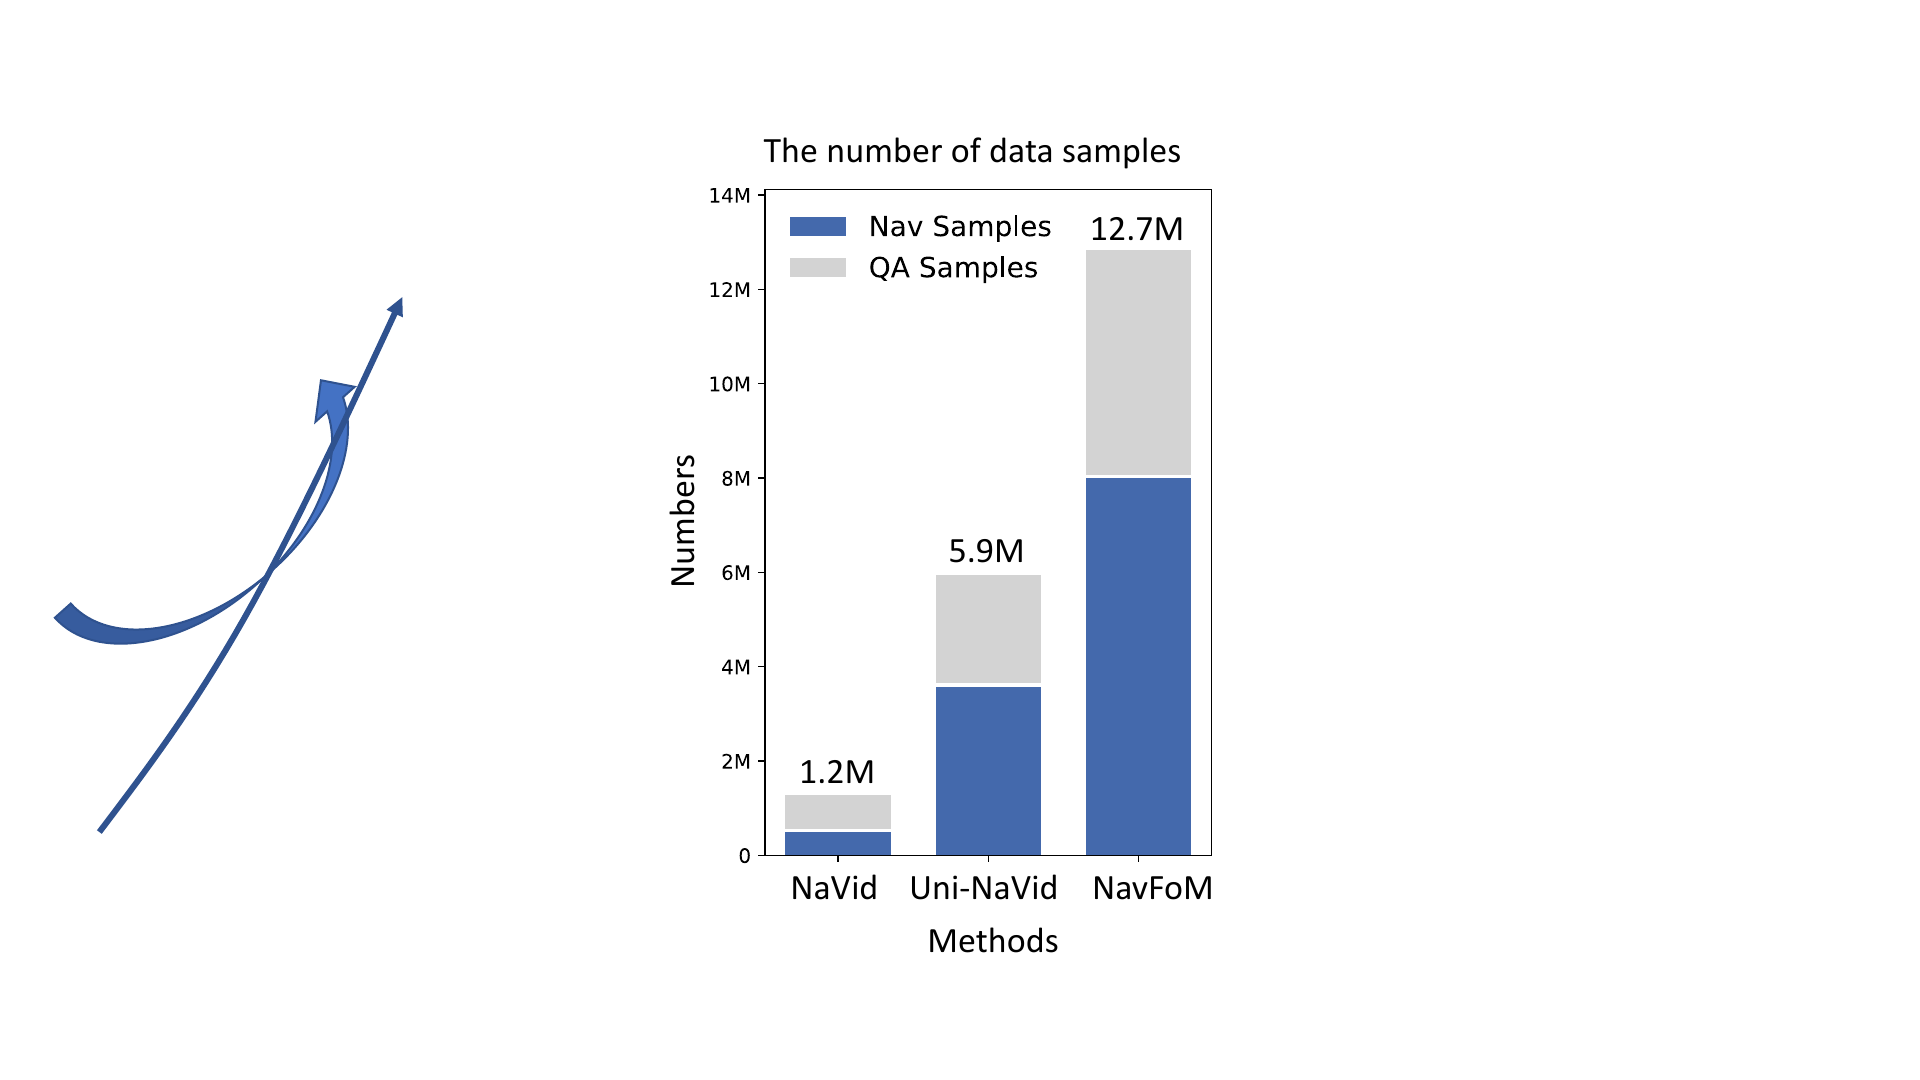
图 7:与以往方法的训练样本数量比较。
为微调 NavFoM,本文收集和处理了 1,270 万条多样化训练样本,包括 802 万条导航样本、315 万条图像问答样本和 161 万条视频问答样本,规模大于以往方法 [zhang2024navid; zhang2024uni]。导航样本覆盖轮式机器人、四足机器人、无人机和汽车,以及视觉—语言导航、目标物体导航、主动视觉跟踪和自动驾驶。所有导航数据均以统一形式组织,包含预先采集的单/多相机视频、指令和轨迹航点。问答样本则依照现有视频 VLM [shen2024longvu; li2023llama] 从现成数据集收集。
视觉—语言导航(337 万)。 智能体需理解自然语言指令和自我中心视觉观测,将二者对齐并规划动作,到达指令描述的地标。本文采用广义 VLN 定义 [zheng2024towards; wang2025rethinking; zhou2024same],同时涵盖部署于机器人的室内环境(VLN-CE R2R [krantz2020beyond] 和 RxR [anderson2020rxr])与部署于无人机的室外环境(OpenUAV [wang2024openuav])。对于 R2R 与 RxR(294 万),机器人沿真值路径移动时采集多视角 RGB 视频、带标注指令和轨迹;相机组包含固定前视相机与随机采样的 1–8 个环视相机,相机高度在 0.6–1.5 m 随机变化,水平视场角在 \(75^\circ\)–\(120^\circ\) 变化。对于 OpenUAV(42.9 万),所有序列记录前、左、右、后四路相机流,其余随机化策略与 VLN-CE 一致。
目标物体导航(102 万)。 机器人需探索未见环境并找到描述目标。按照 [zhang2024uni],从显式建模探索和识别阶段的启发式方法 L3MVN [yu2023l3mvn] 中收集成功轨迹。样本来自 HM3D ObjectNav [habitat19iccv],要求智能体寻找预定义类别物体(如沙发、椅子和床)。尽管如此,实验表明该方法能泛化到开放词汇目标搜索。此任务未采用多相机或相机随机化,以保持与 L3MVN 相同的视觉配置。
主动视觉跟踪(89.7 万)。 机器人需在动态拥挤环境中区分目标。目标由文本指定,例如“跟随穿蓝色 T 恤的男子”。智能体必须识别人类外观、跟随正确目标、保持适当距离并避障。本文使用与 [wang2025trackvla] 一致的 EVT-Bench 数据,涵盖多种室内环境、数百个带描述的虚拟人,并采用与 VLN 相同的相机随机化。
自动驾驶(68.1 万)。 智能体需在复杂动态真实环境中生成安全、舒适且满足运动学约束的轨迹,持续感知环境、预测其他交通参与者并做出稳健连续决策。本文分别处理 nuScenes [Driving_Dataset_Nuscenes] 的 2.7 万条样本和 OpenScene [openscene2023] 的 65.4 万条样本,直接记录原始多视角图像、指令和车辆状态;不同于常见自动驾驶基线 [chen2024drivinggpt; LAW],不采集车道等显式周边信息。
网络视频导航(203 万)。 Sekai [li2025sekai] 包含约 18.2 万个 YouTube 视频,以及由 VLM [bai2025qwen2] 生成的指令和由 SLAM [li2025megasam] 生成的轨迹。尽管这些样本的指令与轨迹并不完美,它们仍有助于引入真实世界导航场景;[cheng2024navila; wei2025streamvln] 也报告了相似发现。
开放世界问答(476 万)。 遵循视频 VLM [li2023llama; shen2024longvu; wang2025trackvla],收集 315 万条图像问答与 161 万条视频问答样本,为开放世界理解提供丰富知识。
3.3 实现细节
训练配置。 模型在 56 张 NVIDIA H100 GPU 的集群服务器上训练约 72 小时,共计 4,032 GPU 小时。问答数据以 1 FPS 采样,减少相邻帧冗余;Habitat 等离散导航环境 [habitat19iccv] 在机器人每次执行离散动作后采样一步;EVT-Bench [wang2025trackvla] 和自动驾驶 [caesar2020nuscenes; openscene2023] 等连续环境以 2 FPS 采样。视觉编码器 DINOv2、SigLIP 和 LLM Qwen2-7B [qwen2] 使用默认预训练权重初始化。遵循 VLM 训练范式 [liu2023llava],仅对指定可训练参数微调一个 epoch。
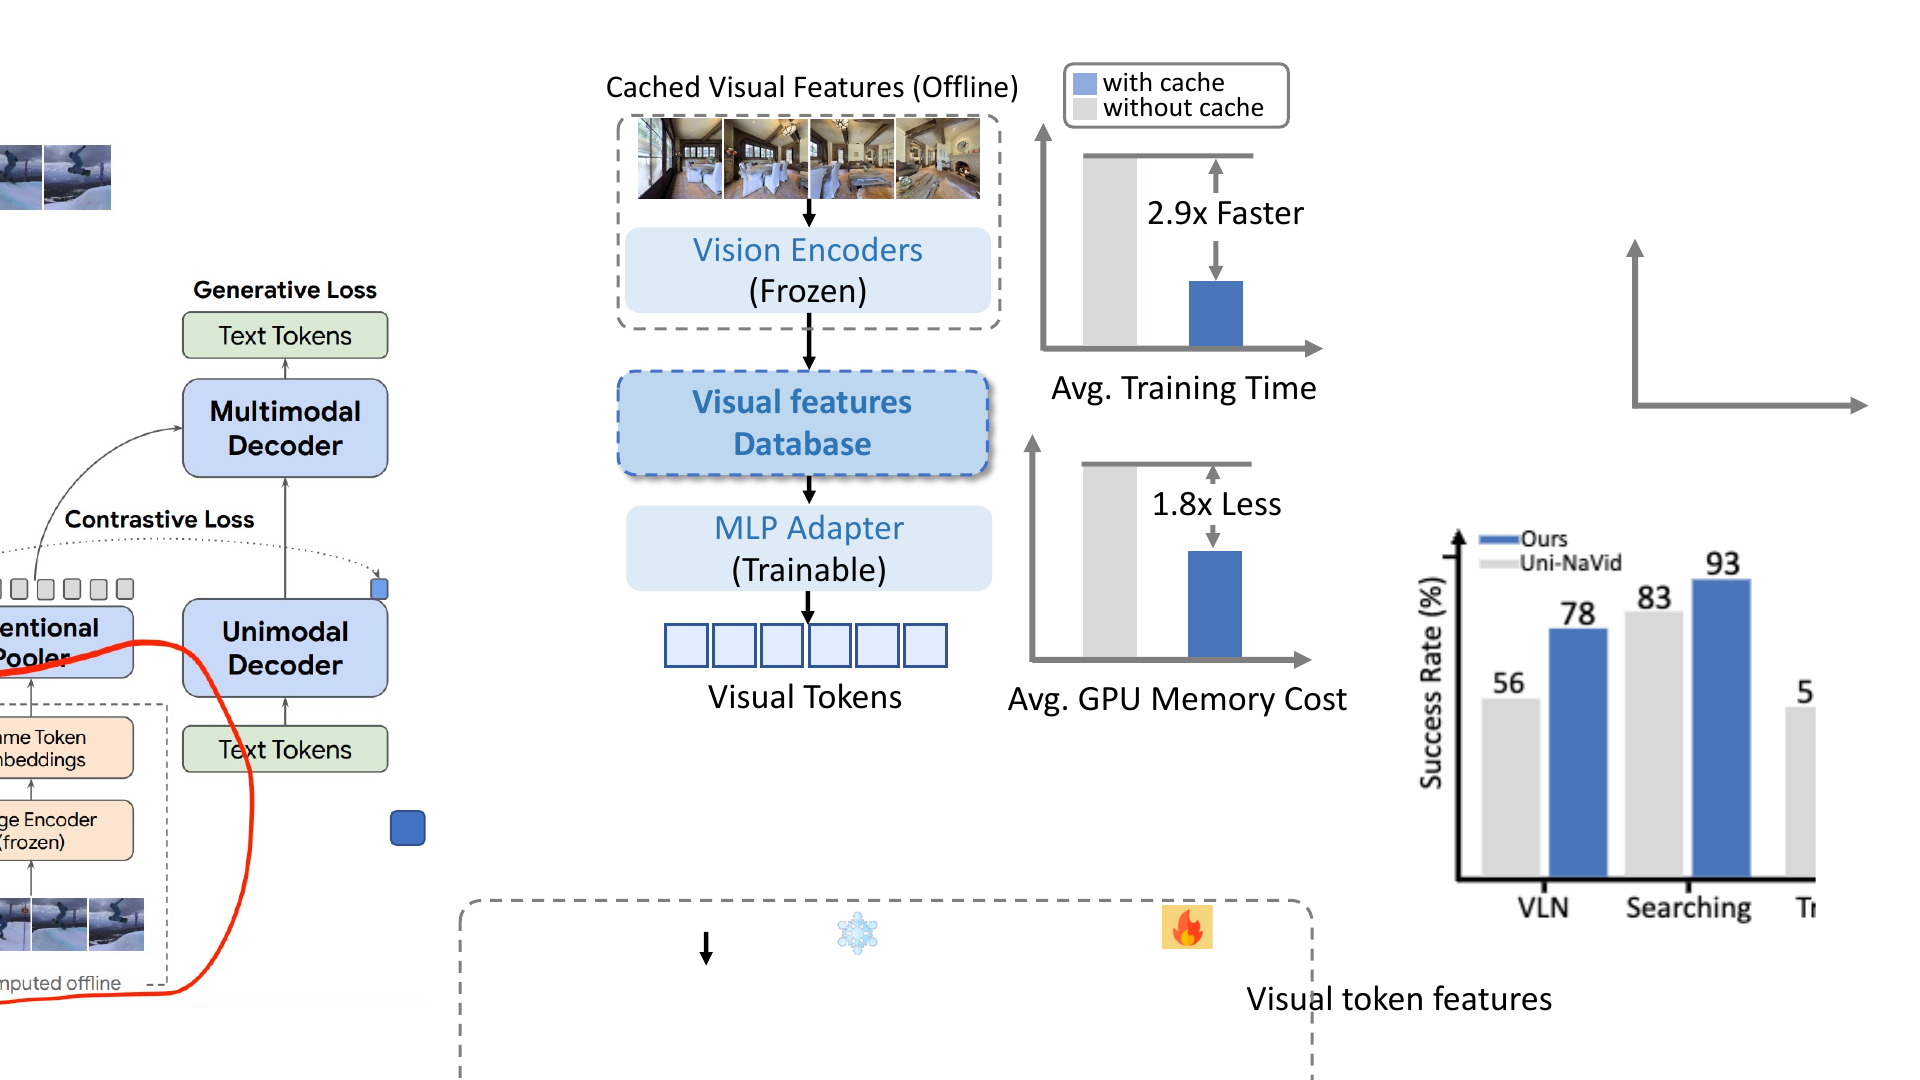
图 8:离线视觉特征缓存。预先计算视频帧和导航历史,并保存为粗粒度视觉词元。
通过缓存视觉特征加速训练。 长视频包含数百帧,大批次在线编码代价高昂。本文使用视觉特征缓存机制 [yan2022videococa] 构建数据库,仅缓存每帧 4 个粗粒度视觉词元;与存储完整视频相比,这显著节省磁盘空间,因为单个导航 episode 通常会产生数十段视频。图像问答与导航最新观测仍在线提取每帧 64 个细粒度词元。该方法将训练速度提高 2.9 倍,并将 GPU 显存占用降低 1.8 倍。
4 实验
4.1 实验设置
实验与消融围绕三个问题展开:(1) NavFoM 在不同基准的多种导航任务上表现如何?(2) 在真实环境中表现如何?(3) 关键设计组件是否有效?每个基准均与强基线比较。
基准。 评估涵盖 VLN、搜索、跟踪和自动驾驶,具身平台采用第一人称、四相机、六相机或八相机配置。所有基准中,NavFoM 仅以在线采集的自我中心视频(部分为多视角)和指令为输入,预测机器人执行轨迹。鉴于各基准跨越不同环境和模拟器,本文仔细核对场景划分,确保训练场景与验证场景不重叠。
- 视觉—语言导航: 在 VLN-CE R2R [krantz2020beyond] 与 RxR [anderson2020rxr] 的 Val-Unseen 划分上评估机器人在未见室内环境中遵循指令的能力;还在 OpenUAV [wang2024openuav] 上评估无人机在未见室外环境中的指令跟随能力。
- 目标物体导航: 按照 [zhang2024uni; zhu2025mtu],在开放词汇目标导航基准 HM3D-OVON [yokoyama2024hm3d] 上做零样本评估。
- 主动视觉跟踪: 在 EVT-Bench [wang2025trackvla] 上评估机器人在拥挤环境中区分并跟随目标的能力。
- 自动驾驶: 在主流基准 nuScenes [Driving_Dataset_Nuscenes] 与 NAVSIM [Driving_Dataset_NAVSIM] 上进行开环和伪模拟评估。
指标。 通用导航采用标准指标 [anderson2018vision]:成功率(SR)、预言成功率(OS)、路径长度加权成功率(SPL)、归一化动态时间规整(nDTW)和目标导航误差(NE)。跟踪使用跟踪率(TR)[puig2023habitat],即成功跟踪步数占总步数比例。各任务沿用其基准默认成功判据。自动驾驶开环规划报告 L2 距离与碰撞率(CR);NAVSIM 闭环评估使用 PDM 分数(PDMS),它综合无责任碰撞(NC)、可行驶区域合规(DAC)、碰撞时间(TTC)、舒适性(Comf.)和自车进度(EP)。
模拟器部署。 每种任务沿用先前工作的默认设置 [krantz2020beyond; savva2019habitat; das2018embodied; islam2019person]。输入是可变数量相机在线采集的 RGB 视频和文本指令,输出下一段轨迹。对于 Habitat-Lab 连续环境中使用 FORWARD、LEFT、RIGHT、STOP 等离散动作的基准,将离散动作替换为轨迹动作。
真实环境部署。 使用搭载 NVIDIA RTX 4090 的远程服务器运行 NavFoM。系统处理观测和文本指令,将动作命令发回本地机器人;实验覆盖四足、人形、无人机和轮式机器人。词元预算为 1600 时,模型最多用 0.5 秒生成包含 8 个航点的轨迹。导航期间,机器人异步压缩并上传最新观测,同时执行动作;不同机器人使用各自现成的局部规划器沿预测轨迹运动。
4.2 基准结果
VLN-CE R2R 与 RxR。 表 1 报告单相机和四相机(\(360^\circ\) 观测)结果。NavFoM 不针对具体相机配置微调,而是直接用 TVI 组织视觉词元。在单视角 RxR 这一最具挑战的设置中,SR 从先前的 \(51.8\%\) 提升到 \(57.4\%\)。多相机设置仅使用四个 RGB 相机,SR 达到 \(64.4\%\),超过依赖 RGB-D 和里程计的先前方法(\(56.3\%\))。从单视角切换到多视角后,R2R-CE 与 RxR-CE 的 SR 分别增加 \(5.5\%\) 和 \(7.0\%\)。与其他基线不同,本方法在指令更长、更复杂的 RxR 上优于 R2R,作者将其归因于 RxR 指令更具体、更详细,能提供更强的地标线索。
表 1:VLN-CE 单视角与多视角设置比较。S.RGB/M.RGB 表示单/多视角;星号表示使用 [hong2022bridging] 的航点预测器。NavFoM 不使用深度或里程计。
| 方法 | S.RGB | M.RGB | 深度 | 里程计 | R2R NE↓ | R2R OS↑ | R2R SR↑ | R2R SPL↑ | RxR NE↓ | RxR SR↑ | RxR SPL↑ | RxR nDTW↑ |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| AG-CMTP | ✓ | ✓ | ✓ | 7.90 | 39.0 | 23.0 | 19.0 | — | — | — | — | |
| R2R-CMTP | ✓ | ✓ | ✓ | 7.90 | 38.0 | 26.0 | 22.0 | — | — | — | — | |
| HPN+DN* | ✓ | ✓ | ✓ | 6.31 | 40.0 | 36.0 | 34.0 | — | — | — | — | |
| CMA* | ✓ | ✓ | ✓ | 6.20 | 52.0 | 41.0 | 36.0 | 8.76 | 26.5 | 22.1 | 47.0 | |
| VLN↻BERT* | ✓ | ✓ | ✓ | 5.74 | 53.0 | 44.0 | 39.0 | 8.98 | 27.0 | 22.6 | 46.7 | |
| Sim2Sim* | ✓ | ✓ | ✓ | 6.07 | 52.0 | 43.0 | 36.0 | — | — | — | — | |
| AO-Planner | ✓ | ✓ | 5.55 | 59.0 | 47.0 | 33.0 | 7.06 | 43.3 | 30.5 | 50.1 | ||
| GridMM* | ✓ | ✓ | ✓ | 5.11 | 61.0 | 49.0 | 41.0 | — | — | — | — | |
| Ego²-Map* | ✓ | ✓ | ✓ | 5.54 | 56.0 | 47.0 | 41.0 | — | — | — | — | |
| DreamWalker* | ✓ | ✓ | ✓ | 5.53 | 59.0 | 49.0 | 44.0 | — | — | — | — | |
| Reborn* | ✓ | ✓ | ✓ | 5.40 | 57.0 | 50.0 | 46.0 | 5.98 | 48.6 | 42.0 | 63.3 | |
| ETPNav* | ✓ | ✓ | ✓ | 4.71 | 65.0 | 57.0 | 49.0 | 5.64 | 54.7 | 44.8 | 61.9 | |
| HNR* | ✓ | ✓ | ✓ | 4.42 | 67.0 | 61.0 | 51.0 | 5.50 | 56.3 | 46.7 | 63.5 | |
| BEVBert* | ✓ | ✓ | ✓ | 4.57 | 67.0 | 59.0 | 50.0 | — | — | — | — | |
| HAMT+ScaleVLN* | ✓ | ✓ | ✓ | 4.80 | — | 55.0 | 51.0 | — | — | — | — | |
| NavFoM(四视角) | ✓ | 4.61 | 72.1 | 61.7 | 55.3 | 4.74 | 64.4 | 56.2 | 65.8 | |||
| LAW | ✓ | ✓ | ✓ | 6.83 | 44.0 | 35.0 | 31.0 | 10.90 | 8.0 | 8.0 | 38.0 | |
| CM2 | ✓ | ✓ | ✓ | 7.02 | 41.0 | 34.0 | 27.0 | — | — | — | — | |
| WS-MGMap | ✓ | ✓ | ✓ | 6.28 | 47.0 | 38.0 | 34.0 | — | — | — | — | |
| Seq2Seq | ✓ | ✓ | 7.77 | 37.0 | 25.0 | 22.0 | 12.10 | 13.9 | 11.9 | 30.8 | ||
| CMA | ✓ | ✓ | 7.37 | 40.0 | 32.0 | 30.0 | — | — | — | — | ||
| RGB-Seq2Seq | ✓ | 10.10 | 8.0 | 0.0 | 0.0 | — | — | — | — | |||
| RGB-CMA | ✓ | 9.55 | 10.0 | 5.0 | 4.0 | — | — | — | — | |||
| NaVid | ✓ | 5.72 | 49.2 | 41.9 | 36.5 | 5.72 | 45.7 | 38.2 | — | |||
| Uni-NaVid | ✓ | 5.58 | 53.3 | 47.0 | 42.7 | 6.24 | 48.7 | 40.9 | — | |||
| NaVILA | ✓ | 5.22 | 62.5 | 54.0 | 49.0 | 6.77 | 49.3 | 44.0 | 58.8 | |||
| StreamVLN-RGB-only | ✓ | 5.10 | 64.0 | 55.7 | 50.9 | 6.16 | 51.8 | 45.0 | 62.1 | |||
| NavFoM(单视角) | ✓ | 5.01 | 64.9 | 56.2 | 51.2 | 5.51 | 57.4 | 49.4 | 60.2 |
OpenUAV。 该任务要求无人机在室外环境遵循自然语言指令,执行平均 200 m 的长时轨迹到达目标。训练轨迹直接来自 TravelUAV 训练集,近似真值轨迹;目标物体导航那样的强专家采集器并不可用。即便如此,本方法无需 TravelUAV 使用的下视相机,仍优于无人机专用基线。未见地图划分要求平均穿越 300 m 的复杂街区寻找未见目标,所有方法表现都较差,说明高质量无人机数据和大范围高效探索能力仍然不足。
表 2:采用 L1 级辅助的 OpenUAV 完整结果。Seen 为已见划分,UO/UM 分别为未见物体/未见地图;DA 表示回溯采样数据聚合。
| 方法/划分 | 全部 NE↓ | SR↑ | OSR↑ | SPL↑ | 简单 NE↓ | SR↑ | OSR↑ | SPL↑ | 困难 NE↓ | SR↑ | OSR↑ | SPL↑ |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 人类 / Seen | 14.15 | 94.51 | 94.51 | 77.84 | 11.68 | 95.44 | 95.44 | 76.19 | 17.16 | 93.37 | 93.37 | 79.85 |
| 随机动作 / Seen | 222.20 | 0.14 | 0.21 | 0.07 | 142.07 | 0.26 | 0.39 | 0.13 | 320.12 | 0.00 | 0.00 | 0.00 |
| 固定动作 / Seen | 188.61 | 2.27 | 8.16 | 1.40 | 121.36 | 3.48 | 11.48 | 2.14 | 270.69 | 0.79 | 4.09 | 0.49 |
| CMA / Seen | 135.73 | 8.37 | 18.72 | 7.90 | 84.89 | 11.48 | 24.52 | 10.68 | 197.77 | 4.57 | 11.65 | 4.51 |
| TravelUAV / Seen | 106.28 | 16.10 | 44.26 | 14.30 | 68.78 | 18.84 | 47.61 | 16.39 | 152.04 | 12.76 | 40.16 | 11.76 |
| TravelUAV-DA / Seen | 98.66 | 17.45 | 48.87 | 15.76 | 66.40 | 20.26 | 51.23 | 18.10 | 138.04 | 14.02 | 45.98 | 12.90 |
| NavFoM / Seen | 93.05 | 29.17 | 49.24 | 25.03 | 58.98 | 32.91 | 53.16 | 27.87 | 143.83 | 23.58 | 43.40 | 20.80 |
| 随机动作 / UO | 260.14 | 0.16 | 0.16 | 0.16 | 174.10 | 0.48 | 0.48 | 0.48 | 302.96 | 0.00 | 0.00 | 0.00 |
| 固定动作 / UO | 212.84 | 3.66 | 9.54 | 2.16 | 151.66 | 6.70 | 13.88 | 3.72 | 243.29 | 2.14 | 7.38 | 1.38 |
| CMA / UO | 155.79 | 9.06 | 16.06 | 8.68 | 102.92 | 14.83 | 22.49 | 13.90 | 182.09 | 6.19 | 12.86 | 6.08 |
| TravelUAV / UO | 118.04 | 22.42 | 46.90 | 20.51 | 86.12 | 24.40 | 49.28 | 22.03 | 134.03 | 21.43 | 45.71 | 19.75 |
| NavFoM / UO | 108.04 | 29.83 | 47.99 | 27.20 | 70.51 | 32.54 | 50.72 | 29.54 | 133.01 | 28.03 | 46.18 | 25.64 |
| 随机动作 / UM | 202.98 | 0.00 | 0.00 | 0.00 | 158.46 | 0.00 | 0.00 | 0.00 | 265.88 | 0.00 | 0.00 | 0.00 |
| 固定动作 / UM | 180.47 | 0.52 | 2.61 | 0.39 | 132.89 | 0.89 | 4.28 | 0.67 | 247.72 | 0.00 | 0.25 | 0.00 |
| CMA / UM | 141.68 | 2.30 | 10.02 | 2.16 | 102.29 | 3.57 | 14.26 | 3.33 | 197.35 | 0.50 | 4.03 | 0.50 |
| TravelUAV / UM | 138.80 | 4.18 | 20.77 | 3.84 | 102.94 | 4.63 | 22.82 | 4.24 | 189.46 | 3.53 | 17.88 | 3.28 |
| NavFoM / UM | 125.10 | 6.30 | 18.95 | 5.68 | 102.41 | 6.77 | 20.07 | 6.04 | 170.58 | 5.36 | 15.71 | 4.97 |
HM3D-OVON 搜索。 按照 [zhang2024uni; zhu2025mtu],在开放词汇基准上做零样本评估。单相机设置下,本方法在 Val Seen 与 Val Seen Synonyms 上接近 SOTA;在更难的 Val Unseen 上,SR 从 \(40.8\%\) 提升到 \(43.6\%\)。切换到四相机后,所有划分和指标均进一步提高。模型只用单相机搜索样本训练,因此结果表明跨相机配置联合微调增强了对不同配置的泛化。
表 3:HM3D-OVON 目标物体导航。星号表示零样本评估。
| 方法 | Seen SR↑ | Seen SPL↑ | Seen Synonyms SR↑ | Seen Synonyms SPL↑ | Unseen SR↑ | Unseen SPL↑ |
|---|---|---|---|---|---|---|
| BC | 11.1 | 4.5 | 9.9 | 3.8 | 5.4 | 1.9 |
| DAgger | 11.1 | 4.5 | 9.9 | 3.8 | 5.4 | 1.9 |
| RL | 18.1 | 9.4 | 15.0 | 7.4 | 10.2 | 4.7 |
| BCRL | 39.2 | 18.7 | 27.8 | 11.7 | 18.6 | 7.5 |
| DAgRL | 41.3 | 21.2 | 29.4 | 14.4 | 18.3 | 7.9 |
| VLFM* | 35.2 | 18.6 | 32.4 | 17.3 | 35.2 | 19.6 |
| DAgRL+OD | 38.5 | 21.1 | 39.0 | 21.4 | 37.1 | 19.8 |
| Uni-NaVid* | 41.3 | 21.1 | 43.9 | 21.8 | 39.5 | 19.8 |
| MTU3D | 55.0 | 23.6 | 45.0 | 14.7 | 40.8 | 12.1 |
| NavFoM*(单视角) | 37.7 | 25.5 | 43.3 | 29.9 | 43.6 | 31.3 |
| NavFoM*(四视角) | 40.1 | 27.1 | 45.4 | 32.6 | 45.2 | 31.9 |
EVT-Bench 跟踪。 在单目标和干扰目标划分上分别评估单视角与四视角。模型只在单视角设置训练,四视角为零样本测试。单视角下,本方法与专门在跟踪数据上微调的 TrackVLA 相比达到 SOTA;增加为四视角后性能继续提升。与 VLN 的 \(6.8\%\) SR 增益相比,跟踪的增益仅 \(0.6\%\),原因可能是 EVT-Bench 默认大多数目标生成在机器人前方。未来可通过随机环绕目标等模拟和方法改进进一步研究。
表 4:EVT-Bench 性能。\(\dagger\) 使用 GroundingDINO 作为开放词汇检测器;\(\ddagger\) 使用 SoM + GPT-4o 作为视觉基础模型。
| 方法 | 单目标 SR↑ | 单目标 TR↑ | 干扰目标 SR↑ | 干扰目标 TR↑ |
|---|---|---|---|---|
| IBVS† | 42.9 | 56.2 | 10.6 | 28.4 |
| PoliFormer† | 4.67 | 15.5 | 2.62 | 13.2 |
| EVT | 24.4 | 39.1 | 3.23 | 11.2 |
| EVT‡ | 32.5 | 49.9 | 15.7 | 35.7 |
| Uni-NaVid | 25.7 | 39.5 | 11.3 | 27.4 |
| TrackVLA | 85.1 | 78.6 | 57.6 | 63.2 |
| NavFoM(单视角) | 85.0 | 80.5 | 61.4 | 68.2 |
| NavFoM(四视角) | 88.4 | 80.7 | 62.0 | 67.9 |
NAVSIM 与 nuScenes 自动驾驶。 在六视角和八视角设置中评估,且不针对具体配置微调。NavFoM 在两个基准上都接近 SOTA,而没有显式建模车道线、周边车辆等驾驶信息。加入场景描述提示可能进一步提升结果;作者也计划在 CARLA [dosovitskiy2017carla] 等闭环自动驾驶模拟器中评估。
表 5:NAVSIM navtest 的闭环规划指标。\(\mathcal V_{8192}\) 表示 8192 个锚点。
| 方法 | 相机 | 激光雷达 | 基于 VLM | NC↑ | DAC↑ | TTC↑ | Comf.↑ | EP↑ | PDMS↑ |
|---|---|---|---|---|---|---|---|---|---|
| 人类驾驶 | — | — | — | 100 | 100 | 100 | 99.9 | 87.5 | 94.8 |
| 恒定速度 | — | — | — | 69.9 | 58.8 | 49.3 | 100 | 49.3 | 21.6 |
| 自车状态 MLP | — | — | — | 93.0 | 77.3 | 83.6 | 100 | 62.8 | 65.6 |
| LTF | ✓ | ✓ | — | 97.4 | 92.8 | 92.4 | 100 | 79.0 | 83.8 |
| Transfuser | ✓ | ✓ | — | 97.7 | 92.8 | 92.8 | 100 | 79.2 | 84.0 |
| VADv2-\(\mathcal V_{8192}\) | ✓ | ✓ | — | 97.2 | 89.1 | 91.6 | 100 | 76.0 | 80.9 |
| Hydra-MDP-\(\mathcal V_{8192}\) | ✓ | ✓ | — | 97.9 | 91.7 | 92.9 | 100 | 77.6 | 83.0 |
| DiffusionDrive | ✓ | ✓ | — | 98.2 | 96.2 | 94.7 | 100 | 82.2 | 88.1 |
| DRAMA | ✓ | ✓ | ✓ | 98.0 | 93.1 | 94.8 | 100 | 80.1 | 85.5 |
| UniAD | ✓ | — | — | 97.8 | 91.9 | 92.9 | 100 | 78.8 | 83.4 |
| PARA-Drive | ✓ | — | — | 97.9 | 92.4 | 93.0 | 99.8 | 79.3 | 84.0 |
| LAW | ✓ | — | — | 96.4 | 95.4 | 88.7 | 99.9 | 81.7 | 84.6 |
| DrivingGPT | ✓ | — | ✓ | 98.9 | 90.7 | 94.9 | 95.6 | 79.7 | 82.4 |
| NavFoM(八视角) | ✓ | — | ✓ | 97.7 | 93.5 | 92.3 | 100 | 79.6 | 84.3 |
表 6:nuScenes 的开环规划指标,计算遵循 DiffusionDrive。
| 方法 | 相机 | 基于 VLM | L2 1s↓ | 2s↓ | 3s↓ | 平均↓ | 碰撞 1s↓ | 2s↓ | 3s↓ | 平均↓ |
|---|---|---|---|---|---|---|---|---|---|---|
| ST-P3 | ✓ | — | 1.33 | 2.11 | 2.90 | 2.11 | 0.23 | 0.62 | 1.27 | 0.71 |
| UniAD | ✓ | — | 0.45 | 0.70 | 1.04 | 0.73 | 0.62 | 0.58 | 0.63 | 0.61 |
| VAD | ✓ | — | 0.41 | 0.70 | 1.05 | 0.72 | 0.07 | 0.17 | 0.41 | 0.22 |
| SparseDrive | ✓ | — | 0.29 | 0.58 | 0.96 | 0.61 | 0.01 | 0.05 | 0.18 | 0.08 |
| DiffusionDrive | ✓ | — | 0.27 | 0.54 | 0.90 | 0.57 | 0.03 | 0.05 | 0.16 | 0.08 |
| DriveVLM | ✓ | ✓ | 0.18 | 0.34 | 0.68 | 0.40 | 0.10 | 0.22 | 0.45 | 0.27 |
| EMMA | ✓ | ✓ | 0.14 | 0.29 | 0.54 | 0.32 | — | — | — | — |
| DME-Driver | ✓ | ✓ | 0.45 | 0.91 | 1.58 | 0.98 | 0.05 | 0.28 | 0.55 | 0.29 |
| Omni-Q | ✓ | ✓ | 0.14 | 0.29 | 0.55 | 0.33 | 0.00 | 0.13 | 0.78 | 0.30 |
| Omni-L | ✓ | ✓ | 0.15 | 0.36 | 0.70 | 0.40 | 0.06 | 0.27 | 0.72 | 0.35 |
| ORION | ✓ | ✓ | 0.17 | 0.31 | 0.55 | 0.34 | 0.05 | 0.25 | 0.80 | 0.37 |
| NavFoM(六视角) | ✓ | ✓ | 0.26 | 0.39 | 0.60 | 0.42 | 0.07 | 0.11 | 0.18 | 0.12 |
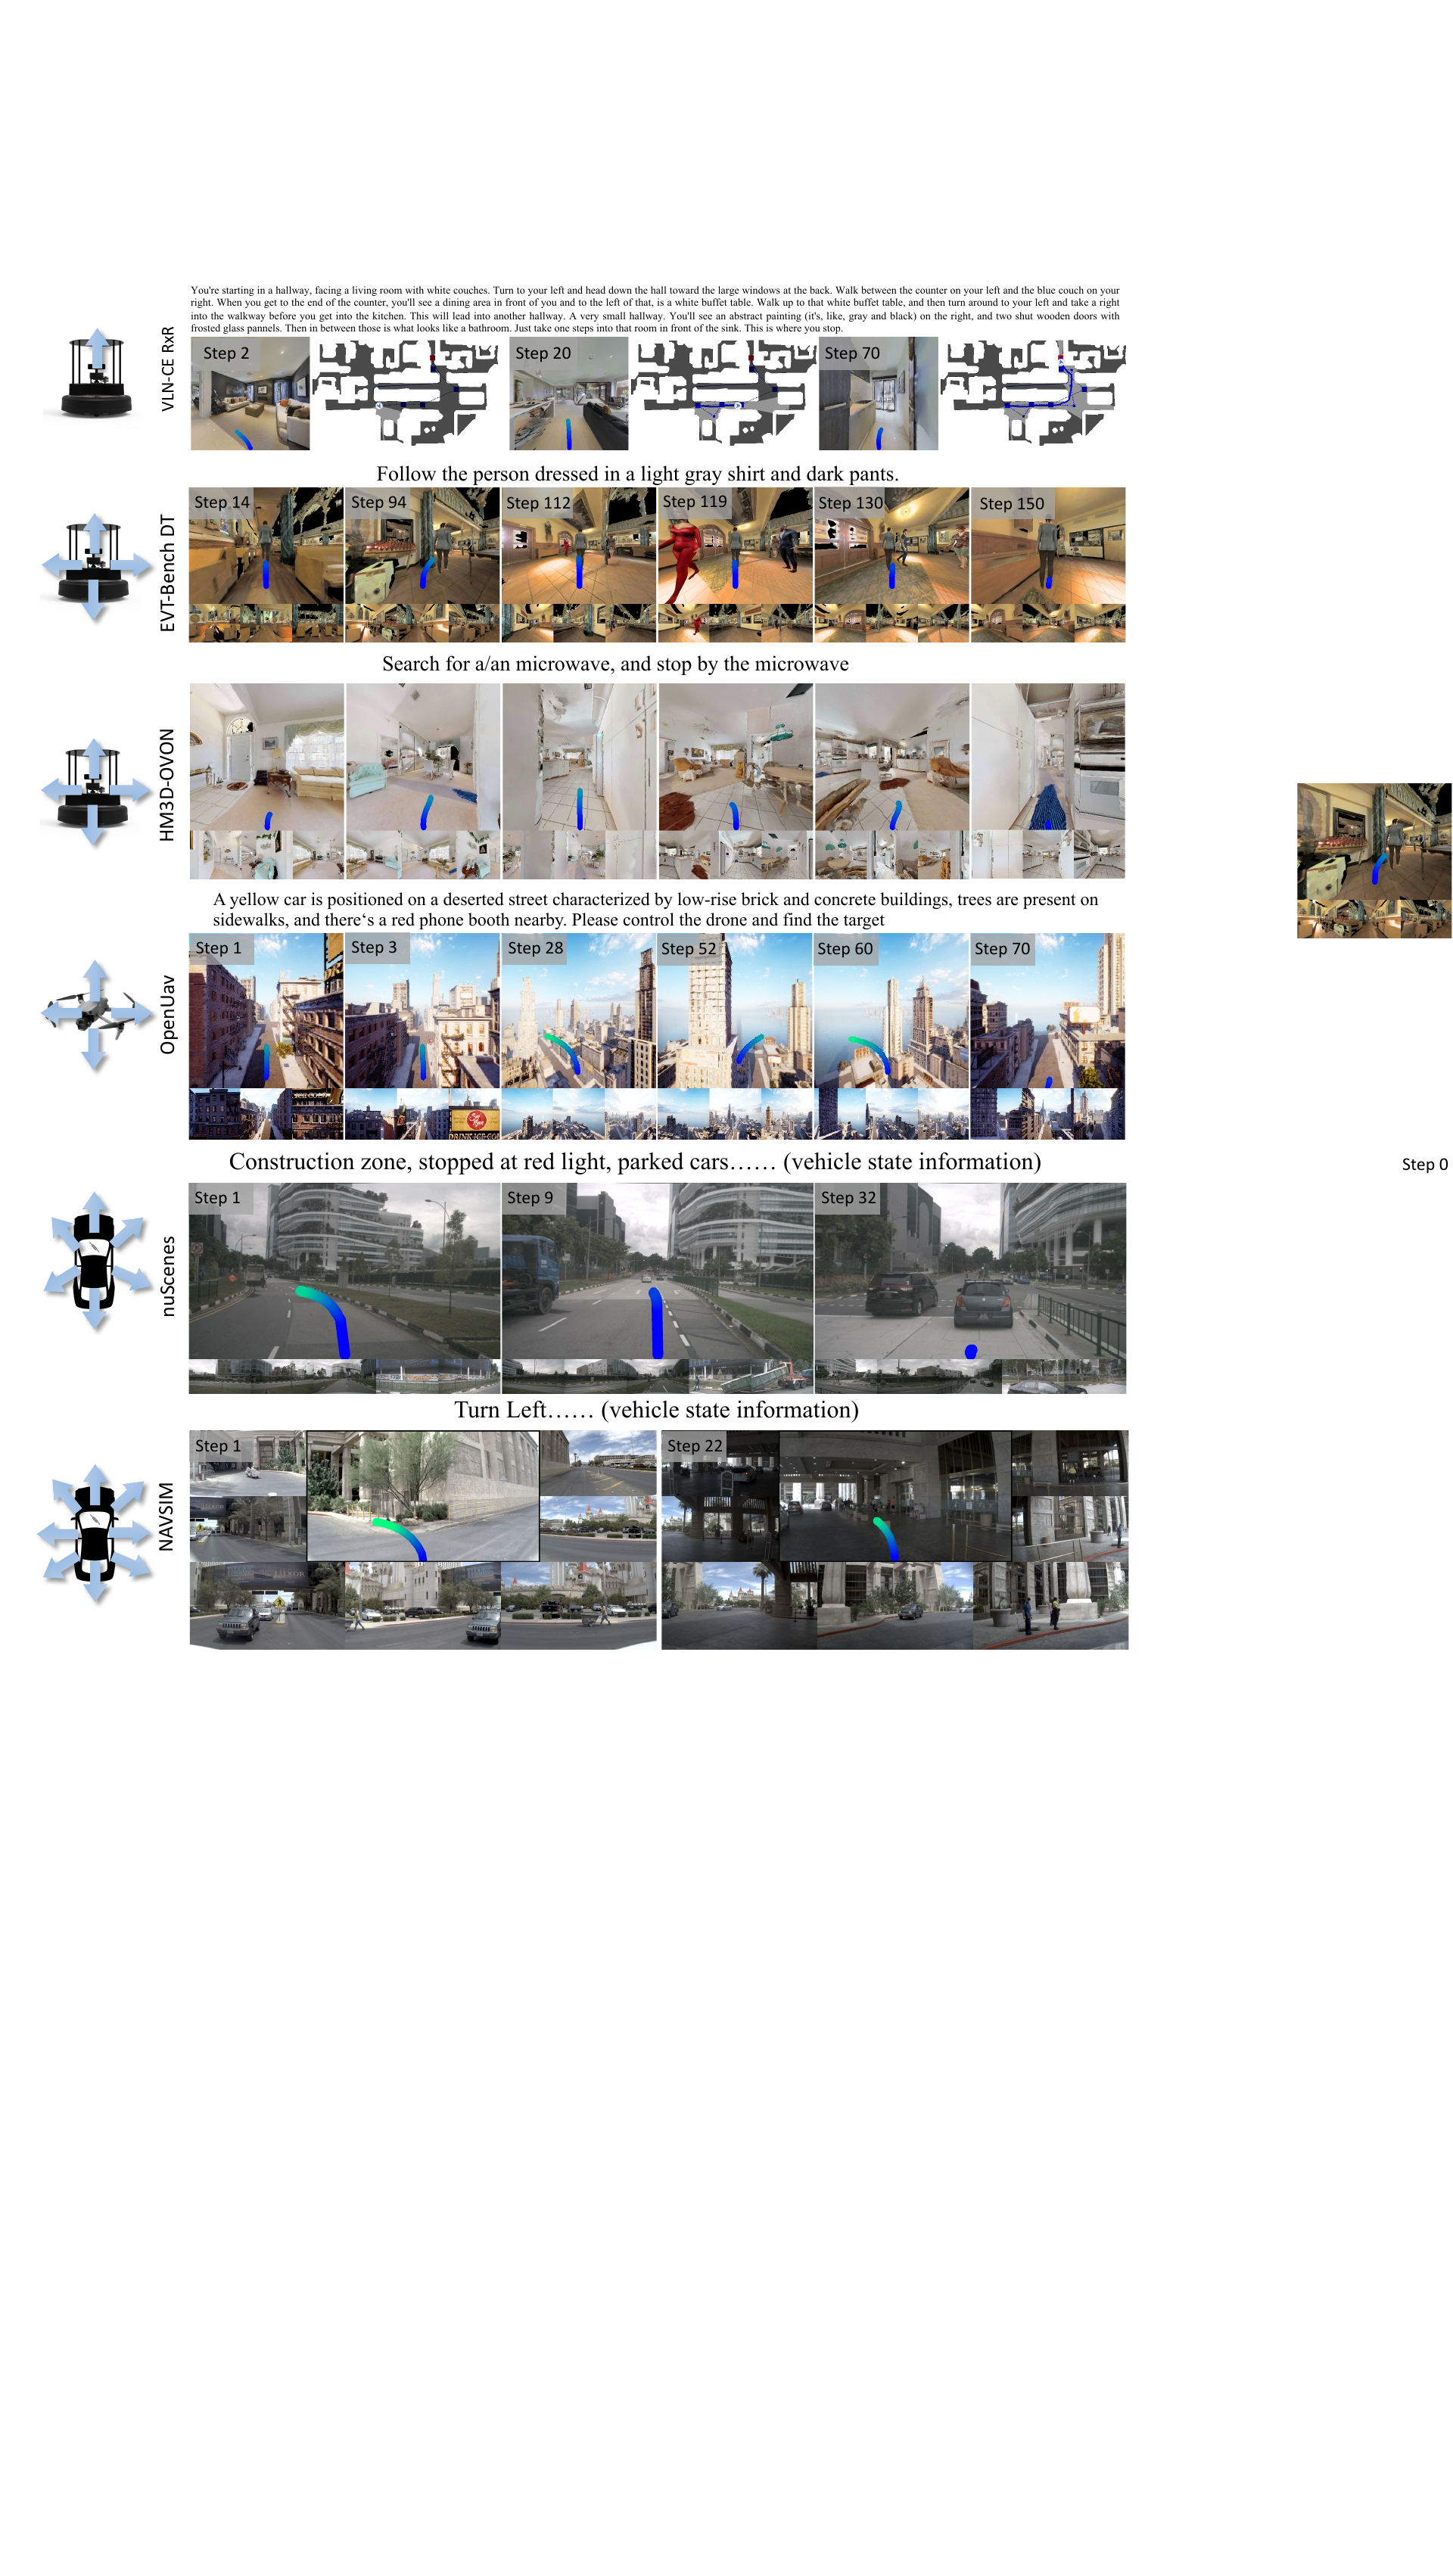
图 9:基准性能可视化。依次展示 VLN-CE RxR(单视角)、EVT-Bench Distracted Targets(四视角)、OpenUAV(四视角)、nuScenes(六视角)和 OpenScene(八视角)上的预测轨迹、相机视图与指令。
4.3 真实世界结果
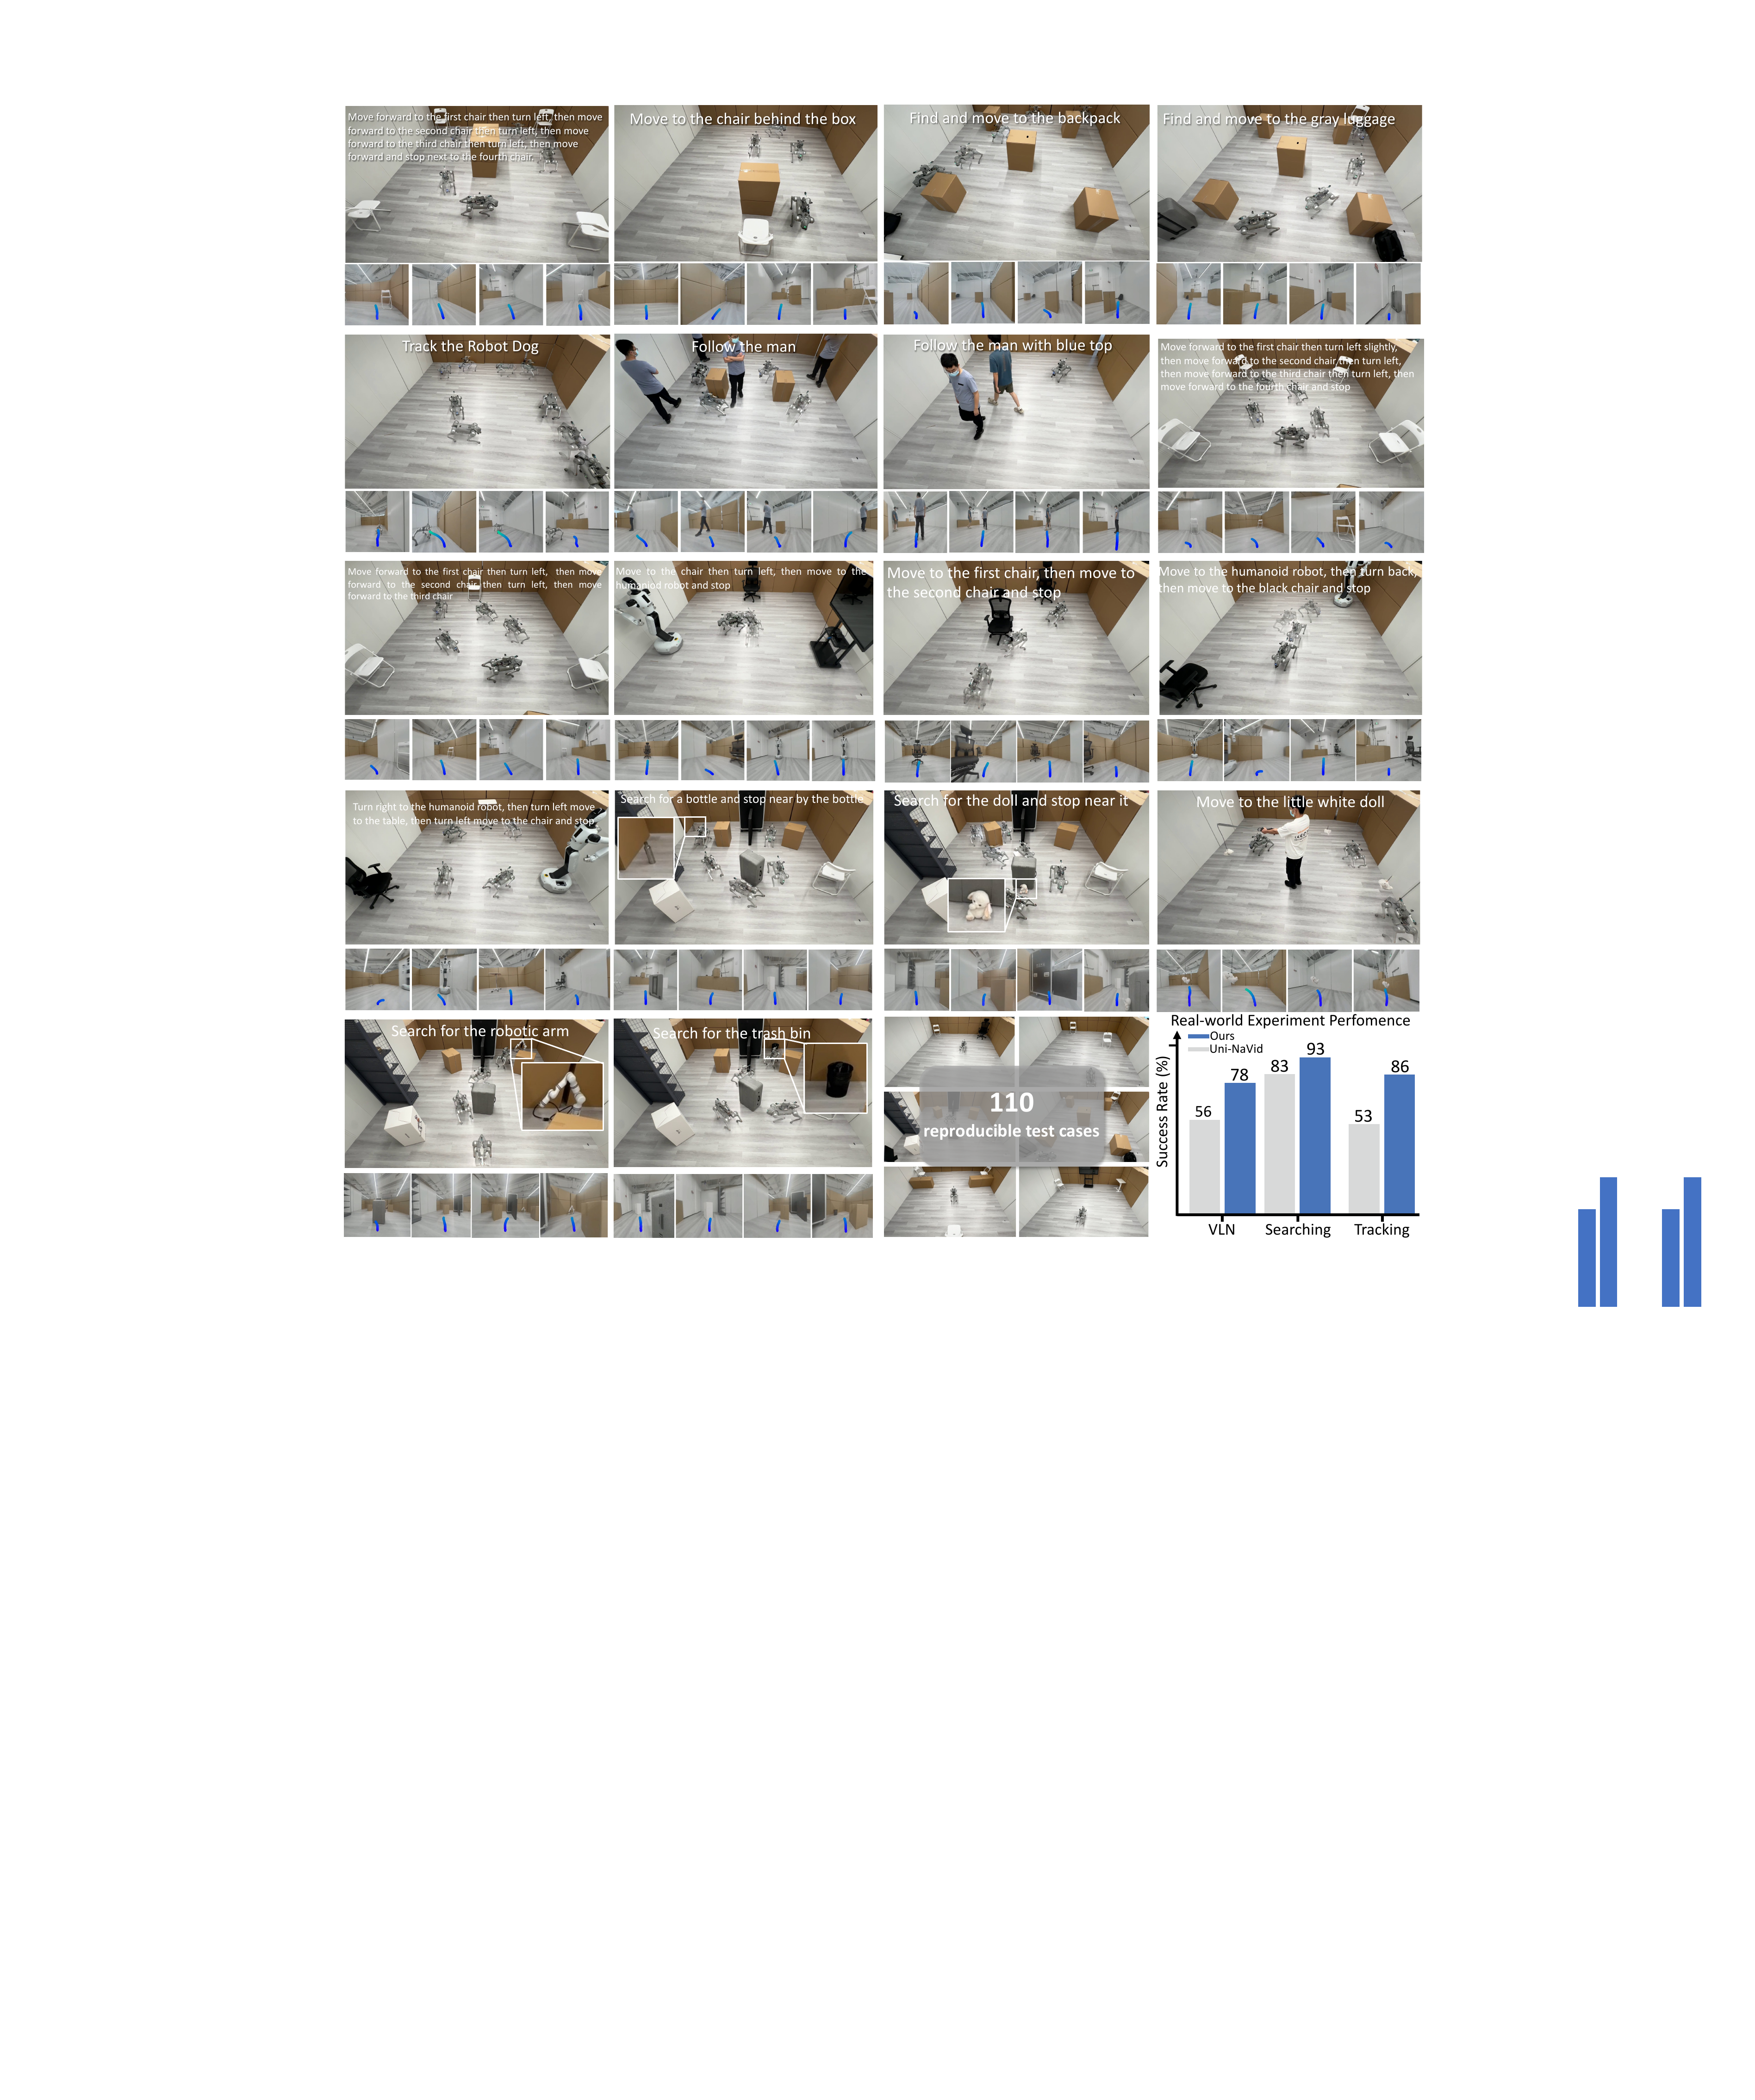
图 10:真实世界实验。报告 NavFoM 在不同导航能力与复杂场景中的定性、定量结果。
110 个可复现测试案例。 为评估真实世界性能,作者设计了 50 个 VLN、30 个搜索和 30 个跟踪案例。在一个 \(5\text{m}\times5\text{m}\) 空间中,记录每个案例的机器人、障碍物和目标位置。定性与定量结果表明,NavFoM 能理解周围环境并规划适当轨迹完成任务;与强基线 Uni-NaVid [zhang2024uni] 相比,在不同任务上均有显著提升。
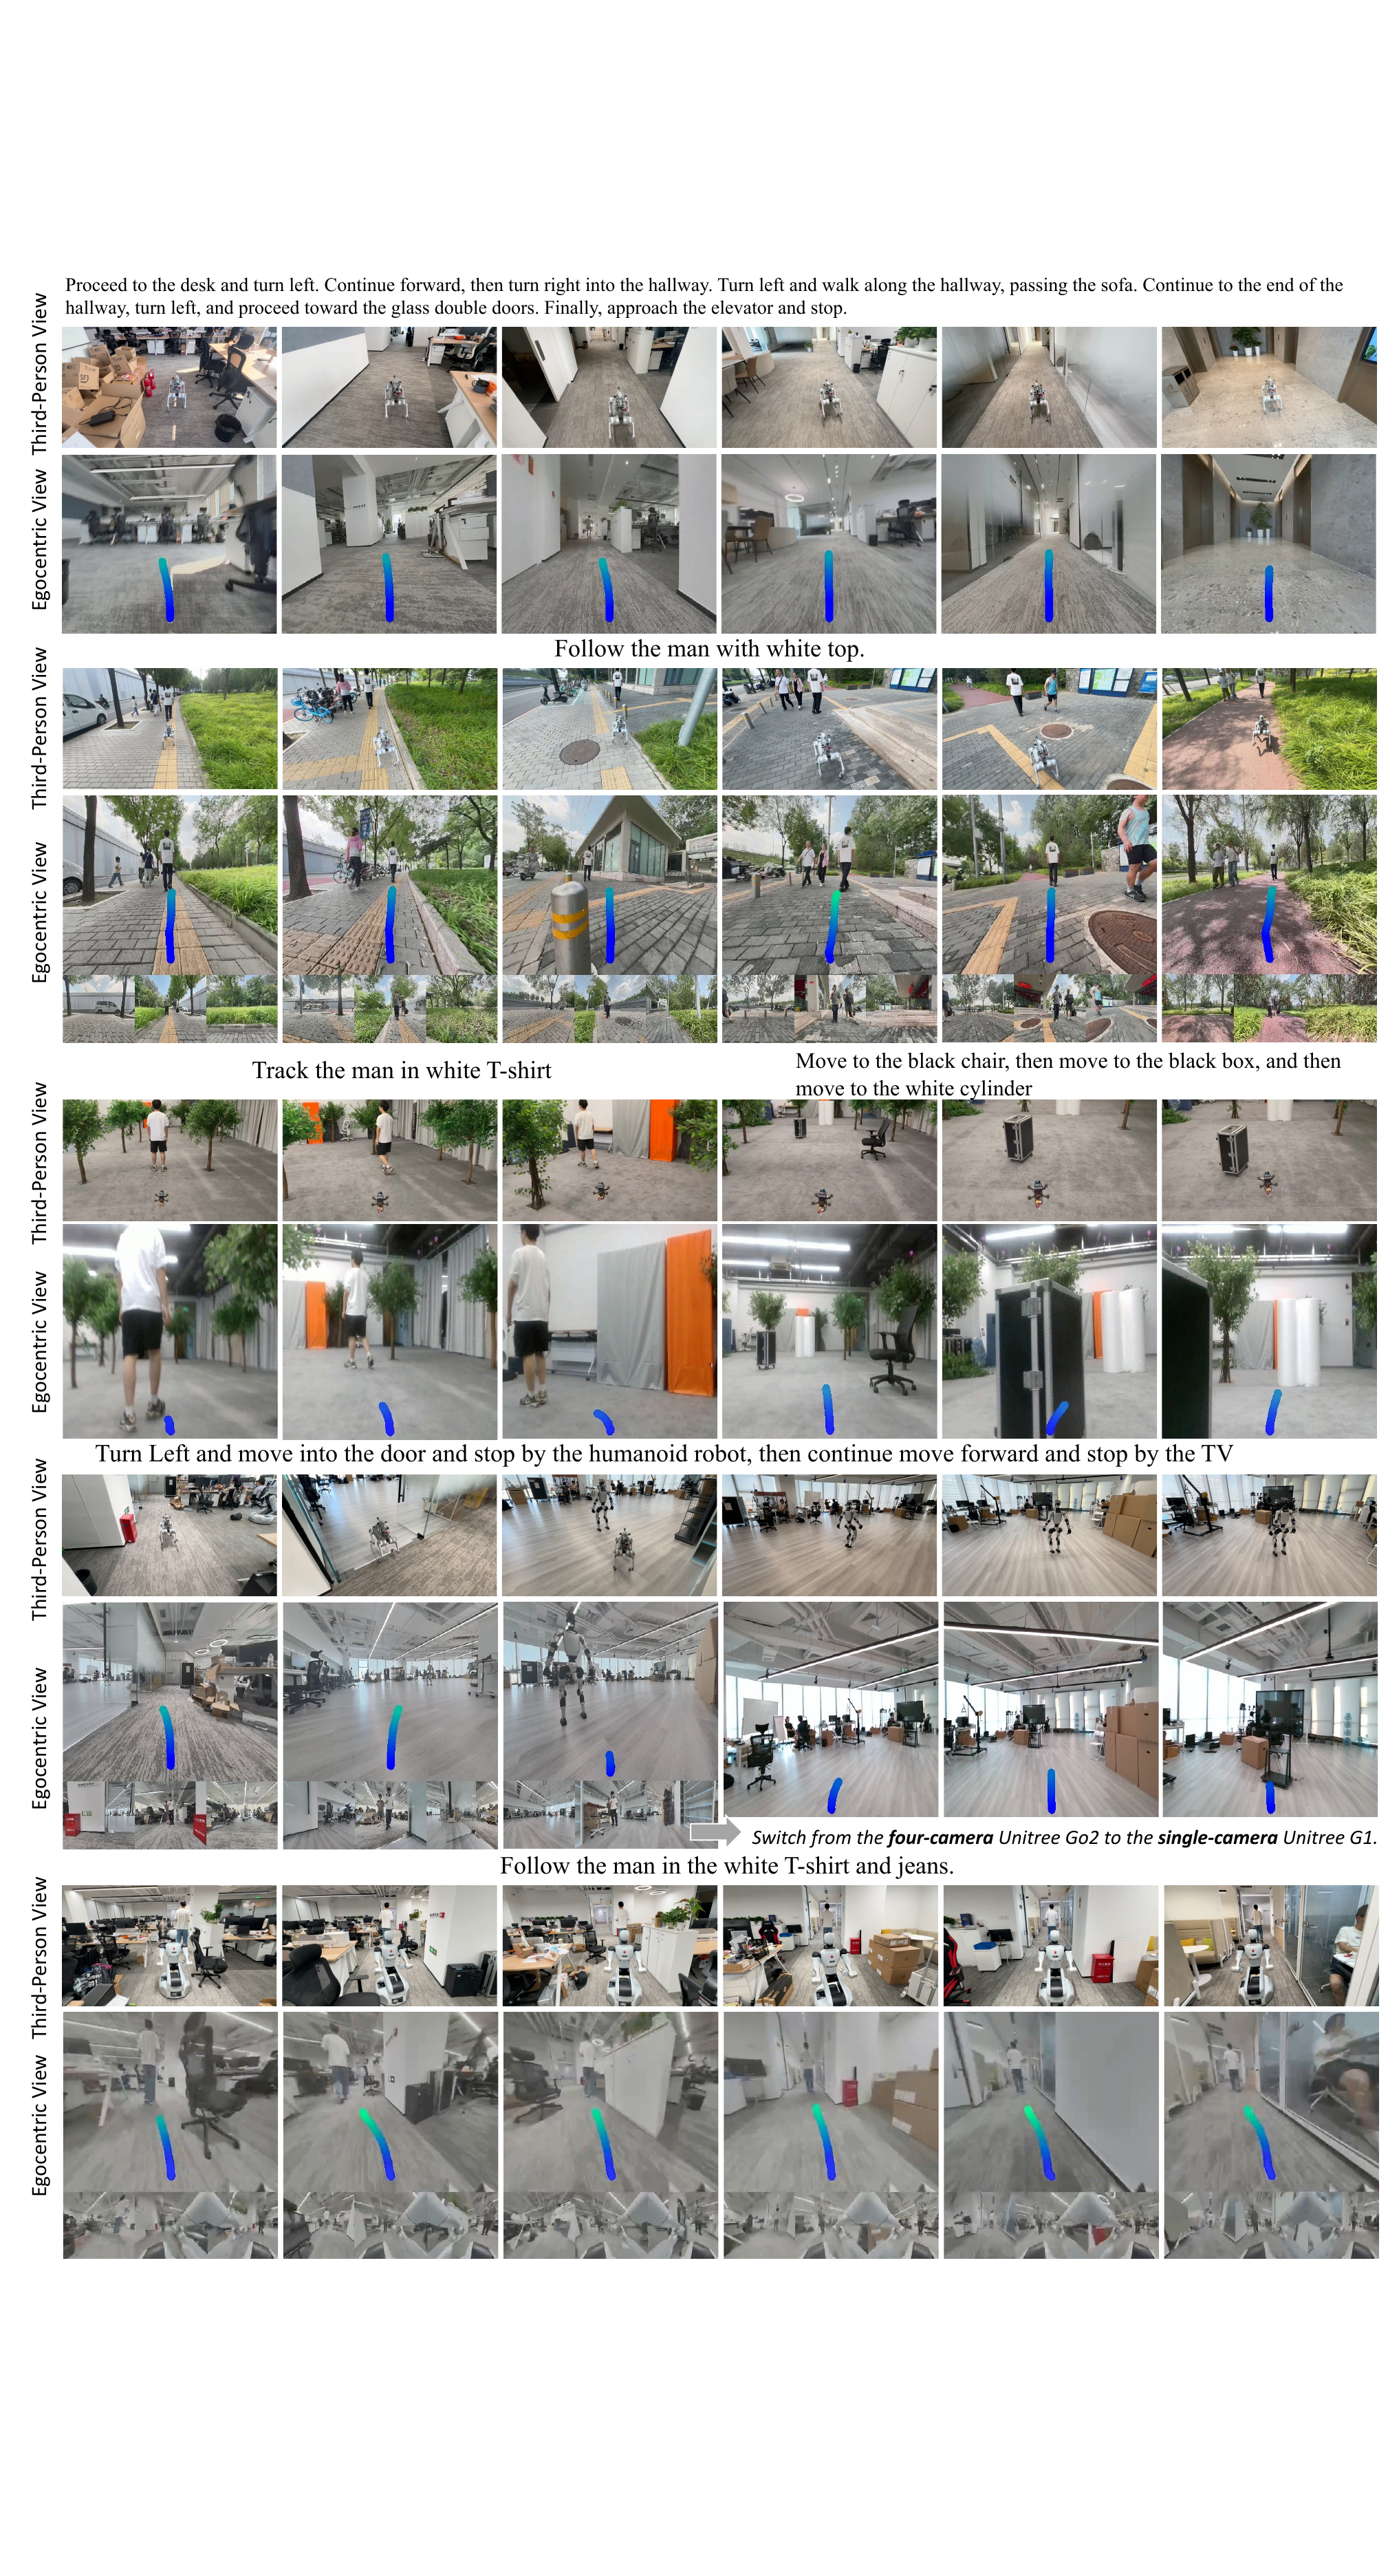
图 11:跨任务、跨具身真实世界实验的可视化结果。
具有挑战性的跨任务、跨具身实验。 进一步在四足机器人、人形机器人、无人机和轮式机器人上开展实验。结果表明,本方法能应对复杂真实环境并完成长时指令;配套视频提供了更直观的展示。
4.4 消融实验
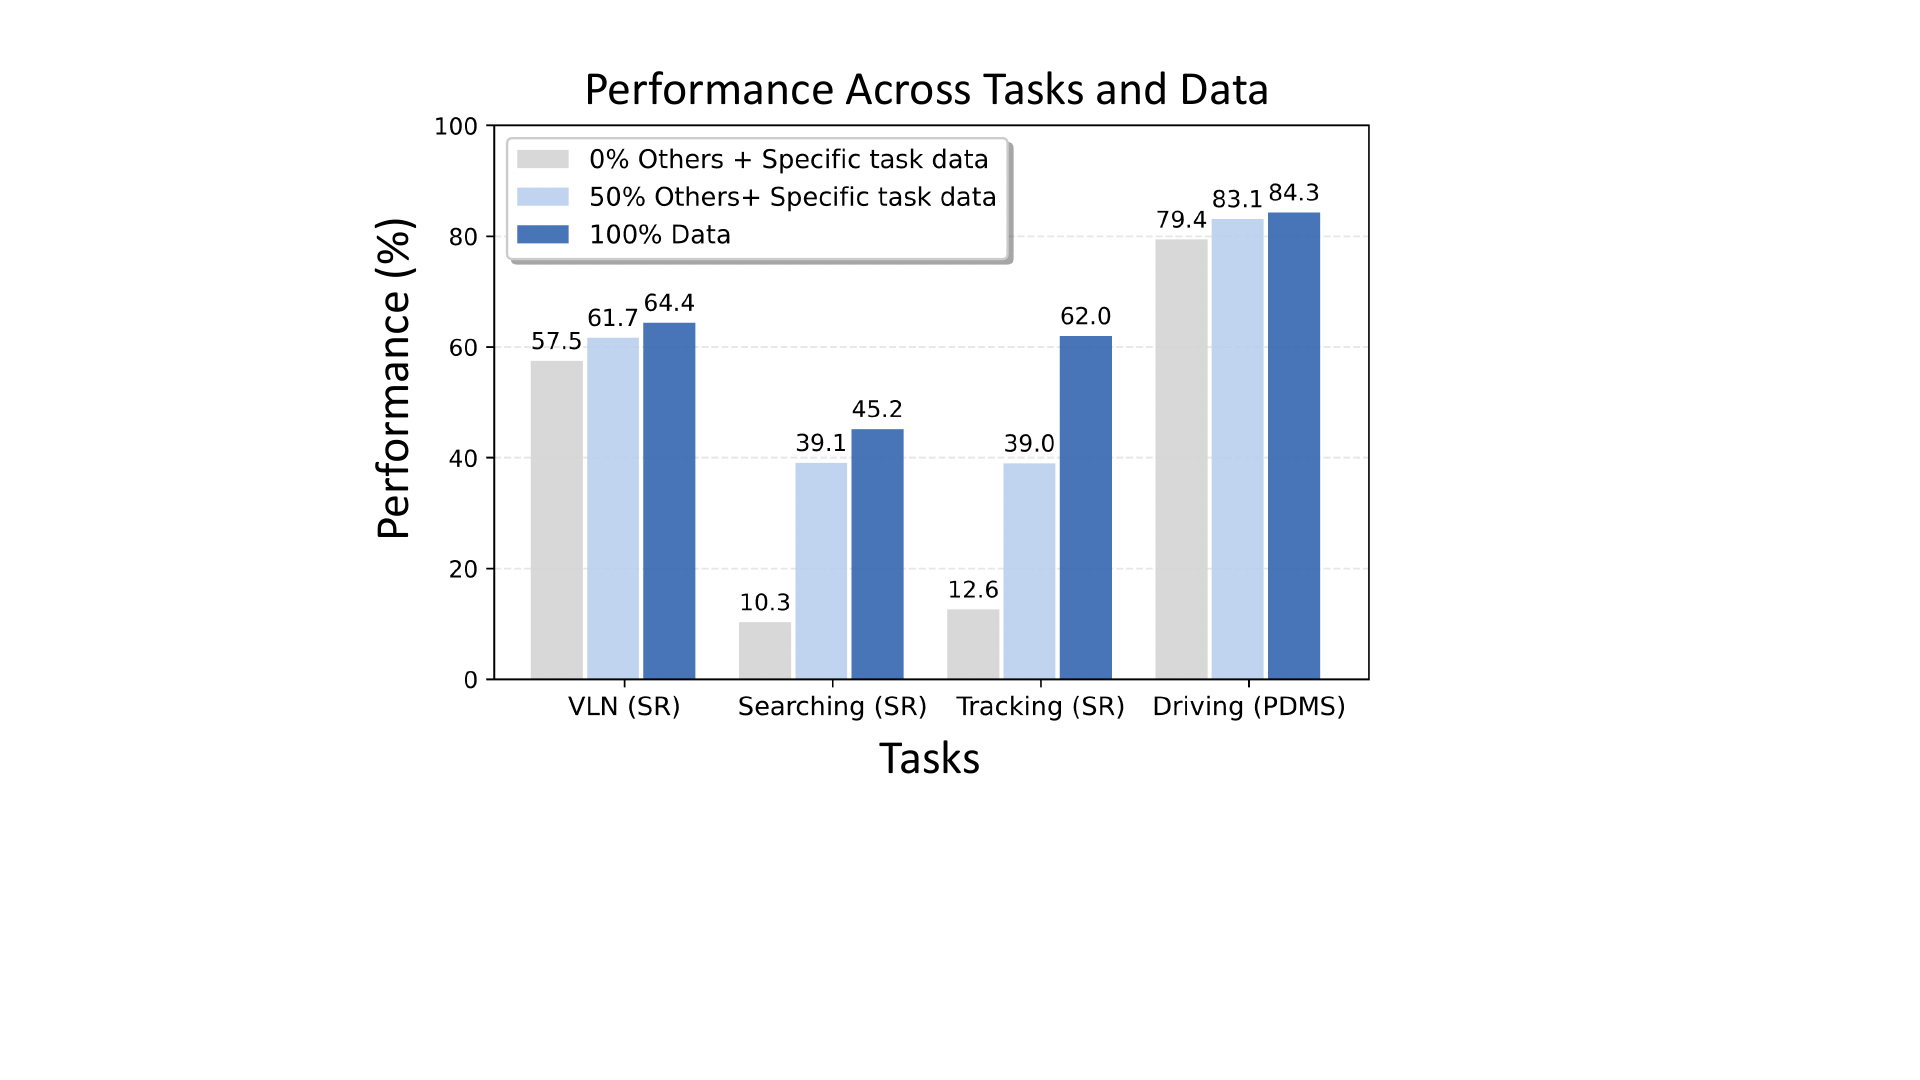
图 12:多导航任务联合训练的消融。比较仅使用特定任务数据、加入 50% 其他任务数据、加入 100% 其他任务数据;搜索任务为零样本测试。
多导航任务训练的协同效应。 将单任务训练与额外加入其他导航任务数据(50% 和 100%)的联合微调比较。“VLN”对应 VLN-CE RxR 四视角,“Searching”对应 OVON 四视角零样本,“Tracking”对应 EVT-Bench 四视角,“Driving”对应 NAVSIM 八视角。随着其他任务数据比例从 50% 增至 100%,所有任务性能都持续提升;搜索从 \(10.3\%\) 增至 \(45.2\%\),跟踪从 \(12.6\%\) 增至 \(62.0\%\),增益最显著。搜索与跟踪训练数据主要为单视角、封闭类别,而评估是多视角、开放词汇;其他任务提供的多视角与多样目标数据改善了开放集泛化,说明多任务训练能缓解对任务特定导航模式的过拟合。
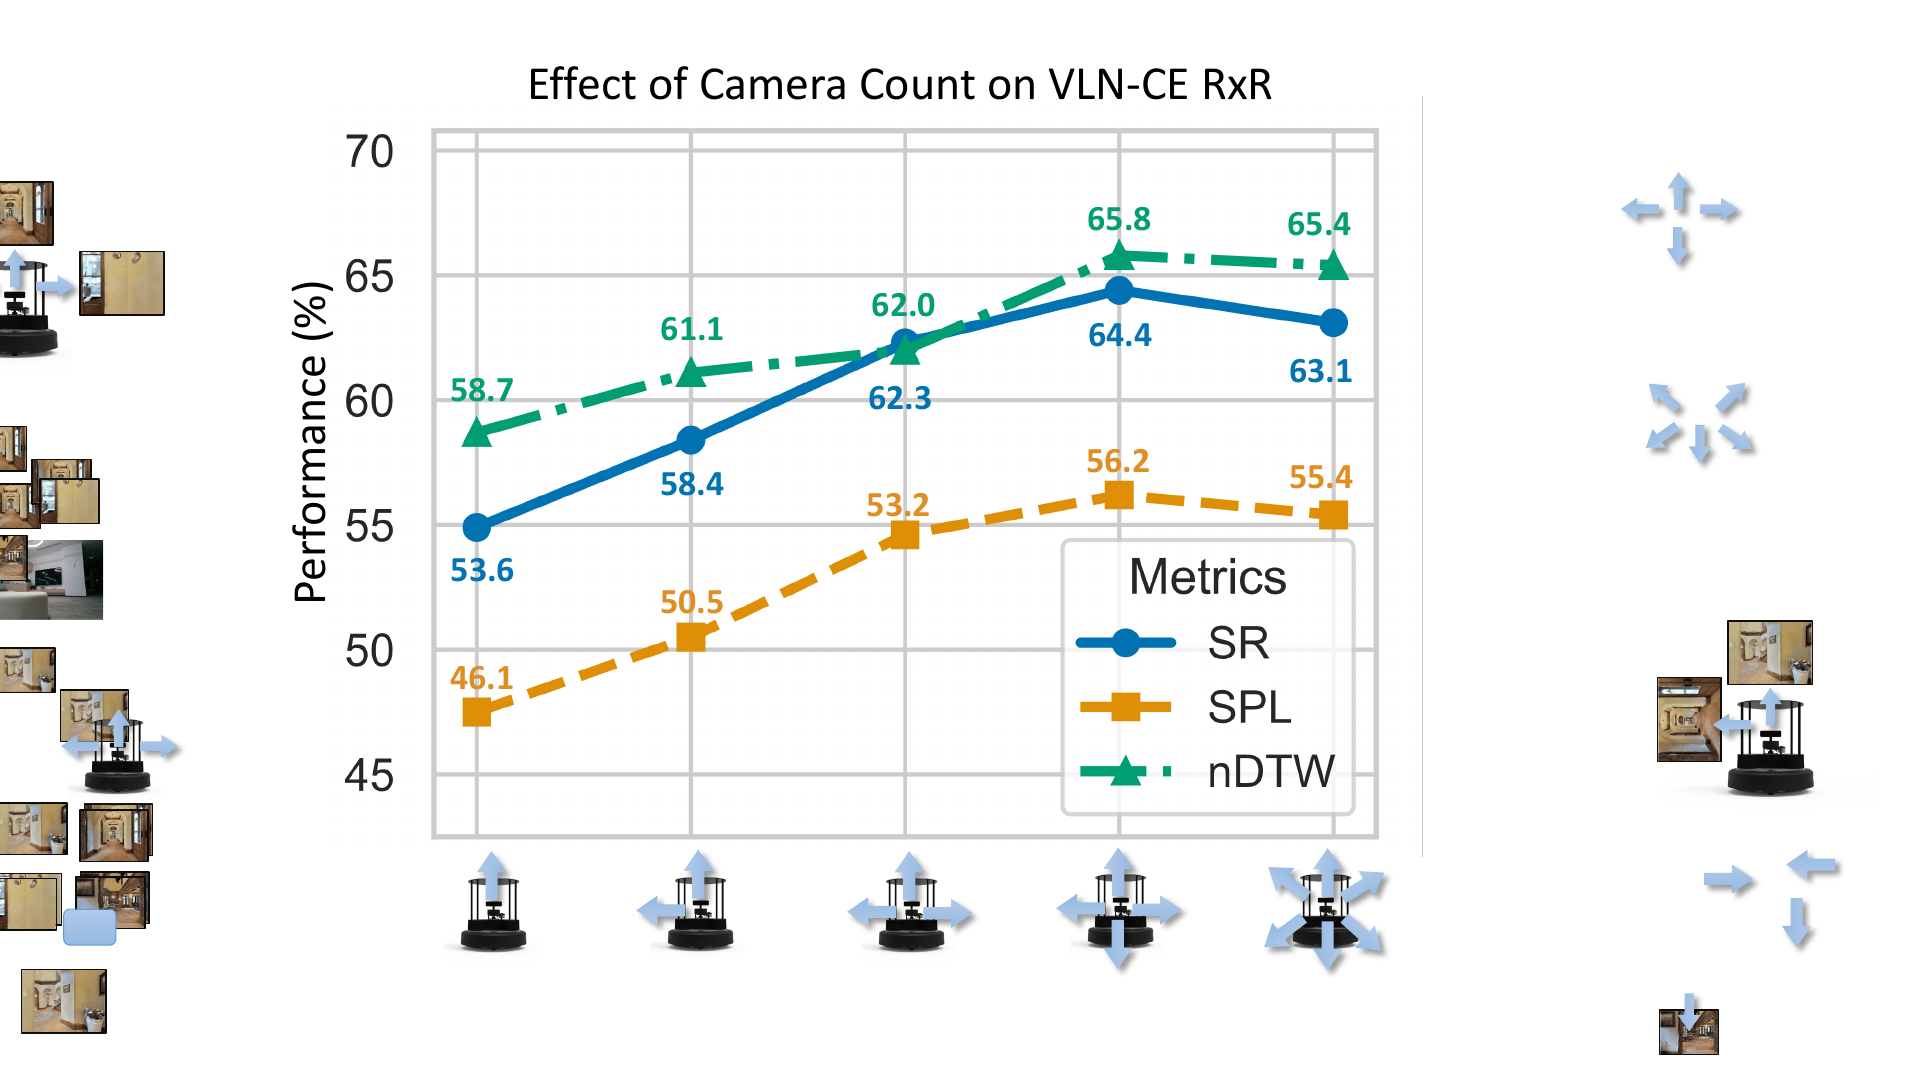
图 13:VLN-CE RxR 上相机数量消融。在相同词元预算 \(B=2048\) 下比较 1、2、3、4 和 6 个相机。
不同相机数量的性能。 在 VLN-CE RxR 上,随着相机数从 1 增至 4,性能持续提高,说明更完整的环境观测有利于导航。然而,增至 6 个相机时性能略降。六相机相较四相机未提供明显更多覆盖,却使更多视角词元挤占固定预算,历史帧容量下降,削弱导航历史与指令的对齐。自适应多视角词元编码可能缓解这一问题,留待后续研究。
BATS 与 TVI 的有效性。 表 7 在 RxR 四相机设置下比较历史词元组织与时空身份建模。预算为 1024 或 2048 时,BATS 均优于其他策略。以直接衡量预测轨迹与真值轨迹对齐的 nDTW 为例,预算下降时 BATS 仅下降 \(1.4\%\),均匀采样下降 \(6.0\%\),线性概率采样下降 \(5.2\%\)。TVI 还明显优于独立学习的特殊词元、去掉 \(\mathcal P_{\mathrm{angle}/\mathrm{time}}\) 的手工词元,以及常用视点—历史位置嵌入 [chen2021hamt]。作者认为,直接向视觉词元添加嵌入会增加 LLM 表征学习难度;TVI 是融合视点和时间信息的有前景起点。
表 7:历史词元组织策略与身份词元消融。均匀和线性采样均从 2048 个基础词元中采样。
| 配置 | RxR NE↓ | SR↑ | SPL↑ | nDTW↑ |
|---|---|---|---|---|
| \(B=1024\),均匀采样 | 5.33 | 59.7 | 49.6 | 57.9 |
| \(B=1024\),线性概率采样 | 5.28 | 61.2 | 50.9 | 58.9 |
| \(B=1024\),BATS | 4.98 | 62.5 | 53.9 | 64.1 |
| \(B=2048\),词元合并 | 5.01 | 63.2 | 54.9 | 64.4 |
| \(B=2048\),均匀采样 | 4.90 | 62.4 | 54.0 | 63.9 |
| \(B=2048\),线性概率采样 | 4.89 | 63.0 | 54.6 | 64.8 |
| \(B=2048\),BATS | 4.74 | 64.4 | 56.2 | 65.8 |
| 视点—历史位置嵌入 | 6.27 | 52.3 | 46.3 | 58.7 |
| 独立学习的特殊词元 | 5.52 | 59.1 | 52.0 | 59.6 |
| 手工词元(无角度/时间投影器) | 6.06 | 53.6 | 46.1 | 58.0 |
| TVI 词元 | 4.74 | 64.4 | 56.2 | 65.8 |
5 讨论与结论
本文提出 NavFoM,旨在拓展导航能力边界,并探索从跨具身、跨任务导航数据中习得的智能。TVI 词元增强 LLM 对不同相机配置与导航时间跨度的理解,并支持导航和问答数据联合训练;BATS 则在多种相机配置与任务时长下统一控制词元预算,兼顾性能与效率。公共基准和真实环境实验表明,NavFoM 性能优异,采用更先进技术或更高质量数据后仍有较大提升潜力。
NavFoM 只是迈向导航基础模型的起点。作者希望本工作推动研究社区更加关注以智能为核心的导航,并催生新一代技术、数据集与基准。
参考文献
正文引用键与原论文一致。完整的 124 条参考文献保存在译文源文件 paper_cn/iclr2025_conference.bbl 中,并已完整编入中文 PDF;以下列出本文方法与实验中最关键的参考资料:
- Anderson et al. Vision-and-Language Navigation: Interpreting Visually-Grounded Navigation Instructions in Real Environments. CVPR, 2018.
[anderson2018vision] - Vaswani et al. Attention Is All You Need. NeurIPS, 2017.
[vaswani2017attention] - Liu et al. Visual Instruction Tuning. NeurIPS, 2023.
[liu2023llava] - Oquab et al. DINOv2: Learning Robust Visual Features without Supervision. TMLR, 2024.
[oquab2023dinov2] - Zhai et al. Sigmoid Loss for Language Image Pre-Training. ICCV, 2023.
[zhai2023siglip] - Zhang et al. NaVid: Video-based VLM Plans the Next Step for Vision-and-Language Navigation. RSS, 2024.
[zhang2024navid] - Zhang et al. Uni-NaVid: A Video-based Vision-Language-Action Model for Unifying Embodied Navigation Tasks. 2024.
[zhang2024uni] - Cheng et al. NaVILA: Legged Robot Vision-Language-Action Model for Navigation. 2024.
[cheng2024navila] - Wang et al. OpenUAV: A Large-Scale Benchmark for Vision-and-Language UAV Navigation. 2024.
[wang2024openuav] - Yokoyama et al. Open-Vocabulary Object Navigation with Embodied Foundation Models. 2024.
[yokoyama2024hm3d] - Wang et al. TrackVLA: Embodied Visual Tracking in the Wild. 2025.
[wang2025trackvla] - Brent. Algorithms for Minimization without Derivatives. 2013.
[brent2013algorithms]
附录 A:实现细节
A.1 动作规划模型
不同具身平台的轨迹尺度不同:室内机器人通常移动数米,汽车则可移动数十米。为统一尺度,将各具身平台预测轨迹的所有维度乘以缩放因子 \(\alpha_{\mathrm{task}}\),归一化到 \([-1,1]\)。缩放因子不是各维绝对最大值,而取第 99 百分位,以避免异常值影响。
表 A1:不同具身平台预测轨迹各维度的缩放因子。
| 具身平台 | \(x\) (m) | \(y\) (m) | \(z\) (m) | \(\theta\) (rad) |
|---|---|---|---|---|
| 室内机器人 | 1.0 | 0.433 | — | 2.09 |
| 无人机 | 7.93 | 3.19 | 7.85 | 1.04 |
| 汽车 | 50.8 | 14.9 | — | 1.52 |
A.2 BATS 使用细节
导航初期,视觉词元数量未超过预算 \(B\) 时保留全部词元;超过预算后,依据遗忘曲线使用 BATS 采样。实践中,针对给定预算 \(B\) 预计算 \(P(t,T)\) 以加速处理。若任务时间跨度极长(例如数千步,实际很少发生),即使采用最小概率 \(\epsilon\),视觉词元仍可能超出预算,此时直接删除最老帧。
A.3 导航数据准备
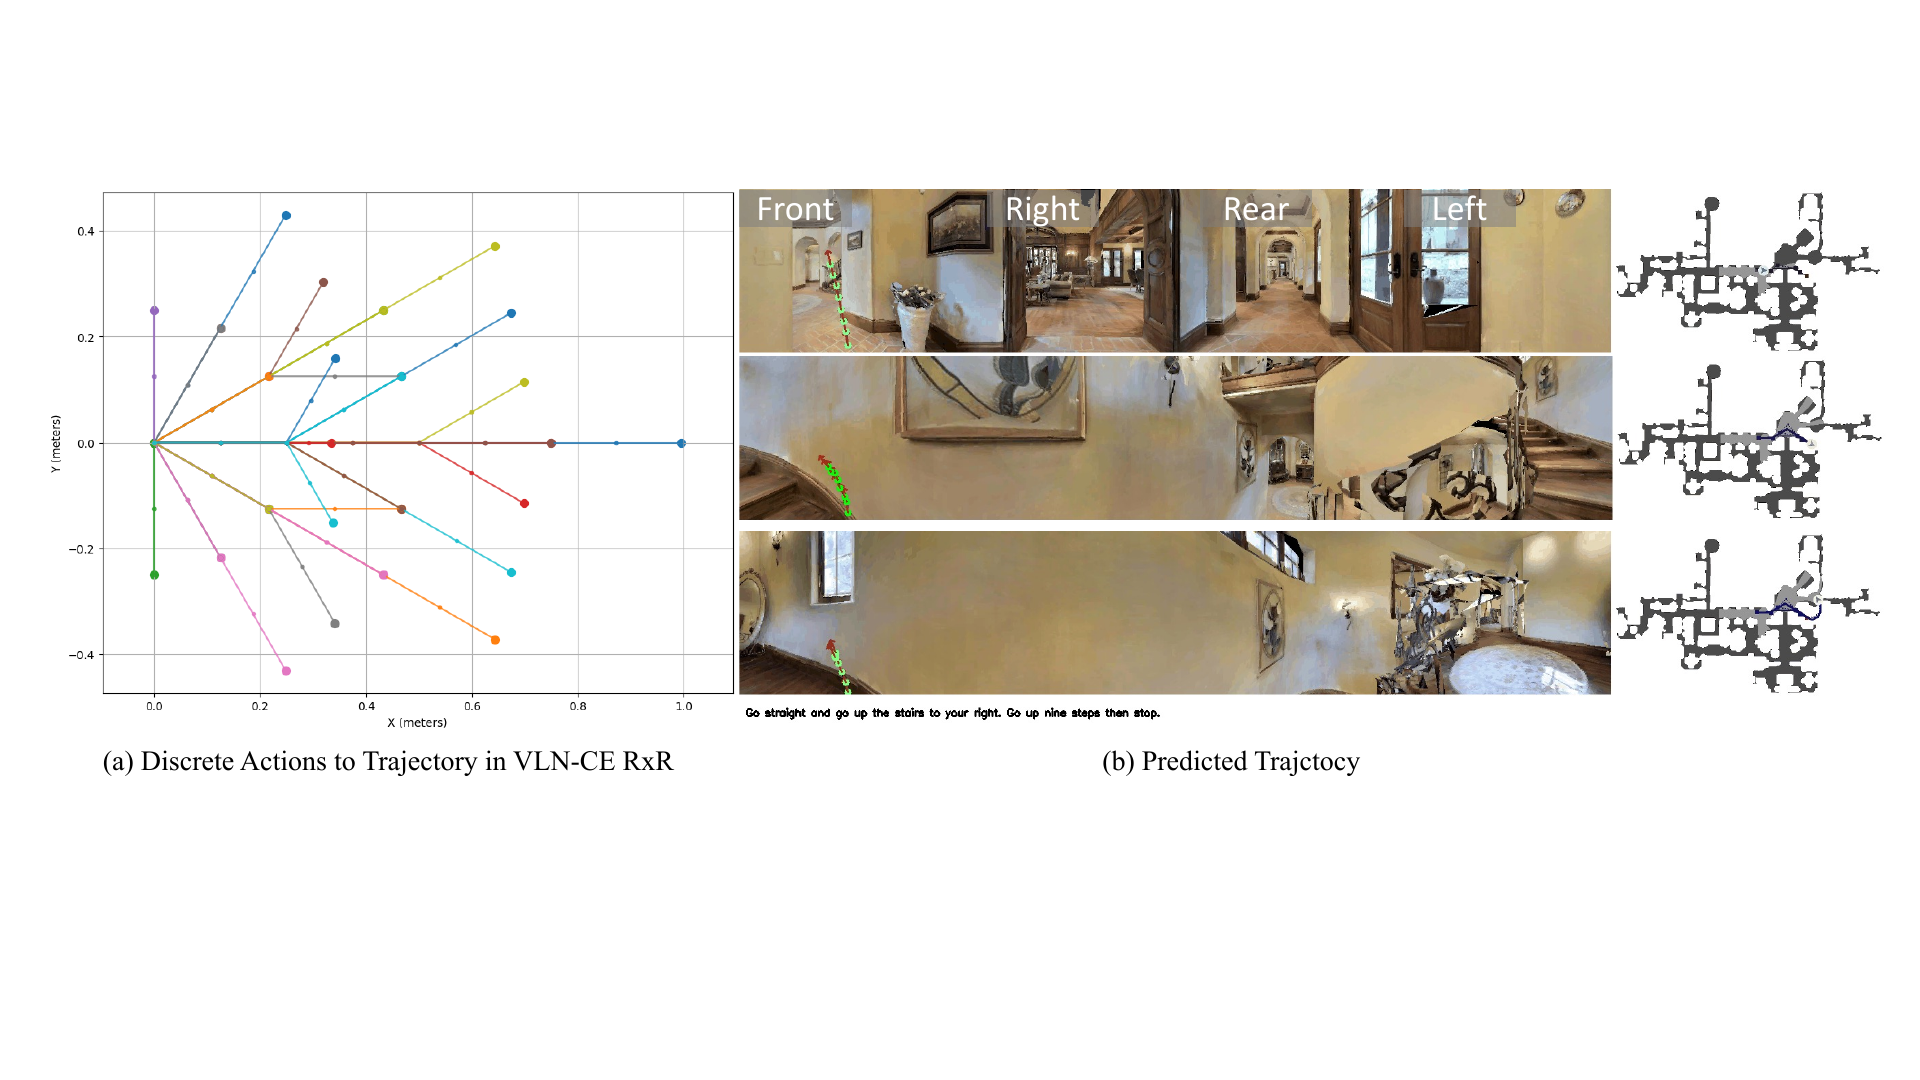
图 A1:VLN-CE RxR 中 (a) 训练与 (b) 评估所用轨迹的可视化。
Habitat 导航任务使用 Move_Forward、Turn_Left、Turn_Right 和 Stop 等底层离散动作,但不同任务的定义略有差异。例如,VLN-CE R2R 中 Turn_Left 表示转动 15 度,RxR 与 HM3D-ObjNav 中则表示 30 度。为统一这些任务,将前进 12.5 cm 或转动 15 度视为一次原子操作,再累积原子操作构造轨迹。训练轨迹可能呈锯齿状,但在所有导航数据集上微调后,预测轨迹平滑且方向明确。
A.4 真实世界部署系统
NavFoM 被视为通用视觉—语言—动作(Visual-Language-Action,VLA)模型,可驱动不同具身平台完成多种导航任务。模型接收一个或多个相机的视觉观测与指令,直接预测轨迹;随后使用各平台现成 API(必要时可包含激光雷达或其他传感器)驱动机器人沿预测轨迹行进。
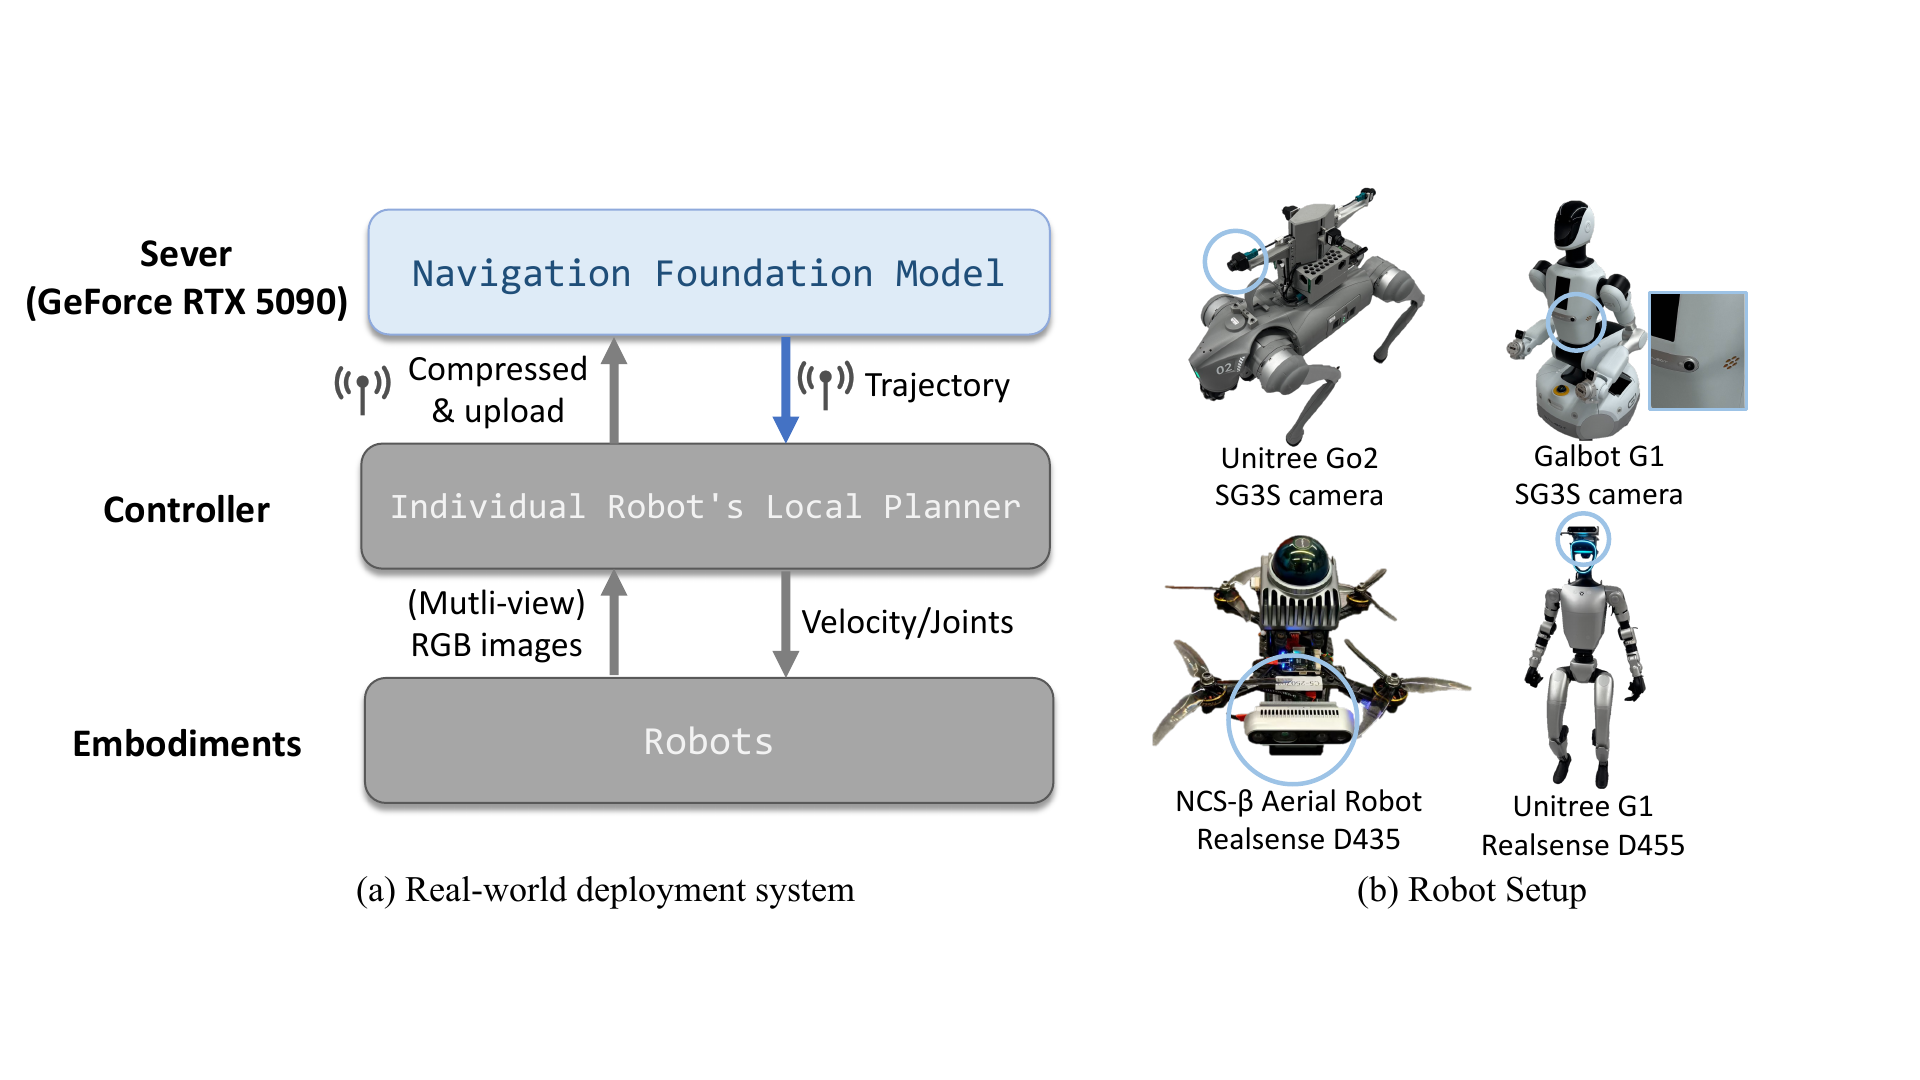
图 A2:真实世界部署系统架构及本文测试的机器人。
具体而言,模型部署在配备 GeForce RTX 5090 GPU 的远程服务器上,服务器与包含控制器和具身平台的客户端通过互联网通信。收到用户指令后,机器人压缩当前观测并上传;服务器处理观测与指令后输出轨迹;各机器人本地规划器再处理该轨迹,发送速度或关节控制等命令驱动机器人。
附录 B:补充实验
B.1 自动驾驶补充结果
表 6 给出了 nuScenes 自动驾驶结果。NavFoM 与专门为自动驾驶设计的强基线比较;尽管没有显式建模驾驶相关信息,仍取得了可比性能。