NaVIDA:基于逆动力学增强的视觉—语言导航
作者: Weiye Zhu、Zekai Zhang、Xiangchen Wang、Hewei Pan、Teng Wang、Tiantian Geng、Rongtao Xu、Feng Zheng
机构: 南方科技大学;穆罕默德·本·扎耶德人工智能大学;SpatialTemporal AI
摘要
视觉—语言导航(Vision-and-Language Navigation,VLN)要求智能体理解自然语言指令,并在视觉信息丰富的环境中采取连贯行动。然而,多数现有方法依赖反应式状态—动作映射,并未显式建模动作落地视觉动力学。由于不了解动作如何改变后续视觉观测,智能体难以合理规划行动,导致行为不稳定、泛化能力弱,并沿轨迹不断累积误差。 为解决这些问题,本文提出 NaVIDA(Navigation with Inverse Dynamics Augmentation),
这是一个轻量级 VLN 框架,将逆动力学监督(IDS)作为显式目标,把动作落地视觉动力学融入策略学习。通过在共享表征与动作空间中联合优化视觉动力学和指令条件动作预测,NaVIDA提供额外的结构化监督以正则化学习,使导航更加稳定、一致。 为组织这种监督并扩大有效规划范围,NaVIDA采用层次概率动作分块(HPAC),将轨迹组织为多步动作块,提供更具判别力的长程视觉变化线索。 大量实验表明,相较于最先进方法,NaVIDA以更少参数(3B 对 8B)取得了更优的导航性能。 真实世界机器人评测进一步验证了本文方法的实际可行性与有效性。代码见 https://github.com/waynechu1021/NAVIDA。
关键词: 视觉—语言导航 、 逆动力学
引言
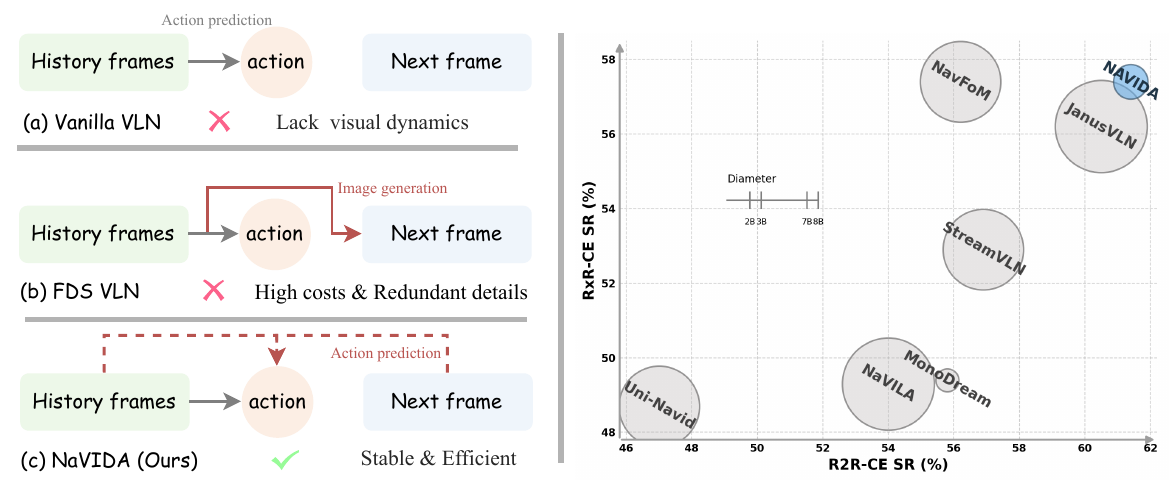
图:左图:三种 VLN 范式的对比。(a) 基础 VLN 依赖反应式状态—动作映射,缺乏动作落地视觉动力学;(b) 前向动力学建模(FDM)增加了预测未来观测的图像生成任务,但计算开销大且容易受到无关细节干扰;(c) NaVIDA仅通过动作预测,利用逆动力学监督学习动作落地视觉动力学,使训练更高效、稳定。右图:成功率与模型规模的对比。蓝色的 NaVIDA以更小模型取得更优性能。每个圆的直径与模型参数量(十亿参数)成正比。
视觉—语言导航(VLN)[r2r; vlnce; vlnpe]是一项具有挑战性的多模态序列决策任务,要求智能体仅根据自然语言指令在三维视觉环境中有效导航。 因此,有效的 VLN 不仅需要准确理解指令,还需要长时域建模能力,以及对视觉多样的未见场景具备稳健泛化能力。 受视频多模态大语言模型(MLLM)[qwen2_5; nvila; llava-video]进展的推动,近期研究[navid; uni-navid; navila; streamvln; monodream; zhang2025activevln]将这类模型引入 VLN,以利用其视觉感知、语义理解与跨场景泛化能力。
许多现有工作[navid; uni-navid; navila]通常将 VLN 建模为短视的状态到动作策略。如[fig:teaser]左图 (a) 所示,这种“基础 VLN”范式直接将当前语言指令和历史视觉观测映射为有限的后续动作。然而,这种反应式建模并未显式刻画动作落地视觉动力学: 当前视觉观测如何在动作影响下转变为下一视觉观测。 智能体若未内化这种视觉动力学,就只能学习指令与观测之间的浅层相关性,无法预判所执行动作带来的视觉后果。导航过程因而极易受到微小感知偏差影响;这些偏差在长时域中不断累积,最终造成提前停止或无法纠正的轨迹漂移等严重不稳定现象。 为缓解该问题,近期研究[monodream; zhang2025cross; huang2025vista]探索了前向动力学建模(FDM,如[fig:teaser]b 所示),迫使智能体预测未来视觉观测。FDM 虽将环境动力学显式纳入策略学习,但资源开销很大。生成高维未来帧通常需要复杂的辅助模块(例如基于扩散的世界模型[chi2025diffusion; cai2025navdp]),并带来显著计算负担[wang2023dreamwalker; zhang2025cross]。更关键的是,FDM 存在内在的目标错位:重建稠密的像素级未来帧会迫使模型关注与导航完全无关的冗余外观细节(例如光照或纹理),而非优化结构化动作空间。
鉴于有效导航无须预测未来的每个像素,本文提出 NaVIDA([fig:teaser]左图 c):一个将逆动力学监督(IDS)作为辅助目标的 VLN 框架,由此把动作落地视觉动力学引入策略训练。IDS 不再仅依赖指令—动作相关性,而是训练模型根据视觉转变推断动作,促使预测动作与其引起的可观测状态变化保持一致。这种动作落地监督可提供稠密且与语言无关的训练信号。通过在共享特征与动作空间中联合对齐 IDS 和基于指令的动作预测,NaVIDA能够学习刻画动作如何驱动环境转变的视觉运动表征,且无须稠密图像预测或访问未来帧。
为更好地组织这种监督并延长有效规划时域,本文提出层次概率动作分块(HPAC)机制,逐步将低层动作合并为多层动作块。这种分层随机合并策略将短暂的微动作压缩为信息更丰富的训练目标,为逆动力学学习提供更丰富、更具判别力的信号。HPAC 在动作块边界中引入受控随机性,避免过于僵化的压缩,在保留分段多样性的同时增强对轻微执行变化的鲁棒性。智能体由此能够在更长时间跨度上推理,并保持稳定、一致的导航行为。 大量实验验证了 NaVIDA的有效性:它以显著更少的参数在 VLN-CE[vlnce]基准上取得了最先进(State-of-the-Art,SOTA)性能(直观对比见[fig:teaser]右图),为 VLN 研究确立了一种简洁轻量的范式。
本文的主要贡献如下: - 本文提出 NaVIDA,一个利用逆动力学监督(IDS)所驱动的动作落地视觉动力学来增强策略学习的 VLN 框架。通过在共享特征与动作空间中对齐这两个目标,NaVIDA实现了更稳定、一致的导航。 - 本文提出层次概率动作分块(HPAC)机制,在时间维度上将智能体轨迹组织为变长语义单元。这一设计提高了对轻微执行变化的鲁棒性,并为逆动力学目标提供更丰富的视觉转变线索,有效延长规划时域。 - 全面实验表明,NaVIDA以更少参数取得了 SOTA 性能。真实世界测试验证了其可行性与鲁棒性,以及更快、更高效的执行能力,体现了联合动作理解方法在物理环境中的实际优势。
相关工作
视觉—语言导航。 VLN 任务要求具身智能体根据自然语言指令进行感知、推理与行动。 早期研究[hong2021vln; chen2021history; liu2023bird]关注以全景 RGB-D 为输入、在连通图上进行的离散导航。这些方法虽在域内取得了较好结果,却依赖笨重传感器和预扫描视点。 后续工作[wu2020towards; vlnce]转向连续控制和低层动作预测,以更贴近真实世界部署;另有多项研究[hong2022bridging; wang2023gridmm; an2022bevbert; nguyen2019vision; wang2022towards; schumann2024velma]探索了单目 RGB 或 RGB-D 变体,降低对全景感知的依赖。 随着 MLLM 兴起,仅使用单目视觉的 VLN 系统开始利用视觉—语言骨干网络增强跨场景迁移能力并降低硬件成本[navid; uni-navid; navila; streamvln]。尽管取得这些进展,多数现有 VLN 方法仍局限于反应式状态—动作映射,忽视了对已执行动作与后续视觉转变关系的显式建模。缺乏这种动作理解能力时,智能体难以预判短时域观测动力学,往往出现转向不稳定、提前停止,以及误差在长轨迹上持续累积等问题。 与之不同,NaVIDA在策略学习中引入逆动力学监督,将其作为状态转变目标。通过在共享特征与动作空间中将该目标与基于指令的动作预测对齐,本文方法提升了单目感知下的执行稳定性。
导航中的动力学模型。 反应式状态—动作建模将历史视觉观测和自然语言指令直接映射到动作空间,并未显式刻画视觉转变与所执行动作之间的依赖关系。为缓解这一问题,早期工作[mpmvln; vlnpredictfutureview; idmpretraininvln]探索了路径掩码预测、图像预测或图像补全等额外预训练任务。然而,这些方法大多局限于离散环境,并经常依赖扩展的上下文线索或语言指令。近期方法[monodream; zhang2025cross; huang2025vista]尝试结合前向动力学建模并分解决策任务,在预测动作的同时预测未来图像,从而建模状态转变。 前向模型虽然在部分设置下有效,却通常需要额外模块完成高维预测,增加计算量与内存开销,还可能使学习偏向与决策空间关联较弱的冗余外观细节。 NaVIDA则在连续环境中采用逆动力学:模型从两幅相邻图像直接推断引起该转变的动作,与反应式策略共享输出空间,无须额外生成器或解码器。这一设计降低了从图像空间映射到动作空间的优化难度,提高数据效率,并注入动作落地的转变先验约束以强化指令落地,从而实现稳定的长时域导航。
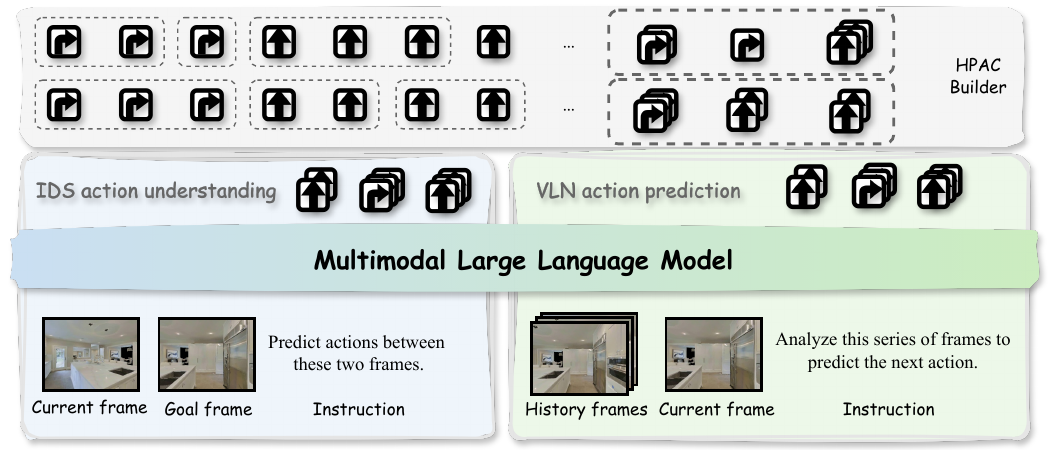
图:NaVIDA概览。多模态语言模型骨干网络生成 HPAC 动作块。HPAC 机制将相邻动作随机合并为变长运动单元,在保留动作块多样性的同时增强对轻微执行变化的鲁棒性。导航动作预测与逆动力学监督(IDS)联合优化,从而在共享表征与动作空间中实现动作落地视觉动力学建模,并增强动作理解能力。
NaVIDA 框架
预备知识
任务定义。
连续环境中的视觉—语言导航任务定义如下。在每个导航回合开始时,智能体收到自然语言指令 \(\mathcal{I}\)。随后,在每个时间步 \(t\),智能体接收第一人称 RGB 观测 \(v_t\);观测历史记为 \(\mathcal{V}_{0:t}=\{v_0,\ldots,v_t\}\)。 导航智能体的离散动作空间为:
$ \mathcal{A}={Forward,\ TurnLeft,\ TurnRight,\ Stop}, $
选择动作 \(a_t\in\mathcal{A}\) 后,环境转移至新状态并产生下一观测 \(v_{t+1}\)。 当智能体发出 Stop 或达到最大步数预算 \(T_{\max}\) 时,回合终止。 若智能体在距目标位置 3 米以内执行停止动作,则视为该回合成功。
框架概述。
NaVIDA基于标准视觉—语言模型(Vision–Language Model,VLM)骨干网络构建,该骨干包含视觉编码器、视觉—语言投影器和 LLM 头([fig:arch])。NaVIDA在共享特征与动作空间中联合建模基于指令的动作预测和动作落地视觉动力学。 为提供结构化且具有判别力的监督信号,NaVIDA首先引入层次概率动作分块(HPAC),将时间相邻动作组织为多层动作块,并捕获更长程的视觉转变模式。在这种层次结构之上,本文将逆动力学监督(IDS)作为辅助目标,训练模型从视觉转变中推断动作;相较于简单的指令—动作相关性,这能增强动作理解和视觉—动作对齐。 通过联合优化动作预测与 IDS,NaVIDA在单目感知下实现了更稳定、一致的导航。
算法:层次概率动作分块
\begin{algorithm}[h]
\caption{层次概率动作分块}

\begin{algorithmic}[1]
\REQUIRE 原子动作 $\mathcal{A} = [a_1, \dots, a_N]$,合并概率 $p$,第二层最大动作块大小 $n$
\ENSURE 层次合并后的序列 $\mathcal{A}^{(2)}$

\COMMENT{**第一层:概率合并**}
\STATE $\mathcal{A}^{(1)} \leftarrow [ ]$, $c \leftarrow [a_1]$
\FOR{$i = 2$ 到 $N$}
\IF{$a_i = a_{i-1}$ 且 $\text{len}(c) < 3$ 且 $\mathcal{U}(0,1) \le p$}
\STATE 将 $a_i$ 追加至 $c$
\ELSE
\STATE 将 $c$ 追加至 $\mathcal{A}^{(1)}$;$c \leftarrow [a_i]$
\ENDIF
\ENDFOR
\STATE 将 $c$ 追加至 $\mathcal{A}^{(1)}$

\COMMENT{**第二层:确定性合并**}
\STATE $\mathcal{A}^{(2)} \leftarrow [ ]$, $c' \leftarrow [\mathcal{A}^{(1)}_1]$
\FOR{$i = 2$ 到 $|\mathcal{A}^{(1)}|$}
\IF{$\text{len}(c') < n$}
\STATE 将 $\mathcal{A}^{(1)}_i$ 追加至 $c'$
\ELSE
\STATE 将 $c'$ 追加至 $\mathcal{A}^{(2)}$;$c' \leftarrow [\mathcal{A}^{(1)}_i]$
\ENDIF
\ENDFOR
\STATE 将 $c'$ 追加至 $\mathcal{A}^{(2)}$

\RETURN $\mathcal{A}^{(2)}$
\end{algorithmic}
\end{algorithm}
层次概率动作分块
NaVIDA不再预测固定且少量的后续动作,而是用变长动作块表示控制序列,以便 (a) 放大动作为逆动力学监督带来的视觉变化;(b) 在置信度较高时支持更远期的解码,同时保持输出与 VLN 动作空间一致。 本文采用 HPAC 机制分两阶段合并原子动作。在第一阶段的概率合并中,以概率 \(p\) 将最多 \(3\) 个时间相邻、视觉转变一致且重复的同一原子动作合并为子动作块。该随机合并策略压缩微动作并缓解标签噪声,同时避免贪心方案造成僵化且可能过度的压缩。通过在动作块边界中引入受控随机性,它保留动作分段的多样性,并提高对轻微执行波动的鲁棒性。在第二阶段的确定性合并中,将最多 \(n\) 个连续子动作块合并为最终动作块,由此得到覆盖 \(n\) 至 \(3n\) 个原子动作的序列。所得语法既保留细粒度短程决策,又允许在置信度较高时解码更远期动作;同时放大动作引起的外观与视点变化,产生更具判别力的监督信号。完整流程见算法[alg:chunking]。该动作块表征用作训练目标,为 IDS 和导航动作预测提供统一标签空间。
逆动力学监督
为在不修改架构的情况下建模动作落地视觉动力学,本文在数据层面引入逆动力学监督(IDS)。给定一对由 HPAC 生成的帧 \((v_t, v_{t+\ell})\),模型需要使用与 VLN 相同的动作语法(即动作类型词元和数值词元),预测二者之间变长动作块 \(\mathbf{y}_t=(y_{t,1},\ldots,y_{t,n_t})\) 的词元序列。在这种定义下,IDS 是显式的动作理解目标,促使模型以结构化动作表征解释视觉转变;VLN 则仍是指令条件动作预测任务。两个目标共享特征与动作空间,因而相辅相成:IDS 利用视觉证据增强落地的动作理解,VLN 则利用这种表征进行语言引导决策。 帧对与动作块层面的监督聚合多个微动作,产生更大的视差和外观变化,从而在视觉歧义场景(例如对称结构或短暂遮挡)中提供更具判别力的学习信号。遵循 StreamVLN[streamvln]和 JanusVLN[janusvln],本文使用 R2R[r2r]、RxR[rxr]、ScaleVLN[wang2023scaling]和 DAgger[dagger]在 Habitat[habitat]中的轨迹构建监督数据。对于每条轨迹,先用 HPAC 定义航路点,再由相邻航路点确定互不重叠的子序列,其中起始帧存为当前视图、结束帧存为目标视图,二者之间的动作块作为监督标签。该过程生成约 \(2.4\)M 个 IDS 三元组,以及约 \(\sim\!2.8\)M 个采用相同动作语法构建的分块 VLN 样本。
训练期间,共享参数并使用任务特定提示词联合优化 IDS 与 VLN 目标。对于 IDS,模型在与任务无关的提示词 \(\mathcal{I}_{\mathrm{IDS}}\) 下,根据 \((v_t, v_{t+\ell})\) 预测 \(\mathbf{y}_t\):
$$
\mathcal{L}{\mathrm{IDS}}^{\tau}=-\sum{t}\sum_{j=1}^{n_t}\log p!\left(y_{t,j}^{\star}\,\middle|\, y_{t,<j}^{\star},\, \mathcal{I}{\mathrm{IDS}},\, v_t,\, v{t+\ell}\right),
$$
对于 VLN,模型根据视觉历史和指令预测下一个动作块:
$$
\mathcal{L}{\mathrm{VLN}}^{\tau}=-\sum{t}\sum_{j=1}^{n_t}\log p!\left(y_{t,j}^{\star}\,\middle|\, y_{t,<j}^{\star},\, \mathcal{I}{\mathrm{NAV}},\, v{<t}\right).
$$
联合目标 \(\mathcal{L}=\sum_{\tau\in D}\big(\mathcal{L}_{\mathrm{VLN}}^{\tau}+\mathcal{L}_{\mathrm{IDS}}^{\tau}\big)\) 鼓励动作落地视觉动力学与指令条件动作预测保持一致,从而正则化共享表征。它将根据观测转变推断的动作与语言引导下解码的动作对齐,在保留原始 VLN 动作空间的同时,无须预测高维未来视觉外观。
表:在 VLN-CE R2R Val-Unseen 划分上与当前最优方法的比较。 所用观测包括全景视图(Pano.)、里程计(Odo.)、 深度传感器(Depth)和单目 RGB 相机(S.RGB)。 所有结果均引自相应论文。 \(*\)表示使用航点预测器的方法。 最优结果以粗体标出, 次优结果以下划线标出。
\begin{table*}[ht]
\caption{在 VLN-CE R2R Val-Unseen 划分上与当前最优方法的比较。
所用观测包括全景视图(Pano.)、里程计(Odo.)、
深度传感器(Depth)和单目 RGB 相机(S.RGB)。
所有结果均引自相应论文。
$*$表示使用航点预测器的方法。
最优结果以粗体标出,
次优结果以下划线标出。
}

\centering
\footnotesize
\resizebox{0.9\columnwidth}{!}{
\begin{tabular}{lcc|cccc|cccc}
\toprule
\multirow{2}{*}{方法} &\multirow{2}{*}{会议/期刊} & \multirow{2}{*}{\begin{tabular}[c]{@{}c@{}}{VLM}\\{参数量}\end{tabular}} & \multicolumn{4}{c|}{观测} & \multicolumn{4}{c}{R2R Val-Unseen} \\
\cmidrule(lr){4-7} \cmidrule(lr){8-11}
& & & 全景 & 里程计 & 深度 & 单目 RGB & NE$\downarrow$ & OS$\uparrow$ & SR$\uparrow$ & SPL$\uparrow$ \\
\midrule
HPN+DN$^*$[krantz2021waypoint]&ICCV2021 & - & $\checkmark$ & $\checkmark$ & $\checkmark$ & & 6.31 & 40.0 & 36.0 & 34.0 \\
CMA$^*$[hong2022bridging] &CVPR2022 & - & $\checkmark$ & $\checkmark$ & $\checkmark$ & & 6.20 & 52.0 & 41.0 & 36.0 \\
\vlnbert$^*$[hong2022bridging] &CVPR2022 & - & $\checkmark$ & $\checkmark$ & $\checkmark$ & & 5.74 & 53.0 & 44.0 & 39.0 \\
Sim2Sim$^*$[krantz2022sim] &ECCV2022 & - & $\checkmark$ & $\checkmark$ & $\checkmark$ & & 6.07 & 52.0 & 43.0 & 36.0 \\
GridMM$^*$[wang2023gridmm] &ICCV2023 & - & $\checkmark$ & $\checkmark$ & $\checkmark$ & & 5.11 & 61.0 & 49.0 & 41.0 \\
ETPNav$^*$[an2024etpnav] &TPAMI2024 & - & $\checkmark$ & $\checkmark$ & $\checkmark$ & & 4.71 & 65.0 & 57.0 & 49.0 \\
ScaleVLN$^{*}$[wang2023scaling]&ICCV2023 & - & $\checkmark$ & $\checkmark$ & $\checkmark$ & & 4.80 & -- & 55.0 & 51.0 \\
\midrule
InstructNav[long2024instructnav]&CoRL2024 & - & - & - & - & - & 6.89 & -- & 31.0 & 24.0 \\
LAW[law] &EMNLP2021 & - & & $\checkmark$ & $\checkmark$ & $\checkmark$ & 6.83 & 44.0 & 35.0 & 31.0 \\
CM2[cm2]&CVPR2022 & - & & $\checkmark$ & $\checkmark$ & $\checkmark$ & 7.02 & 41.5 & 34.3 & 27.6 \\
ETPNav + FF[eptnavff]&CoRL2024 & - & & $\checkmark$ & $\checkmark$ & $\checkmark$ & 5.95 & 55.8 & 44.9 & 30.4 \\
Seq2Seq[vlnce] &ECCV2020 & - & & & $\checkmark$ & $\checkmark$ & 7.77 & 37.0 & 25.0 & 22.0 \\
NavMorph[navmorph]&ICCV2025 & - & & & $\checkmark$ & $\checkmark$ & 5.75 & 56.9 & 47.9 & 33.2 \\
\midrule

NaVid[navid]&RSS2024 & 7B & & & & $\checkmark$ & 5.47 & 49.1 & 37.4 & 35.9 \\

NaVILA[navila]&RSS2025 &8B & & & & $\checkmark$ & 5.22 & 62.5 & 54.0 & 49.0 \\

Uni-NaVid[uni-navid]&RSS2025 &7B & & & & $\checkmark$ & 5.58 & 53.3 & 47.0 & 42.7 \\

Aux-Think[aux-think]&NeurIPS2025 &8B & & & & $\checkmark$ & 6.08 & 60.0 & 54.8 & 46.9 \\

StreamVLN[streamvln]&ICRA2026 &7B & & & & $\checkmark$ & 4.98 & 64.2 & 56.9 & 51.9 \\

MonoDream[monodream]&AAAI2026 &2B & & & & $\checkmark$ & 5.45 & 61.5 & 55.8 & 49.1 \\
InternVLA-N1(S2)[internnav2025]&- &7B & & & & $\checkmark$ & 4.89 & 60.6 & 55.4 & 52.1 \\
InternVLA-N1(S1+S2)[internnav2025]&-&8B & & & $\checkmark$ & $\checkmark$ & 4.83 & 63.3 & 58.2 & 54.0 \\
NavFoM[navfom]&ICLR2026 &7B & & & & $\checkmark$ & 5.01 & 64.9 & 56.2 & 51.2 \\
JanusVLN[janusvln]&ICLR2026 &8B & & & & $\checkmark$ & \underline{4.78} & \underline{65.2} & \underline{60.5} & **56.8** \\
\rowcolor[HTML]{EFF5FB} NaVIDA(本文)&- &3B& & & & $\checkmark$ & **4.32** & **69.5** & **61.4** & \underline{54.7} \\
\bottomrule
\end{tabular}
}

\end{table*}
实验
表:在 VLN-CE RxR Val-Unseen 划分上与当前最优方法的比较。 所用观测包括全景视图(Pano.)、里程计(Odo.)、 深度传感器(Depth)和单目 RGB 相机(S.RGB)。 所有结果均引自相应论文。 最优结果以粗体标出,次优结果以下划线标出。
\begin{table*}[ht]
\caption{在 VLN-CE RxR Val-Unseen 划分上与当前最优方法的比较。
所用观测包括全景视图(Pano.)、里程计(Odo.)、
深度传感器(Depth)和单目 RGB 相机(S.RGB)。
所有结果均引自相应论文。
最优结果以粗体标出,次优结果以下划线标出。
}

\centering
\footnotesize
\resizebox{0.9\columnwidth}{!}{
\begin{tabular}{lcc|cccc|cccc}
\toprule
\multirow{2}{*}{方法} & \multirow{2}{*}{会议/期刊} & \multirow{2}{*}{\begin{tabular}[c]{@{}c@{}}{VLM}\\{参数量}\end{tabular}} & \multicolumn{4}{c|}{观测} & \multicolumn{4}{c}{RxR Val-Unseen} \\
\cmidrule(lr){4-7} \cmidrule(lr){8-11}
& & & 全景 & 里程计 & 深度 & 单目 RGB & NE$\downarrow$ & SR$\uparrow$ & SPL$\uparrow$ & nDTW$\uparrow$ \\

\midrule
NaVILA[navila]&RSS2025 & 8B & & & & $\checkmark$ & 6.77 & 49.3 & 44.0 & 58.8 \\

Uni-NaVid[uni-navid]&RSS2025 & 7B & & & & $\checkmark$ & 6.24 & 48.7 & 40.9 & - \\

Aux-Think[aux-think]&NeurIPS2025 &8B & & & & $\checkmark$ & 6.24 & 52.2 & 40.2 & - \\

StreamVLN[streamvln]&ICRA2026 & 7B & & & & $\checkmark$ & 6.22 & 52.9 & 46.0 & 61.9 \\

MonoDream[monodream]&AAAI2026 & 2B & & & & $\checkmark$ & 6.38 & 49.4 & 40.9 & - \\
InternVLA-N1(S2)[internnav2025]& - & 7B & & & & $\checkmark$ & 6.41 & 49.5 & 41.8 & 62.6 \\
InternVLA-N1(S1+S2)[internnav2025]& - & 8B & & & $\checkmark$ & $\checkmark$ & 5.91 & 53.5 & 46.1 & \underline{65.3} \\
NavFoM[navfom]&ICLR2026 & 7B & & & & $\checkmark$ & \underline{5.51} & **57.4** & \underline{49.4} & 60.2 \\
JanusVLN[janusvln]&ICLR2026 & 8B & & & & $\checkmark$ & 6.06 & \underline{56.2} & 47.5 & 62.1 \\
\rowcolor[HTML]{EFF5FB} NaVIDA(本文)&- & 3B & & & & $\checkmark$ & **5.23** & **57.4** & **49.6** & **67.0** \\
\bottomrule
\end{tabular}
}

\end{table*}
实验设置
实现细节。 本文在 NaVIDA 中采用 Qwen2.5-VL-3B[qwen2_5]。训练期间冻结视觉编码器,并在混合视觉—语言导航与逆动力学数据上训练一轮,以 \(2e-5\) 的学习率优化投影器和 LLM 主干。遵循 NaVILA[navila],将时间上下文限制为八个历史帧;若序列超过此限制,则均匀下采样为八帧,以覆盖完整轨迹。除非另有说明,层次概率动作分块(HPAC)采用合并概率 \(p=0.7\),第 2 级分块最大大小为 \(n=3\)。 推理时仅执行预测出的前两个动作分块。 更多超参数细节见补充材料。
评估基准。 本文在 VLN-CE 上评估 NaVIDA,采用 R2R-CE[r2r; vlnce] 和 RxR-CE[rxr; vlnce] 的 Val-Unseen 划分。 遵循标准做法[janusvln; internnav2025; aux-think],报告导航误差(NE)、成功率(SR)、Oracle 成功率(OS)、路径长度加权成功率(SPL)和归一化动态时间规整(nDTW)。这些指标共同衡量目标完成情况、轨迹效率和路径保真度,并支持与近期仅使用 RGB 及多传感器的方法直接比较。指标的详细说明见补充材料。
真实环境评估设置。 真实环境实验在室内工作环境中使用 AgiBot X2 和 Unitree G1 两个人形机器人平台。AgiBot X2 配备两个单目鱼眼 RGB 相机;实验仅使用其中一个,并将其图像转换为与针孔相机采集结果等效的图像。Unitree G1 的内置相机朝下安装,其 \(55.2^\circ\) 视场(FOV)无法覆盖机器人正前方区域,因此在其胸部另行安装 RealSense D455f 相机。机器人收到指令后,将当前 RGB 图像上传至部署在配备 NVIDIA 4090 GPU 的远程服务器上的 NaVIDA。NaVIDA 在 \(0.93\) 秒内输出动作序列。机器人收到服务器发出的动作命令后,通过运动 API 执行该命令。
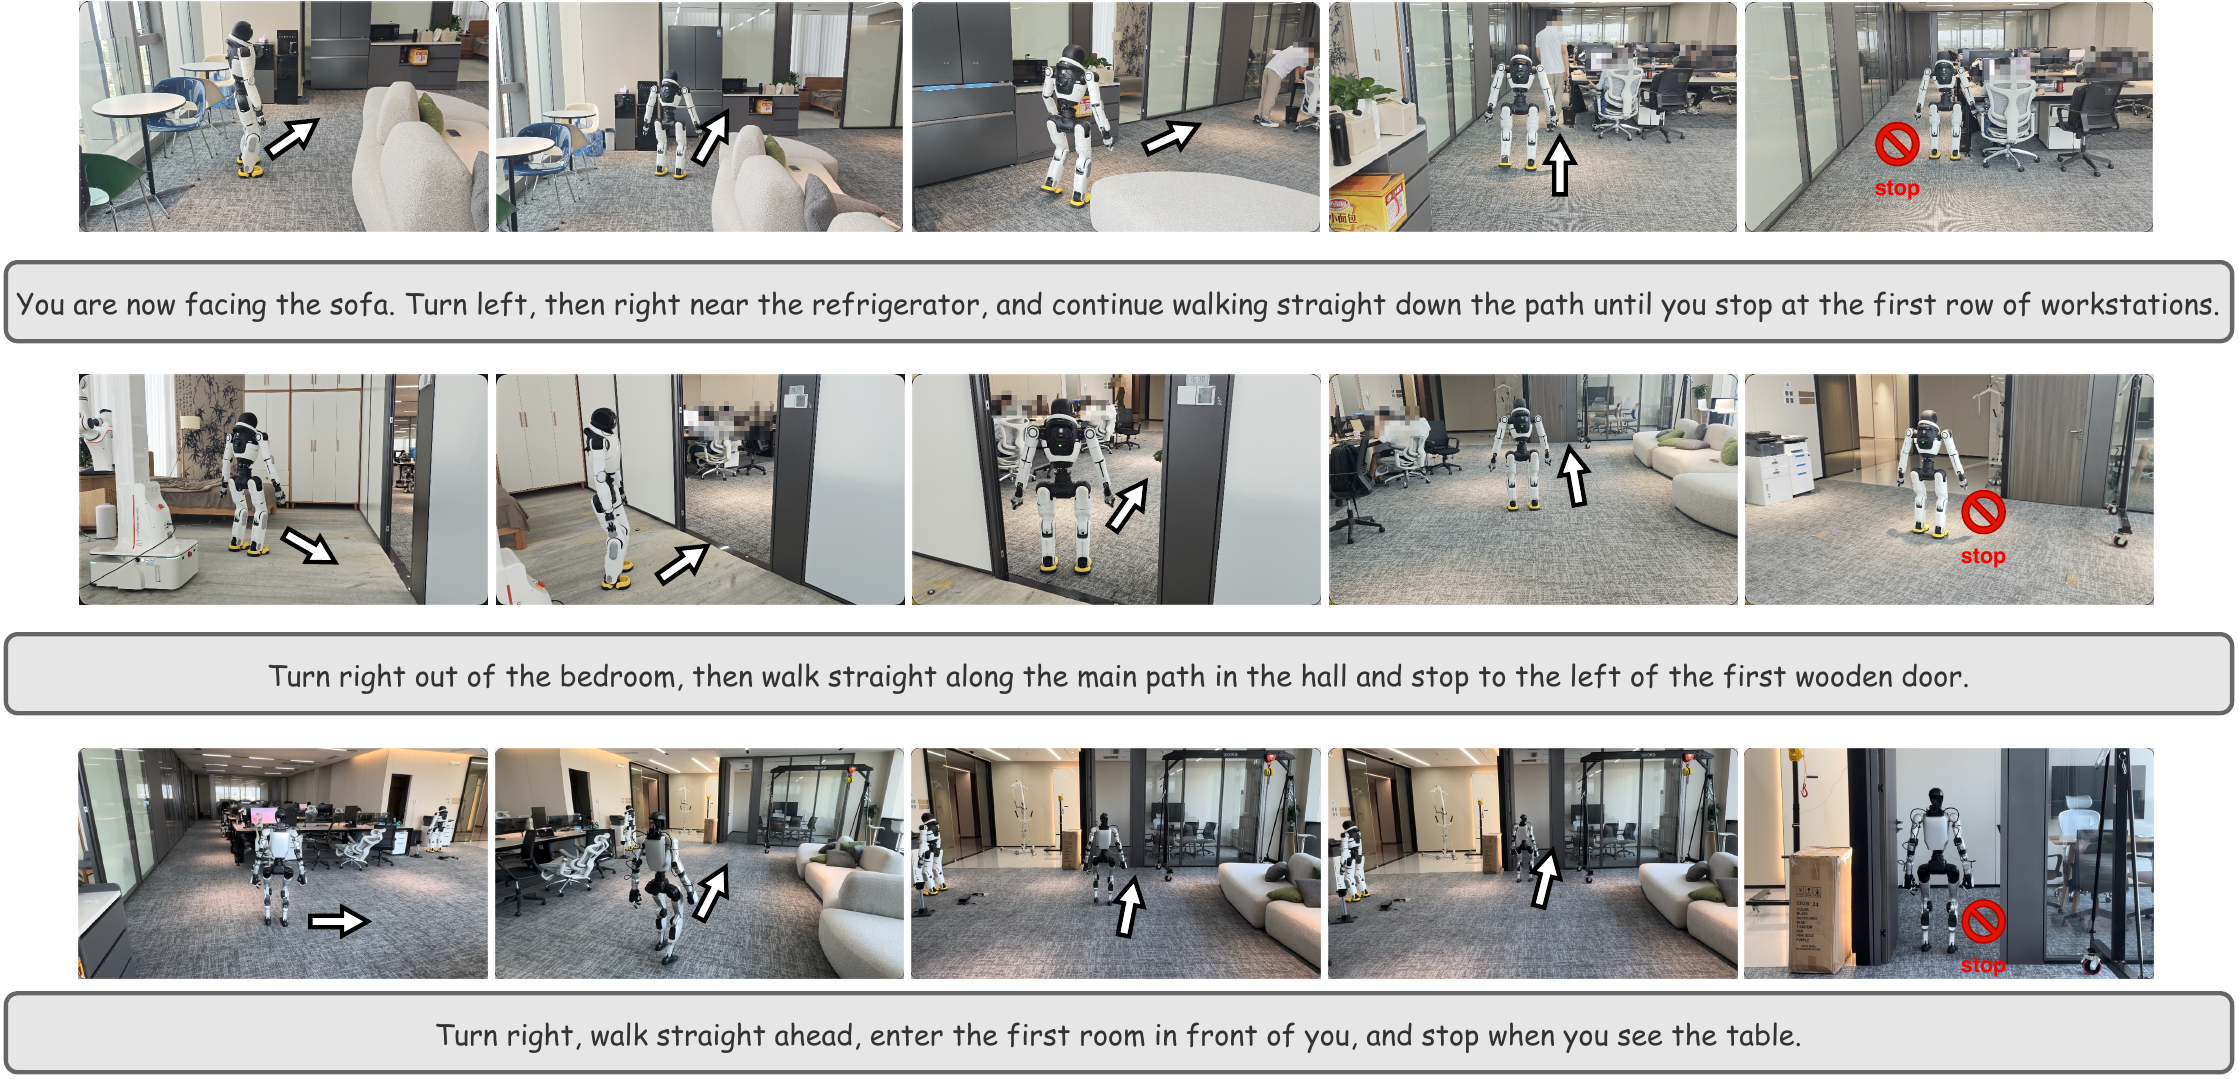
图:NaVIDA 的真实环境结果。图中箭头表示机器人的运动方向。
主要结果
性能评估。
如[tab:main result on vlnce r2r](R2R-CE)和[tab:main result on vlnce rxr](RxR-CE)所示,NaVIDA 仅使用单路 RGB 输入和 3B VLM 主干,即在 Val-Unseen 划分上取得当前最优结果。 在 R2R-CE 上,NaVIDA 的 NE、OS 和 SR 最优,SPL 次优;相较于最强的 8B 基线 JanusVLN[janusvln],NE、OS 和 SR 分别提升 -0.46、+4.3 和 +0.9。在 RxR-CE 上,NaVIDA 取得并列最优 SR(57.4),同时获得最优 NE、SPL 和 nDTW;相较于 StreamVLN 和 JanusVLN,SR 提升 +1.2 至 +4.5,SPL 提升 +2.1 至 +3.6,NE 提升 -0.83 至 -0.99。在轨迹更长、语言更丰富的 RxR-CE 基准上,IDS 与层次分块带来的持续增益表明,模型具有更强的长程对齐能力,并能减少漂移。 与 ETPNav 和 NavMorph 等多传感器方法相比,NaVIDA 的单 RGB 策略在核心指标上仍具有竞争力或更优。其参数量仅为其他仅使用 RGB 方法的 35%,且不使用辅助生成器或空间编码器,却取得了最优性能。总体而言,这些结果表明,结合 HPAC 的逆动力学增强可作为传统地图建模或前向世界建模的一种有效轻量替代方案。
表:VLN-CE R2R Val-Unseen 划分上的 IDS 数据消融实验。
\begin{table}[t]
\centering

\begin{minipage}{0.58\linewidth}
\centering
\caption{VLN-CE R2R Val-Unseen 划分上的 IDS 数据消融实验。}

\setlength{\tabcolsep}{4.5pt}
\newcommand{\grayhline}{\noalign{\color{lightgray}\hrule height 0.8pt\color{black}}}
\newcommand{\noidm}{$\circ$}
\newcommand{\withidm}{$\bullet$}

\newcolumntype{C}[1]{>{\centering\arraybackslash}m{#1}}
\newcommand{\srcw}{1.1cm}
\resizebox{\linewidth}{!}{
\begin{tabular}{*{3}{C{\srcw}}|cccc}
\toprule
R2R & RxR & DAgger & NE$\downarrow$ & OS$\uparrow$ & SR$\uparrow$ & SPL$\uparrow$ \\
\midrule
\noidm & & & 7.86 & 44.5 & 32.0 & 27.6 \\
\grayhline
\withidm & & & 6.99 & 51.5 & 40.5 & 35.5 \\
\grayhline
\withidm & \withidm & & 5.72 & 57.4 & 47.7 & 41.5 \\
\grayhline
\withidm & \withidm & \noidm & 5.25 & 60.9 & 53.7 & 47.0 \\
\grayhline
\noidm & \noidm & \noidm & 5.29 & 61.9 & 52.6 & 47.1 \\
\grayhline
\withidm & \withidm & \withidm & **4.91** & **63.2** & **55.5** & **49.6** \\
\bottomrule
\end{tabular}}
\end{minipage}
\hfill

\begin{minipage}{0.4\linewidth}
\centering
\caption{VLN-CE R2R Val-Unseen 划分上的 IDS 设计变体消融实验。}

\setlength{\tabcolsep}{4.5pt}
\resizebox{\linewidth}{!}{
\begin{tabular}{c|cccc}
\toprule
形式 & NE$\downarrow$ & OS$\uparrow$ & SR$\uparrow$ & SPL$\uparrow$ \\
\midrule
无 IDS & 5.29 & 61.9 & 52.6 & 47.1 \\
MCQ & 5.82 & 56.2 & 49.8 & 45.7 \\
加噪 IDS & 6.21 & 53.9 & 46.8 & 42.7 \\
PD & 5.27 & 60.1 & 52.3 & 47.8 \\
本文方法 & **4.91** & **63.2** & **55.5** & **49.6** \\
\bottomrule
\end{tabular}}
\end{minipage}
\end{table}
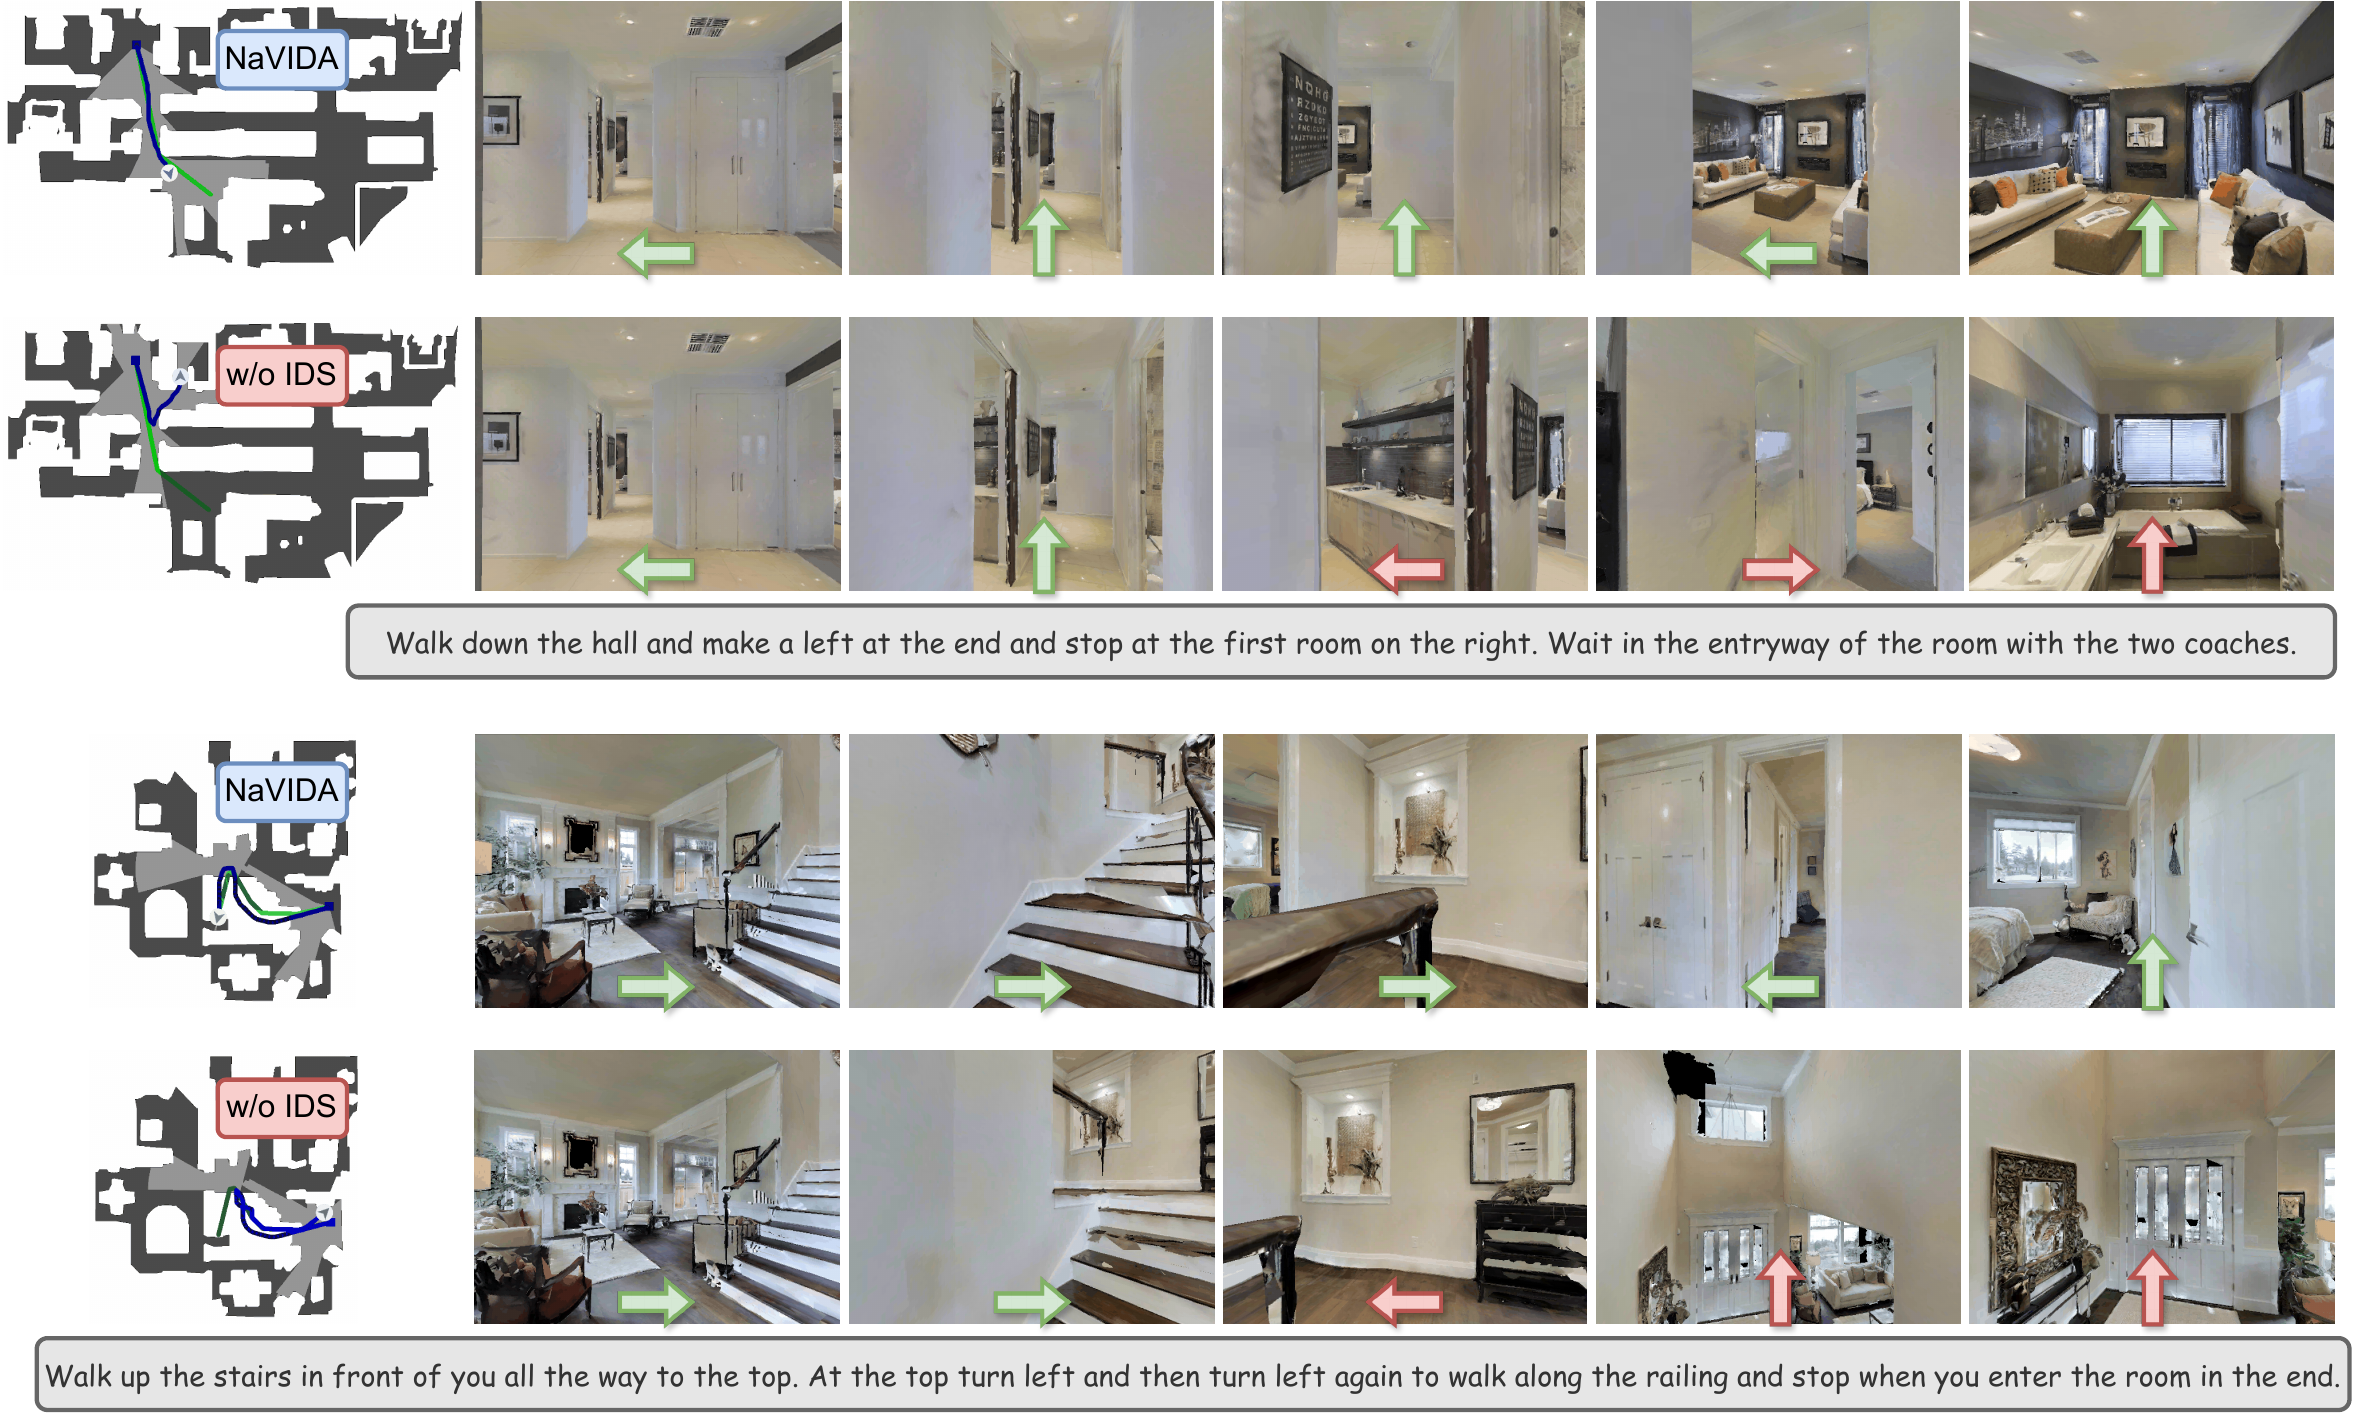
定性结果。 [fig:simulator_qualitative] 对比了 NaVIDA 与不使用 IDS 的变体,其中绿色箭头表示正确动作,红色箭头表示错误动作。 NaVIDA 能够正确延迟转向直至越过楼梯,并选择预期路口;消融模型则出现过早转向和路口误判。这些现象是典型的误差累积:模型缺乏对动作落地视觉动力学的理解,无法内化自身动作造成的视觉后果。
[fig:realworld_qualitative] 展示了真实环境实验示例。NaVIDA 能够在狭窄转角处完成急转,并顺利通过单人宽门口;即使前方有行人,也能抵抗干扰并保持稳定朝向。仿真与真实环境证据共同表明,逆动力学监督(IDS)是实现上述稳定性和场景泛化能力的关键,使模型优于不使用逆动力学监督的变体。
消融实验
本节对 IDS、HPAC 及不同动力学建模方法的有效性进行消融实验。为提高实验效率,采用不含 ScaleVLN 的数据开展实验,并报告 R2R-CE 基准上的性能。为便于分析,本节执行所有预测动作分块。
IDS 数据的可扩展性。
[tab:ablation_on_idm] 改变 R2R、RxR 和 DAgger 轨迹是否提供 IDS 数据对(提供为 \(\bullet\),不提供为 \(\circ\))。 引入 IDS 在所有指标和数据配置下均能持续提升性能。仅使用 R2R 时,加入 IDS 使 SR 从 32.0 提升至 40.5;扩展至 R2R+RxR 后,SR 进一步升至 47.7。不使用 IDS 而引入 DAgger 时,SR 为 52.6;对全部三个数据源启用 IDS 监督后,SR 达到 55.5,同时 NE 降至 4.91,SPL 升至 49.6。 性能增益在数据稀缺设置下最为明显,并随轨迹来源增加而持续累积。这种扩展规律表明,IDS 提供的是互补训练信号,而非仅仅增强模仿监督。 总体来看,IDS 为模型注入了可迁移且与语言无关的动作落地视觉动力学概念。更重要的是,该能力可与 DAgger 等现有基于轨迹展开的范式无缝结合,无需改变底层模仿学习框架即可获得叠加增益。
表:VLN-CE R2R Val-Unseen 划分上的 HPAC 消融实验。
\begin{table}[t]
\centering

\begin{minipage}{0.54\linewidth}
\centering
\caption{VLN-CE R2R Val-Unseen 划分上的 HPAC 消融实验。}

\resizebox{\linewidth}{!}{
\begin{tabular}{cc|cccc}
\toprule
分块大小 & 策略 & NE$\downarrow$ & OS$\uparrow$ & SR$\uparrow$ & SPL$\uparrow$ \\
\midrule
1 & 概率式 & 5.08 & 62.2 & 54.4 & 48.8 \\
2 & 概率式 & 4.94 & 60.8 & 54.2 & 48.9 \\
3 & 概率式 & **4.91** & **63.2** & **55.5** & **49.6** \\
3 & 基于 DINOv2 & 6.29 & 56.1 & 44.7 & 39.5 \\
4 & 概率式 & 5.23 & 60.2 & 52.5 & 46.4 \\
\bottomrule
\end{tabular}}
\end{minipage}
\hfill

\begin{minipage}{0.44\linewidth}
\centering
\caption{VLN-CE R2R Val-Unseen 划分上的动力学建模消融实验。}

\newcommand{\grayhline}{\noalign{\color{lightgray}\hrule height 0.8pt\color{black}}}
\resizebox{\linewidth}{!}{
\begin{tabular}{c|cccc}
\toprule
动力学方法 & NE$\downarrow$ & OS$\uparrow$ & SR$\uparrow$ & SPL$\uparrow$ \\
\midrule
基线 & 5.29 & 61.9 & 52.6 & 47.1 \\
\grayhline
使用 FDS(第 1 轮) & 6.13 & 56.0 & 44.6 & 38.7 \\
使用 FDS(第 2 轮) & 5.06 & 60.1 & 51.0 & 45.2 \\
使用 FDS(第 3 轮) & 5.06 & 62.4 & 53.9 & 48.2 \\
\grayhline
使用 IDS & **4.91** & **63.2** & **55.5** & **49.6** \\
\bottomrule
\end{tabular}}
\end{minipage}

\end{table}
IDS 设计消融。 为深入理解 IDS 如何促进动作预测,本文对其构建策略进行消融实验([tab:ablation on ids design])。 首先,在数据构建过程中用随机动作替换真实动作以破坏 IDS(加噪 IDS),从而打破动作与视觉转换之间的对齐,同时保持视觉—语言导航数据和训练规模不变。噪声监督为动作标记引入不一致的训练信号,使导航性能显著下降。这证实 IDS 的主要作用是强化细粒度动作—视觉动力学一致性,而非仅增加数据规模。 随后,将 IDS 改写为多项选择题(MCQ):模型不再直接生成动作标记,而是从四个候选项中选择正确动作。尽管保留了动作落地视觉动力学,导航性能仍略有下降。MCQ 格式允许模型依赖候选项间的简单比较或排除,而生成式 IDS 要求智能体仅根据视觉变化直接生成动作标记。因此,与视觉—语言导航解码共享同一生成式动作空间至关重要,这使 IDS 学到的转换知识可直接用于导航过程中的动作预测,从而产生更稳健的行为。 本文还实现了特权蒸馏(PD)变体:先以 IDS 监督训练教师模型,再通过最小化师生动作分布之间的 KL 散度,将其知识蒸馏到执行视觉—语言导航任务的学生模型中。尽管增加了这种监督,PD 的表现仍与不含动力学监督的基线相近,且逊于 NAVIDA。 这一有限增益源于动作落地视觉动力学理解的传递方式。PD 仅在输出分布层面对齐,促使学生模仿教师的最终预测。这种事后监督将视觉动力学知识视为训练后注入的固定动作信号。相比之下,NAVIDA 在统一框架内联合优化 IDS 与视觉—语言导航,使动作—视觉对齐能够通过共享表示持续学习和强化。这种更紧密的耦合使动作落地视觉动力学直接塑造导航推理,学习效果优于基于蒸馏的方法。
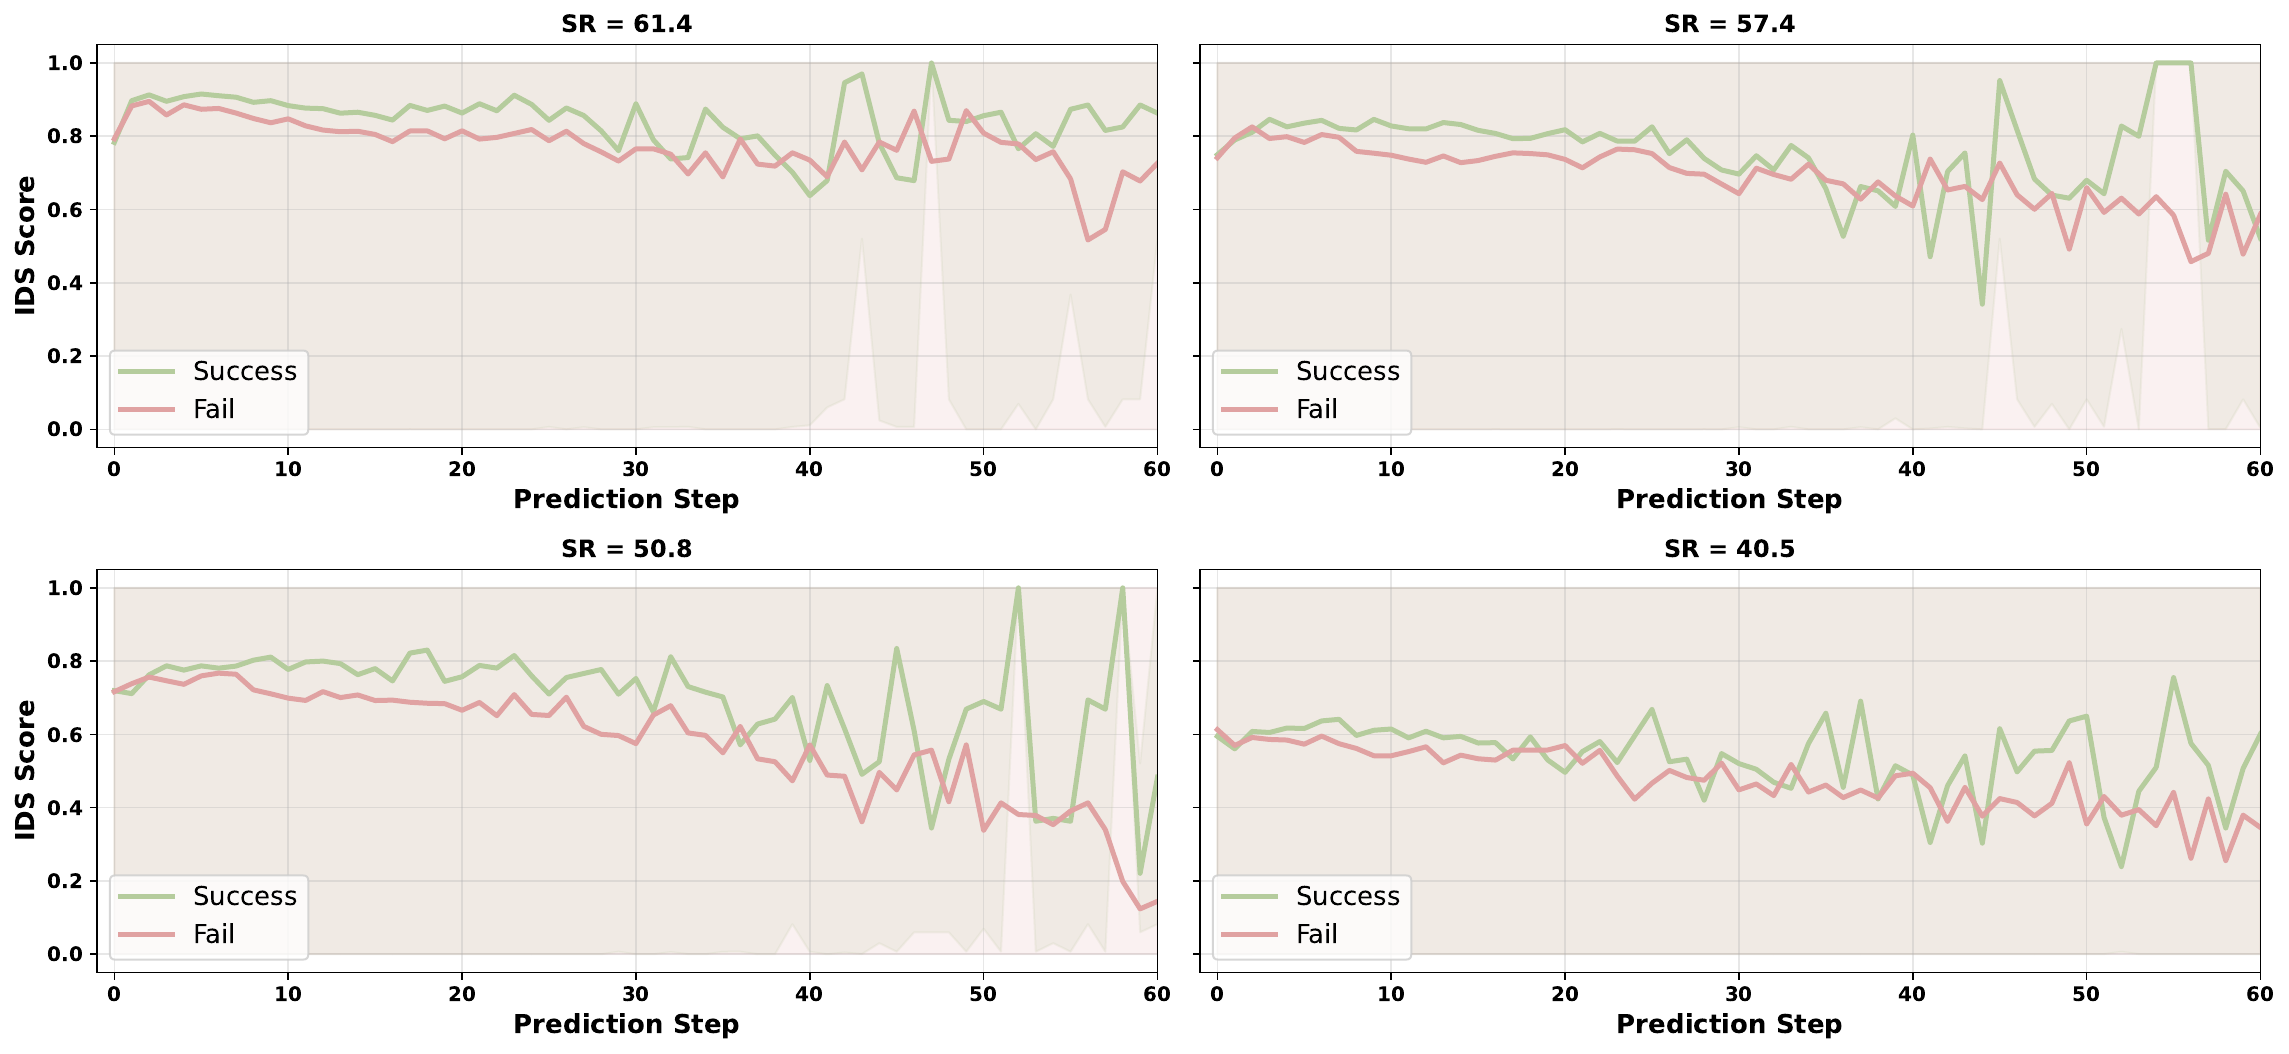
图:成功与失败轨迹的 IDS 分数随预测步数的变化。成功回合的 IDS 分数始终更高且更稳定,失败回合则逐渐下降,表明准确的动作—状态对齐对长程导航至关重要。
IDS 与导航性能的相关性。 为量化 IDS 推断动作序列与真实动作序列的一致性,本文根据二者产生的仿真器状态差异定义IDS 分数。 分别执行预测序列 \(\hat{\mathbf{a}}\) 和真实序列 \(\mathbf{a}\),得到最终位姿 \((\hat{\mathbf{p}}, \hat{\theta})\) 和 \((\mathbf{p}, \theta)\),其中 \(\mathbf{p} \in \mathbb{R}^3\) 表示位置,\(\theta\) 表示偏航角。 位置与角度差异计算如下:
$$
\Delta_p = |\hat{\mathbf{p}} - \mathbf{p}|2, \quad \Delta\theta = \min \left( \left| \hat{\theta} - \theta \right|,\, 2\pi - \left| \hat{\theta} - \theta \right| \right).
$$
IDS 分数定义为:
$$
\mathrm{IDS_{Score}} = \exp\left(-\frac{\Delta_p}{\sigma_p}\right) \cdot \exp\left(-\frac{\Delta_\theta}{\sigma_\theta}\right),
$$
其中,\(\sigma_p\) 和 \(\sigma_\theta\) 分别控制对位置与角度偏差的敏感度。 实现中设定 \(\sigma_p = 0.1\)、\(\sigma_\theta = \pi/12\)。
[fig:ids_score] 展示了在不同总体成功率下,成功与失败轨迹的 IDS 分数随预测步数的变化,呈现出若干一致趋势。 在早期阶段,成功与失败回合的 IDS 分数相近,表明两种情况下的短期动作预测通常都较可靠。随着导航推进,两条曲线逐渐分离:成功轨迹保持更高、更稳定的 IDS 分数,而失败轨迹的分数持续下降。差距不断扩大,说明对动作引起的视觉转换进行理解和准确预测,对长程导航愈发重要。 总体成功率更高的设置始终具有更高、更稳定的 IDS 分数。这种强相关性表明,IDS 的准确性反映了模型理解自身动作视觉动力学的能力。理解越准确,动作序列随时间越能保持连贯,导航性能也越好。相反,失败轨迹中较低的 IDS 分数意味着模型对动作—视觉动力学理解较弱,微小偏差不断累积并最终导致失败。
HPAC 消融。
[tab:ablation_on_chunk_num] 给出了 VLN-CE R2R Val-Unseen 划分上的 HPAC 消融实验。 首先分析动作分块最大数量的影响。当最大值设为 \(1\) 且合并概率固定为 \(1\) 时,HPAC 退化为先前工作[navid; navila]采用的确定性动作合并策略。在默认概率合并方案下,允许最多 \(3\) 个动作分块时性能最佳;分块更少或更多都会降低性能。这表明,适度延长分块有助于长程规划,而过长分块可能超出模型的有效感知范围并导致次优决策。概率合并策略还会在分块边界中引入受控随机性,保持动作分块的多样性,并增强对轻微执行波动的鲁棒性。 本文还评估了基于 DINOv2[dinov2] 相似度的确定性替代方案,其中依据视觉相似度对相邻帧分组。该变体总体表现最差,原因在于 DINOv2 主要捕获高层语义相似性,而导航依赖几何变化和视角变化。例如,从不同视角观察同一物体时,即使空间位移显著,DINOv2 相似度仍可能很高。这种由语义驱动的确定性合并会掩盖运动线索并降低分段多样性,进而削弱动作监督并降低性能。
逆动力学与前向动力学。
为评估逆动力学监督的有效性,本文将其与前向动力学监督(FDS)比较,二者均旨在增强动作落地视觉动力学建模。遵循 MonoDream[monodream],FDS 使用同一 VLM 预测未来视觉特征,不引入额外模块。考虑到其收敛较慢,本文将 FDS 训练三轮,以评估其相较于 IDS 的有效性和效率。 如[tab:ablation_on_dynamic_model]所示,IDS 始终优于 FDS 和不含动力学监督的基线,而 FDS 在初期会导致明显的性能下降。这一差距源于输出空间对齐方式和优化难度的差异。预测稠密未来视觉特征需要建模高维外观变化,这对预训练 VLM 而言较难,通常需要更充分的训练(例如,MonoDream 训练五轮)。相比之下,IDS 与视觉—语言导航中的动作预测共享同一输出空间,因而与模型的预训练目标和下游目标对齐得更好。 尽管 FDS 随训练增加而逐步改善,并在三轮后最终超过基线,其性能仍落后于仅训练一轮即取得更优结果的 IDS。这些结果表明,IDS 提供了更稳定且数据效率更高的监督,而 FDS 需要更长时间的优化才能学到可靠的未来状态预测。
结论
本文提出 NaVIDA,这是一个将策略学习与动作落地视觉动力学建模相结合的统一视觉—语言导航框架。通过基于分块的逆动力学监督,NaVIDA 实现了更具可解释性且更稳定的导航。所提出的层次概率动作分块机制将导航轨迹组织为多层级运动单元,为逆动力学学习提供更丰富、更长程的监督。大量实验表明,与当前最优方法相比,NaVIDA 以更少的参数实现了更优的导航性能;真实机器人评估进一步验证了其有效性和实际适用性。
附录
不同任务的提示词
我们针对视觉—语言导航和逆动力学监督(IDS)使用特定于任务的提示词,二者均采用相同的动作语法(动作类型 + 数值词元)表示。
对于视觉—语言导航任务,我们使用以下提示词模板,引导模型预测相应的动作块:
假设你是一个为导航任务编程的机器人。现向你提供一段历史观测视频:< 图像>,...,< 图像>,以及当前观测:< 图像>。分配给你的任务是:[指令]。请分析这一系列图像以决定下一步动作,该动作可能包括向左或向右旋转特定角度,或向前移动一定距离。
其中,[指令] 是当前导航任务给出的语言指令。对于逆动力学监督(IDS),我们使用如下提示词模板:
假设你是一个为导航任务编程的机器人。现向你提供一张当前视图图像 < 图像> 和一张目标视图图像 < 图像>。请分析这两张图像,预测可使机器人从当前视点移动至目标视图的导航动作,该动作可能包括向左或向右旋转特定角度,或向前移动一定距离。
对于逆动力学监督(IDS)的多项选择题(MCQ),提示词如下:
假设你是一个为导航任务编程的机器人。现向你提供一张当前视图图像 < 图像> 和一张目标视图图像 < 图像>。请分析这两张图像,预测可使机器人从当前视点移动至目标视图的导航动作。请从四个选项(A、B、C 或 D)中选择正确答案。选项:\ n A. < 动作 A> \ n B. < 动作 B> \ n C. < 动作 C> \ n D. < 动作 D>
对于前向动力学监督(FDS),任务要求根据给定的历史帧和语言指令预测下一时间步的视觉观测特征。我们使用以下提示词:
假设你是一个为导航任务编程的机器人。现向你提供一段历史观测视频:< 图像>,...,< 图像>,以及当前观测:< 图像>。分配给你的任务是:[指令]。请分析这一系列图像以预测未来观测。
更多实现细节
数据细节
[fig:data_distribution] 展示了逆动力学(IDM)数据集中每个层次概率动作分块(HPAC)所含原子动作数量的分布。尽管大多数动作块包含 \(3\) 至 \(5\) 个原子动作,与先前工作[navid; navila; streamvln] 采用的固定动作块大小一致,但仍有不可忽略的一部分样本包含更少或更多原子动作。 较长的动作块编码更大幅度的第一人称视点变化与视差,为逆动力学提供强且信息丰富的监督信号,并通过扩展模型的时间上下文支持长时域规划。相比之下,较短的动作块侧重细微、精细的视觉变化(例如小幅转向或局部重新对齐),有助于实现精确控制并减少短时域下的动作歧义。这种长短动作块的自然混合构成互补的课程:层次概率动作分块(HPAC)既为规划提供全局结构线索,也提供用于稳定控制的局部调整先验,从而增强模型对动作条件视觉动态及动作的理解,并提高执行过程中抵抗累积误差的鲁棒性。
我们还将导航进程归一化至 0 到 1 的范围,[fig:data_length_time_step] 展示了动作块随导航推进的分布。可以看出,在导航早期,层次概率动作分块(HPAC)会合并大量原子动作;到中期,其数量略有下降并趋于稳定。在导航后期、接近目标时,层次概率动作分块(HPAC)倾向于使用较少的原子动作来稳定机器人位置。
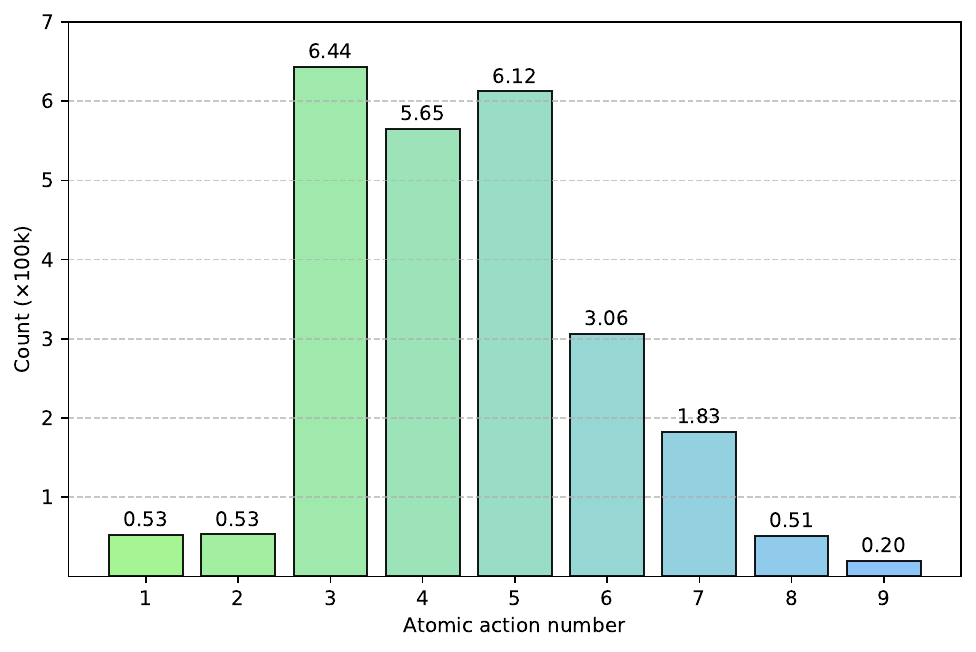
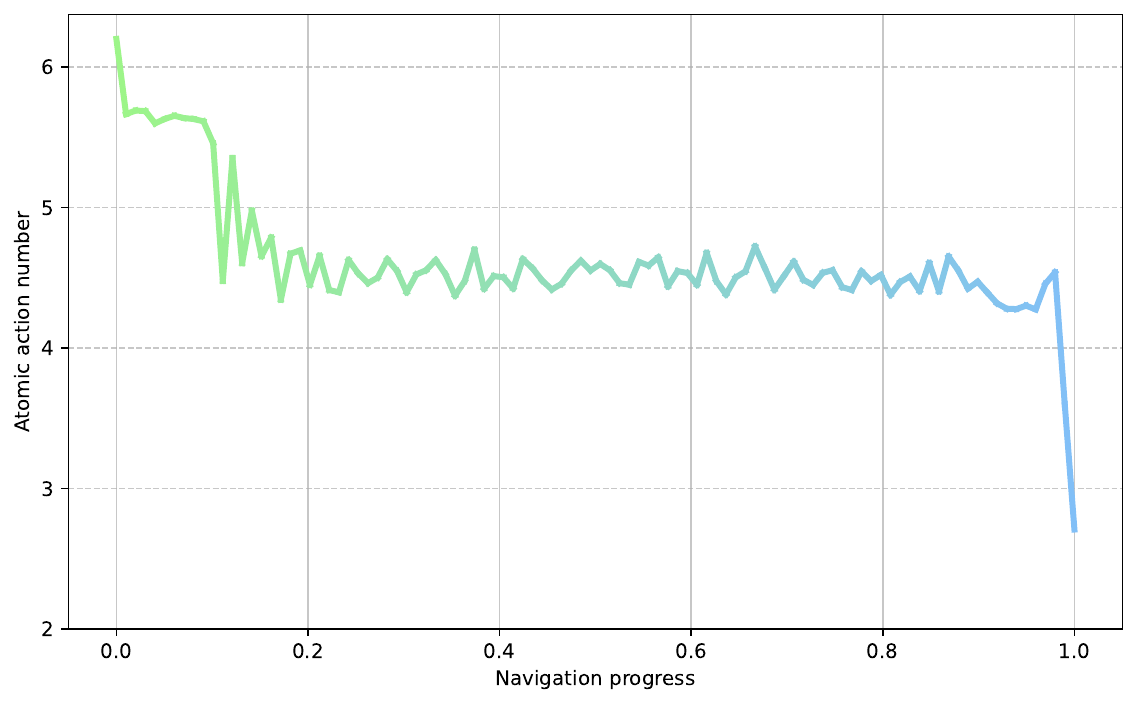
图:IDM 数据中每个层次概率动作分块(HPAC)所含原子动作数量的分布。;动作在导航进程中的分布。;数据集中层次概率动作分块(HPAC)的原子动作统计。
训练超参数
NaVIDA 基于 Qwen-2.5-VL-3B 实现;视觉编码器被冻结,仅投影器和 LLM 参与训练。我们采用 AdamW,学习率 = 2e-5、BF16、Flash-Attention v2、全局批大小 = 64;其他超参数汇总于[tab:hyperparams]。
表:微调 Qwen2.5-VL 所用的训练超参数。仅投影器和 LLM 模块参与训练。
\begin{table}[ht]
\centering
\caption{微调 Qwen2.5-VL 所用的训练超参数。仅投影器和 LLM 模块参与训练。}

\begin{tabular}{l c}
\toprule
**超参数** & **取值** \\
\midrule
训练轮数 & $1$ \\
可训练模块 & 投影器 + LLM \\
学习率 & $2e-5$ \\
优化器 & AdamW \\
AdamW $\beta_1$ & $0.9$ \\
AdamW $\beta_2$ & $0.999$ \\
Adam $\epsilon$ & $1e-8$ \\
学习率调度 & 线性 \\
全局批大小 & $64$ \\
梯度累积 & $4$ \\
混合精度类型 & BFloat16 \\
注意力类型 & Flash Attention v2 \\
LLM 序列长度 & $64800$ \\
图像分辨率 & $308 \times 252$ \\
\bottomrule
\end{tabular}
\end{table}
评估指标细节
为形式化评估标准并阐明各指标的实际含义,我们报告导航误差(NE)、成功率(SR)、Oracle 成功率(OSR)、路径长度加权成功率(SPL)和归一化动态时间规整(nDTW)。简而言之,NE 越低越好,而 SR/OSR/SPL/nDTW 越高越好。
导航误差(NE)。 NE 衡量智能体停止位置 \(\mathbf{p}_{T}\) 与目标位置 \(\mathbf{g}\) 之间的最终距离,其定义为:
$$
\mathrm{NE} = d(\mathbf{p}_{T},\, \mathbf{g}),
$$
其中,\(d(\cdot,\cdot)\) 表示导航环境中的测地距离。NE 越小,说明终点精度越高。
成功率(SR)。 若智能体停止在距目标不超过阈值 \(\tau\) 的范围内,则该导航回合被视为成功。成功率定义为:
$$
\mathrm{SR} = \frac{1}{N} \sum_{i=1}^{N} \mathbf{1}\big[ d(\mathbf{p}_{T}^{(i)}, \mathbf{g}^{(i)}) \le \tau \big],
$$
其中,\(N\) 为回合总数;在大多数视觉—语言导航设定中,\(\tau\) 设为 \(3\)。SR 越高,表示完成目标的一致性越强。
Oracle 成功率(OSR)。 OSR 评估智能体在整条轨迹中是否曾进入成功半径 \(\tau\) 的范围,而不考虑其最终停止位置:
$$
\mathrm{OSR} = \frac{1}{N} \sum_{i=1}^{N} \mathbf{1}\Big[ \min_{t} d(\mathbf{p}_{t}^{(i)}, \mathbf{g}^{(i)}) \le \tau \Big].
$$
其中,\(\mathbf{p}_{t}^{(i)}\) 是机器人在第 \(i\) 个回合中的第 \(t\) 个位置。OSR 有助于理解可恢复性和过早停止现象。
路径长度加权成功率(SPL)。 SPL 衡量成功导航的效率,对比最短测地路径长度 \(L^{(i)}\) 与智能体实际行进的路径长度 \(P^{(i)}\):
$$
\mathrm{SPL} = \frac{1}{N} \sum_{i=1}^{N} \mathbf{1}\big[d(\mathbf{p}_{T}^{(i)}, \mathbf{g}^{(i)}) \le \tau \big] \cdot \frac{L^{(i)}}{\max(P^{(i)},\, L^{(i)})}.
$$
对于失败回合,SPL 通过指示函数取值为 \(0\);当成功路径接近最优时,SPL 趋近于 \(1\)。
归一化动态时间规整(nDTW)。 nDTW 使用动态时间规整距离 \(\mathrm{DTW}(\cdot,\cdot)\) 衡量智能体路径 \(\{\mathbf{p}_{t}\}_{t=1}^{T}\) 与最短路径参考轨迹 \(\{\mathbf{q}_{k}\}_{k=1}^{K}\) 之间的轨迹相似度:
$$
\mathrm{nDTW} = \exp!\left(- \frac{\mathrm{DTW}(\mathbf{p}{1:T},\, \mathbf{q}{1:K})}{\eta} \right),
$$
其中,\(\eta\) 是归一化常数(通常取最短路径长度)。这种指数归一化将对齐代价转换为范围在 \((0, 1]\) 内的有界相似度分数;数值越接近 \(1\),表示与最优参考轨迹在空间和时间上的一致性越高。直观而言,即使轨迹在时序或步骤对应关系上存在细微差异,nDTW 也会奖励紧密遵循正确路线的轨迹。与简单的几何距离指标相比,nDTW 考虑了导航中常见的局部时间错位和路线重叠,因而能以更灵活、更鲁棒的方式衡量路径跟随质量。
真实世界部署细节
[fig:real_world_setup] 展示了真实世界部署系统的整体架构。具体而言,NaVIDA 部署在配备 NVIDIA RTX 4090 GPU 的远程计算服务器上。该系统采用客户端—服务器结构:机器人作为客户端收集传感数据并执行运动命令,远程服务器负责高层推理与动作预测。
运行过程中,机器人持续通过前置相机采集 RGB 图像(如[fig:robot_setup] 所示),并经由局域网接收用户的自然语言或语音命令。随后,传感数据及对应命令被打包并通过互联网传输至远程服务器。在服务器端,NaVIDA 模型处理这些输入,执行视觉—语言推理,并预测下一个导航动作。预测的运动命令随后返回机器人,并通过机器人的运动控制 API 转换为线速度、角速度和运动时长等可执行参数。
此外,我们还提供了真实世界部署的演示视频,并随补充材料一并提交。视频中观察到的轻微延迟主要源于机器人与远程服务器之间的网络通信延迟。
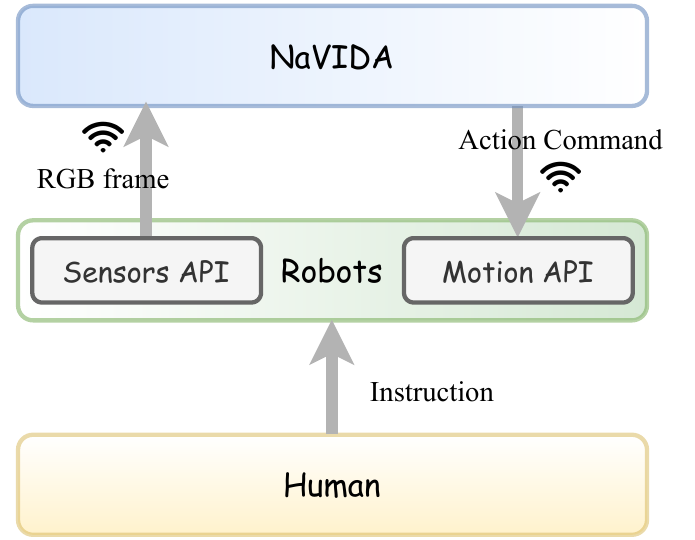
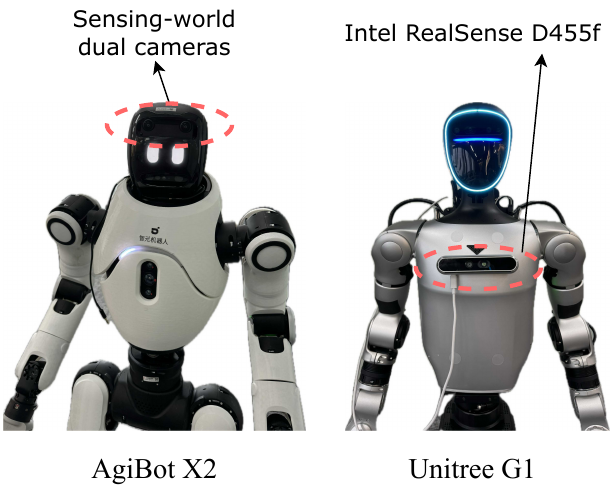
图:用于真实世界评估的部署系统架构。RGB 帧和用户指令从机器人传输至运行 NaVIDA 的远程服务器;服务器预测动作序列,并返回运动命令,由机器人的运动 API 执行。;机器人平台与传感配置。AgiBot X2(左)配备单个经校正的鱼眼 RGB 相机,Unitree G1(右)另配备 Intel RealSense D455f 前置相机,从而为 NaVIDA 的导航策略提供一致的单目 RGB 输入。;真实世界评估设置。
表:在 VLN-CE R2R Val-Unseen 划分上微调视觉编码器的消融研究。
\begin{table}[h]
\caption{在 VLN-CE R2R Val-Unseen 划分上微调视觉编码器的消融研究。}

\centering
\begin{tabular}{c|cccc}
\toprule
视觉编码器 & NE$\downarrow$ & OS$\uparrow$ & SR$\uparrow$ & SPL$\uparrow$ \\
\midrule
可训练 & 5.12 & **63.6** & **55.6** & 49.2 \\
冻结 & **4.91** & 63.2 & 55.5 & **49.6** \\
\bottomrule
\end{tabular}

\end{table}
更多实验结果
更多消融实验
数据规模。 [fig:performance-data_scale] 展示了 NaVIDA 在 R2R-CE Val-Unseen 上的性能随数据总量变化的趋势,其中数据总量同时包括逆动力学监督(IDS)数据与视觉—语言导航数据。我们还在 R2R-CE Val-Unseen 上构建了逆动力学监督(IDS)验证集,并绘制了 IDS 分数的变化曲线。随着数据总量增加,NaVIDA 的性能持续提升。在数据规模较小时,这种提升尤为显著,说明 NaVIDA 能够在低数据量条件下有效利用额外数据,学习更鲁棒的表示。然而,随着数据总量继续增长,性能增益逐渐趋于饱和。这一现象可能反映了边际收益递减:模型已经从现有数据中捕获了大部分有用模式,继续增加数据对性能的贡献随之减小。此外,性能趋稳也可能表明,在数据量达到某一阈值后,模型容量、任务复杂度或数据内在噪声等其他因素成为限制条件。
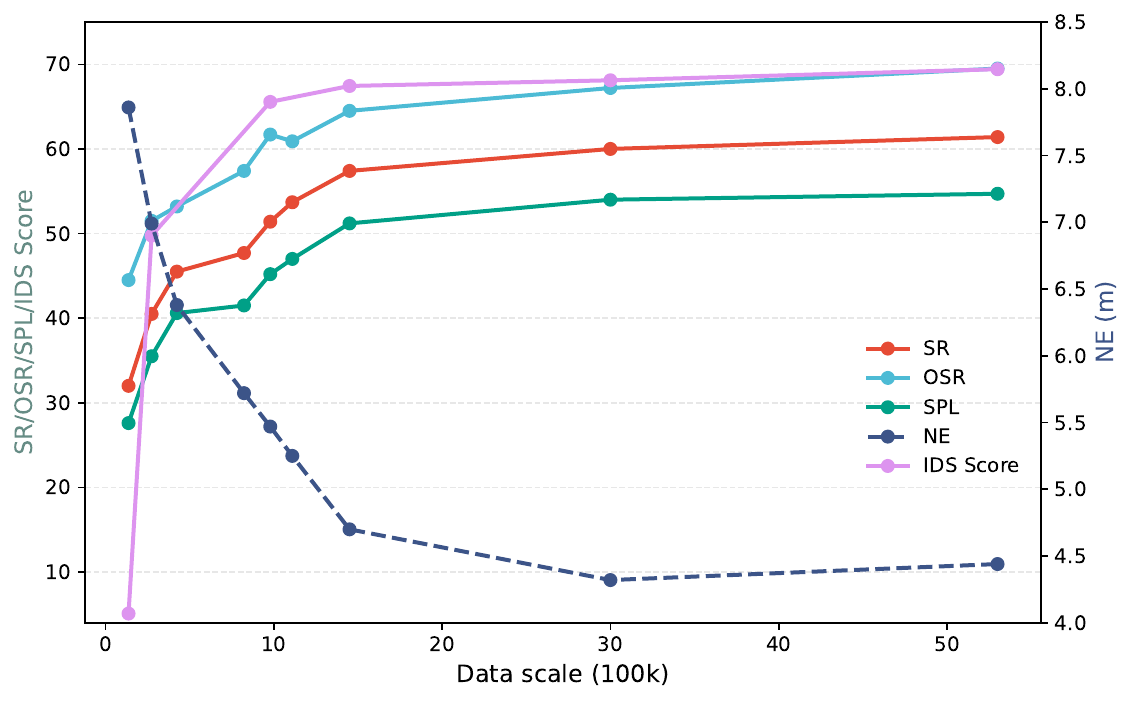
图:随着数据规模增加,NaVIDA 在 VLN-CE R2R Val-Unseen 划分上的导航性能。随着数据量增长,SR/OSR/SPL/IDS 分数上升而 NE 下降;在较大数据规模下,性能增益逐渐减弱。
视觉编码器:冻结与可训练。 我们开展消融研究,评估微调视觉编码器对整体导航性能的影响。如[tab:ablation_on_vision_encoder] 所示,与保持冻结相比,解冻视觉编码器并进行端到端训练仅带来微小提升。这一结果表明,预训练视觉表示已经为下游导航任务提供了足够的信息,进一步适配的收益有限。此外,微调会显著增加 GPU 显存占用和训练时间,而精度收益很小。因此,在后续所有实验中,我们均保持视觉编码器冻结,使模型能够高效利用鲁棒的预训练视觉特征,同时在性能与计算效率之间取得良好平衡。
历史帧数量。 我们开展消融研究,考察历史帧数量如何影响 R2R-CE Val-Unseen 划分上的导航性能。为保持一致性,所有模型均仅使用 R2R 训练数据进行训练。如[tab:ablation_on_history_frames] 所示,使用 \(8\) 个历史帧足以覆盖大多数指令时域,为模型的动作推理提供充分的时间上下文。将帧数增加至 \(16\) 并未带来显著性能提升,偶尔还会导致轻微下降,这可能是因为较长序列积累了冗余或噪声视觉信息。这一现象与 NaVILA[navila] 的发现一致,表明过多的历史上下文可能削弱近期观测的相关性并妨碍时间定位。因此,我们采用 \(8\) 个历史帧,以在上下文丰富度与模型效率之间取得平衡。
表:VLN-CE R2R Val-Unseen 划分上历史帧数量的消融研究。
\begin{table}[h]
\caption{VLN-CE R2R Val-Unseen 划分上历史帧数量的消融研究。}

\centering
\begin{tabular}{c|cccc}
\toprule
\# 历史帧 & NE$\downarrow$ & OS$\uparrow$ & SR$\uparrow$ & SPL$\uparrow$ \\
\midrule
8 & **6.99** & **51.5** & **40.5** & 35.5 \\
16 & 7.02 & 50.1 & 40.4 & **36.1** \\
\bottomrule
\end{tabular}

\end{table}
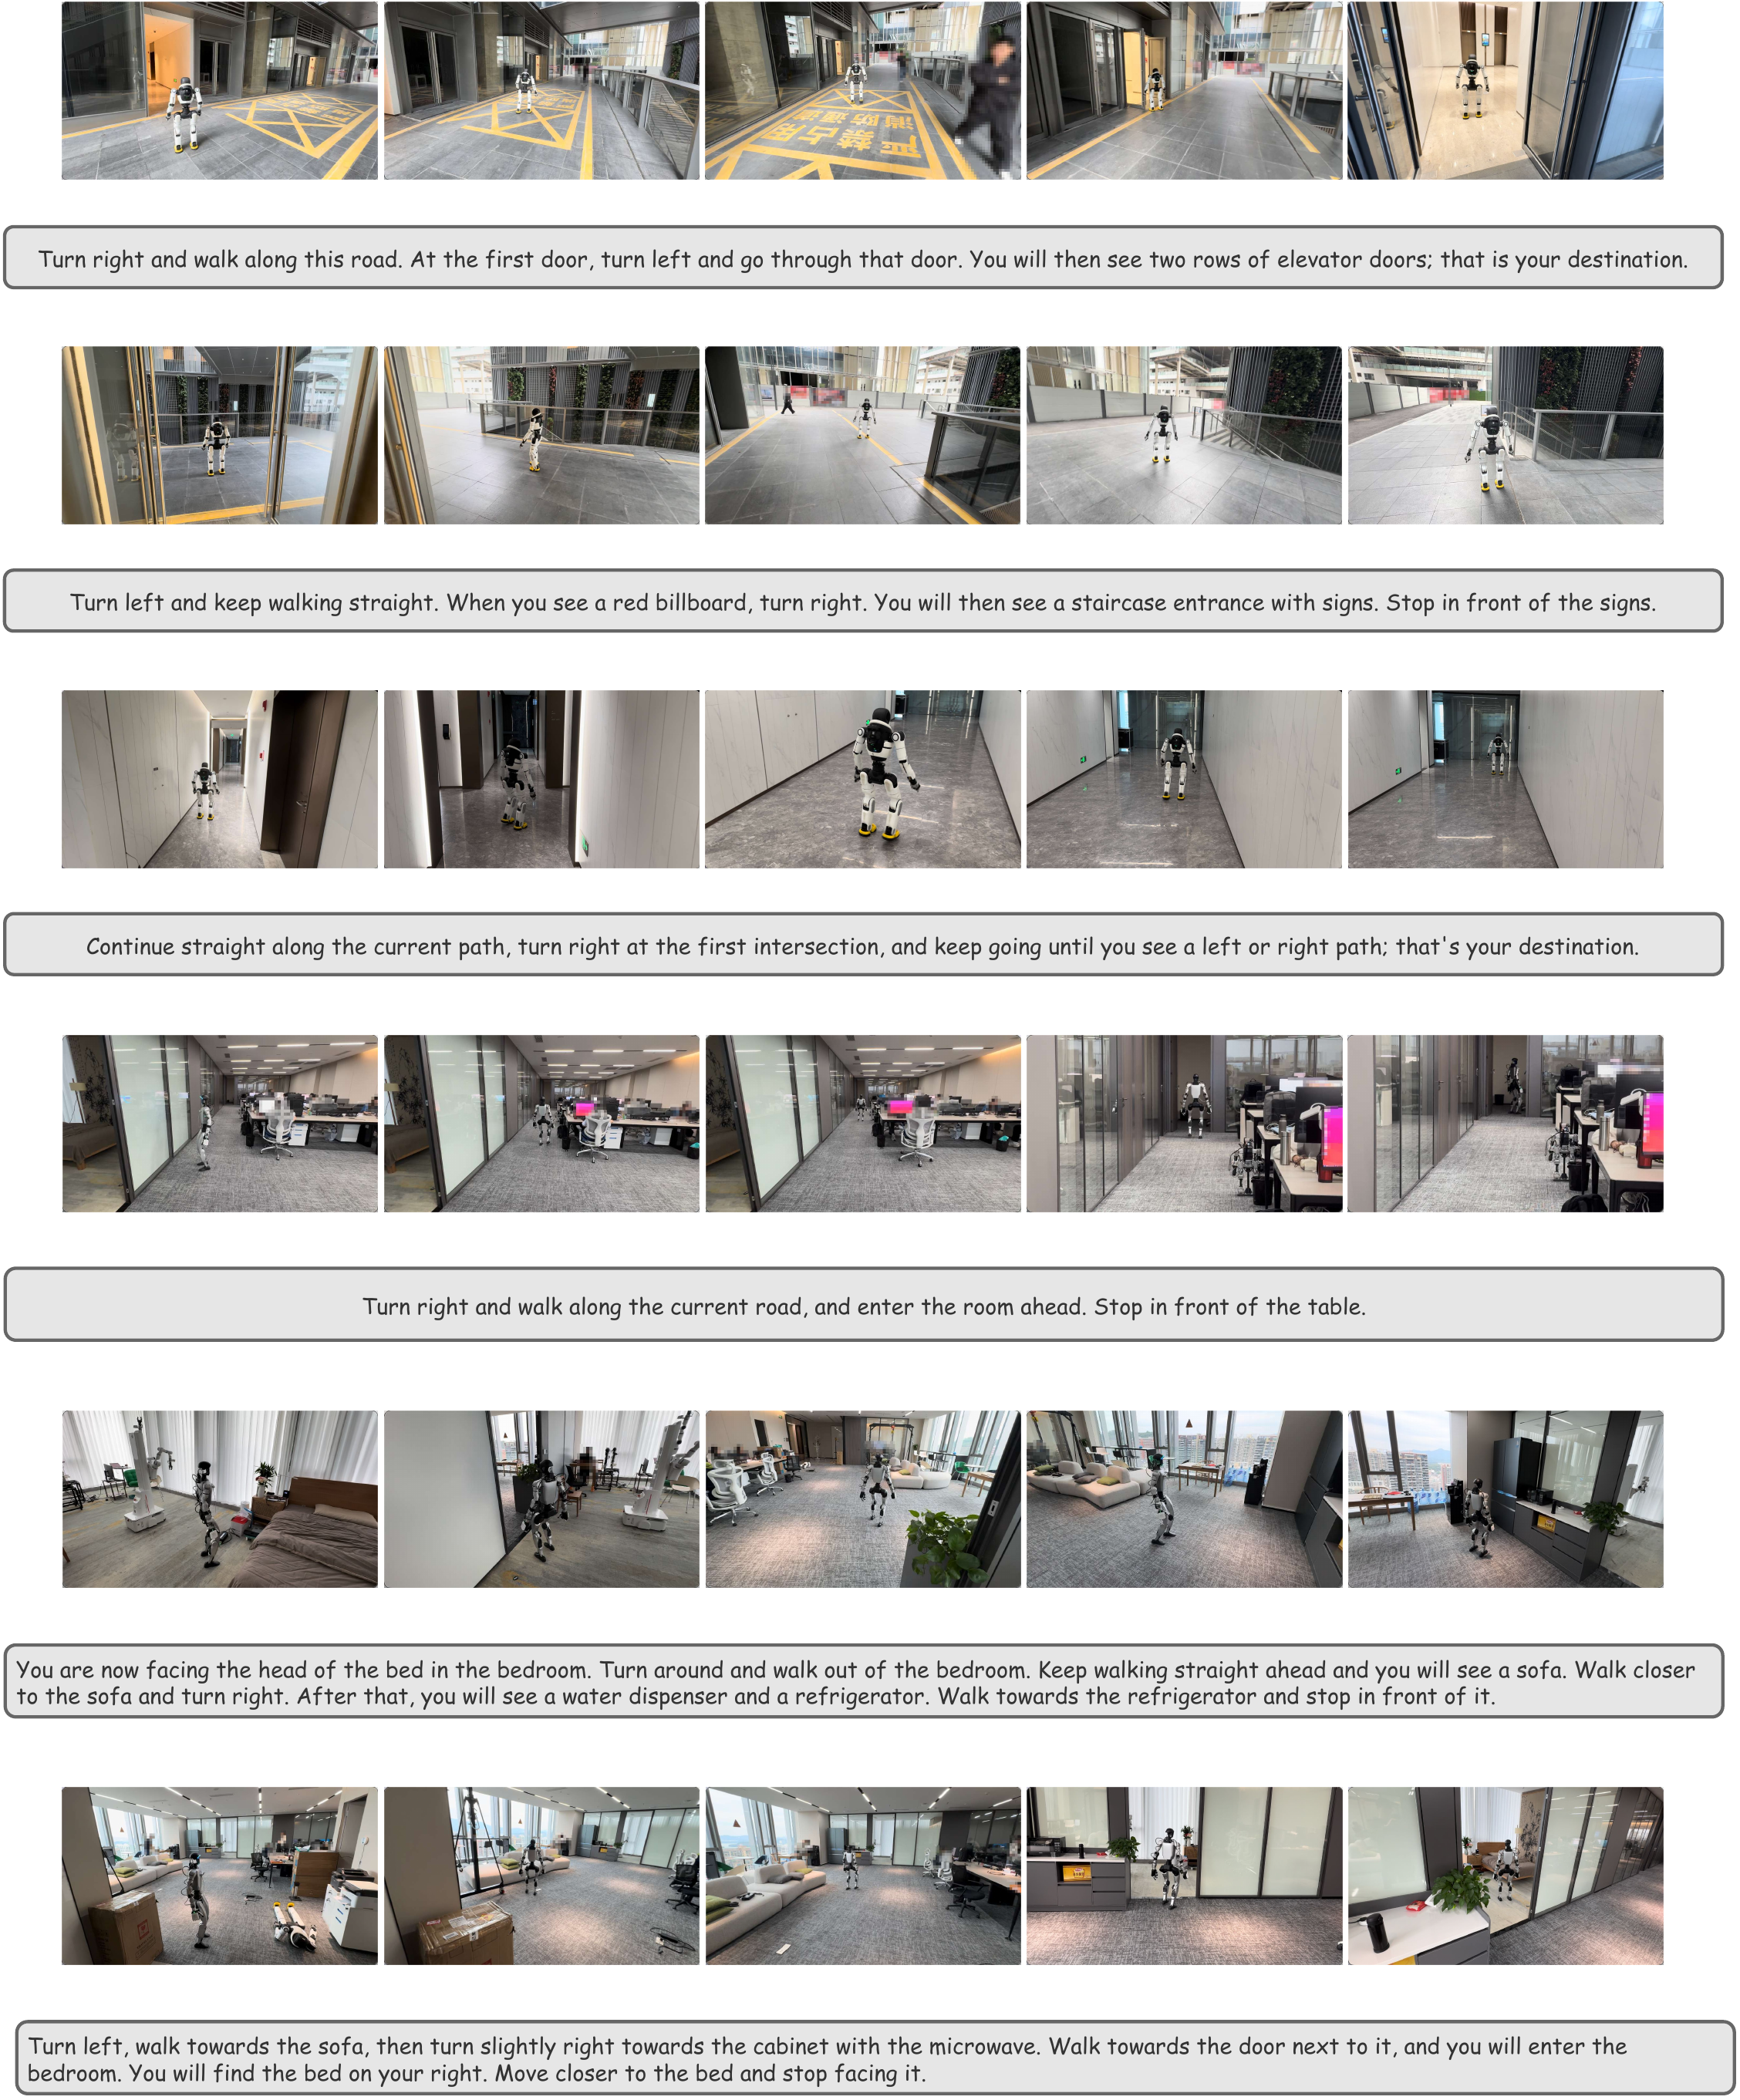
图:NaVIDA 在真实世界中的定性结果。
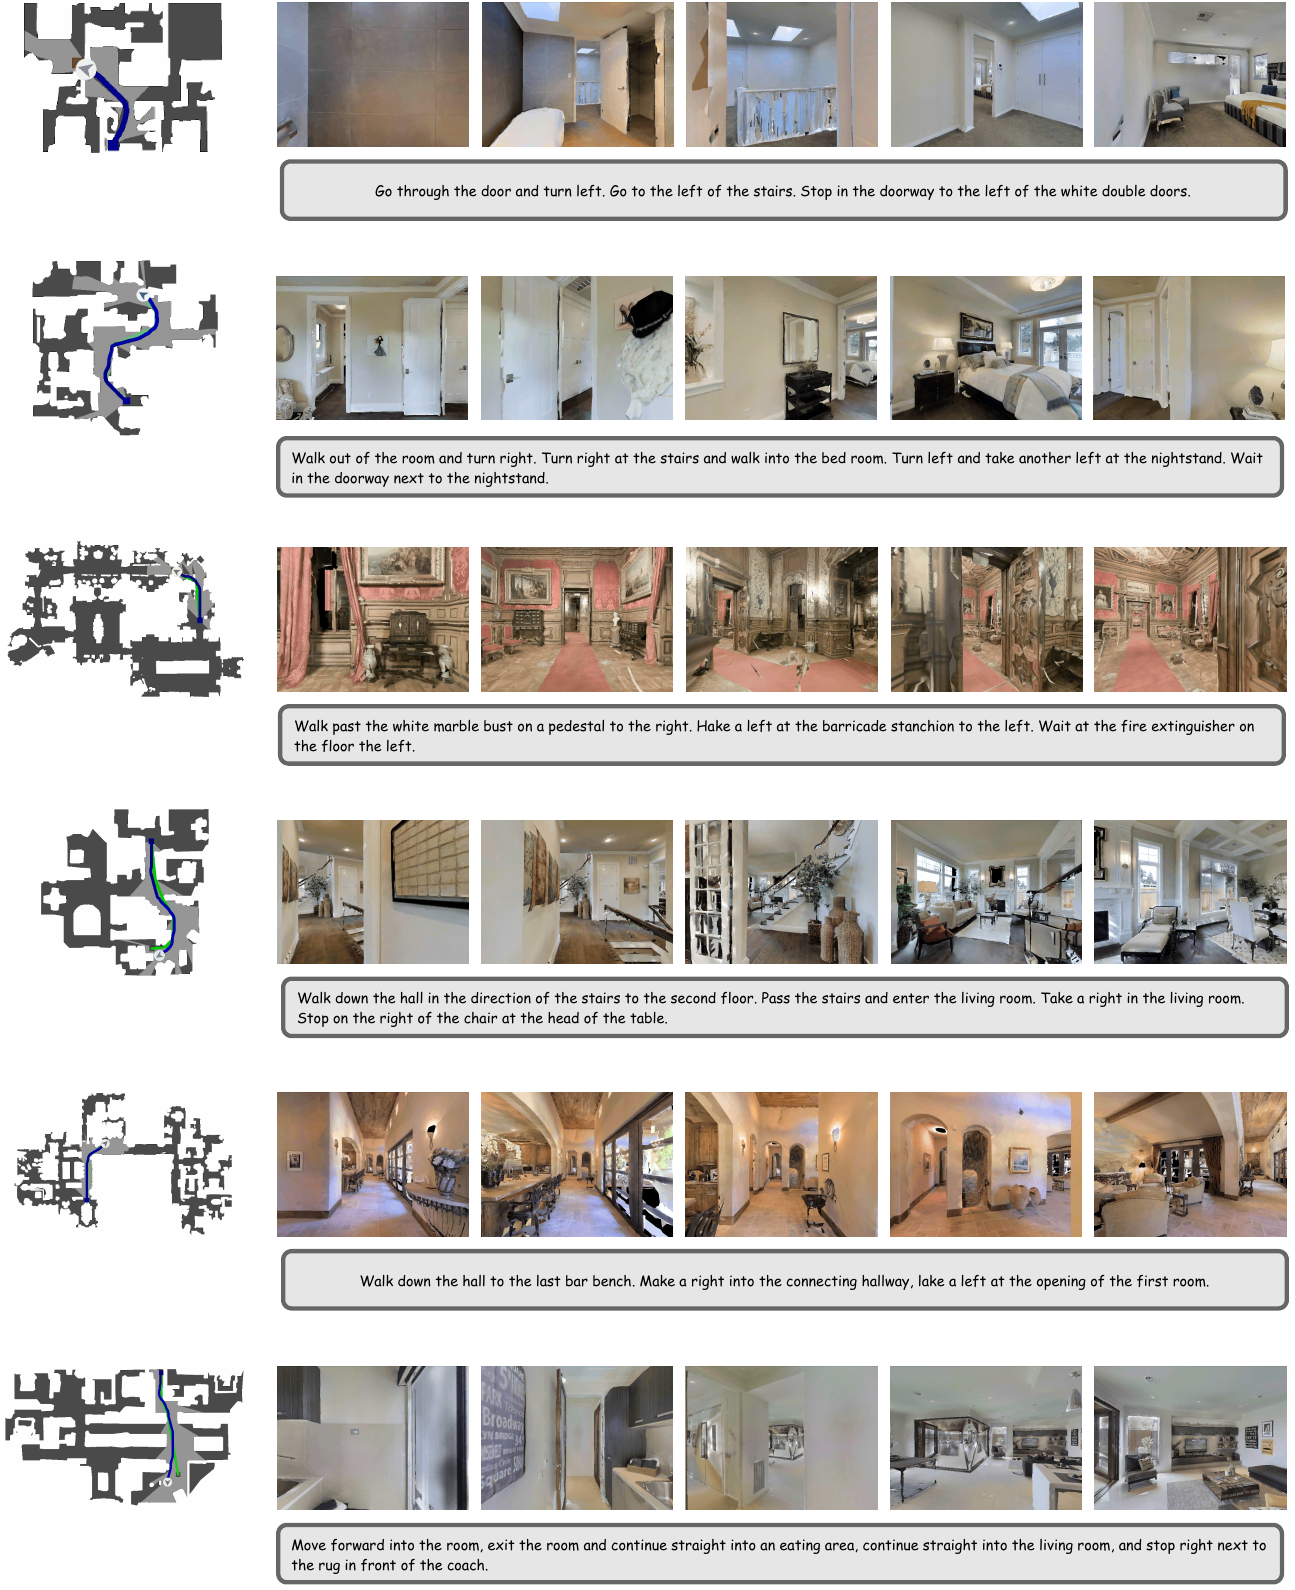
图:NaVIDA 在 VLN-CE R2R Val-Unseen 划分上的定性结果。
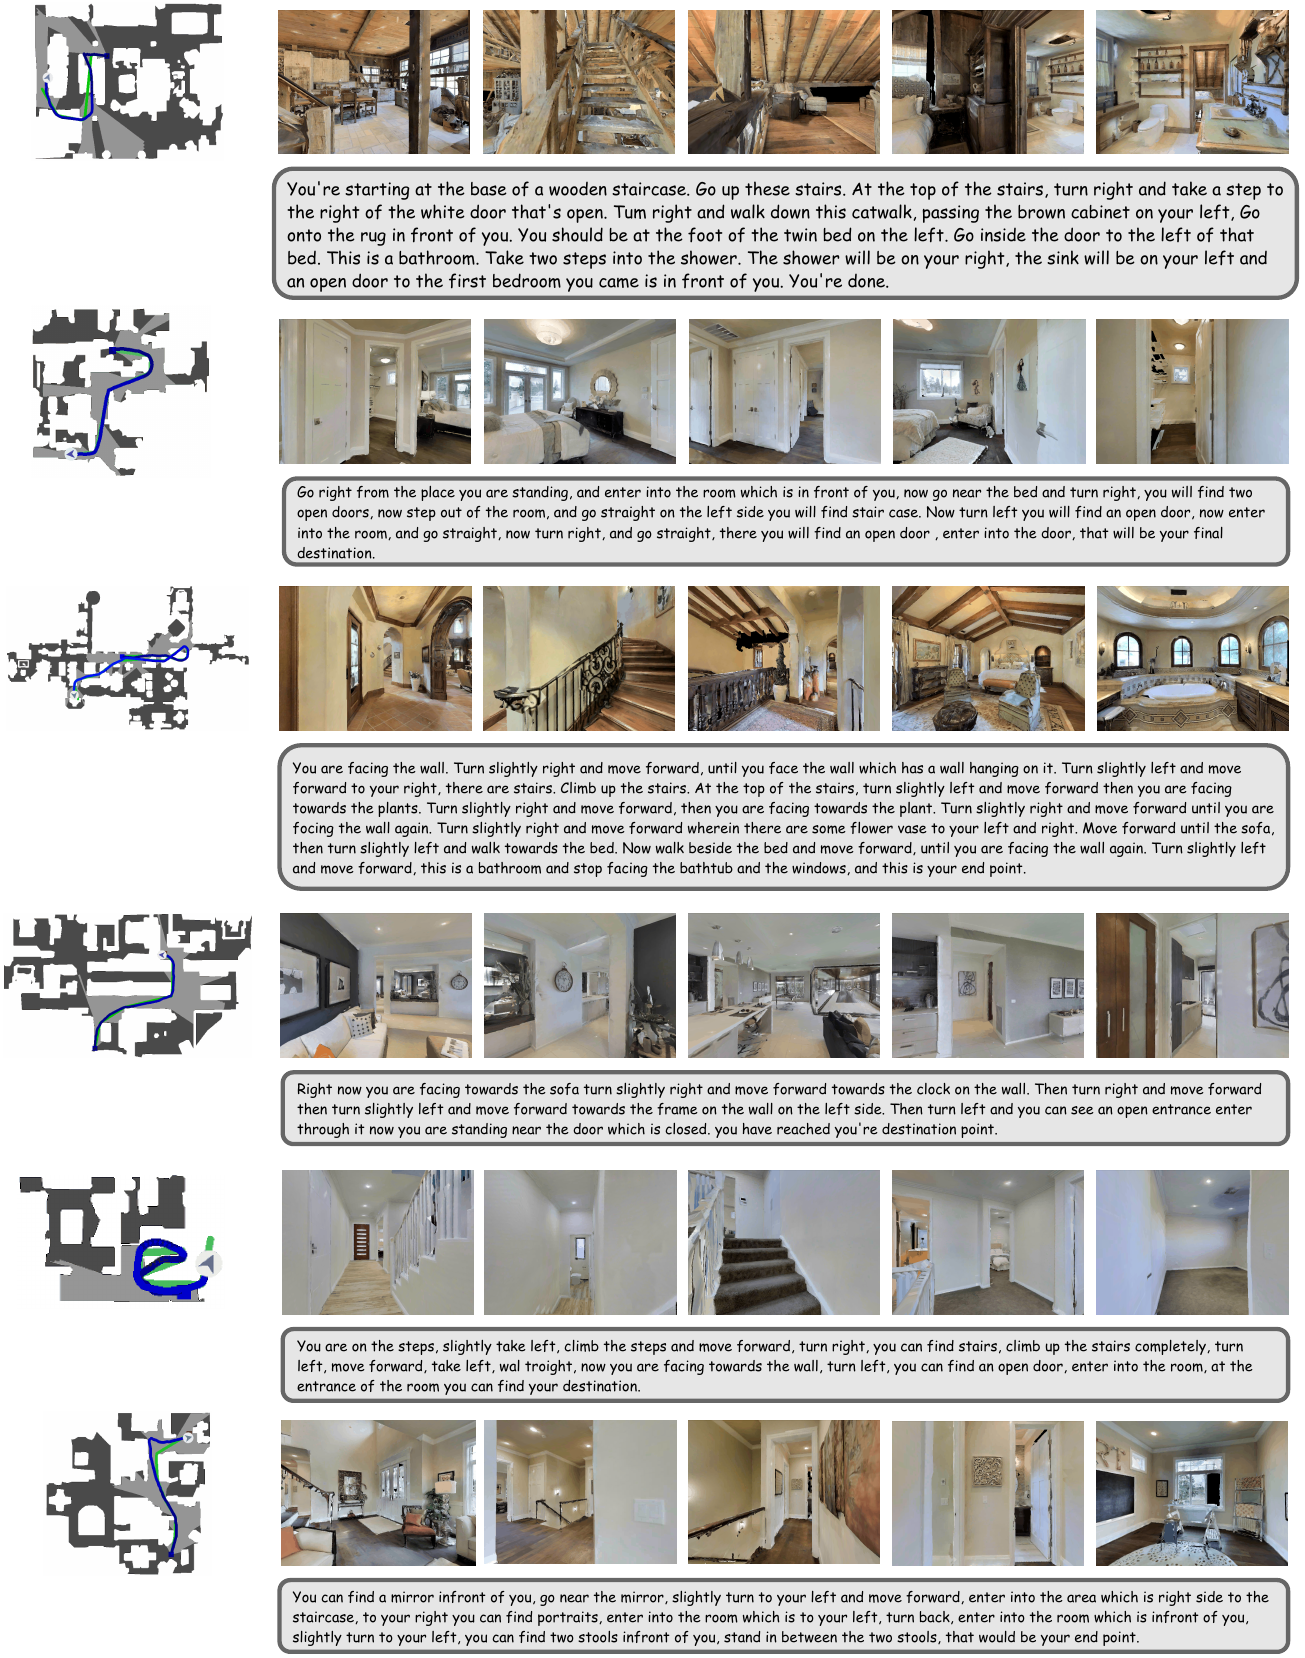
图:NaVIDA 在 VLN-CE RxR Val-Unseen 划分上的定性结果。
更多定性结果
我们在真实世界和仿真环境中展示了 NaVIDA 的大量定性结果,以进一步验证其有效性与泛化能力,如[fig:appendix_realworld]、[fig:appendix_r2r] 和[fig:appendix_rxr] 所示。结果表明,NaVIDA 在仿真中能够生成平滑且符合指令的轨迹,并能在真实世界场景中鲁棒地执行导航命令。这些发现凸显了模型强大的跨域泛化能力、准确的语言定位能力,以及在复杂长时域导航任务中可靠的决策能力。
参考文献
- [navid] Zhang, Jiazhao; Wang, Kunyu; Xu, Rongtao; Zhou, Gengze; Hong, Yicong; Fang, Xiaomeng; Wu, Qi; Zhang, Zhizheng; Wang, He. NaVid: Video-based VLM Plans the Next Step for Vision-and-Language Navigation. Robotics: Science and Systems. 2024.
- [uni-navid] Zhang, Jiazhao; Wang, Kunyu; Wang, Shaoan; Li, Minghan; Liu, Haoran; Wei, Songlin; Wang, Zhongyuan; Zhang, Zhizheng; Wang, He. Uni-NaVid: A Video-based Vision-Language-Action Model for Unifying Embodied Navigation Tasks. Robotics: Science and Systems. 2025.
- [navila] Cheng, An-Chieh; Ji, Yandong; Yang, Zhaojing; Zou, Xueyan; Kautz, Jan; Biyik, Erdem; Yin, Hongxu; Liu, Sifei; Wang, Xiaolong. NaVILA: Legged Robot Vision-Language-Action Model for Navigation. Robotics: Science and Systems. 2025.
- [monodream] Wang, Shuo; Wang, Yongcai; Li, Wanting; Wang, Yucheng; Chen, Maiyue; Wang, Kaihui; Su, Zhizhong; Cai, Xudong; Jin, Yeying; Li, Deying; others. Monodream: Monocular vision-language navigation with panoramic dreaming. arXiv preprint arXiv:2508.02549. 2025.
- [streamvln] Wei, Meng; Wan, Chenyang; Yu, Xiqian; Wang, Tai; Yang, Yuqiang; Mao, Xiaohan; Zhu, Chenming; Cai, Wenzhe; Wang, Hanqing; Chen, Yilun; others. Streamvln: Streaming vision-and-language navigation via slowfast context modeling. arXiv preprint arXiv:2507.05240. 2025.
- [idmpretrainlearnsbetter] Brandfonbrener, David; Nachum, Ofir; Bruna, Joan. Inverse dynamics pretraining learns good representations for multitask imitation. NIPS. 2023.
- [lamb2022guaranteed] Lamb, Alex; Islam, Riashat; Efroni, Yonathan; Didolkar, Aniket; Misra, Dipendra; Foster, Dylan; Molu, Lekan; Chari, Rajan; Krishnamurthy, Akshay; Langford, John. Guaranteed discovery of control-endogenous latent states with multi-step inverse models. arXiv preprint arXiv:2207.08229. 2022.
- [idmpretraininvln] Wu, Siying; Fu, Xueyang; Wu, Feng; Zha, Zheng-Jun. Vision-and-language navigation via latent semantic alignment learning. IEEE Transactions on Multimedia. 2024.
- [mpmvln] Dou, Zi-Yi; Gao, Feng; Peng, Nanyun. Masked path modeling for vision-and-language navigation. arXiv preprint arXiv:2305.14268. 2023.
- [vlnpredictfutureview] Li, Jialu; Bansal, Mohit. Improving vision-and-language navigation by generating future-view image semantics. Proceedings of the IEEE/CVF conference on computer vision and pattern recognition. 2023.
- [krantz2021waypoint] Krantz, Jacob; Gokaslan, Aaron; Batra, Dhruv; Lee, Stefan; Maksymets, Oleksandr. Waypoint models for instruction-guided navigation in continuous environments. Proceedings of the IEEE/CVF International Conference on Computer Vision. 2021.
- [hong2022bridging] Hong, Yicong; Wang, Zun; Wu, Qi; Gould, Stephen. Bridging the gap between learning in discrete and continuous environments for vision-and-language navigation. Proceedings of the IEEE/CVF conference on computer vision and pattern recognition. 2022.
- [krantz2022sim] Krantz, Jacob; Lee, Stefan. Sim-2-sim transfer for vision-and-language navigation in continuous environments. European conference on computer vision. 2022.
- [wang2023gridmm] Wang, Zihan; Li, Xiangyang; Yang, Jiahao; Liu, Yeqi; Jiang, Shuqiang. Gridmm: Grid memory map for vision-and-language navigation. Proceedings of the IEEE/CVF International conference on computer vision. 2023.
- [an2024etpnav] An, Dong; Wang, Hanqing; Wang, Wenguan; Wang, Zun; Huang, Yan; He, Keji; Wang, Liang. Etpnav: Evolving topological planning for vision-language navigation in continuous environments. IEEE Transactions on Pattern Analysis and Machine Intelligence. 2024.
- [wang2023scaling] Wang, Zun; Li, Jialu; Hong, Yicong; Wang, Yi; Wu, Qi; Bansal, Mohit; Gould, Stephen; Tan, Hao; Qiao, Yu. Scaling data generation in vision-and-language navigation. Proceedings of the IEEE/CVF international conference on computer vision. 2023.
- [long2024instructnav] Long, Yuxing; Cai, Wenzhe; Wang, Hongcheng; Zhan, Guanqi; Dong, Hao. Instructnav: Zero-shot system for generic instruction navigation in unexplored environment. arXiv preprint arXiv:2406.04882. 2024.
- [navfom] Zhang, Jiazhao; Li, Anqi; Qi, Yunpeng; Li, Minghan; Liu, Jiahang; Wang, Shaoan; Liu, Haoran; Zhou, Gengze; Wu, Yuze; Li, Xingxing; others. Embodied navigation foundation model. arXiv preprint arXiv:2509.12129. 2025.
- [janusvln] Zeng, Shuang; Qi, Dekang; Chang, Xinyuan; Xiong, Feng; Xie, Shichao; Wu, Xiaolong; Liang, Shiyi; Xu, Mu; Wei, Xing. Janusvln: Decoupling semantics and spatiality with dual implicit memory for vision-language navigation. arXiv preprint arXiv:2509.22548. 2025.
- [internnav2025] InternNav Contributors. InternNav: InternRobotics' open platform for building generalized navigation foundation models. 2025.
- [navmorph] Yao, Xuan; Gao, Junyu; Xu, Changsheng. NavMorph: A Self-Evolving World Model for Vision-and-Language Navigation in Continuous Environments. arXiv preprint arXiv:2506.23468. 2025.
- [law] Raychaudhuri, Sonia; Wani, Saim; Patel, Shivansh; Jain, Unnat; Chang, Angel X. Language-aligned waypoint (law) supervision for vision-and-language navigation in continuous environments. arXiv preprint arXiv:2109.15207. 2021.
- [cm2] Georgakis, Georgios; Schmeckpeper, Karl; Wanchoo, Karan; Dan, Soham; Miltsakaki, Eleni; Roth, Dan; Daniilidis, Kostas. Cross-modal map learning for vision and language navigation. Proceedings of the IEEE/CVF conference on computer vision and pattern recognition. 2022.
- [eptnavff] Wang, Zihan; Li, Xiangyang; Yang, Jiahao; Liu, Yeqi; Jiang, Shuqiang. Sim-to-real transfer via 3d feature fields for vision-and-language navigation. arXiv preprint arXiv:2406.09798. 2024.
- [vlnce] Krantz, Jacob; Wijmans, Erik; Majumdar, Arjun; Batra, Dhruv; Lee, Stefan. Beyond the nav-graph: Vision-and-language navigation in continuous environments. European Conference on Computer Vision. 2020.
- [hong2021vln] Hong, Yicong; Wu, Qi; Qi, Yuankai; Rodriguez-Opazo, Cristian; Gould, Stephen. Vln bert: A recurrent vision-and-language bert for navigation. Proceedings of the IEEE/CVF conference on Computer Vision and Pattern Recognition. 2021.
- [chen2021history] Chen, Shizhe; Guhur, Pierre-Louis; Schmid, Cordelia; Laptev, Ivan. History aware multimodal transformer for vision-and-language navigation. Advances in neural information processing systems. 2021.
- [liu2023bird] Liu, Rui; Wang, Xiaohan; Wang, Wenguan; Yang, Yi. Bird's-eye-view scene graph for vision-language navigation. Proceedings of the IEEE/CVF International Conference on Computer Vision. 2023.
- [an2022bevbert] An, Dong; Qi, Yuankai; Li, Yangguang; Huang, Yan; Wang, Liang; Tan, Tieniu; Shao, Jing. Bevbert: Multimodal map pre-training for language-guided navigation. arXiv preprint arXiv:2212.04385. 2022.
- [dai2024unitedvln] Dai, Guangzhao; Zhao, Jian; Chen, Yuantao; Qin, Yusen; Zhao, Hao; Xie, Guosen; Yao, Yazhou; Shu, Xiangbo; Li, Xuelong. Unitedvln: Generalizable gaussian splatting for continuous vision-language navigation. arXiv preprint arXiv:2411.16053. 2024.
- [nguyen2019vision] Nguyen, Khanh; Dey, Debadeepta; Brockett, Chris; Dolan, Bill. Vision-based navigation with language-based assistance via imitation learning with indirect intervention. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2019.
- [wang2022towards] Wang, Hanqing; Liang, Wei; Gool, Luc V; Wang, Wenguan. Towards versatile embodied navigation. Advances in neural information processing systems. 2022.
- [wu2020towards] Wu, Qiaoyun; Gong, Xiaoxi; Xu, Kai; Manocha, Dinesh; Dong, Jingxuan; Wang, Jun. Towards target-driven visual navigation in indoor scenes via generative imitation learning. IEEE Robotics and Automation Letters. 2020.
- [schumann2024velma] Schumann, Raphael; Zhu, Wanrong; Feng, Weixi; Fu, Tsu-Jui; Riezler, Stefan; Wang, William Yang. Velma: Verbalization embodiment of llm agents for vision and language navigation in street view. Proceedings of the AAAI Conference on Artificial Intelligence. 2024.
- [black2025real] Black, Kevin; Galliker, Manuel Y; Levine, Sergey. Real-Time Execution of Action Chunking Flow Policies. arXiv preprint arXiv:2506.07339. 2025.
- [zhang2025cross] Zhang, Pingrui; Su, Yifei; Wu, Pengyuan; An, Dong; Zhang, Li; Wang, Zhigang; Wang, Dong; Ding, Yan; Zhao, Bin; Li, Xuelong. Cross from Left to Right Brain: Adaptive Text Dreamer for Vision-and-Language Navigation. arXiv preprint arXiv:2505.20897. 2025.
- [huang2025vista] Huang, Yanjia; Wu, Mingyang; Li, Renjie; Tu, Zhengzhong. VISTA: Generative Visual Imagination for Vision-and-Language Navigation. arXiv preprint arXiv:2505.07868. 2025.
- [aux-think] Wang, Shuo; Wang, Yongcai; Li, Wanting; Cai, Xudong; Wang, Yucheng; Chen, Maiyue; Wang, Kaihui; Su, Zhizhong; Li, Deying; Fan, Zhaoxin. Aux-Think: Exploring Reasoning Strategies for Data-Efficient Vision-Language Navigation. arXiv preprint arXiv:2505.11886. 2025.
- [habitat] Savva, Manolis; Kadian, Abhishek; Maksymets, Oleksandr; Zhao, Yili; Wijmans, Erik; Jain, Bhavana; Straub, Julian; Liu, Jia; Koltun, Vladlen; Malik, Jitendra; others. Habitat: A platform for embodied ai research. Proceedings of the IEEE/CVF international conference on computer vision. 2019.
- [vlnpe] Wang, Liuyi; Xia, Xinyuan; Zhao, Hui; Wang, Hanqing; Wang, Tai; Chen, Yilun; Liu, Chengju; Chen, Qijun; Pang, Jiangmiao. Rethinking the embodied gap in vision-and-language navigation: A holistic study of physical and visual disparities. Proceedings of the IEEE/CVF International Conference on Computer Vision. 2025.
- [qwen2_5] Bai, Shuai; Chen, Keqin; Liu, Xuejing; Wang, Jialin; Ge, Wenbin; Song, Sibo; Dang, Kai; Wang, Peng; Wang, Shijie; Tang, Jun; others. Qwen2. 5-vl technical report. arXiv preprint arXiv:2502.13923. 2025.
- [wang2023dreamwalker] Wang, Hanqing; Liang, Wei; Van Gool, Luc; Wang, Wenguan. Dreamwalker: Mental planning for continuous vision-language navigation. Proceedings of the IEEE/CVF international conference on computer vision. 2023.
- [wang2024lookahead] Wang, Zihan; Li, Xiangyang; Yang, Jiahao; Liu, Yeqi; Hu, Junjie; Jiang, Ming; Jiang, Shuqiang. Lookahead exploration with neural radiance representation for continuous vision-language navigation. Proceedings of the IEEE/CVF conference on computer vision and pattern recognition. 2024.
- [internvl3] Zhu, Jinguo; Wang, Weiyun; Chen, Zhe; Liu, Zhaoyang; Ye, Shenglong; Gu, Lixin; Tian, Hao; Duan, Yuchen; Su, Weijie; Shao, Jie; others. Internvl3: Exploring advanced training and test-time recipes for open-source multimodal models. arXiv preprint arXiv:2504.10479. 2025.
- [nvila] Liu, Zhijian; Zhu, Ligeng; Shi, Baifeng; Zhang, Zhuoyang; Lou, Yuming; Yang, Shang; Xi, Haocheng; Cao, Shiyi; Gu, Yuxian; Li, Dacheng; others. Nvila: Efficient frontier visual language models. Proceedings of the Computer Vision and Pattern Recognition Conference. 2025.
- [llava-video] Zhang, Yuanhan; Wu, Jinming; Li, Wei; Li, Bo; Ma, Zejun; Liu, Ziwei; Li, Chunyuan. Video instruction tuning with synthetic data. arXiv preprint arXiv:2410.02713. 2024.
- [chi2025diffusion] Chi, Cheng; Xu, Zhenjia; Feng, Siyuan; Cousineau, Eric; Du, Yilun; Burchfiel, Benjamin; Tedrake, Russ; Song, Shuran. Diffusion policy: Visuomotor policy learning via action diffusion. The International Journal of Robotics Research. 2025.
- [cai2025navdp] Cai, Wenzhe; Peng, Jiaqi; Yang, Yuqiang; Zhang, Yujian; Wei, Meng; Wang, Hanqing; Chen, Yilun; Wang, Tai; Pang, Jiangmiao. NavDP: Learning Sim-to-Real Navigation Diffusion Policy with Privileged Information Guidance. arXiv preprint arXiv:2505.08712. 2025.
- [wang2025dreamnav] Wang, Yunheng; Fang, Yuetong; Wang, Taowen; Feng, Yixiao; Tan, Yawen; Zhang, Shuning; Liu, Peiran; Ji, Yiding; Xu, Renjing. DreamNav: A Trajectory-Based Imaginative Framework for Zero-Shot Vision-and-Language Navigation. arXiv preprint arXiv:2509.11197. 2025.
- [dagger] Ross, Stéphane; Gordon, Geoffrey; Bagnell, Drew. A reduction of imitation learning and structured prediction to no-regret online learning. Proceedings of the fourteenth international conference on artificial intelligence and statistics. 2011.
- [r2r] Anderson, Peter; Wu, Qi; Teney, Damien; Bruce, Jake; Johnson, Mark; Sünderhauf, Niko; Reid, Ian; Gould, Stephen; Van Den Hengel, Anton. Vision-and-language navigation: Interpreting visually-grounded navigation instructions in real environments. Proceedings of the IEEE conference on computer vision and pattern recognition. 2018.
- [rxr] Ku, Alexander; Anderson, Peter; Patel, Roma; Ie, Eugene; Baldridge, Jason. Room-across-room: Multilingual vision-and-language navigation with dense spatiotemporal grounding. arXiv preprint arXiv:2010.07954. 2020.
- [zhang2025activevln] Zhang, Zekai; Zhu, Weiye; Pan, Hewei; Wang, Xiangchen; Xu, Rongtao; Sun, Xing; Zheng, Feng. ActiveVLN: Towards Active Exploration via Multi-Turn RL in Vision-and-Language Navigation. arXiv preprint arXiv:2509.12618. 2025.
- [dinov2] Oquab, Maxime; Darcet, Timothée; Moutakanni, Théo; Vo, Huy; Szafraniec, Marc; Khalidov, Vasil; Fernandez, Pierre; Haziza, Daniel; Massa, Francisco; El-Nouby, Alaaeldin; others. Dinov2: Learning robust visual features without supervision. arXiv preprint arXiv:2304.07193. 2023.