VGGT:以视觉几何为基础的 Transformer
原文标题:VGGT: Visual Geometry Grounded Transformer
作者:Jianyuan Wang、Minghao Chen、Nikita Karaev、Andrea Vedaldi、Christian Rupprecht、David Novotny
机构:牛津大学视觉几何组、Meta AI
会议:CVPR 2025
原文:https://arxiv.org/abs/2503.11651
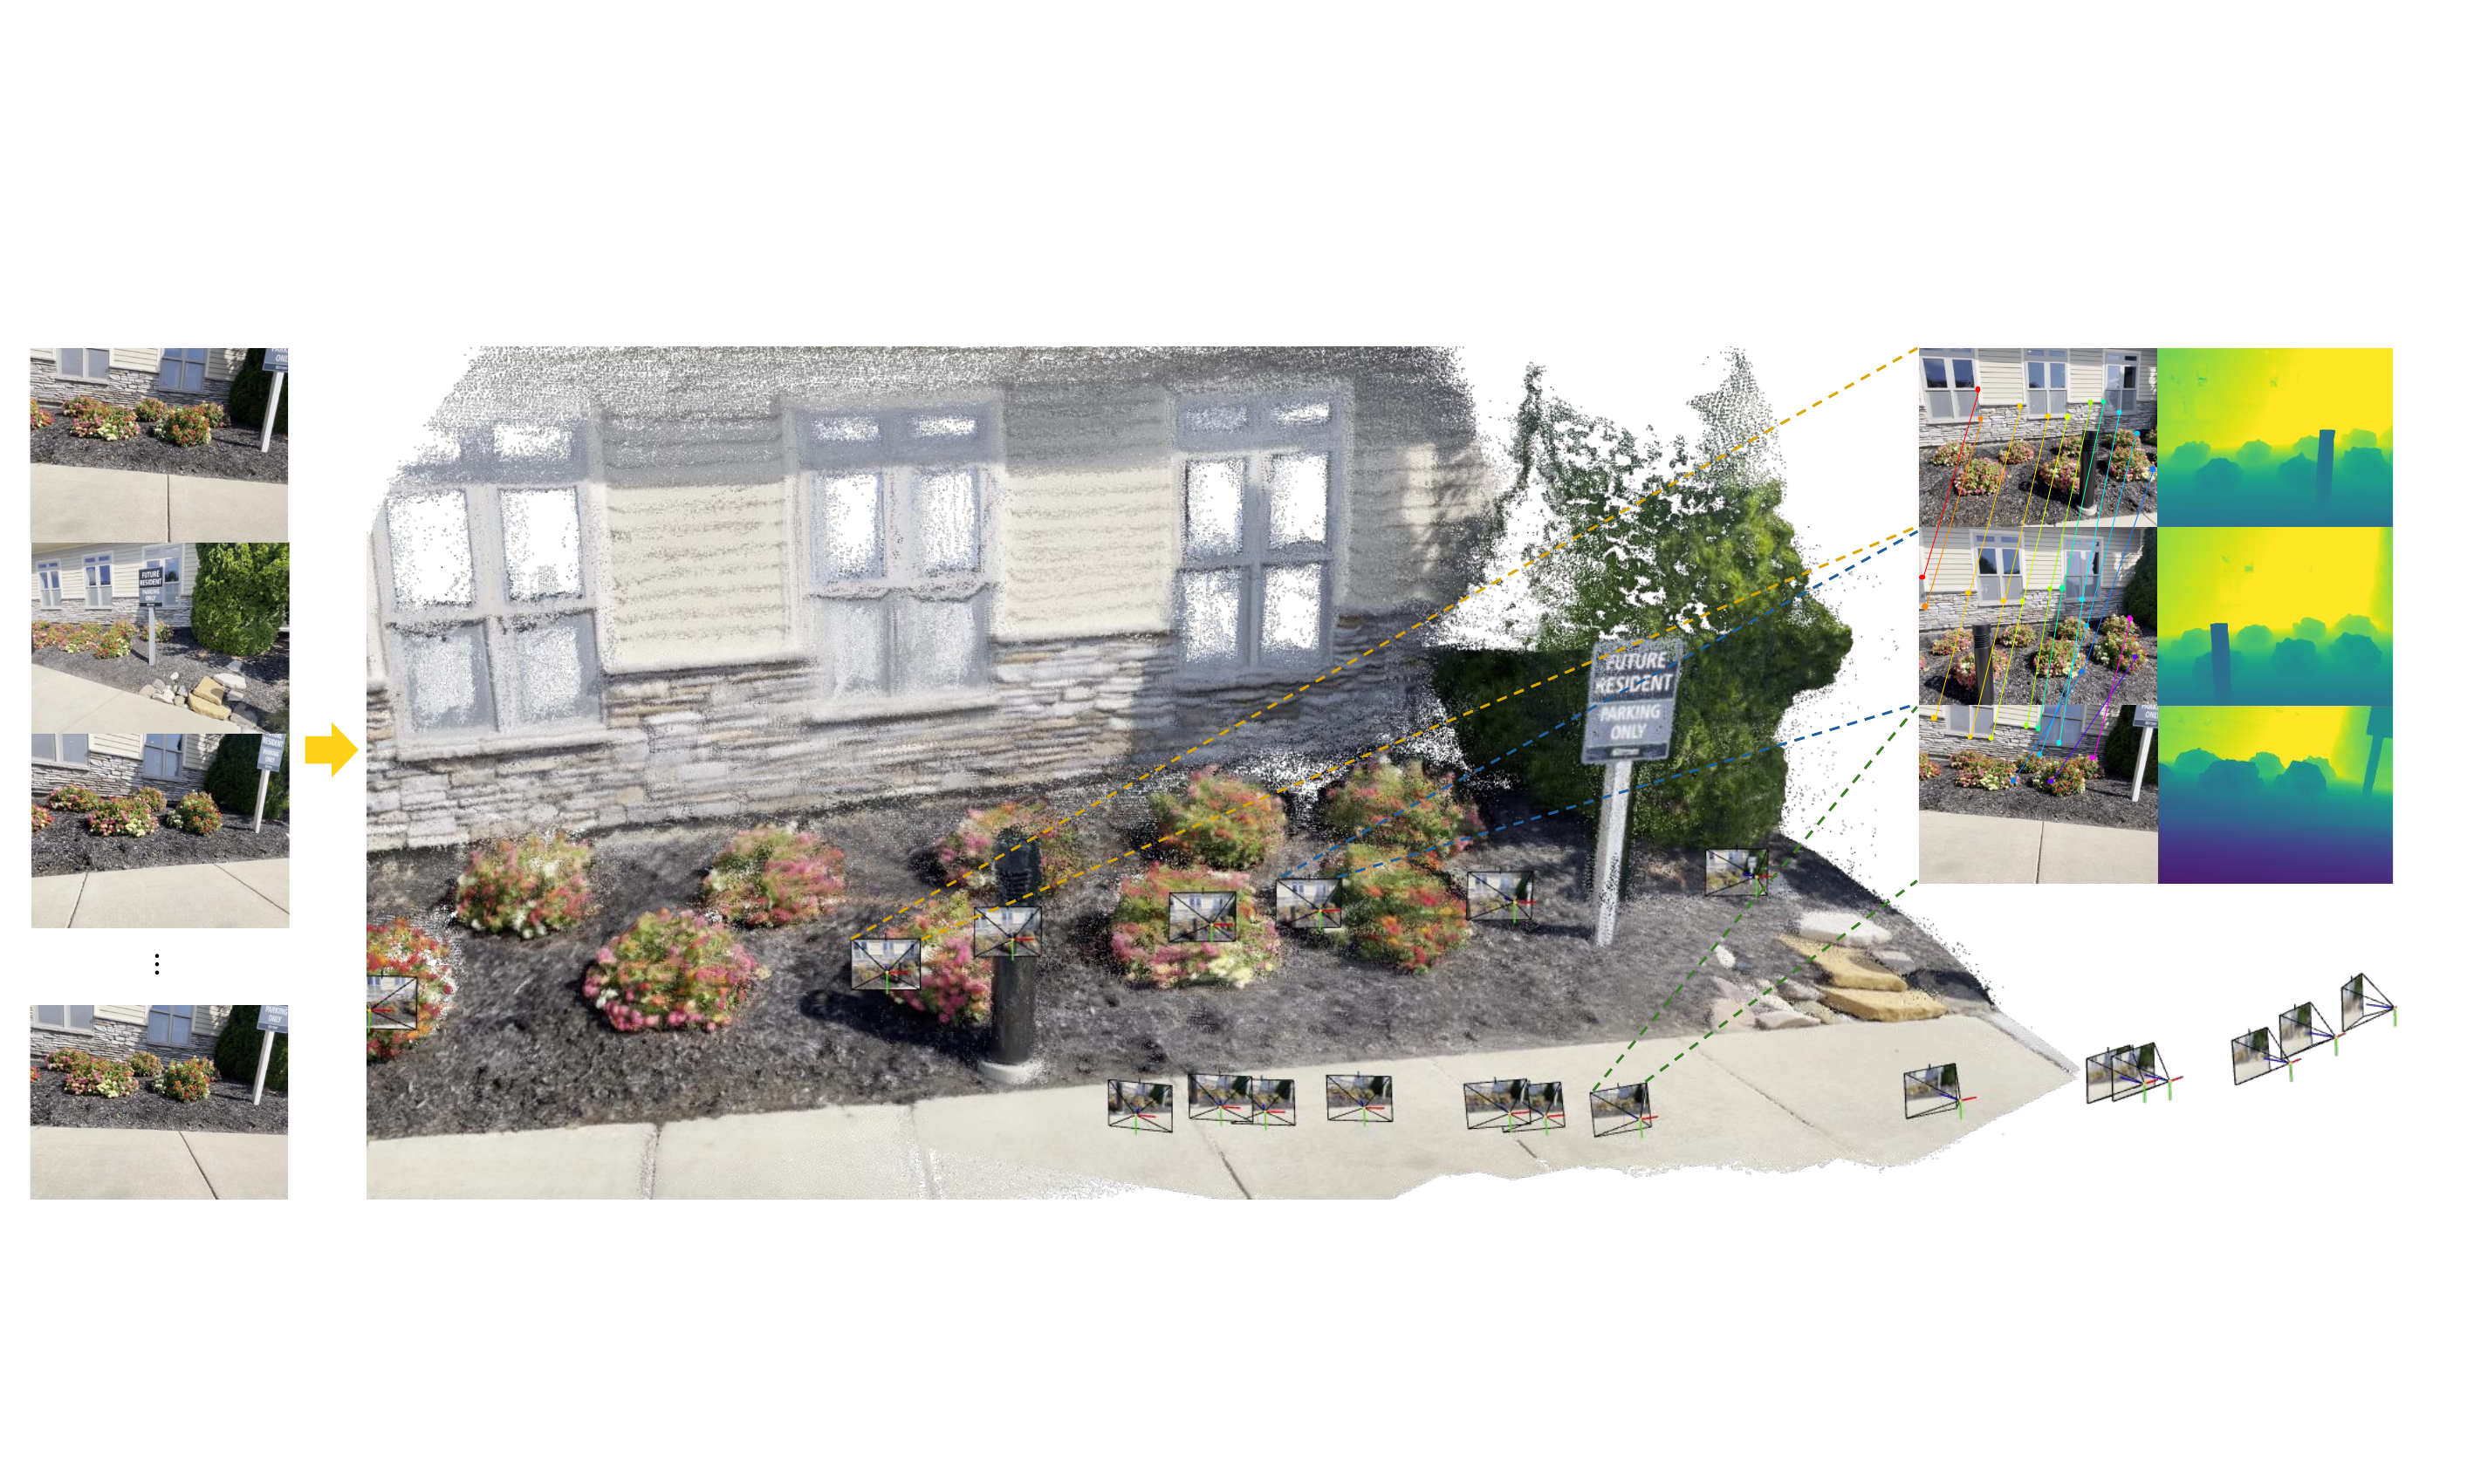
图:VGGT 是一个仅含少量三维归纳偏置的大型前馈 Transformer,使用海量带三维标注的数据训练。它可接收多达数百张图像,并在一次前向传播中预测相机参数、点图、深度图和点轨迹。
摘要
本文提出VGGT,这是一种前馈(Feed-forward)神经网络,可从场景的一张、少量乃至数百张视图中,直接推断场景的所有关键三维属性,包括相机参数、点图(Point Map)、深度图和三维点轨迹。 这一方法推动了三维计算机视觉的发展;以往模型通常受限于单项任务,且专门为其设计。 该方法简洁高效,可在一秒内完成图像重建,其性能仍优于需要视觉几何优化技术进行后处理的替代方案。
该网络在多项三维任务上取得了当前最佳结果,包括相机参数估计、多视图深度估计、稠密点云重建和三维点跟踪。
实验还表明,将预训练的VGGT用作特征骨干网络(Feature Backbone),可显著增强非刚性点跟踪和前馈新视角合成(Feed-forward Novel View Synthesis)等下游任务。
代码和模型已公开发布于 https://github.com/facebookresearch/vggt。
引言
本文研究如何利用前馈神经网络,从一组图像中估计场景的三维属性。 传统三维重建采用视觉几何方法,并使用光束法平差(Bundle Adjustment,BA) [hartley_multiple_2000] 等迭代优化技术。 机器学习常作为重要补充,用于解决仅凭几何无法处理的任务,例如特征匹配和单目深度预测。 二者的结合日益紧密;如今,VGGSfM [wang24vggsfm:] 等当前最佳的运动恢复结构(Structure-from-Motion,SfM)方法通过可微 BA,将机器学习与视觉几何端到端结合起来。 即便如此,视觉几何在三维重建中仍然占据重要地位,增加了系统复杂度和计算成本。
随着网络能力不断增强,一个自然的问题是:能否最终由神经网络直接解决三维任务,几乎完全免除几何后处理? 近期的DUSt3R [wang24dust3r:] 及其后续方法MASt3R [mast3r] 在这一方向展现出良好前景,但这些网络每次只能处理两张图像;要重建更多图像,仍须依赖后处理融合成对重建结果。
本文朝着消除三维几何后处理优化的目标更进一步。 为此,本文提出以视觉几何为基础的 Transformer(Visual Geometry Grounded Transformer,VGGT),这是一种前馈神经网络,可从场景的一张、少量乃至数百张输入视图完成三维重建。 VGGT预测完整的三维属性,包括相机参数、深度图、点图和三维点轨迹。 上述预测通过单次前向传播即可在数秒内完成。 即使不作进一步处理,其性能通常也优于基于优化的替代方案。 这与DUSt3R、MASt3R和 VGGSfM 有显著区别:后者仍需代价高昂的迭代后优化才能获得可用结果。
实验还表明,无须为三维重建设计专用网络。 VGGT基于相当标准的大型 Transformer [vaswani17attention],除交替采用帧内注意力(Frame-wise Attention)与全局注意力(Global Attention)外,不包含特定的三维或其他归纳偏置;模型在大量公开的三维标注数据集上训练。 因此,VGGT沿用了自然语言处理和计算机视觉大模型的设计思路,例如 GPT [yenduri23generative,dubey24the-llama,achiam2023gpt]、CLIP [radford21learning]、DINO [caron21emerging,oquab24dinov2:] 和 Stable Diffusion [esser21taming]。 这些模型已成为用途广泛的骨干网络,可通过微调解决新的特定任务。 与之类似,本文表明VGGT计算的特征可显著增强动态视频点跟踪和新视角合成等下游任务。
近期已有多种大型三维神经网络,例如 DepthAnything [yang24depth]、MoGe [wang24moge:] 和 LRM [hong24lrm:]。 然而,这些模型仅关注单项三维任务,例如单目深度估计或新视角合成。 相比之下,VGGT使用共享骨干网络,联合预测所有关注的三维量。 实验表明,尽管这些属性之间可能存在冗余,通过学习联合预测相互关联的三维属性仍能提高整体准确率。 与此同时,在推理阶段,可由分别预测的深度与相机参数推导点图,相比直接采用专用点图头,准确率更高。
综上,本文贡献如下: (1) 提出VGGT,一种大型前馈 Transformer;输入场景的一张、少量乃至数百张图像后,可在数秒内预测其全部关键三维属性,包括相机内参与外参、点图、深度图和三维点轨迹。 (2) 证明VGGT的预测结果可直接使用:与采用缓慢后处理优化技术的当前最佳方法相比,其竞争力很强,且通常表现更优。 (3) 进一步结合 BA 后处理后,VGGT在各项任务上均取得当前最佳结果;即便与专攻部分三维任务的方法相比,也常能显著提高质量。
代码和模型已公开发布于 https://github.com/facebookresearch/vggt。
我们相信,这将推动该方向的进一步研究,并为快速、可靠且通用的三维重建提供新的基础,从而惠及计算机视觉社区。
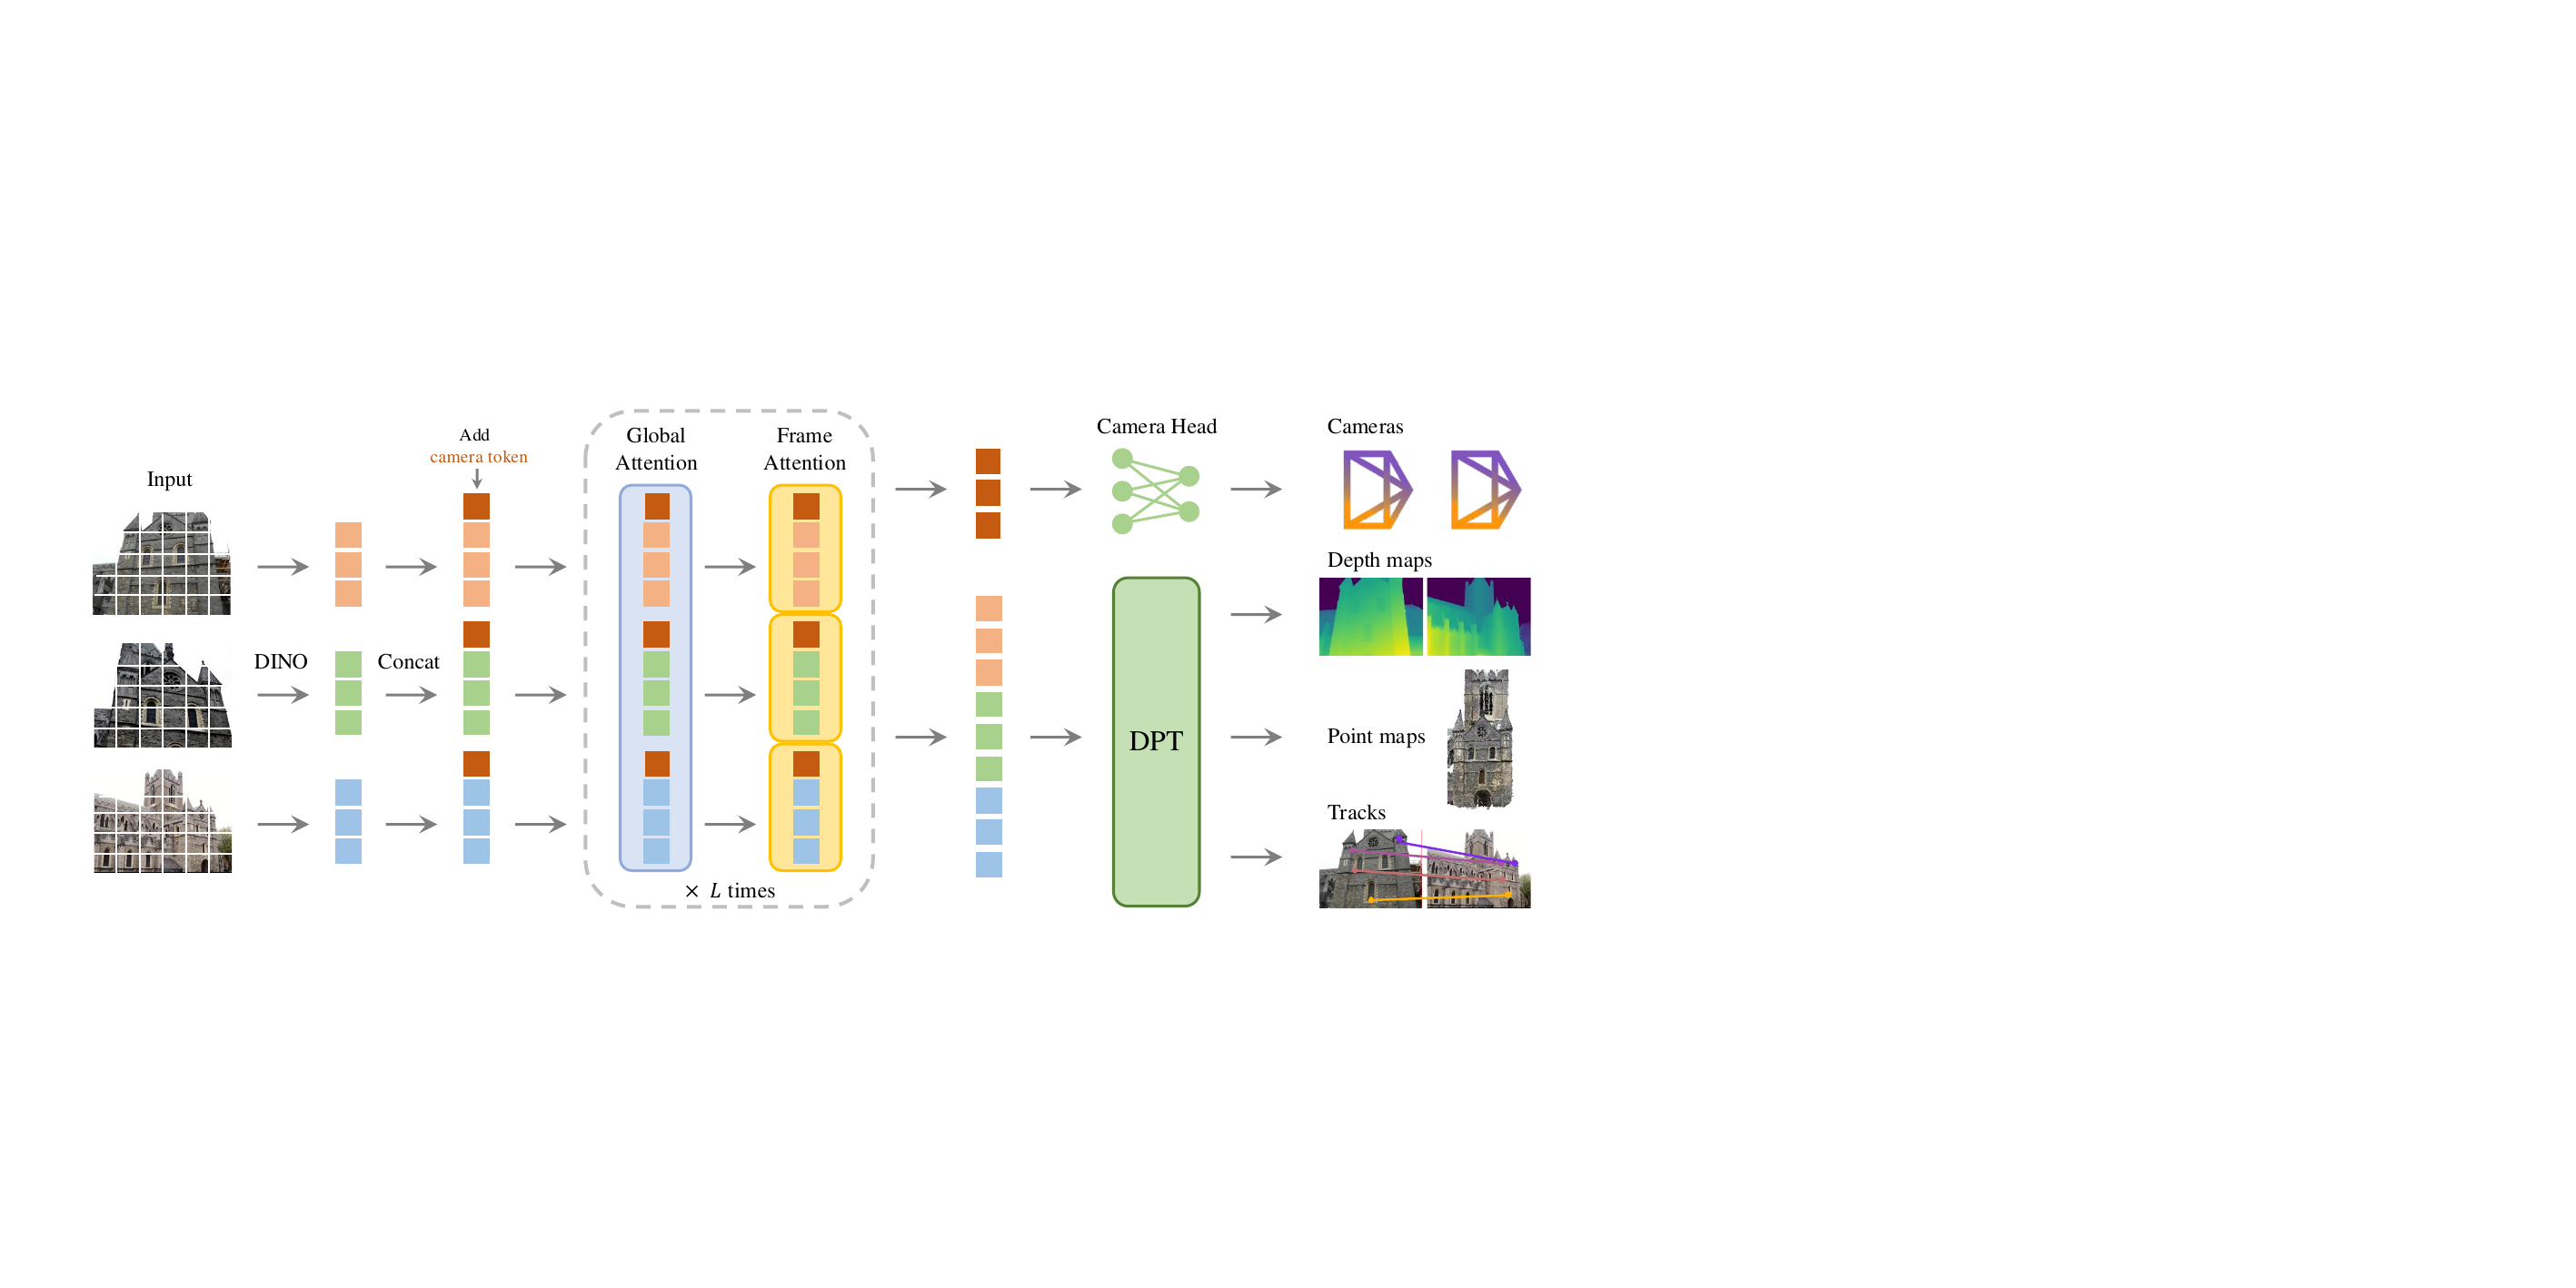
图:架构概览。 模型首先使用 DINO 将输入图像划分为图像块并转换为词元,随后附加相机词元以预测相机。 接着,模型交替使用帧内自注意力层和全局自注意力层。 相机头最终预测相机外参与内参,而 DPT [ranftl21dpt] 头负责生成各类稠密输出。
相关工作
运动恢复结构 是经典的计算机视觉问题 [hartley_multiple_2000, ozyecsil2017survey, oliensis2000critique],其目标是从不同视点拍摄的静态场景图像集合中估计相机参数并重建稀疏点云。 传统 SfM 流程 [snavely2006photo, agarwal2011building, frahm2010building, wu2013towards, schoenberger2016sfm, liu2025robust] 包含图像匹配、三角化和光束法平差等多个阶段。 COLMAP [schoenberger2016sfm] 是基于传统流程最常用的框架。 近年来,深度学习改进了 SfM 流程中的许多组件,其中关键点检测 [yi_lift_2016, detone2018self, dusmanu2019d2, tyszkiewicz2020disk] 和图像匹配 [sarlin2020superglue, chen2021learning, shi2022clustergnn, lindenberger2023lightglue] 是两个主要研究方向。 近期方法 [zhou2017unsupervised, ummenhofer2017demon, tang2018ba, wei2020deepsfm, wang2021deep, teed2018deepv2d, teed2021droid, brachmann2024acezero, smith24flowmap:, wang24vggsfm:] 探索了端到端可微 SfM;其中,VGGSfM [wang24vggsfm:] 开始在具有挑战性的地标旅游照片场景上超越传统算法。
多视图立体 旨在从多张相互重叠的图像中稠密重建场景几何,通常假设相机参数已知,而这些参数往往由 SfM 估计。 多视图立体(Multi-view Stereo,MVS)方法可分为三类:传统手工方法 [furukawa2015multi, galliani2015massively, schonberger2016pixelwise, Wang_2023_CVPR]、全局优化方法 [niemeyer2020differentiable, fu2022geo, Wei_2021_ICCV, yariv2020multiview] 和基于学习的方法 [yao2018mvsnet, gu2020cascade, ma2022multiview, peng2022rethinking, geomvsnet]。 与 SfM 类似,基于学习的 MVS 方法近年来也取得了长足进展。 其中,DUSt3R [wang24dust3r:] 和MASt3R [mast3r] 直接从一对视图估计对齐的稠密点云;该任务类似 MVS,但不需要相机参数。 同期的一些工作 [cut3r, tang2024mv, zhang2025flare, yang2025fast3r] 探索用神经网络替代DUSt3R的测试时优化,但性能仅次于或相当于DUSt3R。相比之下,VGGT大幅超越了DUSt3R和MASt3R。
任意点跟踪(Tracking-Any-Point) 最早由 Particle Video [sand2008particle] 提出,并在深度学习时代由 PIPs [pips] 重新带入研究视野,旨在跨包含动态运动的视频序列跟踪感兴趣点。
给定一段视频和若干二维查询点,该任务需要预测这些点在其余所有帧中的二维对应位置。 TAP-Vid [tapvid] 为该任务提出了三个基准和一种简单基线,后者随后在 TAPIR [doersch2023tapir] 中得到改进。 CoTracker [karaev2023cotracker, karaev2024cotracker3] 利用不同点之间的相关性实现跨遮挡跟踪,而 DOT [lemoing2024dense] 则实现了跨遮挡稠密跟踪。 近期,TAPTR [li2024taptr] 为该任务提出端到端 Transformer,LocoTrack [cho2024local] 则将常用的逐点特征扩展至邻近区域。
上述方法均为专用点跟踪器。 本文证明,将VGGT特征与现有点跟踪器结合,可获得当前最佳的跟踪性能。
方法
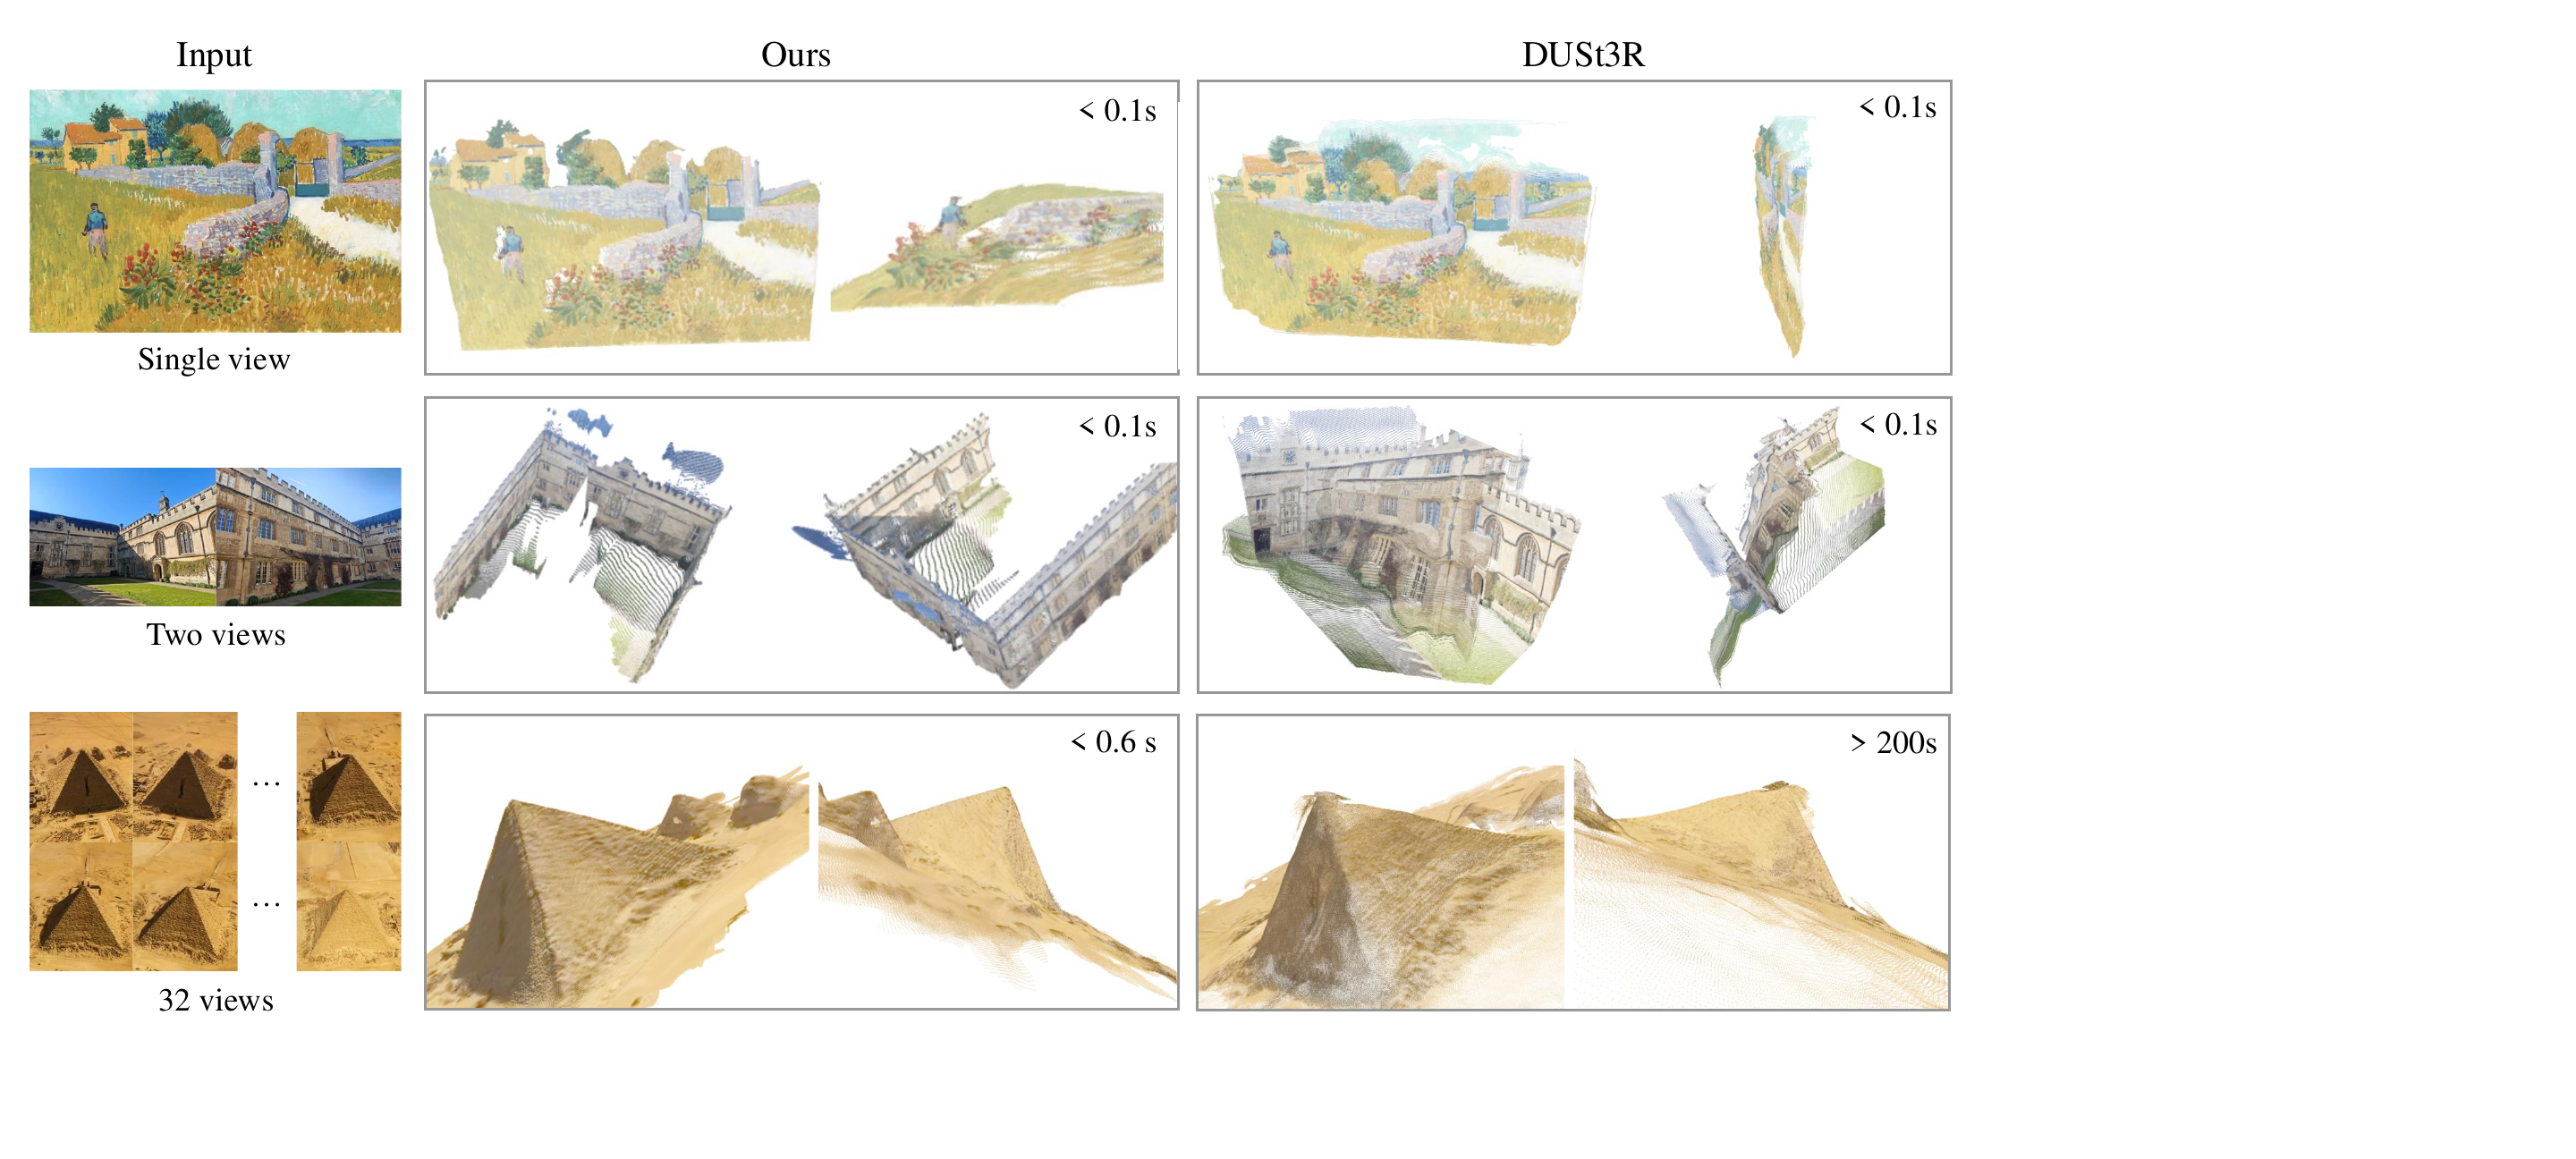
图:在自然图像上,将本文预测的三维点与DUSt3R进行定性比较。 如第一行所示,本文方法成功预测了油画的几何结构,而DUSt3R预测出一个略有畸变的平面。第二行中,本文方法从两幅无重叠区域的图像中正确恢复出三维场景,而DUSt3R未能恢复。 第三行给出了一个包含重复纹理的困难样例,本文方法仍能得到高质量预测。 我们未展示输入超过 32 帧的样例,因为DUSt3R在超过该上限后会耗尽显存。
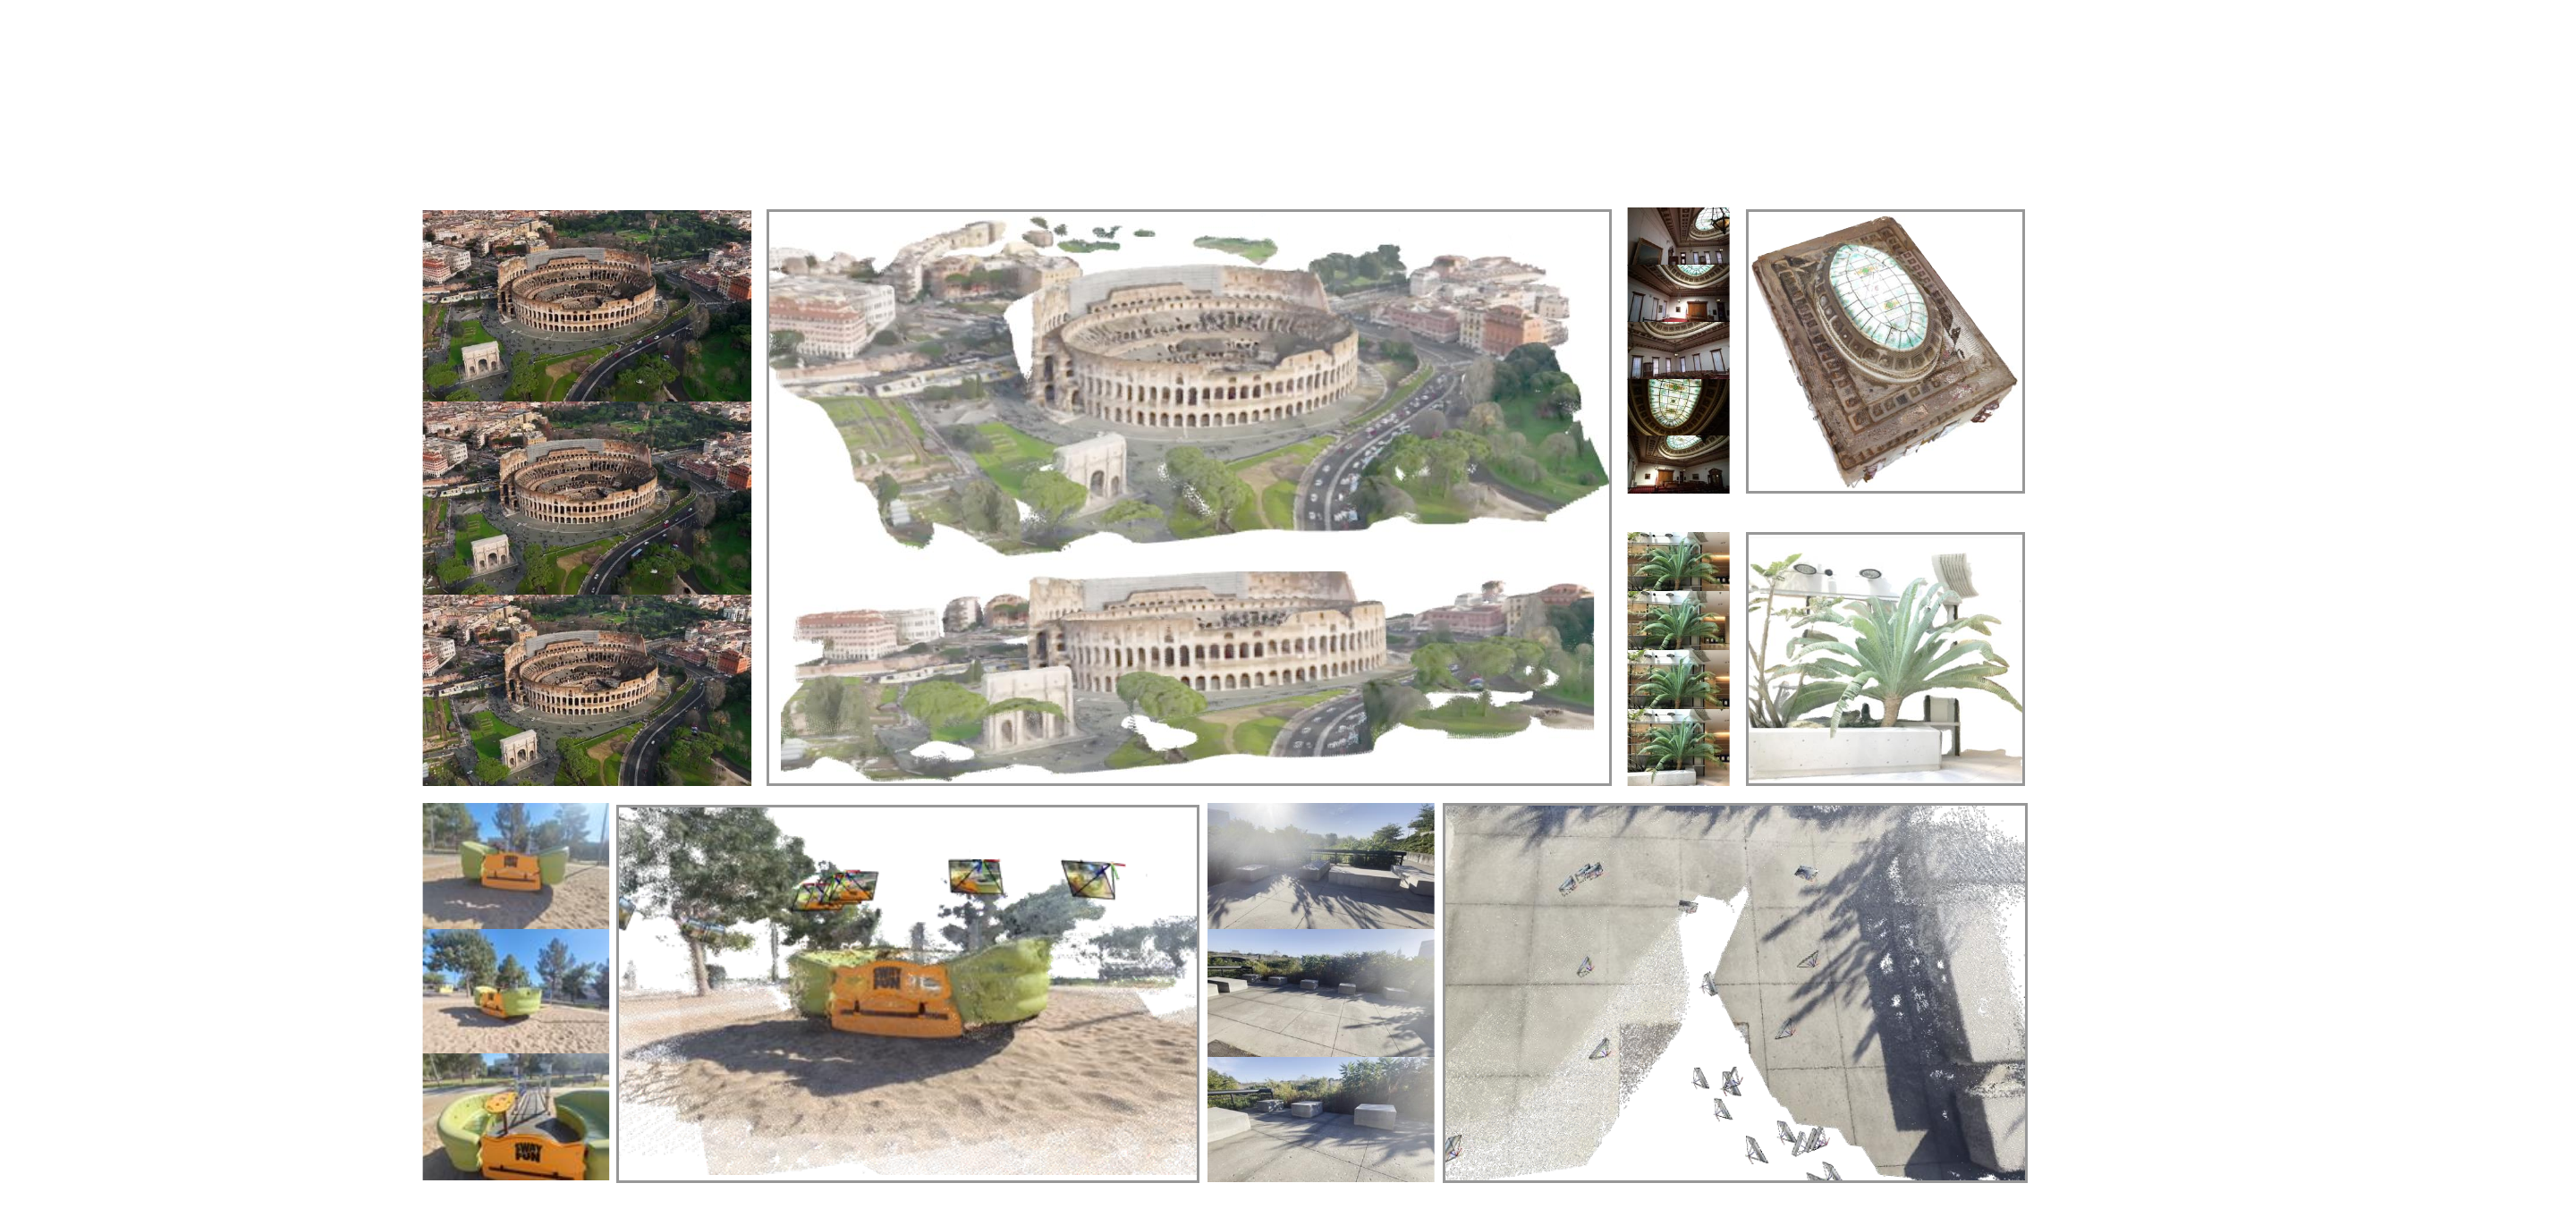
图:点图估计的更多可视化结果。相机视锥展示了估计的相机位姿。 可通过我们的交互式演示获得更清晰的可视化效果。
本文提出VGGT,一个以图像集为输入、输出多种三维量的大型 Transformer。 我们首先在(见 sec:problem_definition)中介绍问题,在(见 sec:architecture)中介绍模型架构,在(见 sec:prediction_heads)中介绍各预测头,最后在(见 sec:training_losses)中说明训练设置。
问题定义与符号
输入是由 \(N\) 幅 RGB 图像组成的序列 \((I_i)_{i=1}^N\),其中 $$ I_i \in \R^{3\times H\times W}, $$ 这些图像观测同一个三维场景。 VGGT的 Transformer 是一个函数,它将该序列映射为相应的一组三维标注,每帧对应一组:
因此,该 Transformer 将每幅图像 \(I_i\) 映射为 其相机参数 \(\bg_i \in \mathbb{R}^9\)(内参与外参)、 深度图 \(D_i \in \R^{H\times W}\)、 点图(Point Map)\(P_i \in \R^{3\times H\times W}\), 以及用于点跟踪的 \(C\) 维特征网格 \(T_i \in \R^{C\times H\times W}\)。 下文将说明这些量的定义。
对于相机参数 \(\bg_i\),我们采用 [wang24vggsfm:]中的参数化方式,令 $$ \bg = [\mathbf{q}, \mathbf{t}, \mathbf{f}] $$, 即旋转四元数 \(\bq \in \R^4\)、 平移向量 \(\bt \in \R^3\) 和视场角 \(\mathbf{f} \in \R^2\) 的拼接。 我们假设相机主点位于图像中心,这也是运动恢复结构(Structure from Motion,SfM)框架中的常见设定 [schonberger16structure-from-motion,wang24vggsfm:]。
图像 \(I_i\) 的定义域记为 $$ \mathcal{I}(I_i) = {1, \dots, H} \times {1,\dots,W}, $$, 即所有像素位置的集合。 深度图 \(D_i\) 将每个像素位置 \(\by \in \mathcal{I}(I_i)\) 与第 \(i\) 个相机所观测到的相应深度值 \(D_i(\by) \in \R^+\) 关联起来。 类似地,点图 \(P_i\) 将每个像素与相应的三维场景点 \(P_i(\by) \in \mathbb{R}^3\) 关联起来。 关键在于,与DUSt3R [wang24dust3r:]相同,这些点图具有视点不变性(Viewpoint Invariance),即三维点 \(P_i(\by)\) 定义在第一个相机 \(\bg_1\) 的坐标系中,我们将其作为世界参考坐标系。
最后,对于关键点跟踪,我们遵循 [karaev24cotracker,doersch23tapir:]等任意点跟踪(Track-Any-Point)方法。 具体而言,给定查询图像 \(I_q\) 中的固定查询图像点 \(\mathbf{y}_q\),网络输出一条轨迹 $$ \mathcal{T}^\star(\mathbf{y}q) = ( \mathbf{y}_i ){i=1}^N $$, 它由所有图像 \(I_i\) 中对应的二维点 \(\mathbf{y}_i \in \R^2\) 构成。
需要注意的是,上述 Transformer \(f\) 并不直接输出轨迹,而是输出用于跟踪的特征 \(T_i \in \mathbb{R}^{C\times H \times W}\)。 跟踪任务交由(见 sec:prediction_heads)中介绍的单独模块完成,该模块实现如下函数: $$ \mathcal{T}( (\mathbf{y}j){j=1}^M, (T_i){i=1}^N) = ((\hat{\by}{j,i}){i=1}^N){j=1}^M. $$ 它接收查询点 \(\mathbf{y}_q\) 和 Transformer \(f\) 输出的稠密跟踪特征 \(T_i\),随后计算轨迹。 两个网络 \(f\) 与 \(\mathcal{T}\) 以端到端方式联合训练。
预测顺序。
除第一幅图像被选为参考帧外,输入序列中的图像顺序可以任意排列。 网络架构被设计为对第一帧之外的所有帧满足置换等变性。
过完备预测。
值得指出的是,VGGT预测的量并非全部相互独立。 例如,正如DUSt3R [wang24dust3r:]所示,相机参数 \(\bg\) 可以从不变点图 \(P\) 推断得到,例如通过求解透视-\(n\)-点(Perspective-n-Point,PnP)问题 [lepetit2009ep, fischler1981random]。 此外,深度图也可由点图和相机参数推导得到。 然而,正如(见 sec:ablation)所示,即使上述各量之间存在闭式关系,在训练时要求VGGT显式预测所有这些量仍能显著提升性能。
与此同时,在推理阶段,相比直接使用专门的点图分支,将独立估计的深度图与相机参数相结合可以生成更准确的三维点。
特征骨干网络
遵循近期三维深度学习工作 [wei24meshlrm:,wang24dust3r:,jin24lvsm:],我们设计了一个仅包含少量三维归纳偏置的简洁架构,使模型能够从大量带三维标注的数据中学习。 具体而言,我们将模型 \(f\) 实现为大型 Transformer [vaswani17attention]。 为此,首先通过 DINO [oquab24dinov2:]将每幅输入图像 \(I\) 分块标记化(Patchify)为由 \(K\) 个标记组成的集合(注:标记数量取决于图像分辨率。) \(\tok^I \in \R^{K\times C}\)。
随后,所有帧的图像标记集合,即 \(\tok^I = \cup_{i=1}^N \{\tok^I_i\}\),经过帧内自注意力(Frame-Wise Self-Attention)层与全局自注意力(Global Self-Attention)层交替组成的主干网络处理。
交替注意力。
我们对标准 Transformer 设计略作调整,引入交替注意力(Alternating-Attention,AA),使 Transformer 交替关注帧内信息和全局信息。 具体而言,帧内自注意力分别关注每一帧内的标记 \(\tok^I_k\),而全局自注意力则同时关注所有帧中的标记 \(\tok^I\)。 这种设计在跨图像整合信息与归一化每幅图像中各标记的激活之间取得了平衡。 默认情况下,我们采用 \(L=24\) 层全局与帧内注意力。 在(见 sec:exp)中,我们证明 AA 架构能够显著提升性能。 需要注意的是,该架构不含任何交叉注意力层,仅使用自注意力层。
预测头
本节介绍 \(f\) 如何预测相机参数、深度图、点图和点轨迹。 首先,对每幅输入图像 \(I_i\),我们在对应的图像标记 \(\tok^I_i\) 中加入一个额外的相机标记 \(\tok^\bg_i \in \R^{1 \times C'}\) 和四个寄存器标记 [registers] \(\tok^R_i \in \R^{4 \times C'}\)。 随后,将 \((\tok^I_i, \tok^\bg_i, \tok^R_ij)_{i=1}^{N}\) 的拼接结果输入 AA Transformer,得到输出标记 \(({\hat\tok}^I_i, {\hat\tok}^\bg_i, {\hat\tok}^R_i)_{i=1}^N\)。 第一帧的相机标记和寄存器标记(\(\tok^\bg_1 := \bar{\tok}^\bg\), \(\tok^R_1 := \bar{\tok}^R\))被设为一组可学习标记 \(\overline{\tok}^\bg, \overline{\tok}^R\),不同于其他所有帧同样可学习的标记(\(\tok^\bg_i := \overline{\overline{\tok}}^\bg, \tok^R_i := \overline{\overline{\tok}}^R, i \in [2,\dots,N]\))。 这使模型能够区分第一帧与其余各帧,并在第一个相机的坐标系中表示三维预测结果。 经过细化的相机标记和寄存器标记现在具有帧特异性——这是因为 AA Transformer 包含帧内自注意力层,使 Transformer 能够将相机标记和寄存器标记与同一图像中的对应标记进行匹配。 按照常见做法,输出寄存器标记 \({\hat\tok}^R_i\) 被丢弃,而 \({\hat\tok}^I_i\)、\({\hat\tok}^\bg_i\) 用于预测。
坐标系。 如上所述,我们在第一个相机 \(\bg_1\) 的坐标系中预测相机、点图和深度图。 因此,第一个相机输出的相机外参被设为单位变换,即第一个旋转四元数为 \(\bq_1 = [0, 0, 0, 1]\),第一个平移向量为 \(\bt_1 = [0, 0, 0]\)。 前述特殊的相机标记和寄存器标记 \(\tok^\bg_1 := \overline{\tok}^\bg, \tok^R_1 := \overline{\tok}^R\) 使 Transformer 能够识别第一个相机。
相机预测。 相机参数 \((\hat{\bg}^i)_{i=1}^N\) 由输出相机标记 \(({\hat\tok}^\bg_i)_{i=1}^N\) 预测,具体使用四个额外的自注意力层,之后接一个线性层。 这些层构成预测相机内参与外参的相机头。
稠密预测。 输出图像标记 \({\hat\tok}^I_i\) 用于预测稠密输出,即深度图 \(D_i\)、点图 \(P_i\) 和跟踪特征 \(T_i\)。 更具体地,首先通过一个 DPT 层 [ranftl21dpt]将 \({\hat\tok}^I_i\) 转换为稠密特征图 \(F_i \in \R^{C'' \times H \times W}\)。 随后,分别用一个 \(3\times 3\) 卷积层将每个 \(F_i\) 映射为相应的深度图 \(D_i\) 和点图 \(P_i\)。 此外,DPT 头还输出稠密特征 \(T_i \in \R^{C \times H \times W}\),作为跟踪头的输入。 我们还分别为每幅深度图和点图预测偶然不确定性(Aleatoric Uncertainty) [kendall16modelling,novotny18capturing] \(\Sigma_i^D \in \R_+^{H \times W}\) 和 \(\Sigma_i^P \in \R_+^{H \times W}\)。 如(见 sec:training_losses)所述,不确定性图用于计算损失;训练完成后,它们与模型对预测的置信度成正比。
跟踪。 为了实现跟踪模块 \(\mathcal{T}\),我们采用以稠密跟踪特征 \(T_i\) 为输入的 CoTracker2 架构 [karaev24cotracker]。 更具体地,给定查询图像 \(I_q\) 中的查询点 \(\by_j\)(训练期间始终设 \(q=1\),但也可使用任何其他图像作为查询),跟踪头 \(\mathcal{T}\) 预测所有图像 \(I_i\) 中的一组二维点 $$ \mathcal{T}((\mathbf{y}j){j=1}^M, (T_i){i=1}^N) = ((\hat{\by}{j,i}){i=1}^N){j=1}^M $$, 这些点与 \(\by\) 对应于同一个三维点。 为此,首先在查询点 \(\by_j\) 处对查询图像的特征图 \(T_q\) 进行双线性采样,以获得该点的特征。 随后,将该特征与所有其他特征图 \(T_i, i \neq q\) 进行相关性计算,得到一组相关图。 这些相关图经过自注意力层处理,预测最终的二维点 \(\hat{\by}_i\);这些点均与 \(\by_j\) 对应。 与 VGGSfM [wang24vggsfm:]类似,我们的跟踪器不对输入帧作任何时序顺序假设,因此可应用于任意输入图像集,而不仅限于视频。
训练
训练损失。 我们使用多任务损失对VGGT模型 \(f\) 进行端到端训练:
$$
\mathcal{L}
\mathcal{L}\text{camera} + \mathcal{L}\text{depth} + \mathcal{L}\text{pmap} + \lambda \mathcal{L}\text{track}. $$
实验发现,相机损失(\(\mathcal{L}_\text{camera}\))、深度损失(\(\mathcal{L}_\text{depth}\))和点图损失(\(\mathcal{L}_\text{pmap}\))的数值范围相近,无需相互加权。 跟踪损失 \(\mathcal{L}_\text{track}\) 的权重因子设为 \(\lambda = 0.05\)。 下面依次介绍各损失项。
相机损失 \(\mathcal{L}_\text{camera}\) 监督相机预测 \(\hat{\bg}\): $$ \mathcal{L}\text{camera} = \sum{i=1}^N \left | \hat{\bg}i - \bg_i \right |\epsilon, $$ 该损失使用 Huber 损失 \(|\cdot|_\epsilon\) 比较预测相机 \(\hat{\bg}_i\) 与真值 \(\bg_i\)。
深度损失 \(\mathcal{L}_\text{depth}\) 遵循DUSt3R [wang24dust3r:],采用偶然不确定性损失 [novotny17learning,kendall17what],根据预测的不确定性图 \(\hat{\Sigma}_i^D\) 对预测深度 \(\hat{D}_i\) 与真值深度 \(D_i\) 之间的差异加权。 与DUSt3R不同,我们还加入了单目深度估计中广泛使用的梯度项。 因此,深度损失为 $$ \mathcal{L}\text{depth} = \sum{i=1}^N | \Sigma_i^D \odot (\hat{D}i - D_i) | + | \Sigma_i^D \odot ({\smallnabla} \hat{D}_i - {\smallnabla} D_i) | - \alpha \log \Sigma_i^D $$, 其中 \(\odot\) 表示沿通道广播的逐元素乘积。 点图损失的定义与之类似,但使用点图不确定性 \(\Sigma_i^P\): $$ \mathcal{L}\text{pmap} = \sum_{i=1}^N | \Sigma_i^P \odot (\hat{P}i - P_i) | + | \Sigma_i^P \odot ({\smallnabla} \hat{P}_i - {\smallnabla} P_i) | - \alpha \log \Sigma_i^P $$。 最后,跟踪损失定义为 $$ \mathcal{L}\text{track} = \sum_{j=1}^M \sum_{i=1}^N | \by_{j,i} - \hat{\by}_{j,i} | $$。 其中,外层求和遍历查询图像 \(I_q\) 中的所有真值查询点 \(\by_j\),\(\by_{j,i}\) 是 \(\by_j\) 在图像 \(I_i\) 中的真值对应点,而 \(\hat{\by}_{j,i}\) 是应用跟踪模块 \(\mathcal{T}((\mathbf{y}_j)_{j=1}^M, (T_i)_{i=1}^N)\) 得到的相应预测。 此外,遵循 CoTracker2 [karaev24cotracker],我们采用可见性损失(二元交叉熵)估计一个点在给定帧中是否可见。
真值坐标归一化。 如果缩放一个场景或改变其全局参考坐标系,场景图像完全不受影响,这意味着任何此类变体都是三维重建的合理结果。 我们通过归一化数据消除这种歧义,从中确定一个规范形式,并要求 Transformer 输出这一特定变体。 遵循 [wang24dust3r:],首先在第一个相机 \(\bg_1\) 的坐标系中表示所有量。 然后,计算点图 \(P\) 中所有三维点到原点的平均欧氏距离,并使用该尺度归一化相机平移 \(\bt\)、点图 \(P\) 和深度图 \(D\)。 与 [wang24dust3r:]不同的是,我们不会对 Transformer 的输出预测执行这种归一化;相反,我们要求模型从训练数据中学习所选用的归一化方式。
实现细节。 默认情况下,我们分别采用 \(L=24\) 层全局注意力和帧内注意力。 模型总计约含 12 亿个参数。 我们使用 AdamW 优化器优化训练损失(eq:training_loss),共训练 \(160\)K 次迭代。 采用余弦学习率调度器,峰值学习率为 \(0.0002\),并进行 \(8\)K 次迭代的预热。 对于每个批次,从随机训练场景中随机采样 \(2\)--\(24\) 帧。
输入帧、深度图和点图均被缩放至最大尺寸为 \(518\) 像素。 宽高比在 0.33 至 1.0 之间随机取值。 我们还对输入帧随机应用颜色抖动、高斯模糊和灰度增强。 训练使用 64 块 A100 GPU,历时九天。 采用阈值为 \(1.0\) 的梯度范数裁剪,以保证训练稳定性。 同时使用 bfloat16 精度和梯度检查点,以提高 GPU 显存与计算效率。
训练数据。 模型使用大规模、多样化的数据集集合进行训练,包括: Co3Dv2 [reizenstein21common]、 BlendMVS [yao2020blendedmvs]、 DL3DV [ling2024dl3dv]、 MegaDepth [li2018megadepth]、 Kubric [greff22kubric:]、 WildRGB [xia2024rgbd]、 ScanNet [dai2017scannet]、 HyperSim [hypersim]、 Mapillary [MPSD_2020_ECCV]、 Habitat [szot2021habitat]、 Replica [straub2019replica]、 MVS-Synth [mvssynth]、 PointOdyssey [zheng2023point]、 Virtual KITTI [cabon2020virtual]、 Aria Synthetic Environments [Pan_2023_ICCV]、 Aria Digital Twin [Pan_2023_ICCV], 以及一个由艺术家创作资产组成、类似 Objaverse [deitke2023objaverse]的合成数据集。 这些数据集覆盖室内和室外等不同领域,同时包含合成与真实世界场景。 数据集中的三维标注来自多种来源,例如传感器直接采集、合成引擎或 SfM 技术 [schonberger16structure-from-motion]。 我们的数据集组合在规模和多样性上与 MASt3R [duisterhof24mast3r-sfm:]大致相当。
实验
表:在 RealEstate10K [zhou2018stereo] 和 CO3Dv2 [reizenstein21common] 上的相机位姿估计, 使用 10 个随机帧。 所有指标均为越高越好。 所有方法均未在 Re10K 数据集上训练。 运行时间使用一张 H100 GPU 测得。 以 \(^{\mathbf{\ddagger}}\) 标记的方法为同期工作。
\begin{table}[t]
    \centering
    \footnotesize
    \resizebox{\columnwidth}{!}{
    \begin{tabular}{c|c|c|c}

    \toprule
    \multirow{2}{*}{方法} & \multicolumn{1}{c|}{Re10K \textit{(未见)} } & \multicolumn{1}{c|}{CO3Dv2} & \multirow{2}{*}{时间}\\


                                                & AUC@30 $\uparrow$ & AUC@30 $\uparrow$ \\
    \midrule

    Colmap+SPSG~\cite{sarlin2020superglue}    & 45.2              & 25.3              &  $\sim$ 15s          \\
    PixSfM~\cite{lindenberger21pixel-perfect} & 49.4              & 30.1              &  $>$ 20s             \\


    PoseDiff~\cite{wang23posediffusion:}      & 48.0              & 66.5              &  $\sim$ 7s           \\


    DUSt3R~\cite{wang24dust3r:}               & 67.7              & 76.7              &  $\sim$ 7s           \\

    MASt3R~\cite{mast3r}                      & 76.4              & 81.8              &  $\sim$ 9s           \\
    VGGSfM v2~\cite{wang24vggsfm:}            & 78.9              & 83.4              &  $\sim$ 10s          \\
    \midrule
    MV-DUSt3R~\cite{tang2024mv} $^{\mathbf{\ddagger}}$ & 71.3 & 69.5 & {$\sim$ 0.6s} \\
    CUT3R~\cite{cut3r} $^{\mathbf{\ddagger}}$ & 75.3 & 82.8 & {$\sim$ 0.6s}  \\
    FLARE~\cite{zhang2025flare} $^{\mathbf{\ddagger}}$ & 78.8 & 83.3 & \underline{{$\sim$ 0.5s}}  \\
    Fast3R~\cite{yang2025fast3r} $^{\mathbf{\ddagger}}$  &72.7 & 82.5 & \textbf{$\sim$ 0.2s}  \\
    \midrule
    本文方法(前馈)                           & \underline{85.3}  & \underline{88.2}  & \textbf{$\sim$ 0.2s} \\
    本文方法(含 BA)                          & \textbf{93.5}     & \textbf{91.8}     &  $\sim$ 1.8s         \\
    \bottomrule
    \end{tabular}
    }
    \caption{
    \textbf{在 RealEstate10K~\cite{zhou2018stereo} 和 CO3Dv2~\cite{reizenstein21common} 上的相机位姿估计},
    使用 10 个随机帧。
    所有指标均为越高越好。

    所有方法均未在 Re10K 数据集上训练。

    运行时间使用一张 H100 GPU 测得\@。

    以 $^{\mathbf{\ddagger}}$ 标记的方法为同期工作。
    }\label{tab:pose}
    \normalsize
    \end{table}
表:在 DTU [dtudataset] 数据集上的稠密 MVS 估计。 表格上半部分为已知真值相机的方法,下半部分为未知真值相机的方法。
\begin{table}
\centering
\small
\newcommand{\tickmark}{\ding{51}}
\newcommand{\xmark}{\ding{55}}
\footnotesize
\begin{tabular}{ccccc}
\toprule
    已知真值
    & \multirow{2}{*}{方法}
    & \multirow{2}{*}{准确度$\downarrow$}
    & \multirow{2}{*}{完整度$\downarrow$}
    & \multirow{2}{*}{总体误差$\downarrow$}
    \\
    相机
    &&&&\\\midrule


    \tickmark  &   Gipuma~\cite{gipuma} &     \textbf{0.283} &       0.873 &    0.578 \\

    \tickmark &       MVSNet~\cite{mvsnet} &     0.396 &       0.527 &    0.462 \\


    \tickmark&       CIDER~\cite{cider} &     0.417 &       0.437 &    0.427 \\
    \tickmark& PatchmatchNet~\cite{pathcmatchnet} &     0.427 &       0.377 &    0.417 \\
    \tickmark&  MASt3R~\cite{mast3r} &     0.403 &       0.344 &    0.374 \\
    \tickmark&  GeoMVSNet~\cite{geomvsnet} &     0.331 &\textbf{0.259} &    \textbf{0.295} \\ \midrule

  \xmark&     DUSt3R~\cite{wang24dust3r:} &     2.677 &       0.805 &    1.741 \\

\xmark & 本文方法 & \textbf{0.389} & \textbf{0.374} & \textbf{0.382} \\
\bottomrule
\end{tabular}
\caption{
\textbf{在 DTU~\cite{dtudataset} 数据集上的稠密 MVS 估计。}
表格上半部分为已知真值相机的方法,下半部分为未知真值相机的方法。
}\label{tab:dtu}
\end{table}
表:在 ETH3D [eth3d] 上的点图估计。 DUSt3R 和 MASt3R 使用全局对齐,而本文方法采用前馈方式,因而速度快得多。本文方法(点图)一行表示直接使用点图头的结果,本文方法(深度 + 相机)表示结合深度图头与相机头构建点云。
\begin{table}
\centering
\footnotesize
\begin{tabular}{cccccc}
\toprule
方法                & 准确度$\downarrow$  & 完整度$\downarrow$ & 总体误差$\downarrow$ &  时间       \\
\midrule
DUSt3R             & 1.167             & 0.842             & 1.005               &  $\sim$ 7s  \\
MASt3R             & 0.968             & 0.684             & 0.826               &  $\sim$ 9s  \\
本文方法(点图)    & \underline{0.901} & \underline{0.518} & \underline{0.709}   & $\sim$ 0.2s \\
本文方法(深度 + 相机) &\textbf{0.873}     & \textbf{0.482}    & \textbf{0.677}      &  $\sim$ 0.2s\\
\bottomrule
\end{tabular}
\caption{
\textbf{在 ETH3D~\cite{eth3d} 上的点图估计。}
DUSt3R 和 MASt3R 使用全局对齐,而本文方法采用前馈方式,因而速度快得多。\textit{本文方法(点图)}一行表示直接使用点图头的结果,\textit{本文方法(深度 + 相机)}表示结合深度图头与相机头构建点云。}
\label{tab:eth3d}
\end{table}
表:在 ScanNet-1500 [dai2017scannet, sarlin2020superglue] 上的双视图匹配比较。尽管本文跟踪头并非专为双视图设置设计,其性能仍超过当前最先进的双视图匹配方法 Roma。采用 AUC 衡量(越高越好)。
\begin{table}
\footnotesize
\centering
\begin{tabular}{lcccc}
\toprule

方法                                                 & AUC@5 $\uparrow$ & AUC@10 $\uparrow$ & AUC@20 $\uparrow$ \\
\midrule
SuperGlue~\citep{sarlin2020superglue}                & 16.2             & 33.8              & 51.8              \\

    LoFTR~\citep{sun2021loftr}                       & 22.1             & 40.8              & 57.6              \\


    DKM~\citep{edstedt2023dkm}                       & 29.4             & 50.7              & 68.3              \\

CasMTR~\citep{cao2023casmtr}                         & 27.1             & 47.0              & 64.4              \\
    Roma~\citep{edstedt2024roma}                     & {31.8}           & {53.4}            & {70.9}            \\ \midrule
    本文方法                                         & \textbf{33.9}    & \textbf{55.2}     & \textbf{73.4}     \\
\bottomrule
\end{tabular}
\caption{\textbf{在 ScanNet-1500~\citep{dai2017scannet, sarlin2020superglue} 上的双视图匹配比较。}尽管本文跟踪头并非专为双视图设置设计,其性能仍超过当前最先进的双视图匹配方法 Roma。采用 AUC 衡量(越高越好)。}
\label{tab:scannet}
\end{table}
本节在多项任务上将本文方法与当前最先进的方法进行比较,以验证其有效性。
相机位姿估计
首先在 CO3Dv2 [reizenstein21common] 和 RealEstate10K [zhou2018stereo] 数据集上评估本文方法的相机位姿估计(Camera Pose Estimation)性能,结果如(见 tab:pose) 所示。 遵循 [wang23posediffusion:],我们从每个场景中随机选择 10 张图像,并采用结合 RRA 与 RTA 的标准指标 AUC@30 进行评估。 相对旋转准确率(Relative Rotation Accuracy,RRA)与相对平移准确率(Relative Translation Accuracy,RTA)分别计算每个图像对的旋转和平移相对角度误差。 随后对这些角度误差设置阈值,以确定准确率分数。 AUC 是不同阈值下 RRA 与 RTA 较小值所形成的准确率--阈值曲线下面积。 (见 tab:pose) 中的(可学习)方法均在 Co3Dv2 上训练,且未在 RealEstate10K 上训练。 在两个数据集的所有指标上,本文的前馈模型始终优于其他方法,包括采用高计算开销后优化步骤的方法,例如 DUSt3R/MASt3R 的全局对齐和 VGGSfM 的光束法平差(Bundle Adjustment,BA);这些方法通常需要超过 \(10\) 秒。 相比之下,VGGT仅以纯前馈方式运行便取得更优性能,在相同硬件上只需 \(0.2\) 秒。 与同期工作 [yang2025fast3r, tang2024mv, zhang2025flare, cut3r](以 \(^{\mathbf{\ddagger}}\) 标记)相比,本文方法具有显著性能优势,速度则与其中最快的 Fast3R [yang2025fast3r] 相近。 在 RealEstate10K 数据集上,这一性能优势更加明显,因为 (见 tab:pose) 中的方法均未在该数据集上训练。 这验证了 VGGT 出色的泛化能力。
结果还表明,将 VGGT 与 BA 等视觉几何优化方法结合可进一步提升性能。 具体而言,使用 BA 优化预测的相机位姿与轨迹可进一步提高准确率。 本文方法直接预测接近准确的点图/深度图,可为 BA 提供良好的初始化。 因此,无需像 [wang24vggsfm:] 那样在 BA 中执行三角测量和迭代细化,使本文方法快得多(即使采用 BA 也只需约 \(2\) 秒)。 由此可见,尽管 VGGT 的前馈模式优于此前所有方案(无论其是否为前馈方法),后优化仍能带来收益,性能还有进一步提升的空间。
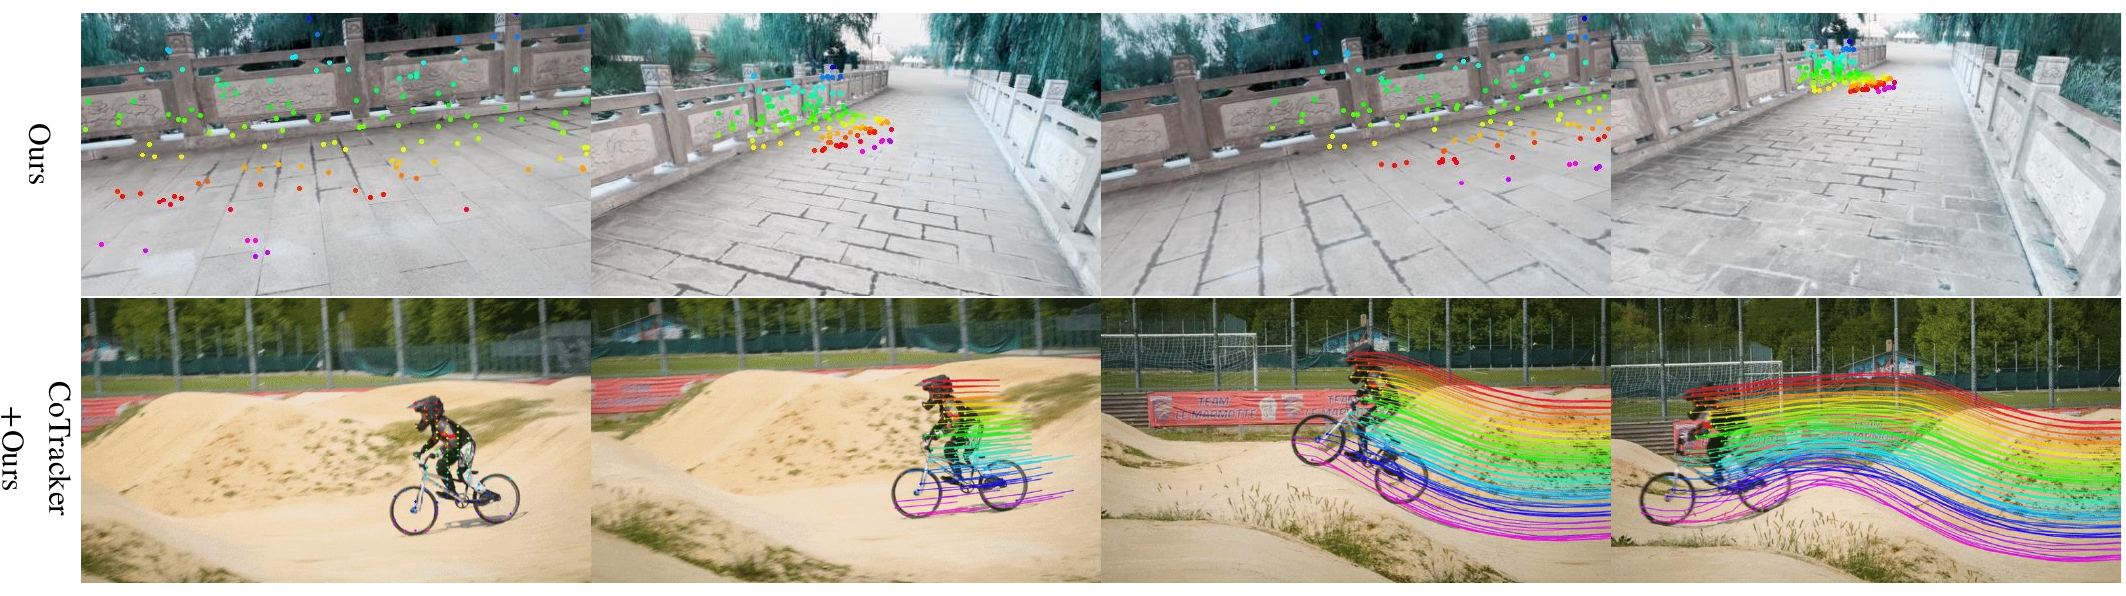
图:刚性点跟踪与动态点跟踪的可视化。 上:VGGT 的跟踪模块 \(\mathcal{T}\) 为描述静态场景的无序输入图像集合输出关键点轨迹。 下:我们微调 VGGT 的骨干网络,以增强处理时序输入的动态点跟踪器 CoTracker [karaev2023cotracker]。
多视图深度估计
遵循 MASt3R [mast3r],我们进一步在 DTU [dtudataset] 数据集上评估多视图深度估计结果。 报告的标准 DTU 指标包括准确度(Accuracy,从预测到真值的最小欧氏距离)、完整度(Completeness,从真值到预测的最小欧氏距离),以及二者平均值总体误差(Overall,即 Chamfer 距离)。 在 (见 tab:dtu) 中,DUSt3R 和本文的 VGGT 是仅有的两个不使用真值相机信息的方法。 MASt3R 使用真值相机对匹配点进行三角测量,从而得到深度图。 GeoMVSNet 等深度多视图立体视觉方法则使用真值相机构建代价体。
本文方法显著优于 DUSt3R,将总体误差从 \(1.741\) 降至 \(0.382\)。 更重要的是,其结果与测试时已知真值相机的方法相当。 这一显著性能提升很可能得益于模型的多图像训练方案:该方案使模型原生具备多视图三角测量推理能力,而不依赖特设的对齐过程。相比之下,DUSt3R 仅对多个成对相机三角测量结果取平均。
点图估计
我们还在 ETH3D [eth3d] 数据集上比较本文方法、DUSt3R 和 MASt3R 所预测点云的准确性。 每个场景随机采样 \(10\) 帧。 采用 Umeyama [umeyama91least-squares] 算法将预测点云与真值对齐。 使用官方掩码过滤无效点后报告结果。 点图估计采用准确度、完整度和总体误差(Chamfer 距离)作为指标。 如 (见 tab:eth3d) 所示,尽管 DUSt3R 和 MASt3R 执行了高开销优化(全局对齐——每个场景约 10 秒),本文方法仅以简单的前馈方式、每次重建只需 \(0.2\) 秒,仍显著优于二者。
与直接使用估计点图相比,深度头和相机头的预测结果(即使用预测相机参数将预测深度图反投影到三维空间)具有更高准确率。 这说明,将复杂任务(点图估计)分解为较简单的子问题(深度图与相机预测)能够带来收益,尽管训练期间相机、深度图和点图受到联合监督。
(见 fig:pointmap_compare) 给出了本文方法与 DUSt3R 在自然场景上的定性比较,更多示例见 (见 fig:pointmap)。 VGGT 能够输出高质量预测并具有良好泛化能力,在油画、无重叠帧,以及沙漠等具有重复或均匀纹理的场景等困难域外样例上表现出色。
图像匹配
双视图图像匹配是计算机视觉中得到广泛研究的课题 [sarlin20superglue:,lindenberger23lightglue:, sun2021loftr]。 它是仅限两个视图的刚性点跟踪特例,因此即使本文模型并非专门面向该任务,它仍是衡量跟踪准确率的合适评估基准。 我们在 ScanNet 数据集 [dai2017scannet] 上遵循标准协议 [edstedt2024roma,sarlin20superglue:],结果见 (见 tab:scannet)。 对于每个图像对,首先提取匹配并据此估计本质矩阵,再将其分解得到相对相机位姿。 最终指标为以 AUC 衡量的相对位姿准确率。 评估时,使用 ALIKED [zhao2023aliked] 检测关键点,并将其作为查询点 \(\by_q\)。 随后将这些点输入跟踪分支 \(\mathcal{T}\),以在第二帧中寻找对应点。 评估超参数(例如匹配数量、RANSAC 阈值)采用 Roma [edstedt2024roma] 的设置。 尽管未针对双视图匹配进行显式训练,(见 tab:scannet) 表明 VGGT 在所有基线中取得最高准确率。
表:在 ETH3D 上对 Transformer 骨干网络进行消融实验。将本文的交替注意力架构与两个变体进行比较:一个仅使用全局自注意力,另一个使用交叉注意力。
\begin{table}
\centering
\footnotesize
\begin{tabular}{c|ccc}
\toprule
ETH3D 数据集               & 准确度$\downarrow$  & 完整度$\downarrow$ & 总体误差$\downarrow$ \\
\midrule
交叉注意力                 & 1.287             & 0.835             & 1.061               \\
仅全局自注意力             & \underline{1.032 }& \underline{0.621} & \underline{0.827}   \\
交替注意力                 & \textbf{0.901}    & \textbf{0.518}    & \textbf{0.709}      \\
\bottomrule
\end{tabular}
\caption{
\textbf{在 ETH3D 上对 Transformer 骨干网络进行消融实验。}将本文的交替注意力架构与两个变体进行比较:一个仅使用全局自注意力,另一个使用交叉注意力。
}
\label{tab:ablation}
\vspace{-6pt}
\end{table}
表:多任务学习的消融实验。结果表明,同时训练相机、深度和轨迹估计时,在 ETH3D 上取得最高的点图估计准确率。
\begin{table}
\centering
\footnotesize
\resizebox{0.9\columnwidth}{!}{
\newcommand{\tickmark}{\ding{51}}
\newcommand{\xmark}{\ding{55}}
\begin{tabular}{ccccccc}
\toprule
含 $\mathcal{L}_\text{camera}$   & 含 $\mathcal{L}_\text{depth}$  & 含 $\mathcal{L}_\text{track}$       & 准确度$\downarrow$  &  完整度$\downarrow$ &  总体误差$\downarrow$ \\
\midrule
\xmark      & \tickmark & \tickmark      & 1.042             &  0.627             &  0.834               \\
 \tickmark  & \xmark    & \tickmark      & \underline{0.920} &  \underline{0.534} &  \underline{0.727}   \\
 \tickmark  & \tickmark & \xmark         & 0.976             &  0.603             &  0.790               \\
\tickmark   & \tickmark & \tickmark      & \textbf{0.901}    &  \textbf{0.518}    &  \textbf{0.709}      \\
\bottomrule
\end{tabular}
}
\caption{
\textbf{多任务学习的消融实验。}结果表明,同时训练相机、深度和轨迹估计时,在 ETH3D 上取得最高的点图估计准确率。
}
\label{tab:multitask}
\end{table}
消融实验
特征骨干网络。
首先将本文提出的交替注意力(Alternating-Attention)设计与两种替代注意力架构进行比较,以验证其有效性:(a) 仅使用全局自注意力;(b) 交叉注意力。 为确保公平比较,所有模型变体的参数量相同,均使用总计 \(2L\) 个注意力层。 在交叉注意力变体中,每一帧分别关注其余所有帧的标记,最大限度融合跨帧信息,但运行时间显著增加,输入帧数增多时尤为明显。 隐藏维度和注意力头数量等超参数保持一致。 消融实验选择点图估计准确率作为评估指标,因为它能反映模型对场景几何与相机参数的联合理解能力。 (见 tab:ablation) 的结果表明,交替注意力架构以明显优势超过两个基线变体。 其他初步探索实验也一致表明,使用交叉注意力的架构通常不如仅使用自注意力的架构。
多任务学习。
我们还验证了训练单个网络同时学习多种三维量的收益,尽管这些输出可能存在重叠(例如深度图与相机参数可共同生成点图)。 如 (见 tab:multitask) 所示,训练时移除相机、深度或轨迹估计都会使点图估计准确率明显下降。 相机参数估计能显著提高点图准确率,而深度估计仅带来小幅提升。
面向下游任务的微调
下面说明 VGGT 预训练特征提取器可复用于下游任务。 具体展示其在前馈新视角合成(Novel View Synthesis)和动态点跟踪(Dynamic Point Tracking)中的应用。
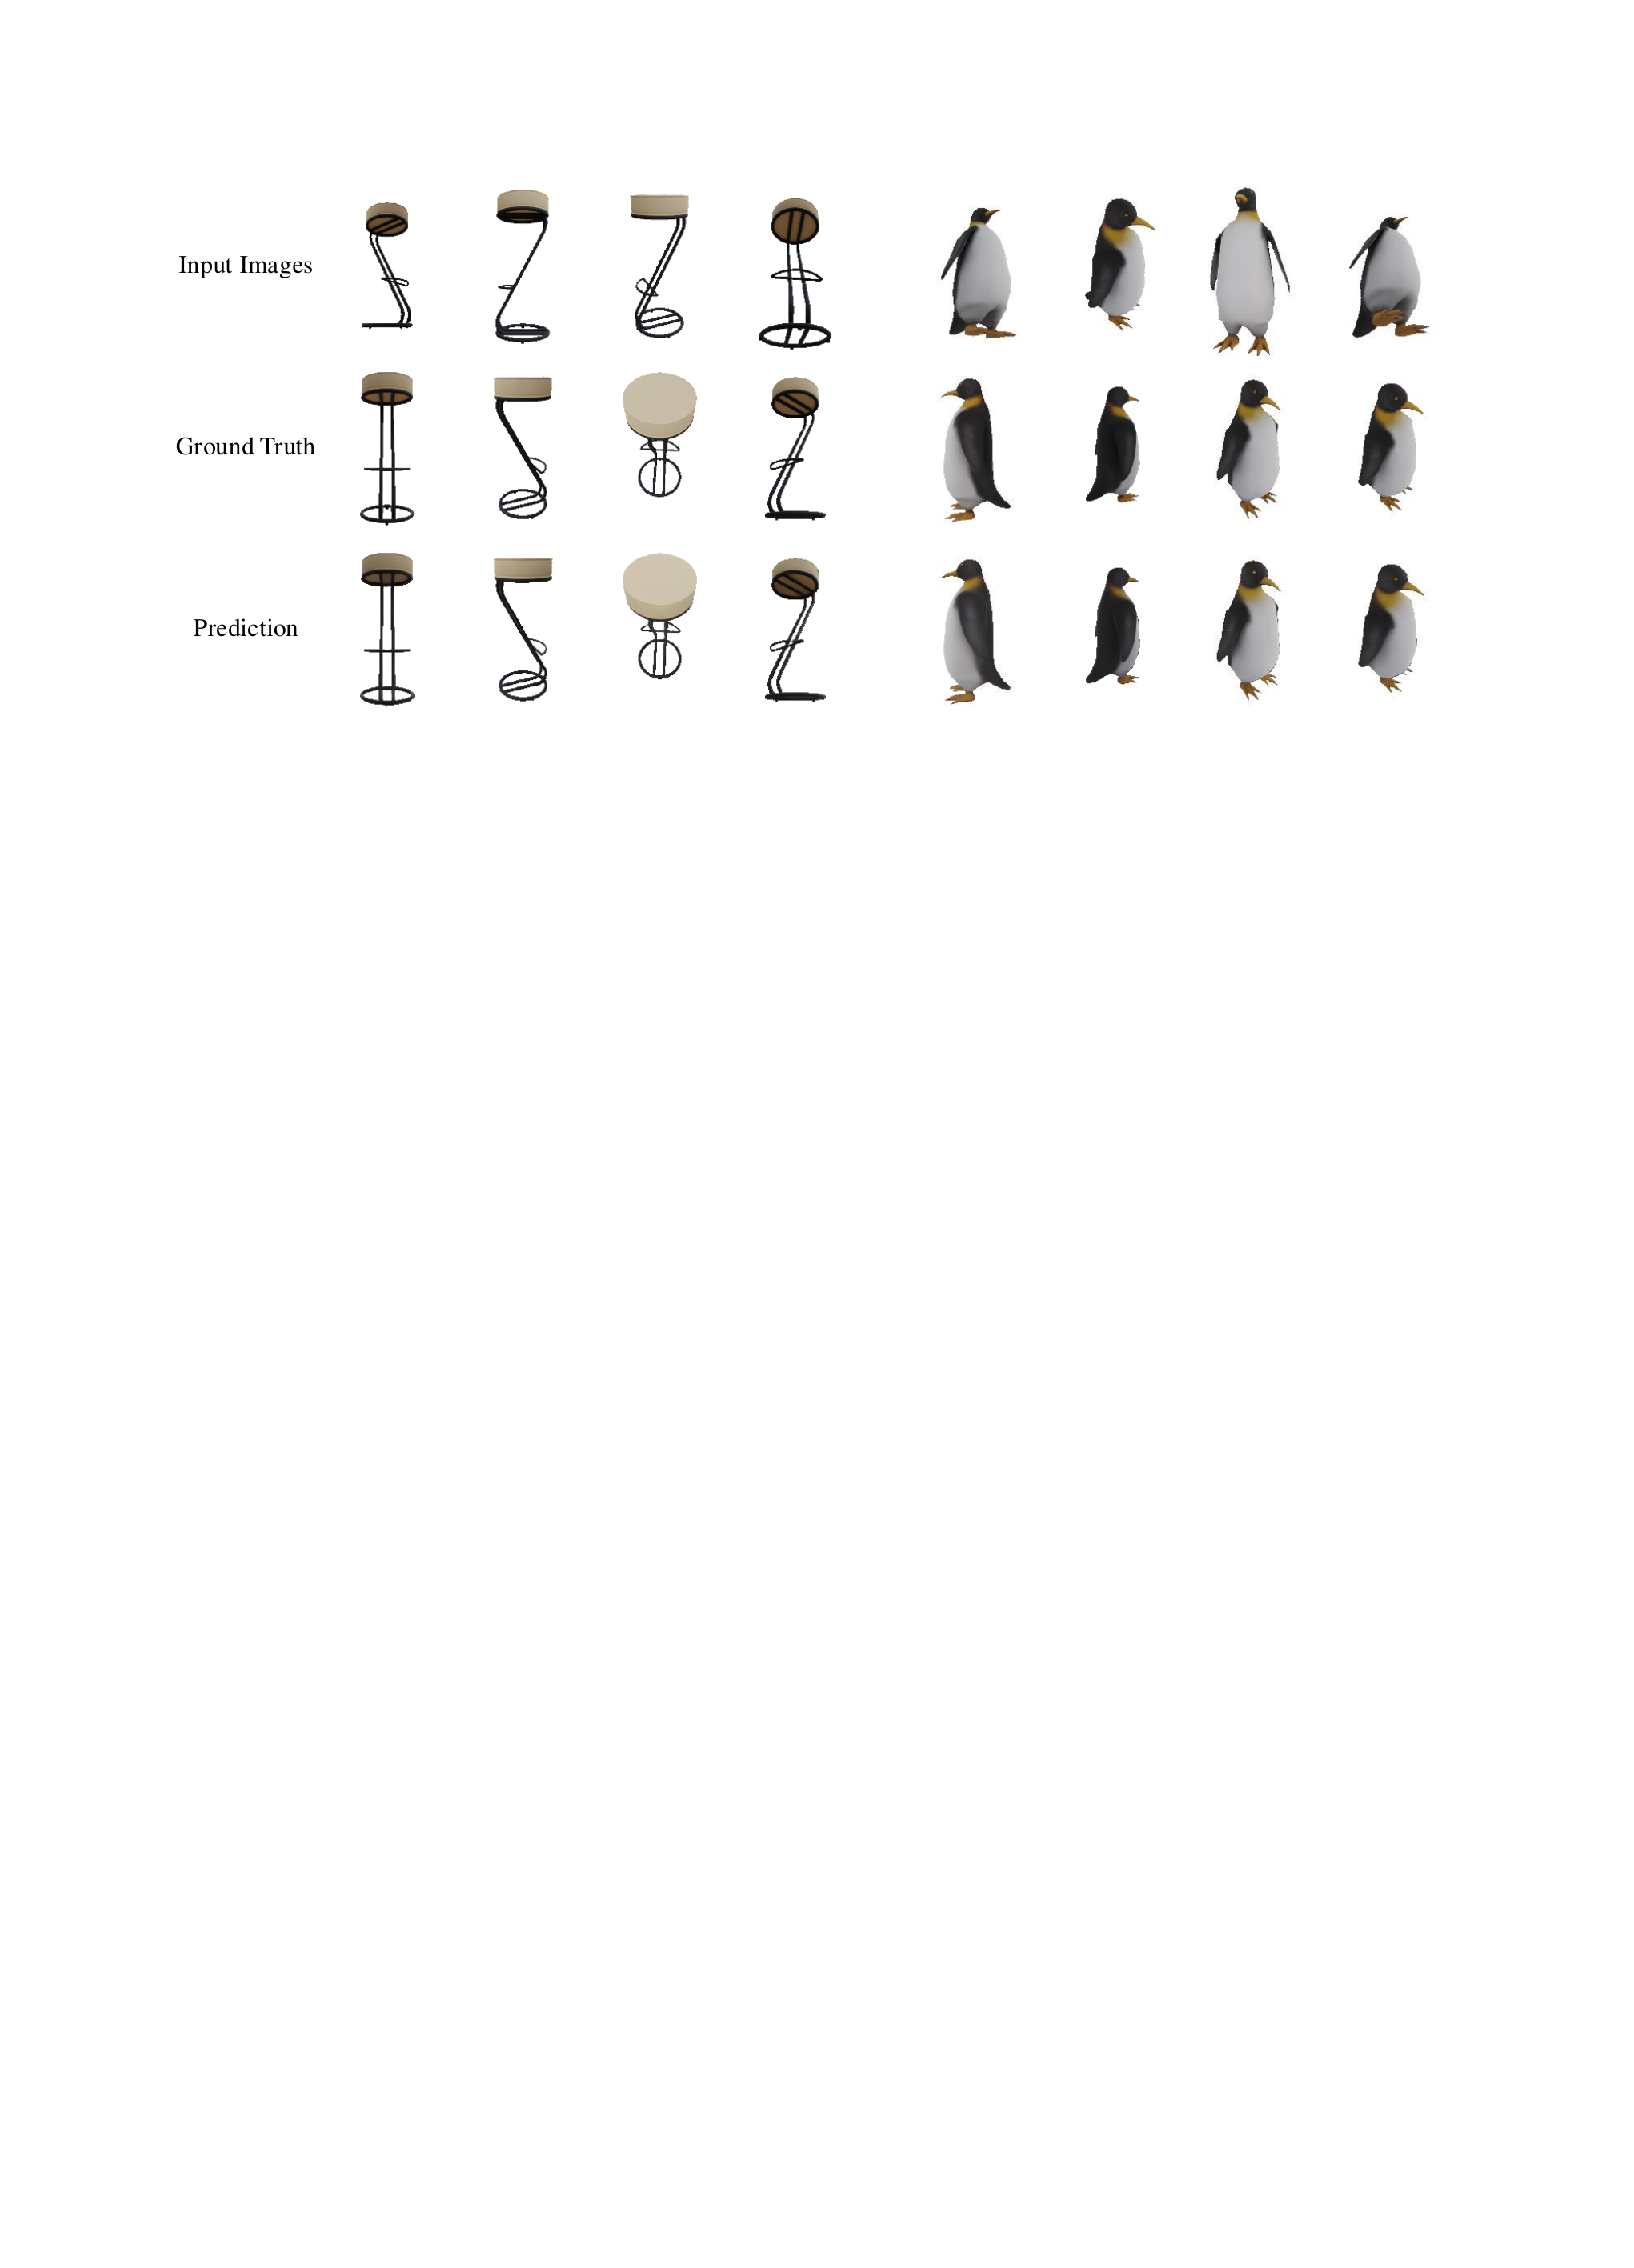
图:新视角合成的定性示例。上排为输入图像,中排为目标视点的真值图像,下排为本文方法合成的图像。
表:在 GSO [downs2022google] 数据集上的视图合成定量比较。 将 VGGT 微调用于前馈新视角合成后,即使不知道输入图像的相机外参与内参,也能取得有竞争力的性能。 注意,\(^*\) 表示使用小规模训练集(仅 20%)。
\begin{table}[htbp]
\footnotesize
\newcommand{\tickmark}{\ding{51}}
\newcommand{\xmark}{\ding{55}}
\begin{center}
\resizebox{0.95\columnwidth}{!}{
\begin{tabular}{ccc|ccc}
\midrule
方法                       & \scriptsize{已知输入相机} & 尺寸 & PSNR \(\uparrow \) & SSIM \(\uparrow \) & LPIPS \(\downarrow \) \\
\midrule
LGM~\citep{tang2024lgm}
                           & \tickmark                    & 256  & 21.44              & 0.832              & 0.122                 \\
GS-LRM~\citep{zhang2024gs} & \tickmark                    & 256  & 29.59              & 0.944              & 0.051                 \\
LVSM~\cite{jin24lvsm:}     & \tickmark                    & 256  & 31.71              & 0.957              & 0.027                 \\
\midrule
{本文方法-NVS}$^*$         & \xmark                       & 224  & 30.41             & 0.949              & 0.033
\\
\midrule
\end{tabular}}
\caption{\textbf{在 GSO~\cite{downs2022google} 数据集上的视图合成定量比较。}
将 \themethod{} 微调用于前馈新视角合成后,即使不知道输入图像的相机外参与内参,也能取得有竞争力的性能。
注意,$^*$ 表示使用小规模训练集(仅 20\%)。}
\label{tab:compare_gso}
\end{center}
\vspace{-4pt}
\end{table}
前馈新视角合成 近年来发展迅速 [hong24lrm:, wang23pf-lrm:, cao25lightplane:, xu24grm:, zhang24gs-lrm:, szymanowicz2024splatter, han2024flex3d, jin24lvsm:]。多数现有方法将已知相机参数的图像作为输入,并预测新相机视点所对应的目标图像。 本文遵循 LVSM [jin24lvsm:],不依赖显式 3D 表示,而是修改 VGGT 以直接输出目标图像。 但我们不假设输入帧的相机参数已知。
训练与评估严格遵循 LVSM 的协议,例如使用 \(4\) 个输入视图,并以 Plücker 射线表示目标视点。 我们对 VGGT 进行简单修改。 与此前相同,输入图像由 DINO 转换为标记。 对于目标视图,则使用卷积层将其 Plücker 射线图像编码为标记。 表示输入图像和目标视图的这些标记被拼接起来,并由 AA Transformer 处理。 随后使用 DPT 头回归目标视图的 RGB 颜色。 需要强调的是,本文不输入源图像的 Plücker 射线。 因此,模型无法获知这些输入帧的相机参数。
LVSM 在 Objaverse 数据集 [deitke2023objaverse] 上训练。 本文使用类似的内部数据集,其规模约为 Objaverse 的 20%。 训练和评估的更多细节见 [jin24lvsm:]。 如 (见 tab:compare_gso) 所示,尽管无需输入相机参数且训练数据少于 LVSM,本文模型在 GSO 数据集 [downs2022google] 上仍取得有竞争力的结果。 预计采用更大的训练数据集可取得更好结果。 定性示例见 (见 fig:nvs)。
表:在 TAP-Vid 基准上的动态点跟踪结果。 尽管本文模型并非为动态场景设计,仅使用本文预训练权重微调 CoTracker 即可显著提高性能,说明所学特征具有良好的鲁棒性和有效性。
\begin{table}[t]
\centering
\setlength{\tabcolsep}{2pt}
\footnotesize
\begin{tabular}{lcccccccccccccccc}
\toprule
\multirow{2}{*}[-0.2em]{方法} & \multicolumn{3}{c}{Kinetics } & \multicolumn{3}{c}{RGB-S}  & \multicolumn{3}{c}{DAVIS}\\
\cmidrule(lr){2-4}
\cmidrule(lr){5-7}
\cmidrule(lr){8-10}
                                       & AJ               & \davgvis         & OA              & AJ               & \davgvis         & OA               & AJ               & \davgvis         & OA               \\ \midrule

TAPTR~\citep{li2024taptr}              & 49.0             & 64.4             & 85.2            & 60.8             & 76.2             & 87.0             & \underline{63.0} & \underline{76.1} & \underline{91.1} \\
LocoTrack~\citep{cho2024local}         & 52.9             & 66.8             & 85.3            & 69.7             & \underline{83.2} & \underline{89.5} & 62.9             & 75.3             & 87.2             \\

BootsTAPIR~\citep{doersch2024bootstap} & \underline{54.6} & \underline{68.4} &\underline{86.5} & \underline{70.8} & 83.0             & 89.9             & 61.4             &73.6              & 88.7             \\ \midrule
CoTracker~\citep{karaev2023cotracker}  & 49.6             & 64.3             & 83.3            & 67.4             &78.9              & 85.2             & 61.8             & 76.1             & 88.3             \\
CoTracker + 本文方法                   & \textbf{57.2}    & \textbf{69.0}    & \textbf{88.9}   & \textbf{72.1}    & \textbf{84.0}    & \textbf{91.6}    & \textbf{64.7}    & \textbf{77.5}    & \textbf{91.4}    \\
\bottomrule
\end{tabular}
\caption{\textbf{在 TAP-Vid 基准上的动态点跟踪结果。}
尽管本文模型并非为动态场景设计,仅使用本文预训练权重微调 CoTracker 即可显著提高性能,说明所学特征具有良好的鲁棒性和有效性。
}
\label{tab:tab_tapvid}
\end{table}
动态点跟踪 近年来已成为竞争激烈的任务 [pips, doersch23tapir:, xiao2024spatialtracker, karaev24cotracker],也是所学特征的另一项下游应用。 遵循标准实践,报告以下点跟踪指标: 遮挡准确率(Occlusion Accuracy,OA),即遮挡预测的二分类准确率; \(\delta_{\mathrm{avg}}^{\mathrm{vis}}\),即在给定像素阈值内被准确跟踪的可见点平均比例;以及 平均 Jaccard(Average Jaccard,AJ),用于联合衡量跟踪与遮挡预测的准确率。
我们将当前最先进的 CoTracker2 模型 [karaev24cotracker] 的骨干网络替换为本文的预训练特征骨干网络。 这是因为 VGGT 在无序图像集合上训练,而非时序视频。 本文骨干网络预测跟踪特征 \(T_i\),以其替代特征提取器的输出;这些特征随后进入 CoTracker2 架构的其余部分,并最终用于预测轨迹。 整个修改后的跟踪器在 Kubric [greff22kubric:] 上微调。 如 (见 tab:tab_tapvid) 所示,集成预训练 VGGT 后,CoTracker 在 TAP-Vid 基准 [tapvid] 上的性能显著提升。 例如,在 TAP-Vid RGB-S 数据集上,VGGT 的跟踪特征将 \(\delta_{\mathrm{avg}}^{\mathrm{vis}}\) 指标从 \(78.9\) 提升至 \(84.0\)。 尽管 TAP-Vid 基准包含来自不同数据源、具有快速动态运动的视频,本文模型仍取得优异性能,表明其特征即使在并非显式设计所面向的场景中也具有良好泛化能力。
讨论
局限性。
尽管本文方法对多样的自然场景表现出强泛化能力,但仍存在若干局限。 首先,当前模型不支持鱼眼图像或全景图像;输入图像发生极端旋转时,重建性能也会下降。 此外,模型虽能处理存在轻微非刚性运动的场景,却无法应对大幅非刚性形变。
本文方法的重要优势在于灵活且易于适配。只需在针对性数据集上微调模型,并对架构做少量修改,即可直接解决这些局限。相比之下,现有方法通常需要在测试时优化过程中进行大量重新设计,才能适应此类特殊场景;这种适应能力使本文方法与其明显不同。
表:不同输入帧数下的运行时间与 GPU 峰值显存占用。运行时间以秒为单位,GPU 显存占用以 GB 为单位。
\begin{table}[t]
\footnotesize
\begin{center}
\resizebox{\columnwidth}{!}{
\begin{tabular}{c|ccccccccc}
\hline
\textbf{输入帧数} & 1 & 2 & 4 & 8 & 10 & 20 & 50 & 100 & 200 \\
\hline
\textbf{时间(s)} & 0.04 & 0.05 & 0.07 & 0.11 & 0.14 & 0.31 & 1.04 & 3.12 & 8.75 \\
\textbf{显存(GB)} & 1.88 & 2.07 & 2.45 & 3.23 & 3.63 & 5.58 & 11.41 & 21.15 & 40.63 \\
\hline
\end{tabular}
}
\caption{\textbf{不同输入帧数下的运行时间与 GPU 峰值显存占用。}运行时间以秒为单位,GPU 显存占用以 GB 为单位。}
\label{tab:runtime_mem}
\end{center}
\vspace{-10pt}
\end{table}
运行时间与显存。 如 (见 tab:runtime_mem) 所示,我们评估了特征骨干网络处理不同数量输入帧时的推理运行时间和 GPU 峰值显存占用。测量在单张 NVIDIA H100 GPU 上使用 Flash Attention v3 [shah2024flashattention] 完成。 图像分辨率为 \(336\times518\)。
由于用户可能根据具体需求与可用资源选择不同分支组合,此处重点分析特征骨干网络的开销。相机头较为轻量,其运行时间通常约为特征骨干网络的 \(5%\),GPU 显存占用约为后者的 \(2%\)。每个 DPT 头处理一帧平均耗时 \(0.03\) 秒,占用 \(0.2\) GB GPU 显存。
GPU 显存充足时,可在单次前向传播中高效处理多帧。 在本文模型中,帧间关系仅由特征骨干网络处理,而 DPT 头对每一帧独立进行预测。 因此,GPU 资源受限的用户可逐帧预测,具体取舍由用户决定。
当标记数量很大时,全局自注意力的朴素实现会占用大量显存。采用大语言模型(Large Language Model,LLM)部署中的技术可节省资源或加速计算。例如,Fast3R [yang2025fast3r] 采用张量并行(Tensor Parallelism),通过多张 GPU 加速推理,这一技术可直接用于本文模型。
分块标记化。
如 (见 sec:architecture) 所述,我们探索了两种将图像分块标记化(Patchifying)为标记的方法:使用 \(14 \times 14\) 卷积层或预训练 DINOv2 模型。实验结果表明,DINOv2 性能更好,且训练稳定得多,尤其是在初始阶段。DINOv2 对学习率或动量等超参数的变化也不太敏感。因此,本文模型默认使用 DINOv2 进行分块标记化。
可微光束法平差。
我们还探索了像 VGGSfM [wang24vggsfm:] 一样使用可微光束法平差(Differentiable Bundle Adjustment,BA)。 小规模初步实验表明,可微 BA 具有良好潜力。 但其瓶颈在于训练期间的计算成本。 在 PyTorch 中使用 Theseus [pineda2022theseus] 启用可微 BA,通常会使每个训练步骤慢约 \(4\) 倍,对于大规模训练而言开销很高。 定制框架以加速训练可能是一种解决方案,但超出本文范围。 因此,本文没有加入可微 BA;不过,它可在缺乏显式 3D 标注的场景中提供有效监督信号,是大规模无监督训练中值得探索的方向。
单视图重建。
DUSt3R 和 MASt3R 等系统必须复制图像以构成图像对,而本文模型架构原生支持单张图像输入。此时,全局注意力会直接转变为逐帧注意力。尽管模型未针对单视图重建进行显式训练,却取得了出人意料的良好结果。部分示例见 (见 fig:pointmap_compare) 和 (见 fig:pointmap_supp)。我们强烈建议试用演示,以获得更直观的可视化效果。
预测归一化。
如 (见 sec:training_losses) 所述,本文方法使用 3D 点的平均欧氏距离对真值进行归一化。 虽然 DUSt3R 等方法也对网络预测应用这种归一化,但实验表明,它既非模型收敛所必需,也无益于最终性能。 此外,这种做法往往会在训练阶段引入额外的不稳定性。
结论
本文提出以视觉几何为基础的 Transformer(VGGT),一种前馈神经网络,可直接估计数百个输入视图中的所有关键三维场景属性。 该方法在多项 3D 任务上取得当前最先进的结果,包括相机参数估计、多视图深度估计、稠密点云重建和 3D 点跟踪。 本文简单且以神经网络为先的方法不同于传统的视觉几何方法;后者依赖优化和后处理才能针对特定任务获得准确结果。 本文方法简单高效,非常适合实时应用,这也是其相较于优化类方法的另一项优势。
附录
\noindent 附录包含以下内容:
-
(见 sec:definitions)给出关键术语的形式化定义。
-
(见 sec:impl)提供完整的实现细节,包括架构和训练超参数。
-
(见 sec:addexp)给出补充实验与讨论。
-
(见 sec:qual)展示单视图重建的定性示例。
-
(见 sec:addrel)进一步综述相关工作。
形式化定义
本节补充形式化定义,为方法部分奠定更严谨的基础。
相机外参相对于世界参考系定义,本文将第一台相机的坐标系作为世界参考系。 为此,引入两个函数。 第一个函数 $$ \gamma(\bg, \bp) = \bp' $$ 将 \(\bg\) 编码的刚性变换应用于世界参考系中的点 \(\bp\),得到相机参考系中的对应点 \(\bp'\)。 第二个函数 $$ \pi(\bg, \bp) = \by $$ 进一步应用透视投影,将三维点 \(\bp\) 映射为二维图像点 \(\by\)。 相机 \(\bg\) 观测到的该点深度记为 $$ \pi^\text{D}(\bg, \bp) = d \in \R^+ $$. 本文将场景建模为一组正则曲面 \(S_i \subset \mathbb{R}^3\)。 由于场景会随时间变化 [zhang24monst3r:],因此令其依赖于第 \(i\) 张输入图像。 像素位置 \(\by \in \mathcal{I}(I_i)\) 处的深度定义为场景中所有投影至 \(\by\) 的三维点 \(\bp\) 的最小深度,即 $$ D_i(\by) = \min { \pi^D(\bg_i, \bp) : \bp \in S_i \wedge \pi(\bg_i, \bp) = \by }. $$ 于是,像素位置 \(\by\) 处的点为 \(P_i(\by) = \gamma(\bg, \bp)\),其中 \(\bp \in S_i\) 是使上式取最小值的三维点,即 $$ \bp \in S_i \wedge \pi(\bg_i, \bp) = \by \wedge \pi^D(\bg_i, \bp) = D_i(\by) $$.
实现细节
架构。 如正文所述,VGGT由 \(24\) 个注意力块组成,每个块包含一个帧内自注意力层和一个全局自注意力层。 遵循 DINOv2 [oquab24dinov2:] 采用的 ViT-L 模型,每个注意力层的特征维度设为 \(1024\),并使用 \(16\) 个注意力头。 注意力层采用 PyTorch 官方实现(即 torch.nn.MultiheadAttention),并启用 Flash Attention。 为稳定训练,每个注意力层还采用 QKNorm [henry2020query] 和 LayerScale [touvron2021going]。 LayerScale 的初始值设为 \(0.01\)。 图像词元化采用 DINOv2 [oquab24dinov2:],并加入位置嵌入。 与 [depth_anything_v2] 一致,将第 \(4\)、\(11\)、\(17\) 和 \(23\) 个块的词元输入 DPT [ranftl21dpt] 进行上采样。
训练。 构建训练批次时,首先随机选择一个训练数据集(与 [wang24dust3r:] 一致,各数据集权重不同但大致接近),再从中均匀随机采样一个场景。 训练期间,每个场景选择 \(2\) 至 \(24\) 帧,同时保持每个批次共 \(48\) 帧不变。 训练使用各数据集对应的训练集。 包含少于 \(24\) 帧的训练序列会被排除。 首先对 RGB 帧、深度图和点图进行等比例缩放,使长边为 \(518\) 像素。 随后围绕主点裁剪短边,使其尺寸介于 \(168\) 至 \(518\) 像素,并保持为 \(14\) 像素图像块尺寸的整数倍。 同一场景中的各帧会独立应用幅度较大的颜色增强,以提高模型对不同光照条件的鲁棒性。 遵循 [wang24vggsfm:,edstedt2024roma, sun2021loftr] 构建真实轨迹:将深度图反投影至三维空间,再把点重投影到目标帧,并保留重投影深度与目标深度图相符的对应关系。 批次采样时,排除与查询帧相似度较低的帧。 在少数不存在有效对应关系的情况下,省略跟踪损失。
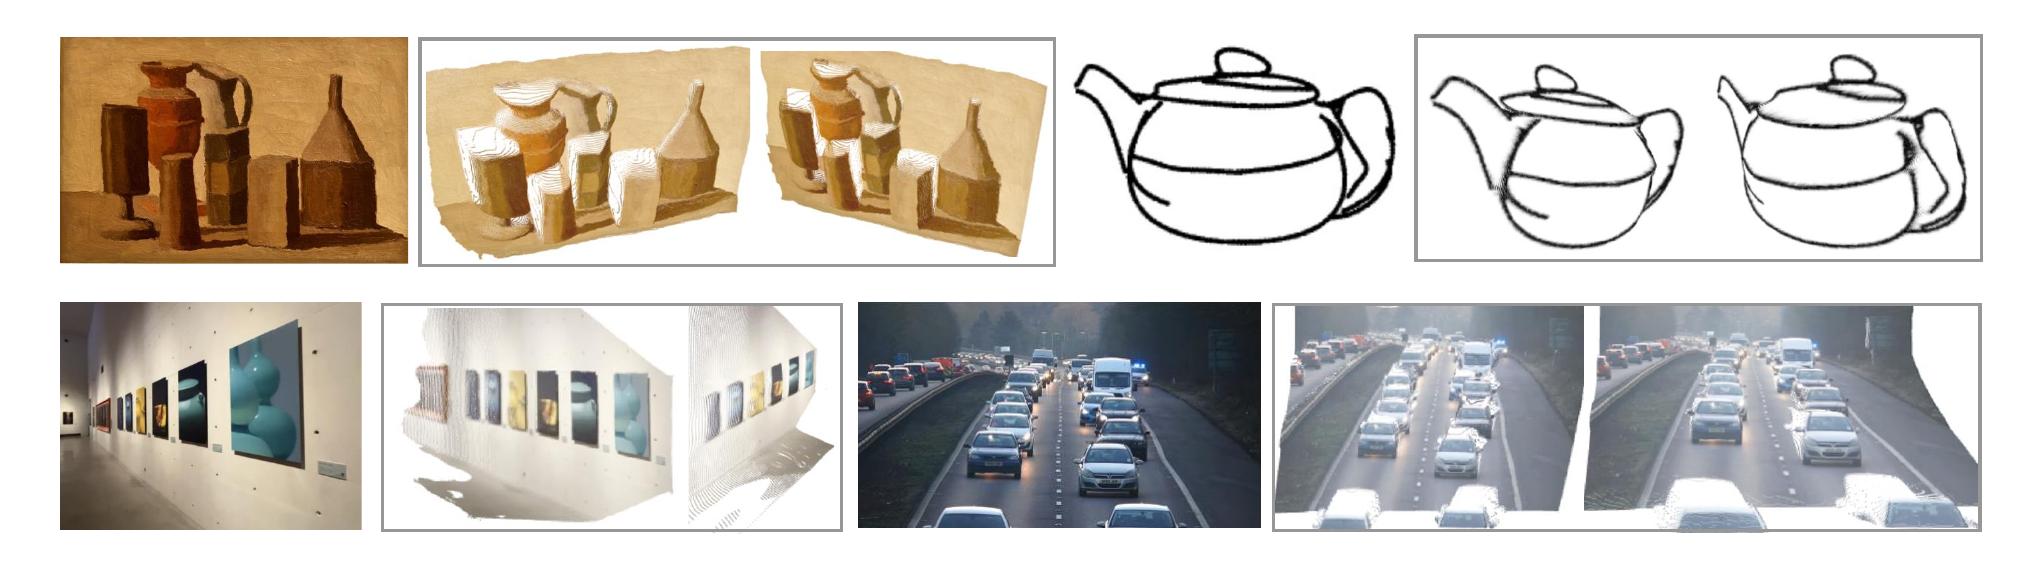
图:基于点图估计的单视图重建。 DUSt3R 需要将一张图像复制为图像对,而本文模型可直接从单张输入图像预测点图。 模型对未见过的真实世界图像表现出很强的泛化能力。
补充实验
IMC 上的相机位姿估计 本文还在图像匹配挑战赛(Image Matching Challenge,IMC) [jin2021image] 上评估;这是一个专注于地标旅游照片数据的相机位姿估计基准。 直到近期,该基准仍由经典增量式 SfM 方法 [schoenberger2016sfm] 主导。
基线。 评估模型的两个版本:VGGT和VGGT+ BA。 VGGT直接输出相机位姿估计,而VGGT+ BA 通过额外的光束法平差阶段细化估计结果。 对比对象包括 [schoenberger2016sfm,lindenberger21pixel-perfect] 等经典增量式 SfM 方法和近期提出的深度学习方法。 具体而言,近期的 VGGSfM [wang24vggsfm:] 是首个在具有挑战性的地标旅游照片数据集上超越增量式 SfM 的端到端训练深度学习方法。
除 VGGSfM 外,还与近期广受关注的 DUSt3R [wang24dust3r:] 和 MASt3R [mast3r] 进行比较。 需要指出的是,DUSt3R 和 MASt3R 使用了 MegaDepth 数据集的很大一部分进行训练,仅排除场景 \(0015\) 和 \(0022\)。 其训练采用的 MegaDepth 场景与 IMC 基准存在一定重叠;虽然图像并不相同,但两个数据集中包含相同场景。 例如,MegaDepth 的场景 \(0024\) 对应大英博物馆,而 IMC 基准同样包含大英博物馆场景。 为进行同等条件下的比较,本文采用与 DUSt3R 和 MASt3R 相同的训练划分。 正文中,为确保在 ScanNet-1500 上公平比较,训练时排除了对应的 ScanNet 场景。
结果。 (见 tab:IMCpose)给出了评估结果。 尽管地标旅游照片数据历来是 SfM 方法的重点,VGGT的前馈性能仍与当前最佳的 VGGSfMv2 相当:二者 AUC@10 分别为 \(71.26\) 和 \(76.82\);与此同时,前者速度显著更快(每个场景 0.2 秒,对比 10 秒)。 VGGT在所有准确率阈值下均显著超越 MASt3R [mast3r] 和 DUSt3R [wang24dust3r:],且速度快得多。 这是因为 MASt3R 和 DUSt3R 的前馈预测一次只能处理一对帧,因此需要代价高昂的全局对齐(Global Alignment)步骤。 加入光束法平差后,VGGT+ BA 的性能进一步大幅提升,在 IMC 上取得当前最佳结果:AUC@10 从 \(71.26\) 提升至 \(84.91\),AUC@3 从 \(39.23\) 提升至 \(66.37\)。 本文模型直接预测三维点,可作为 BA 的初始化。 因此无需像 [wang24vggsfm:] 那样执行三角化和 BA 迭代细化。 由此,VGGT+ BA 比 [wang24vggsfm:] 快得多。
\newcommand{\tickmark}{\ding{51}} \newcommand{\xmark}{\ding{55}}
表:IMC [jin2021image] 上的相机位姿估计。 本文方法在具有挑战性的地标旅游照片数据上取得当前最佳性能,优于在最新 CVPR'24 IMC 挑战赛相机位姿(旋转和平移)估计任务中排名第一的 VGGSfMv2 [wang24vggsfm:]。
\begin{table}[tbp]
\centering
\small
\resizebox{\linewidth}{!}{

\begin{tabular}{cccccc}
\toprule
方法                                                  &  测试时优化 & AUC@3$\degree$    & AUC@5$\degree$    & AUC@10$\degree$   &
运行时间                                              \\
\midrule
COLMAP~(SIFT+NN)~\cite{schoenberger2016sfm}           &  \tickmark      & 23.58             & 32.66             & 44.79             & $>$10s        \\
PixSfM (SIFT + NN)~\cite{lindenberger21pixel-perfect} &  \tickmark      & 25.54             & 34.80             & 46.73             & $>$20s        \\
PixSfM (LoFTR)~\cite{lindenberger21pixel-perfect}     &  \tickmark      & 44.06             & 56.16             & 69.61             & $>$20s        \\
PixSfM (SP + SG)~\cite{lindenberger21pixel-perfect}   &  \tickmark      & {45.19}           & 57.22             & 70.47             & $>$20s        \\
DFSfM~(LoFTR)~\cite{he2023dfsfm}                      &  \tickmark      & {46.55}           & {58.74}           & {72.19}           & $>$10s        \\
\midrule
DUSt3R~\cite{wang24dust3r:}                           &  \tickmark      & 13.46             & 21.24             & 35.62             & $\sim$ 7s     \\
MASt3R~\cite{mast3r}                                  &  \tickmark      & 30.25             & 46.79             & 57.42             & $\sim$ 9s     \\
VGGSfM~\cite{wang24vggsfm:}                           &  \tickmark      & {45.23}           & {58.89}           & {73.92}           & $\sim$ 6s     \\
VGGSfMv2~\cite{wang24vggsfm:}                         &  \tickmark      & \underline{59.32} & \underline{67.78} & \underline{76.82} & $\sim$ 10s    \\
\midrule
\themethod{}(本文)                                  &  \xmark         & 39.23             & 52.74             & 71.26             & \textbf{0.2s} \\
\themethod + BA(本文)                               &  \tickmark      & \textbf{66.37}    & \textbf{75.16}    & \textbf{84.91}    & 1.8s          \\
\bottomrule
\end{tabular}
}
\caption{\textbf{IMC~\cite{jin2021image} 上的相机位姿估计。}
本文方法在具有挑战性的地标旅游照片数据上取得当前最佳性能,优于在最新 CVPR'24 IMC 挑战赛相机位姿(旋转和平移)估计任务中排名第一的 VGGSfMv2~\cite{wang24vggsfm:}。
}
\label{tab:IMCpose}
\end{table}
定性示例
单视图重建的定性示例进一步见(见 fig:pointmap_supp)。
相关工作
本节进一步讨论相关工作。
视觉 Transformer。 Transformer 架构最初针对语言处理任务提出 [vaswani2017attention, Devlin2019BERTPO, brown2020language],随后由 ViT [dosovitskiy21an-image] 引入计算机视觉领域,并得到广泛采用。凭借结构简洁、容量大、灵活性强以及捕获长程依赖的能力,视觉 Transformer 及其变体此后成为各类计算机视觉任务架构设计的主流选择 [arnab2021vivit, peebles2023scalable, cheng2022masked, xie2021segformer]。
DeiT [touvron2021training] 证明,采用强数据增强策略可在 ImageNet 等数据集上有效训练视觉 Transformer。DINO [caron21emerging] 揭示了视觉 Transformer 通过自监督学习获得的特征所具有的独特性质。CaiT [touvron2021going] 引入层缩放以应对更深层视觉 Transformer 的训练难题,有效缓解了梯度相关问题。 此外,QKNorm [henry2020query, zhai2023stabilizing] 等技术也被用于稳定训练过程。 文献 [xie2022correlation] 还探索了目标跟踪中帧内注意力模块与全局注意力模块之间的动态关系,但其采用交叉注意力。
相机位姿估计。
从多视图图像估计相机位姿是三维计算机视觉中的关键问题。
过去几十年间,无论是增量式方法 [snavely2006photo,agarwal2011building, frahm2010building,wu2013towards, schoenberger2016sfm] 还是全局方法 [arie2012global, crandall2012sfm, cui2015linear, moulon2013global, sweeney2015optimizing, rother2003linear, ozyesil2015robust, jiang2013global, cui2015global, cui2017hsfm,pan2024glomap],运动恢复结构(SfM)都已成为主流方案 [hartley04multiple]。
近期,一系列方法将相机位姿估计视为回归问题 [zhou2017unsupervised,ummenhofer2017demon,tang2018ba,wei2020deepsfm,wang2021deep, teed2018deepv2d, teed2021droid, zhang2022relpose,sinha2023sparsepose, wang2023posediffusion, lin2023relposepp, raydiffusion],并在稀疏视图设置下取得了良好结果。
Ace-Zero [brachmann2024acezero] 进一步提出回归三维场景坐标,而 FlowMap [smith2024flowmap] 则聚焦深度图,二者均将其作为相机预测的中间表示。
VGGSfM [wang24vggsfm:] 则将经典 SfM 流程简化为可微框架,并展现出很高的性能,尤其是在地标旅游照片数据集上。
与此同时,DUSt3R [wang24dust3r:, mast3r] 提出学习像素对齐点图的方法,从而可通过简单对齐恢复相机位姿。
这一范式转变引起广泛关注,因为点图这种过参数化表示可与三维高斯泼溅等多种下游应用无缝结合。
参考文献
- [achiam2023gpt] Josh Achiam, Steven Adler, Sandhini Agarwal, Lama Ahmad, Ilge Akkaya, Florencia Leoni Aleman, Diogo Almeida, Janko Altenschmidt, Sam Altman, Shyamal Anadkat, et al. Gpt-4 technical report. arXiv preprint arXiv:2303.08774, 2023.
- [agarwal2011building] Sameer Agarwal, Yasutaka Furukawa, Noah Snavely, Ian Simon, Brian Curless, Steven M Seitz, and Richard Szeliski. Building rome in a day. Communications of the ACM, 54 (10): 105--112, 2011.
- [arie2012global] Mica Arie-Nachimson, Shahar Z Kovalsky, Ira Kemelmacher-Shlizerman, Amit Singer, and Ronen Basri. Global motion estimation from point matches. In 2012 Second international conference on 3D imaging, modeling, processing, visualization & transmission, pages 81--88. IEEE, 2012.
- [arnab2021vivit] Anurag Arnab, Mostafa Dehghani, Georg Heigold, Chen Sun, Mario Lu{\v{c}}i{\'c}, and Cordelia Schmid. Vivit: A video vision transformer. In Proceedings of the IEEE/CVF international conference on computer vision, pages 6836--6846, 2021.
- [brachmann2024acezero] Eric Brachmann, Jamie Wynn, Shuai Chen, Tommaso Cavallari, {\'{A}}ron Monszpart, Daniyar Turmukhambetov, and Victor Adrian Prisacariu. Scene coordinate reconstruction: Posing of image collections via incremental learning of a relocalizer. In ECCV, 2024.
- [brown2020language] Tom B Brown. Language models are few-shot learners. arXiv preprint arXiv:2005.14165, 2020.
- [cabon2020virtual] Yohann Cabon, Naila Murray, and Martin Humenberger. Virtual kitti 2. arXiv preprint arXiv:2001.10773, 2020.
- [cao25lightplane:] Ang Cao, Justin Johnson, Andrea Vedaldi, and David Novotny. Lightplane: Highly-scalable components for neural {3D}fields. In Proceedings of the International Conference on {3D} Vision (3DV), 2025.
- [cao2023casmtr] Chenjie Cao and Yanwei Fu. Improving transformer-based image matching by cascaded capturing spatially informative keypoints. In Proceedings of the IEEE/CVF International Conference on Computer Vision (ICCV), pages 12129--12139, 2023.
- [caron21emerging] Mathilde Caron, Hugo Touvron, Ishan Misra, Herv{\'{e}} J{\'{e}}gou, Julien Mairal, Piotr Bojanowski, and Armand Joulin. Emerging properties in self-supervised vision transformers. In Proc. {ICCV}, 2021.
- [chen2021learning] Hongkai Chen, Zixin Luo, Jiahui Zhang, Lei Zhou, Xuyang Bai, Zeyu Hu, Chiew-Lan Tai, and Long Quan. Learning to match features with seeded graph matching network. In Proceedings of the IEEE/CVF International Conference on Computer Vision, pages 6301--6310, 2021.
- [cheng2022masked] Bowen Cheng, Ishan Misra, Alexander G Schwing, Alexander Kirillov, and Rohit Girdhar. Masked-attention mask transformer for universal image segmentation. In Proceedings of the IEEE/CVF conference on computer vision and pattern recognition, pages 1290--1299, 2022.
- [cho2024local] Seokju Cho, Jiahui Huang, Jisu Nam, Honggyu An, Seungryong Kim, and Joon-Young Lee. Local all-pair correspondence for point tracking. Proc. {ECCV}, 2024.
- [crandall2012sfm] David J Crandall, Andrew Owens, Noah Snavely, and Daniel P Huttenlocher. Sfm with mrfs: Discrete-continuous optimization for large-scale structure from motion. IEEE transactions on pattern analysis and machine intelligence, 35 (12): 2841--2853, 2012.
- [cui2017hsfm] Hainan Cui, Xiang Gao, Shuhan Shen, and Zhanyi Hu. Hsfm: Hybrid structure-from-motion. In Proceedings of the IEEE conference on computer vision and pattern recognition, pages 1212--1221, 2017.
- [cui2015global] Zhaopeng Cui and Ping Tan. Global structure-from-motion by similarity averaging. In Proceedings of the IEEE International Conference on Computer Vision, pages 864--872, 2015.
- [cui2015linear] Zhaopeng Cui, Nianjuan Jiang, Chengzhou Tang, and Ping Tan. Linear global translation estimation with feature tracks. arXiv preprint arXiv:1503.01832, 2015.
- [dai2017scannet] Angela Dai, Angel X Chang, Manolis Savva, Maciej Halber, Thomas Funkhouser, and Matthias Nie{\ss}ner. Scannet: Richly-annotated 3d reconstructions of indoor scenes. In Proceedings of the IEEE conference on computer vision and pattern recognition, pages 5828--5839, 2017.
- [registers] Timoth{\'e}e Darcet, Maxime Oquab, Julien Mairal, and Piotr Bojanowski. Vision transformers need registers. arXiv preprint arXiv:2309.16588, 2023.
- [deitke2023objaverse] Matt Deitke, Dustin Schwenk, Jordi Salvador, Luca Weihs, Oscar Michel, Eli VanderBilt, Ludwig Schmidt, Kiana Ehsani, Aniruddha Kembhavi, and Ali Farhadi. Objaverse: A universe of annotated 3d objects. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, pages 13142--13153, 2023.
- [detone2018self] Daniel DeTone, Tomasz Malisiewicz, and Andrew Rabinovich. Superpoint: Self-supervised interest point detection and description. In Proceedings of the IEEE conference on computer vision and pattern recognition workshops, pages 224--236, 2018.
- [Devlin2019BERTPO] Jacob Devlin, Ming-Wei Chang, Kenton Lee, and Kristina Toutanova. Bert: Pre-training of deep bidirectional transformers for language understanding. In North American Chapter of the Association for Computational Linguistics, 2019.
- [tapvid] Carl Doersch, Ankush Gupta, Larisa Markeeva, Adri{`a} Recasens, Lucas Smaira, Yusuf Aytar, Jo{\ a}o Carreira, Andrew Zisserman, and Yi Yang. Tap-vid: A benchmark for tracking any point in a video. arXiv, 2022.
- [doersch2023tapir] Carl Doersch, Yi Yang, Mel Vecerik, Dilara Gokay, Ankush Gupta, Yusuf Aytar, Joao Carreira, and Andrew Zisserman. {TAPIR}: Tracking any point with per-frame initialization and temporal refinement. arXiv, 2306.08637, 2023{a}.
- [doersch23tapir:] Carl Doersch, Yi Yang, Mel Vecerik, Dilara Gokay, Ankush Gupta, Yusuf Aytar, Joao Carreira, and Andrew Zisserman. {TAPIR:} tracking any point with per-frame initialization and temporal refinement. In Proc. {CVPR}, 2023{b}.
- [doersch2024bootstap] Carl Doersch, Yi Yang, Dilara Gokay, Pauline Luc, Skanda Koppula, Ankush Gupta, Joseph Heyward, Ross Goroshin, Jo{\ a}o Carreira, and Andrew Zisserman. Bootstap: Bootstrapped training for tracking-any-point. arXiv preprint arXiv:2402.00847, 2024.
- [dosovitskiy21an-image] Alexey Dosovitskiy, Lucas Beyer, Alexander Kolesnikov, Dirk Weissenborn, Xiaohua Zhai, Thomas Unterthiner, Mostafa Dehghani, Matthias Minderer, Georg Heigold, Sylvain Gelly, Jakob Uszkoreit, and Neil Houlsby. An image is worth 16\(\times\)16 words: Transformers for image recognition at scale. In Proc. {ICLR}, 2021.
- [downs2022google] Laura Downs, Anthony Francis, Nate Koenig, Brandon Kinman, Ryan Hickman, Krista Reymann, Thomas B McHugh, and Vincent Vanhoucke. Google scanned objects: A high-quality dataset of 3d scanned household items. In 2022 International Conference on Robotics and Automation (ICRA), pages 2553--2560. IEEE, 2022.
- [dubey24the-llama] Abhimanyu Dubey, Abhinav Jauhri, Abhinav Pandey, Abhishek Kadian, Ahmad Al{-}Dahle, Aiesha Letman, Akhil Mathur, Alan Schelten, Amy Yang, Angela Fan, Anirudh Goyal, Anthony Hartshorn, Aobo Yang, Archi Mitra, Archie Sravankumar, Artem Korenev, Arthur Hinsvark, Arun Rao, Aston Zhang, Aur{\'{e}}lien Rodriguez, Austen Gregerson, Ava Spataru, Baptiste Rozi{`{e}}re, Bethany Biron, Binh Tang, Bobbie Chern, Charlotte Caucheteux, Chaya Nayak, Chloe Bi, Chris Marra, Chris McConnell, Christian Keller, Christophe Touret, Chunyang Wu, Corinne Wong, Cristian Canton Ferrer, Cyrus Nikolaidis, Damien Allonsius, Daniel Song, Danielle Pintz, Danny Livshits, David Esiobu, Dhruv Choudhary, Dhruv Mahajan, Diego Garcia{-}Olano, Diego Perino, Dieuwke Hupkes, Egor Lakomkin, Ehab AlBadawy, Elina Lobanova, Emily Dinan, Eric Michael Smith, Filip Radenovic, Frank Zhang, Gabriel Synnaeve, Gabrielle Lee, Georgia Lewis Anderson, Graeme Nail, Gr{\'{e}}goire Mialon, Guan Pang, Guillem Cucurell, Hailey Nguyen, Hannah Korevaar, Hu Xu, Hugo Touvron, Iliyan Zarov, Imanol Arrieta Ibarra, Isabel M. Kloumann, Ishan Misra, Ivan Evtimov, Jade Copet, Jaewon Lee, Jan Geffert, Jana Vranes, Jason Park, Jay Mahadeokar, Jeet Shah, Jelmer van der Linde, Jennifer Billock, Jenny Hong, Jenya Lee, Jeremy Fu, Jianfeng Chi, Jianyu Huang, Jiawen Liu, Jie Wang, Jiecao Yu, Joanna Bitton, Joe Spisak, Jongsoo Park, Joseph Rocca, Joshua Johnstun, Joshua Saxe, Junteng Jia, Kalyan Vasuden Alwala, Kartikeya Upasani, Kate Plawiak, Ke Li, Kenneth Heafield, and Kevin Stone. The {Llama} 3 herd of models. arXiv, 2407.21783, 2024.
- [duisterhof24mast3r-sfm:] Bardienus Duisterhof, Lojze Zust, Philippe Weinzaepfel, Vincent Leroy, Yohann Cabon, and Jerome Revaud. {MASt3R-SfM:} a fully-integrated solution for unconstrained structure-from-motion. arXiv, 2409.19152, 2024.
- [dusmanu2019d2] Mihai Dusmanu, Ignacio Rocco, Tomas Pajdla, Marc Pollefeys, Josef Sivic, Akihiko Torii, and Torsten Sattler. D2-net: A trainable cnn for joint description and detection of local features. In Proceedings of the ieee/cvf conference on computer vision and pattern recognition, pages 8092--8101, 2019.
- [edstedt2023dkm] Johan Edstedt, Ioannis Athanasiadis, Mårten Wadenbäck, and Michael Felsberg. {DKM}: Dense kernelized feature matching for geometry estimation. In IEEE Conference on Computer Vision and Pattern Recognition, 2023.
- [edstedt2024roma] Johan Edstedt, Qiyu Sun, Georg B{\"o}kman, M{\aa}rten Wadenb{\"a}ck, and Michael Felsberg. Roma: Robust dense feature matching. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, pages 19790--19800, 2024.
- [esser21taming] Patrick Esser, Robin Rombach, and Bj{\"{o}}rn Ommer. Taming transformers for high-resolution image synthesis. In Proc. {CVPR}, 2021.
- [fischler1981random] Martin A Fischler and Robert C Bolles. Random sample consensus: a paradigm for model fitting with applications to image analysis and automated cartography. Communications of the ACM, 24 (6): 381--395, 1981.
- [frahm2010building] Jan-Michael Frahm, Pierre Fite-Georgel, David Gallup, Tim Johnson, Rahul Raguram, Changchang Wu, Yi-Hung Jen, Enrique Dunn, Brian Clipp, Svetlana Lazebnik, et al. Building rome on a cloudless day. In Computer Vision--ECCV 2010: 11th European Conference on Computer Vision, Heraklion, Crete, Greece, September 5-11, 2010, Proceedings, Part IV 11, pages 368--381. Springer, 2010.
- [fu2022geo] Qiancheng Fu, Qingshan Xu, Yew Soon Ong, and Wenbing Tao. Geo-neus: Geometry-consistent neural implicit surfaces learning for multi-view reconstruction. Advances in Neural Information Processing Systems, 35: 3403--3416, 2022.
- [furukawa2015multi] Yasutaka Furukawa, Carlos Hern{\'a}ndez, et al. Multi-view stereo: A tutorial. Foundations and Trends{\textregistered} in Computer Graphics and Vision, 9 (1-2): 1--148, 2015.
- [galliani2015massively] Silvano Galliani, Katrin Lasinger, and Konrad Schindler. Massively parallel multiview stereopsis by surface normal diffusion. In Proceedings of the IEEE international conference on computer vision, pages 873--881, 2015{a}.
- [gipuma] Silvano Galliani, Katrin Lasinger, and Konrad Schindler. Massively parallel multiview stereopsis by surface normal diffusion. In ICCV, 2015{b}.
- [greff22kubric:] Klaus Greff, Francois Belletti, Lucas Beyer, Carl Doersch, Yilun Du, Daniel Duckworth, David J Fleet, Dan Gnanapragasam, Florian Golemo, Charles Herrmann, Thomas Kipf, Abhijit Kundu, Dmitry Lagun, Issam Laradji, Hsueh-Ti (Derek) Liu, Henning Meyer, Yishu Miao, Derek Nowrouzezahrai, Cengiz Oztireli, Etienne Pot, Noha Radwan, Daniel Rebain, Sara Sabour, Mehdi S. M. Sajjadi, Matan Sela, Vincent Sitzmann, Austin Stone, Deqing Sun, Suhani Vora, Ziyu Wang, Tianhao Wu, Kwang Moo Yi, Fangcheng Zhong, and Andrea Tagliasacchi. Kubric: a scalable dataset generator. In Proc. {CVPR}, 2022.
- [gu2020cascade] Xiaodong Gu, Zhiwen Fan, Siyu Zhu, Zuozhuo Dai, Feitong Tan, and Ping Tan. Cascade cost volume for high-resolution multi-view stereo and stereo matching. In Proceedings of the IEEE/CVF conference on computer vision and pattern recognition, pages 2495--2504, 2020.
- [han2024flex3d] Junlin Han, Jianyuan Wang, Andrea Vedaldi, Philip Torr, and Filippos Kokkinos. Flex3d: Feed-forward 3d generation with flexible reconstruction model and input view curation. arXiv preprint arXiv:2410.00890, 2024.
- [pips] Adam W Harley, Zhaoyuan Fang, and Katerina Fragkiadaki. Particle video revisited: Tracking through occlusions using point trajectories. In Proc. {ECCV}, 2022.
- [hartley_multiple_2000] Richard Hartley and Andrew Zisserman. Multiple {View} {Geometry} in {Computer} {Vision}. Cambridge University Press, 2000.
- [hartley04multiple] Richard Hartley and Andrew Zisserman. Multiple View Geometry in Computer Vision. Cambridge University Press, ISBN: 0521540518, 2004.
- [he2023dfsfm] Xingyi He, Jiaming Sun, Yifan Wang, Sida Peng, Qixing Huang, Hujun Bao, and Xiaowei Zhou. Detector-free structure from motion. In arxiv, 2023.
- [henry2020query] Alex Henry, Prudhvi Raj Dachapally, Shubham Pawar, and Yuxuan Chen. Query-key normalization for transformers. arXiv preprint arXiv:2010.04245, 2020.
- [hong24lrm:] Yicong Hong, Kai Zhang, Jiuxiang Gu, Sai Bi, Yang Zhou, Difan Liu, Feng Liu, Kalyan Sunkavalli, Trung Bui, and Hao Tan. {LRM}: Large reconstruction model for single image to {3D}. In Proc. {ICLR}, 2024.
- [mvssynth] Po-Han Huang, Kevin Matzen, Johannes Kopf, Narendra Ahuja, and Jia-Bin Huang. Deepmvs: Learning multi-view stereopsis. In IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 2018.
- [dtudataset] Rasmus Jensen, Anders Dahl, George Vogiatzis, Engil Tola, and Henrik Aan{\ae}s. Large scale multi-view stereopsis evaluation. In 2014 IEEE Conference on Computer Vision and Pattern Recognition, pages 406--413. IEEE, 2014.
- [jiang2013global] Nianjuan Jiang, Zhaopeng Cui, and Ping Tan. A global linear method for camera pose registration. In Proceedings of the IEEE international conference on computer vision, pages 481--488, 2013.
- [jin24lvsm:] Haian Jin, Hanwen Jiang, Hao Tan, Kai Zhang, Sai Bi, Tianyuan Zhang, Fujun Luan, Noah Snavely, and Zexiang Xu. {LVSM:} a large view synthesis model with minimal {3D} inductive bias. arXiv, 2410.17242, 2024.
- [jin2021image] Yuhe Jin, Dmytro Mishkin, Anastasiia Mishchuk, Jiri Matas, Pascal Fua, Kwang Moo Yi, and Eduard Trulls. Image matching across wide baselines: From paper to practice. International Journal of Computer Vision, 129 (2): 517--547, 2021.
- [karaev2024cotracker3] Nikita Karaev, Iurii Makarov, Jianyuan Wang, Natalia Neverova, Andrea Vedaldi, and Christian Rupprecht. Cotracker3: Simpler and better point tracking by pseudo-labelling real videos. arXiv preprint arXiv:2410.11831, 2024{a}.
- [karaev2023cotracker] Nikita Karaev, Ignacio Rocco, Benjamin Graham, Natalia Neverova, Andrea Vedaldi, and Christian Rupprecht. Cotracker: It is better to track together. Proc. {ECCV}, 2024{b}.
- [karaev24cotracker] Nikita Karaev, Ignacio Rocco, Ben Graham, Natalia Neverova, Andrea Vedaldi, and Christian Rupprecht. {CoTracker}: It is better to track together. In Proceedings of the European Conference on Computer Vision ({ECCV}), 2024{c}.
- [kendall16modelling] Alex Kendall and Roberto Cipolla. Modelling uncertainty in deep learning for camera relocalization. In Proc. {ICRA}. IEEE, 2016.
- [kendall17what] Alex Kendall and Yarin Gal. What uncertainties do we need in {Bayesian} deep learning for computer vision? Proc. {NeurIPS}, 2017.
- [lemoing2024dense] Guillaume Le Moing, Jean Ponce, and Cordelia Schmid. Dense optical tracking: Connecting the dots. In CVPR, 2024.
- [lepetit2009ep] Vincent Lepetit, Francesc Moreno-Noguer, and Pascal Fua. Ep n p: An accurate o (n) solution to the p n p problem. International journal of computer vision, 81: 155--166, 2009.
- [mast3r] Vincent Leroy, Yohann Cabon, and J{\'e}r{\^o}me Revaud. Grounding image matching in 3d with mast3r. arXiv preprint arXiv:2406.09756, 2024.
- [li2024taptr] Hongyang Li, Hao Zhang, Shilong Liu, Zhaoyang Zeng, Tianhe Ren, Feng Li, and Lei Zhang. Taptr: Tracking any point with transformers as detection. arXiv preprint arXiv:2403.13042, 2024.
- [li2018megadepth] Zhengqi Li and Noah Snavely. Megadepth: Learning single-view depth prediction from internet photos. In Proceedings of the IEEE conference on computer vision and pattern recognition, pages 2041--2050, 2018.
- [lin2023relposepp] Amy Lin, Jason Y Zhang, Deva Ramanan, and Shubham Tulsiani. Relpose++: Recovering 6d poses from sparse-view observations. arXiv preprint arXiv:2305.04926, 2023.
- [lindenberger21pixel-perfect] Philipp Lindenberger, Paul{-}Edouard Sarlin, Viktor Larsson, and Marc Pollefeys. Pixel-perfect structure-from-motion with featuremetric refinement. arXiv.cs, abs/2108.08291, 2021.
- [lindenberger2023lightglue] Philipp Lindenberger, Paul-Edouard Sarlin, and Marc Pollefeys. Lightglue: Local feature matching at light speed. arXiv preprint arXiv:2306.13643, 2023{a}.
- [lindenberger23lightglue:] Philipp Lindenberger, Paul-Edouard Sarlin, and Marc Pollefeys. {LightGlue:} local feature matching at light speed. In Proc. {ICCV}, 2023{b}.
- [ling2024dl3dv] Lu Ling, Yichen Sheng, Zhi Tu, Wentian Zhao, Cheng Xin, Kun Wan, Lantao Yu, Qianyu Guo, Zixun Yu, Yawen Lu, et al. Dl3dv-10k: A large-scale scene dataset for deep learning-based 3d vision. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, pages 22160--22169, 2024.
- [liu2025robust] Shaohui Liu, Yidan Gao, Tianyi Zhang, R{\'e}mi Pautrat, Johannes L Sch{\"o}nberger, Viktor Larsson, and Marc Pollefeys. Robust incremental structure-from-motion with hybrid features. In European Conference on Computer Vision, pages 249--269. Springer, 2025.
- [MPSD_2020_ECCV] Manuel Lopez-Antequera, Pau Gargallo, Markus Hofinger, Samuel Rota Bulò, Yubin Kuang, and Peter Kontschieder. Mapillary planet-scale depth dataset. In Proceedings of the European Conference on Computer Vision (ECCV), 2020.
- [ma2022multiview] Zeyu Ma, Zachary Teed, and Jia Deng. Multiview stereo with cascaded epipolar raft. In European Conference on Computer Vision, pages 734--750. Springer, 2022.
- [moulon2013global] Pierre Moulon, Pascal Monasse, and Renaud Marlet. Global fusion of relative motions for robust, accurate and scalable structure from motion. In Proceedings of the IEEE international conference on computer vision, pages 3248--3255, 2013.
- [niemeyer2020differentiable] Michael Niemeyer, Lars Mescheder, Michael Oechsle, and Andreas Geiger. Differentiable volumetric rendering: Learning implicit 3d representations without 3d supervision. In Proceedings of the IEEE/CVF conference on computer vision and pattern recognition, pages 3504--3515, 2020.
- [novotny17learning] David Novotn{\'{y}}, Diane Larlus, and Andrea Vedaldi. Learning {3D} object categories by looking around them. In Proceedings of the International Conference on Computer Vision ({ICCV}), 2017.
- [novotny18capturing] David Novotn{\'{y}}, Diane Larlus, and Andrea Vedaldi. Capturing the geometry of object categories from video supervision. {IEEE} Transactions on Pattern Analysis and Machine Intelligence, 2018.
- [oliensis2000critique] John Oliensis. A critique of structure-from-motion algorithms. Computer Vision and Image Understanding, 80 (2): 172--214, 2000.
- [oquab24dinov2:] Maxime Oquab, Timoth{\'e}e Darcet, Th{\'e}o Moutakanni, Huy V. Vo, Marc Szafraniec, Vasil Khalidov, Pierre Fernandez, Daniel HAZIZA, Francisco Massa, Alaaeldin El-Nouby, Mido Assran, Nicolas Ballas, Wojciech Galuba, Russell Howes, Po-Yao Huang, Shang-Wen Li, Ishan Misra, Michael Rabbat, Vasu Sharma, Gabriel Synnaeve, Hu Xu, Herve Jegou, Julien Mairal, Patrick Labatut, Armand Joulin, and Piotr Bojanowski. {DINO}v2: Learning robust visual features without supervision. Transactions on Machine Learning Research, 2024.
- [ozyesil2015robust] Onur Ozyesil and Amit Singer. Robust camera location estimation by convex programming. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, pages 2674--2683, 2015.
- [ozyecsil2017survey] Onur {\"O}zye{\c{s}}il, Vladislav Voroninski, Ronen Basri, and Amit Singer. A survey of structure from motion. Acta Numerica*, 26: 305--364, 2017.
- [pan2024glomap] Linfei Pan, Daniel Barath, Marc Pollefeys, and Johannes Lutz Sch\"{o}nberger. {Global Structure-from-Motion Revisited}. In European Conference on Computer Vision (ECCV), 2024.
- [Pan_2023_ICCV] Xiaqing Pan, Nicholas Charron, Yongqian Yang, Scott Peters, Thomas Whelan, Chen Kong, Omkar Parkhi, Richard Newcombe, and Yuheng (Carl) Ren. Aria digital twin: A new benchmark dataset for egocentric 3d machine perception. In Proceedings of the IEEE/CVF International Conference on Computer Vision (ICCV), pages 20133--20143, 2023.
- [peebles2023scalable] William Peebles and Saining Xie. Scalable diffusion models with transformers. In Proceedings of the IEEE/CVF International Conference on Computer Vision, pages 4195--4205, 2023.
- [peng2022rethinking] Rui Peng, Rongjie Wang, Zhenyu Wang, Yawen Lai, and Ronggang Wang. Rethinking depth estimation for multi-view stereo: A unified representation. In Proceedings of the IEEE/CVF conference on computer vision and pattern recognition, pages 8645--8654, 2022.
- [pineda2022theseus] Luis Pineda, Taosha Fan, Maurizio Monge, Shobha Venkataraman, Paloma Sodhi, Ricky TQ Chen, Joseph Ortiz, Daniel DeTone, Austin Wang, Stuart Anderson, et al. Theseus: A library for differentiable nonlinear optimization. Advances in Neural Information Processing Systems, 35: 3801--3818, 2022.
- [radford21learning] Alec Radford, Jong Wook Kim, Chris Hallacy, Aditya Ramesh, Gabriel Goh, Sandhini Agarwal, Girish Sastry, Amanda Askell, Pamela Mishkin, Jack Clark, Gretchen Krueger, and Ilya Sutskever. Learning transferable visual models from natural language supervision. In Proc. {ICML}, pages 8748--8763, 2021.
- [ranftl21dpt] Ren{\'e} Ranftl, Alexey Bochkovskiy, and Vladlen Koltun. Vision transformers for dense prediction. In Proceedings of the IEEE/CVF international conference on computer vision, pages 12179--12188, 2021.
- [reizenstein21common] Jeremy Reizenstein, Roman Shapovalov, Philipp Henzler, Luca Sbordone, Patrick Labatut, and David Novotny. {Common Objects in 3D}: Large-scale learning and evaluation of real-life {3D} category reconstruction. In Proc. {ICCV}, 2021.
- [hypersim] Mike Roberts, Jason Ramapuram, Anurag Ranjan, Atulit Kumar, Miguel Angel Bautista, Nathan Paczan, Russ Webb, and Joshua M. Susskind. {Hypersim}: {A} photorealistic synthetic dataset for holistic indoor scene understanding. In International Conference on Computer Vision (ICCV) 2021, 2021.
- [rother2003linear] Rother. Linear multiview reconstruction of points, lines, planes and cameras using a reference plane. In Proceedings Ninth IEEE International Conference on Computer Vision, pages 1210--1217. IEEE, 2003.
- [sand2008particle] Peter Sand and Seth Teller. Particle video: Long-range motion estimation using point trajectories. {IJCV}, 80, 2008.
- [sarlin2020superglue] Paul-Edouard Sarlin, Daniel DeTone, Tomasz Malisiewicz, and Andrew Rabinovich. Superglue: Learning feature matching with graph neural networks. In Proceedings of the IEEE/CVF conference on computer vision and pattern recognition, pages 4938--4947, 2020{a}.
- [sarlin20superglue:] Paul-Edouard Sarlin, Daniel DeTone, Tomasz Malisiewicz, and Andrew Rabinovich. {SuperGlue:} learning feature matching with graph neural networks. In Proc. {CVPR}, 2020{b}.
- [schoenberger2016sfm] Johannes Lutz Sch\"{o}nberger and Jan-Michael Frahm. Structure-from-motion revisited. In Conference on Computer Vision and Pattern Recognition (CVPR), 2016{a}.
- [schonberger16structure-from-motion] Johannes Lutz Sch\"{o}nberger and Jan-Michael Frahm. Structure-from-motion revisited. In Proc. {CVPR}, 2016{b}.
- [schonberger2016pixelwise] Johannes L Sch{\"o}nberger, Enliang Zheng, Jan-Michael Frahm, and Marc Pollefeys. Pixelwise view selection for unstructured multi-view stereo. In Computer Vision--ECCV 2016: 14th European Conference, Amsterdam, The Netherlands, October 11-14, 2016, Proceedings, Part III 14, pages 501--518. Springer, 2016.
- [eth3d] Thomas Schops, Johannes L Schonberger, Silvano Galliani, Torsten Sattler, Konrad Schindler, Marc Pollefeys, and Andreas Geiger. A multi-view stereo benchmark with high-resolution images and multi-camera videos. In Proceedings of the IEEE conference on computer vision and pattern recognition, pages 3260--3269, 2017.
- [shah2024flashattention] Jay Shah, Ganesh Bikshandi, Ying Zhang, Vijay Thakkar, Pradeep Ramani, and Tri Dao. Flashattention-3: Fast and accurate attention with asynchrony and low-precision. Advances in Neural Information Processing Systems, 37: 68658--68685, 2024.
- [shi2022clustergnn] Yan Shi, Jun-Xiong Cai, Yoli Shavit, Tai-Jiang Mu, Wensen Feng, and Kai Zhang. Clustergnn: Cluster-based coarse-to-fine graph neural network for efficient feature matching. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, pages 12517--12526, 2022.
- [sinha2023sparsepose] Samarth Sinha, Jason Y Zhang, Andrea Tagliasacchi, Igor Gilitschenski, and David B Lindell. Sparsepose: Sparse-view camera pose regression and refinement. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, pages 21349--21359, 2023.
- [smith2024flowmap] Cameron Smith, David Charatan, Ayush Tewari, and Vincent Sitzmann. Flowmap: High-quality camera poses, intrinsics, and depth via gradient descent. arXiv preprint arXiv:2404.15259, 2024{a}.
- [smith24flowmap:] Cameron Smith, David Charatan, Ayush Tewari, and Vincent Sitzmann. {FlowMap:} high-quality camera poses, intrinsics, and depth via gradient descent. arXiv, 2404.15259, 2024{b}.
- [snavely2006photo] Noah Snavely, Steven M Seitz, and Richard Szeliski. Photo tourism: exploring photo collections in 3d. In ACM siggraph 2006 papers, pages 835--846. 2006.
- [straub2019replica] Julian Straub, Thomas Whelan, Lingni Ma, Yufan Chen, Erik Wijmans, Simon Green, Jakob J Engel, Raul Mur-Artal, Carl Ren, Shobhit Verma, et al. The replica dataset: A digital replica of indoor spaces. arXiv preprint arXiv:1906.05797, 2019.
- [sun2021loftr] Jiaming Sun, Zehong Shen, Yuang Wang, Hujun Bao, and Xiaowei Zhou. Loftr: Detector-free local feature matching with transformers. In Proceedings of the IEEE/CVF conference on computer vision and pattern recognition, pages 8922--8931, 2021.
- [sweeney2015optimizing] Chris Sweeney, Torsten Sattler, Tobias Hollerer, Matthew Turk, and Marc Pollefeys. Optimizing the viewing graph for structure-from-motion. In Proceedings of the IEEE international conference on computer vision, pages 801--809, 2015.
- [szot2021habitat] Andrew Szot, Alex Clegg, Eric Undersander, Erik Wijmans, Yili Zhao, John Turner, Noah Maestre, Mustafa Mukadam, Devendra Chaplot, Oleksandr Maksymets, Aaron Gokaslan, Vladimir Vondrus, Sameer Dharur, Franziska Meier, Wojciech Galuba, Angel Chang, Zsolt Kira, Vladlen Koltun, Jitendra Malik, Manolis Savva, and Dhruv Batra. Habitat 2.0: Training home assistants to rearrange their habitat. In Advances in Neural Information Processing Systems (NeurIPS), 2021.
- [szymanowicz2024splatter] Stanislaw Szymanowicz, Chrisitian Rupprecht, and Andrea Vedaldi. Splatter image: Ultra-fast single-view 3d reconstruction. In Proceedings of the IEEE/CVF conference on computer vision and pattern recognition, pages 10208--10217, 2024.
- [tang2018ba] Chengzhou Tang and Ping Tan. Ba-net: Dense bundle adjustment network. arXiv preprint arXiv:1806.04807, 2018.
- [tang2024lgm] Jiaxiang Tang, Zhaoxi Chen, Xiaokang Chen, Tengfei Wang, Gang Zeng, and Ziwei Liu. Lgm: Large multi-view gaussian model for high-resolution 3d content creation. In European Conference on Computer Vision, pages 1--18. Springer, 2024{a}.
- [tang2024mv] Zhenggang Tang, Yuchen Fan, Dilin Wang, Hongyu Xu, Rakesh Ranjan, Alexander Schwing, and Zhicheng Yan. Mv-dust3r+: Single-stage scene reconstruction from sparse views in 2 seconds. arXiv preprint arXiv:2412.06974, 2024{b}.
- [teed2018deepv2d] Zachary Teed and Jia Deng. Deepv2d: Video to depth with differentiable structure from motion. arXiv preprint arXiv:1812.04605, 2018.
- [teed2021droid] Zachary Teed and Jia Deng. Droid-slam: Deep visual slam for monocular, stereo, and rgb-d cameras. Advances in neural information processing systems, 34: 16558--16569, 2021.
- [touvron2021training] Hugo Touvron, Matthieu Cord, Matthijs Douze, Francisco Massa, Alexandre Sablayrolles, and Herv{\'e} J{\'e}gou. Training data-efficient image transformers & distillation through attention. In International conference on machine learning, pages 10347--10357. PMLR, 2021{a}.
- [touvron2021going] Hugo Touvron, Matthieu Cord, Alexandre Sablayrolles, Gabriel Synnaeve, and Herv{\'e} J{\'e}gou. Going deeper with image transformers. In Proceedings of the IEEE/CVF international conference on computer vision, pages 32--42, 2021{b}.
- [tyszkiewicz2020disk] Micha{\l} Tyszkiewicz, Pascal Fua, and Eduard Trulls. Disk: Learning local features with policy gradient. Advances in Neural Information Processing Systems, 33: 14254--14265, 2020.
- [umeyama91least-squares] Shinji Umeyama. Least-squares estimation of transformation parameters between two point patterns. {IEEE} Trans. Pattern Anal. Mach. Intell., 13 (4), 1991.
- [ummenhofer2017demon] Benjamin Ummenhofer, Huizhong Zhou, Jonas Uhrig, Nikolaus Mayer, Eddy Ilg, Alexey Dosovitskiy, and Thomas Brox. Demon: Depth and motion network for learning monocular stereo. In Proceedings of the IEEE conference on computer vision and pattern recognition, pages 5038--5047, 2017.
- [vaswani17attention] Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Lukasz Kaiser, and Illia Polosukhin. Attention is all you need. In Proc. {NeurIPS}, 2017{a}.
- [vaswani2017attention] Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N Gomez, {\L}ukasz Kaiser, and Illia Polosukhin. Attention is all you need. Advances in neural information processing systems, 30, 2017{b}.
- [pathcmatchnet] Fangjinhua Wang, Silvano Galliani, Christoph Vogel, Pablo Speciale, and Marc Pollefeys. Patchmatchnet: Learned multi-view patchmatch stereo. In CVPR, pages 14194--14203, 2021{a}.
- [wang2021deep] Jianyuan Wang, Yiran Zhong, Yuchao Dai, Stan Birchfield, Kaihao Zhang, Nikolai Smolyanskiy, and Hongdong Li. Deep two-view structure-from-motion revisited. In Proceedings of the IEEE/CVF conference on Computer Vision and Pattern Recognition, pages 8953--8962, 2021{b}.
- [wang2023posediffusion] Jianyuan Wang, Christian Rupprecht, and David Novotny. Posediffusion: Solving pose estimation via diffusion-aided bundle adjustment. In Proceedings of the IEEE/CVF International Conference on Computer Vision, pages 9773--9783, 2023{a}.
- [wang23posediffusion:] Jianyuan Wang, Christian Rupprecht, and David Novotny. {PoseDiffusion:} solving pose estimation via diffusion-aided bundle adjustment. In Proc. {ICCV}, 2023{b}.
- [wang24vggsfm:] Jianyuan Wang, Nikita Karaev, Christian Rupprecht, and David Novotny. {VGGSfM:} visual geometry grounded deep structure from motion. In Proc. {CVPR}, 2024{a}.
- [wang23pf-lrm:] Peng Wang, Hao Tan, Sai Bi, Yinghao Xu, Fujun Luan, Kalyan Sunkavalli, Wenping Wang, Zexiang Xu, and Kai Zhang. {PF-LRM:} pose-free large reconstruction model for joint pose and shape prediction. arXiv.cs, abs/2311.12024, 2023{c}.
- [cut3r] Qianqian Wang, Yifei Zhang, Aleksander Holynski, Alexei A. Efros, and Angjoo Kanazawa. Continuous 3d perception model with persistent state, 2025.
- [wang24moge:] Ruicheng Wang, Sicheng Xu, Cassie Dai, Jianfeng Xiang, Yu Deng, Xin Tong, and Jiaolong Yang. {MoGe:} unlocking accurate monocular geometry estimation for open-domain images with optimal training supervision. arXiv, 2410.19115, 2024{b}.
- [wang24dust3r:] Shuzhe Wang, Vincent Leroy, Yohann Cabon, Boris Chidlovskii, and Jerome Revaud. {DUSt3R}: Geometric {3D} vision made easy. In Proc. {CVPR}, 2024{c}.
- [Wang_2023_CVPR] Yuesong Wang, Zhaojie Zeng, Tao Guan, Wei Yang, Zhuo Chen, Wenkai Liu, Luoyuan Xu, and Yawei Luo. Adaptive patch deformation for textureless-resilient multi-view stereo. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), pages 1621--1630, 2023{d}.
- [wei2020deepsfm] Xingkui Wei, Yinda Zhang, Zhuwen Li, Yanwei Fu, and Xiangyang Xue. Deepsfm: Structure from motion via deep bundle adjustment. In Computer Vision--ECCV 2020: 16th European Conference, Glasgow, UK, August 23--28, 2020, Proceedings, Part I 16, pages 230--247. Springer, 2020.
- [wei24meshlrm:] Xinyue Wei, Kai Zhang, Sai Bi, Hao Tan, Fujun Luan, Valentin Deschaintre, Kalyan Sunkavalli, Hao Su, and Zexiang Xu. {MeshLRM:} large reconstruction model for high-quality mesh. arXiv, 2404.12385, 2024.
- [Wei_2021_ICCV] Yi Wei, Shaohui Liu, Yongming Rao, Wang Zhao, Jiwen Lu, and Jie Zhou. Nerfingmvs: Guided optimization of neural radiance fields for indoor multi-view stereo. In Proceedings of the IEEE/CVF International Conference on Computer Vision (ICCV), pages 5610--5619, 2021.
- [wu2013towards] Changchang Wu. Towards linear-time incremental structure from motion. In 2013 International Conference on 3D Vision-3DV 2013, pages 127--134. IEEE, 2013.
- [xia2024rgbd] Hongchi Xia, Yang Fu, Sifei Liu, and Xiaolong Wang. Rgbd objects in the wild: Scaling real-world 3d object learning from rgb-d videos, 2024.
- [xiao2024spatialtracker] Yuxi Xiao, Qianqian Wang, Shangzhan Zhang, Nan Xue, Sida Peng, Yujun Shen, and Xiaowei Zhou. Spatialtracker: Tracking any 2d pixels in 3d space. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, pages 20406--20417, 2024.
- [xie2021segformer] Enze Xie, Wenhai Wang, Zhiding Yu, Anima Anandkumar, Jose M Alvarez, and Ping Luo. Segformer: Simple and efficient design for semantic segmentation with transformers. Advances in neural information processing systems, 34: 12077--12090, 2021.
- [xie2022correlation] Fei Xie, Chunyu Wang, Guangting Wang, Yue Cao, Wankou Yang, and Wenjun Zeng. Correlation-aware deep tracking. In Proceedings of the IEEE/CVF conference on computer vision and pattern recognition, pages 8751--8760, 2022.
- [cider] Qingshan Xu and Wenbing Tao. Learning inverse depth regression for multi-view stereo with correlation cost volume. In AAAI, 2020.
- [xu24grm:] Yinghao Xu, Zifan Shi, Wang Yifan, Hansheng Chen, Ceyuan Yang, Sida Peng, Yujun Shen, and Gordon Wetzstein. {GRM}: Large gaussian reconstruction model for efficient {3D} reconstruction and generation. arXiv, 2403.14621, 2024.
- [yang2025fast3r] Jianing Yang, Alexander Sax, Kevin J Liang, Mikael Henaff, Hao Tang, Ang Cao, Joyce Chai, Franziska Meier, and Matt Feiszli. Fast3r: Towards 3d reconstruction of 1000+ images in one forward pass. arXiv preprint arXiv:2501.13928, 2025.
- [yang24depth] Lihe Yang, Bingyi Kang, Zilong Huang, Xiaogang Xu, Jiashi Feng, and Hengshuang Zhao. Depth anything: Unleashing the power of large-scale unlabeled data. In Proc. {CVPR}, 2024{a}.
- [depth_anything_v2] Lihe Yang, Bingyi Kang, Zilong Huang, Zhen Zhao, Xiaogang Xu, Jiashi Feng, and Hengshuang Zhao. Depth anything v2. arXiv:2406.09414, 2024{b}.
- [mvsnet] Yao Yao, Zixin Luo, Shiwei Li, Tian Fang, and Long Quan. Mvsnet: Depth inference for unstructured multi-view stereo. In ECCV, 2018{a}.
- [yao2018mvsnet] Yao Yao, Zixin Luo, Shiwei Li, Tian Fang, and Long Quan. Mvsnet: Depth inference for unstructured multi-view stereo. In Proceedings of the European conference on computer vision (ECCV), pages 767--783, 2018{b}.
- [yao2020blendedmvs] Yao Yao, Zixin Luo, Shiwei Li, Jingyang Zhang, Yufan Ren, Lei Zhou, Tian Fang, and Long Quan. Blendedmvs: A large-scale dataset for generalized multi-view stereo networks. In Proceedings of the IEEE/CVF conference on computer vision and pattern recognition, pages 1790--1799, 2020.
- [yariv2020multiview] Lior Yariv, Yoni Kasten, Dror Moran, Meirav Galun, Matan Atzmon, Basri Ronen, and Yaron Lipman. Multiview neural surface reconstruction by disentangling geometry and appearance. Advances in Neural Information Processing Systems, 33: 2492--2502, 2020.
- [yenduri23generative] Gokul Yenduri, Ramalingam M, Chemmalar Selvi G., Supriya Y, Gautam Srivastava, Praveen Kumar Reddy Maddikunta, Deepti Raj G, Rutvij H. Jhaveri, Prabadevi B, Weizheng Wang, Athanasios V. Vasilakos, and Thippa Reddy Gadekallu. Generative pre-trained transformer: {A} comprehensive review on enabling technologies, potential applications, emerging challenges, and future directions. arXiv.cs, abs/2305.10435, 2023.
- [yi_lift_2016] Kwang Moo Yi, Eduard Trulls, Vincent Lepetit, and Pascal Fua. {LIFT}: {Learned} {Invariant} {Feature} {Transform}. In Proc. {ECCV}, 2016.
- [zhai2023stabilizing] Shuangfei Zhai, Tatiana Likhomanenko, Etai Littwin, Dan Busbridge, Jason Ramapuram, Yizhe Zhang, Jiatao Gu, and Joshua M Susskind. Stabilizing transformer training by preventing attention entropy collapse. In International Conference on Machine Learning, pages 40770--40803. PMLR, 2023.
- [zhang24monst3r:] Junyi Zhang, Charles Herrmann, Junhwa Hur, Varun Jampani, Trevor Darrell, Forrester Cole, Deqing Sun, and Ming-Hsuan Yang. {MonST3R:} a simple approach for estimating geometry in the presence of motion. arXiv, 2410.03825, 2024{a}.
- [zhang2022relpose] Jason Y Zhang, Deva Ramanan, and Shubham Tulsiani. Relpose: Predicting probabilistic relative rotation for single objects in the wild. In ECCV, pages 592--611. Springer, 2022.
- [raydiffusion] Jason Y Zhang, Amy Lin, Moneish Kumar, Tzu-Hsuan Yang, Deva Ramanan, and Shubham Tulsiani. Cameras as rays: Pose estimation via ray diffusion. In International Conference on Learning Representations (ICLR), 2024{b}.
- [zhang2024gs] Kai Zhang, Sai Bi, Hao Tan, Yuanbo Xiangli, Nanxuan Zhao, Kalyan Sunkavalli, and Zexiang Xu. Gs-lrm: Large reconstruction model for 3d gaussian splatting. In European Conference on Computer Vision, pages 1--19. Springer, 2024{c}.
- [zhang24gs-lrm:] Kai Zhang, Sai Bi, Hao Tan, Yuanbo Xiangli, Nanxuan Zhao, Kalyan Sunkavalli, and Zexiang Xu. {GS-LRM:} large reconstruction model for {3D} {Gaussian} splatting. arXiv, 2404.19702, 2024{d}.
- [zhang2025flare] Shangzhan Zhang, Jianyuan Wang, Yinghao Xu, Nan Xue, Christian Rupprecht, Xiaowei Zhou, Yujun Shen, and Gordon Wetzstein. Flare: Feed-forward geometry, appearance and camera estimation from uncalibrated sparse views, 2025.
- [geomvsnet] Zhe Zhang, Rui Peng, Yuxi Hu, and Ronggang Wang. Geomvsnet: Learning multi-view stereo with geometry perception. In CVPR, 2023.
- [zhao2023aliked] Xiaoming Zhao, Xingming Wu, Weihai Chen, Peter CY Chen, Qingsong Xu, and Zhengguo Li. Aliked: A lighter keypoint and descriptor extraction network via deformable transformation. IEEE Transactions on Instrumentation and Measurement, 72: 1--16, 2023.
- [zheng2023point] Yang Zheng, Adam W. Harley, Bokui Shen, Gordon Wetzstein, and Leonidas J. Guibas. Pointodyssey: A large-scale synthetic dataset for long-term point tracking. In ICCV, 2023.
- [zhou2017unsupervised] Tinghui Zhou, Matthew Brown, Noah Snavely, and David G Lowe. Unsupervised learning of depth and ego-motion from video. In Proceedings of the IEEE conference on computer vision and pattern recognition, pages 1851--1858, 2017.
- [zhou2018stereo] Tinghui Zhou, Richard Tucker, John Flynn, Graham Fyffe, and Noah Snavely. Stereo magnification: Learning view synthesis using multiplane images. arXiv preprint arXiv:1805.09817, 2018.